

După cinci luni de dezvoltare, a fost lansată versiunea 1.1 a proiectului IncidentRelay, care dezvoltă un sistem deschis pentru organizarea de ture, rutarea notificărilor și gestionarea incidentelor, care se rulează pe un server propriu (self-hosted). IncidentRelay 1.1 este marcat ca prima versiune stabilă (rama 1.0 a avut statut de versiune beta). Proiectul este destinat echipelor SRE, DevOps și infrastructurii care au nevoie de o alternativă deschisă la serviciile SaaS pentru gestionarea turelor (on-call management), aplicarea politicilor de escaladare și reacția la incidente. Codul proiectului este scris în Python și este distribuit sub licența MIT.
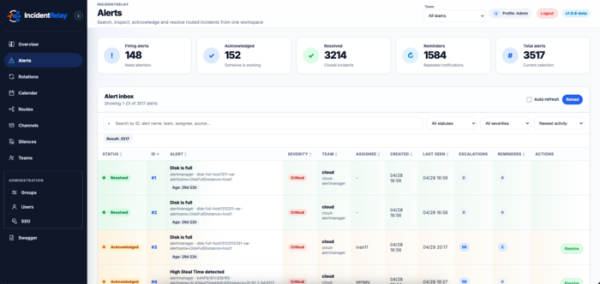
IncidentRelay preia evenimente din sistemele de monitorizare, le corelează cu serviciul, echipa și rotația, după care livrează notificările responsabilelor de tură sau echipelor. În sistem sunt implementate programări pentru ture, rotații, suprascrierea schimburilor, confirmarea primirii incidentului, stările ACK/Resolve, memento-uri, escaladări, înlocuiri temporare ale echipelor de tură, definirea timpului pentru lucrări planificate și suprimarea alertelor zgomotoase.
Principalul avantaj al proiectului este controlul total asupra infrastructurii și logicii de rutare. IncidentRelay se desfășoară în mediu propriu, lucrează cu propria bază de date și permite separarea clară a rutelor de intrare, echipelor, rotațiilor și canalelor de livrare. Tokenurile de intrare aparțin rutelor, nu canalelor, astfel încât este mai ușor de înțeles care sursă externă are dreptul să trimită evenimente către o echipă specifică.
IncidentRelay suportă primirea evenimentelor din Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch și webhook-uri arbitrare. Pentru trimiterea notificărilor sunt disponibile canale precum Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhook-uri, push browser/PWA și furnizori de apeluri vocale. În Mattermost și Telegram, notificările pot conține acțiuni pentru confirmarea și rezolvarea problemei, ceea ce permite gestionarea incidentelor fără a trece printr-o interfață separată.
Proiectul poate fi lansat prin Docker Compose, pachet RPM pentru distribuțiile similare cu Red Hat, manual prin systemd, precum și în Kubernetes folosind chart-ul Helm. Pentru instalări mici, se poate folosi SQLite, iar pentru sisteme de lucru și sarcini mai mari se recomandă PostgreSQL.
Noua versiune oferă următoarele modificări:
- Au fost adăugate rotații multi-nivel on-call cu restricții temporale, priorități pentru straturi și luând în considerare înlocuirile temporare;
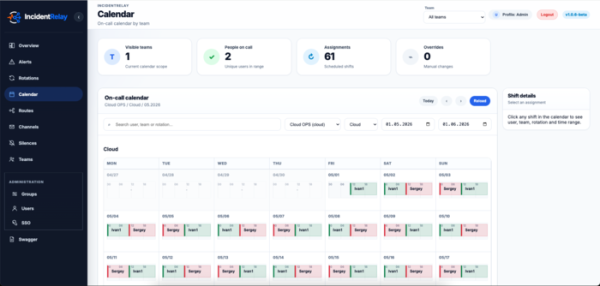
- A apărut un calendar pentru de tură, CalDAV și abonamente ICS pentru calendare externe;
- Au fost implementate politici de escaladare a incidentelor cu lanțuri de creștere pas cu pas;
- Au fost adăugate grupuri de alerte, gruparea evenimentelor, notificări întârziate și combinarea manuală a alertelor corelate;
- Au apărut feronerie pentru lucrări planificate și alerte 'tăcute';
- A fost adăugată posibilitatea de a adăuga comentarii la alerte;
- Au fost adăugate priorități pentru incidente (P1-P5) și creșterea automată a prioritarității în funcție de importanță;
- Au fost implementate un catalog de servicii, dependențele serviciilor, SLI/SLO, istoria impactului asupra funcționării sistemelor (Service Impact History) și servicii de afaceri (Business Services);
- A apărut Explain Trace pentru analiza rutării: de ce o alertă a fost sau nu a fost inclusă în echipă, a fost grupată, suprima sau trimisă într-un canal specific;
- Au fost adăugate verificări (Heartbeats/dead-man-switch) pentru watchdog, backup, ETL și alte sarcini unde problema este lipsa semnalului așteptat.
Sursa: opennet.ro
