

În cadrul proiectului Qwenputer, cercetătorii au pregătit o variantă extinsă a modelului AI Qwen3.5-4B, care integrează un simulator complet al unui CPU de 32 de biți bazat pe arhitectura RISC-V (RV32IM), care suportă extensia Zba și este echipat cu un coprocessor bignum pentru operații aritmetice cu numere mari. Implementarea nucleului CPU este compilată într-un set de greutăți și integrată într-un model lingvistic mai mare sub formă de 11 straturi suplimentare de transformatoare, adăugate înaintea straturilor principale Qwen. Calculul se realizează direct în timpul trecerii directe (forward pass) a rețelei neuronale, fără a conecta instrumente externe sau pluginuri.
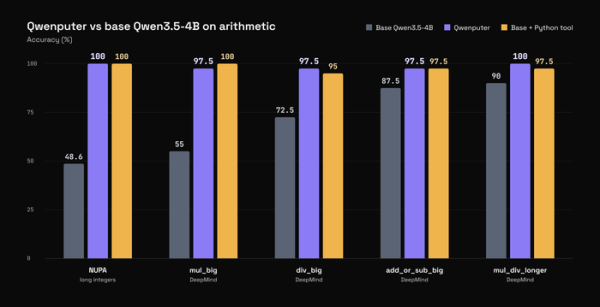
Implementarea trece cu succes toate testele din setul oficial de teste riscv-tests și este capabilă să execute cod compilat în C și MicroPython. Atunci când realizează calcule aritmetice cu numere mari, Qwenputer asigură o precizie de 97.5-100%, care este comparabilă sau depășește rezultatele modelului bazic Qwen3.5 cu un interpretator Python extern conectat.
Pentru simularea memoriei operative în model este utilizată un strat separat Gated DeltaNet (RNN liniar), aplicat în modelul AI standard Qwen pentru a menține starea modificată atunci când lucrează cu feronii de context mari. Prin fixarea stării porții și aplicarea codificării unitar (one-hot), fiecare solicitare de scriere rescrie exact un rând din matricea de stare, permițând utilizarea stării DeltaNet ca memorie adresabilă de dimensiune fixă, evitând creșterea liniară a cache-ului KV (Key-Value) pe măsură ce lungimea contextului crește. În această memorie sunt stocate registrele CPU, datele și codul mașină executabil.
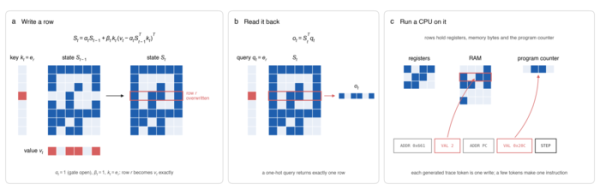
Instrucțiunile procesorului, cum ar fi citirea registrelor, operațiile aritmetice și salturile condiționate, sunt compilate direct în greutățile straturilor transformatoare. Fiecare instrucțiune este asociată cu tokenuri speciale (ADDR, VAL, STEP), pe care straturile modelului AI le interpretează ca logica de funcționare a CPU-ului. Pentru inițializarea CPU-ului și încărcarea firmware-ului se folosește un mic driver extern RvChat, dar codul mașină este procesat complet în interiorul greutăților modelului.
Printre limitările proiectului se menționează o creștere de aproximativ două ori a dimensiunii (18,8 GB) față de modelul inițial Qwen, datorată în principal umplerii suplimentare a straturilor adăugate, păstrând totodată instantanee ale stării (checkpoint). De asemenea, se remarcă o viteză de calcul relativ scăzută (aproximativ 3200 de tokeni pe secundă pe GPU L4), ceea ce face ca calculele complexe să dureze secunde și nu milisecunde.
În plus, a fost implementată o variantă a modelului AI cu un sistem de fișiere experimental, care permite stocarea în greutățile modelului AI a până la 512 fișiere cu 53 de mii de tokeni de text. Ca și în cazul memoriei RAM, stocarea este organizată în legătură cu stările DeltaNet, dar se deosebește prin faptul că FS asigură stocarea permanentă, care nu pierde starea între sesiunile de utilizare.
Lucrările de dezvoltare Qwenputer au fost, de asemenea, baza pentru cercetarea unor noi probleme potențiale de securitate în AI. Exemplul Qwenputer arată cum un model AI modificat special poate ascunde procesarea sa în starea RNN și ocolind mecanismele de monitorizare a gândirii modelului (CoT, Chain-of-Thought). De asemenea, s-a demonstrat
posibilitatea creării de mecanisme de control și monitorizare a securității, încorporate în greutățile modelului AI, pe care modelul însuși nu le poate dezactiva sau modifica.
Sursa: opennet.ro
