

Salut, Habr!
În toamna anului trecut, pe Kaggle, a avut loc o competiție de clasificare a imaginilor desenate de mână, Quick Draw Doodle Recognition, la care a participat, printre altele, echipa R-urilor formată din , și . Nu vom detalia competiția, aceasta a fost deja făcută în .
. De data aceasta nu am reușit să câștigăm medalii, dar am obținut multe experiențe valoroase, așa că ne-am propus să împărtășim comunității câteva dintre cele mai interesante și utile lucruri întâlnite pe Kaggle și în activitatea zilnică. Printre subiectele discutate: viața nu tocmai ușoară fără OpenCV, parsarea JSON-urilor (în aceste exemple sunt discutate integrările codului C++ în scripturi sau pachete R prin intermediul Rcpp), parametrizarea scripturilor și îmbinarea soluției finale în Docker. Tot codul din mesaj este disponibil într-o formă gata de utilizare în .
Cuprins:
1. Încărcarea eficientă a datelor din CSV în baza MonetDB
Datele din această competiție sunt furnizate nu sub formă de imagini gata făcute, ci sub formă de 340 de fișiere CSV (câte un fișier pentru fiecare clasă), care conțin JSON-uri cu coordonatele punctelor. Conectând aceste puncte prin linii, obținem imaginea finală cu dimensiunea de 256x256 pixeli. De asemenea, pentru fiecare înregistrare se oferă o etichetă care indică dacă imaginea a fost corect recunoscută de clasificatorul utilizat în timpul colectării setului de date, un cod din două litere al țării de origine a autorului desenului, un identificator unic, o marcă de timp și numele clasei, care corespunde cu numele fișierului. O versiune simplificată a datelor originale cântărește 7.4 GB în arhivă și aproximativ 20 GB după decompresie, iar datele complete după decompresie ocupă 240 GB. Organizatorii au garantat că ambele versiuni reproduc aceleași desene, adică versiunea completă este redundantă. În orice caz, stocarea a 50 de milioane de imagini în fișiere grafice sau sub formă de matrice a fost imediat considerată nerentabilă, așa că am decis să îmbinăm toate fișierele CSV din arhivă train_simplified.zip într-o bază de date, generând apoi imaginile de dimensiunea necesară „la cerere” pentru fiecare lot.
Ca sistem de gestionare a bazelor de date, am ales o soluție bine-testată MonetDB, și anume implementarea pentru R sub formă de pachet . Pachetul include versiunea embedded a serverului de baze de date și permite lansarea serverului direct din sesiunea R și lucrul cu acesta. Crearea unei baze de date și conectarea la aceasta se face cu o singură comandă:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Va trebui să creăm două tabele: una pentru toate datele, alta pentru informațiile de sistem despre fișierele încărcate (utilă în cazul în care ceva nu merge conform planului și procesul trebuie reluat după încărcarea mai multor fișiere):
Crearea tabelelor
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Cea mai rapidă metodă de încărcare a datelor în Baza de Date s-a dovedit a fi copierea directă a fișierelor CSV folosind SQL — comanda COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, unde numele_tabelei — numele tabelului și cale — calea către fișier. În timpul lucrului cu arhiva, s-a descoperit că implementarea încorporată unzip în R nu funcționează corect cu unele fișiere din arhivă, astfel că am folosit sistemul unzip (cu ajutorul parametrului getOption("unzip")).
Funcția pentru a scrie în bază
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
În cazul în care este necesară transformarea tabelului înainte de a fi scris în baza de date, este suficient să trimitem funcția care va transforma datele ca argument. preprocess Codul pentru încărcarea secvențială a datelor în bază:
Scrierea datelor în bază
Timpul de încărcare a datelor poate varia în funcție de caracteristicile de viteză ale mediului de stocare utilizat. În cazul nostru, citirea și scrierea pe un SSD sau de pe un stick USB (fișierul sursă) pe SSD (DB) durează mai puțin de 10 minute.
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Câteva secunde suplimentare sunt necesare pentru a crea o coloană cu eticheta de clasă întreagă și o coloană de indice (
ORDERED INDEX) cu numerele de rând, pe care se va realiza selecția observațiilor la crearea loturilor:Crearea coloanelor și indicelui suplimentare
message("Generate lables") invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int")) invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))message("Generate row numbers") invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial")) invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
message("Generează etichete")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generează numere de rând")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Pentru a rezolva problema generării unui lot „în mișcare”, a fost necesar să obținem viteza maximă de extragere a rândurilor aleatorii din tabel. doodles. Pentru asta, am folosit 3 trucuri. Primul a constat în reducerea dimensiunii tipului în care este stocat ID-ul observației. În setul de date inițial, pentru stocarea ID-ului este necesar tipul bigint, dar numărul de observații permite stocarea identificatorilor care corespund ordinii lor în tipul int. Căutarea se desfășoară semnificativ mai rapid. Al doilea truc a fost utilizarea ) cu numerele de rând, pe care se va realiza selecția observațiilor la crearea loturilor: — la această soluție am ajuns empiri c, testând toate variantele disponibile . Al treilea a constat în utilizarea cererilor parametrizate. Esența metodei este executarea comenzii PREPARE o dată, urmată de utilizarea expresiei pregătite la crearea unui lot de cereri de același tip, dar în realitate câștigul comparativ cu cererile simple SELECT a fost în jurul erorii statistice.
Procesul de încărcare a datelor consumă nu mai mult de 450 MB de RAM. Așadar, abordarea descrisă permite manipularea seturilor de date de câteva zeci de gigabayți practic pe orice hardware bugetar, inclusiv unele plăci unice, ceea ce este destul de impresionant.
Rămâne să măsurăm viteza de extragere a datelor (aleatorii) și să evaluăm scalabilitatea la selecția unor loturi de dimensiuni diferite:
Benchmark-ul bazei de date
library(ggplot2)

set.seed(0)
# Conectare la baza de date
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funcție pentru pregătirea cererii pe server
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funcție pentru extragerea datelor
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Efectuarea măsurătorilor
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametrii benchmark-ului
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("timp median, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 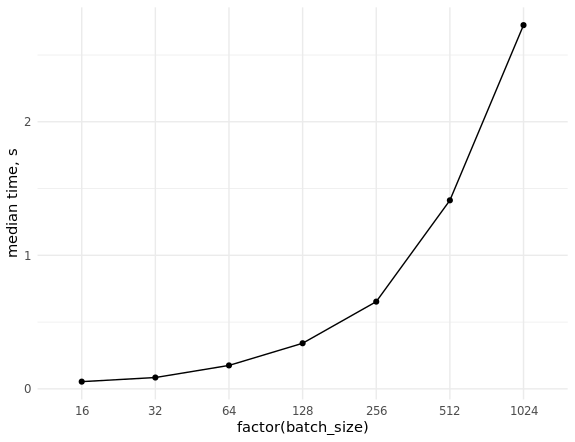
2. Pregătirea batch-urilor
Întregul proces de pregătire a batch-urilor constă în următoarele etape:
- Parsing-ul mai multor JSON-uri, care conțin vectori de șiruri cu coordonatele punctelor.
- Desenarea liniilor colorate pe baza coordonatelor punctelor pe o imagine de dimensiunea dorită (de exemplu, 256×256 sau 128×128).
- Transformarea imaginilor obținute într-un tensor.
În cadrul competiției dintre kernel-urile Python, problema a fost rezolvată preponderent cu ajutorul OpenCV. Unul dintre cele mai simple și evidente echivalente în R ar avea următoarea formă:
Implementarea transformării JSON în tensor în R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsare JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Ștergerea fișierului temporar la finalizarea funcției
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Diagramă goală
  plot.new()
  # Dimensiunea ferestrei graficului
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Culorile liniilor
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Transformarea imaginii într-un array tridimensional
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Unificarea array-urilor tridimensionale ale imaginilor într-un array cvadimensional în tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Desenarea se efectuează cu ajutorul funcțiilor standard R, salvându-se într-un PNG temporar, stocat în RAM (în Linux directoarele temporare R se află în directorul /tmp, montat în RAM). Apoi, acest fișier este citit ca un array tridimensional cu numere în intervalul de la 0 la 1. Acest lucru este important, deoarece BMP-ul mai comun ar fi fost citit ca un array raw cu coduri hex pentru culori.
Să testăm rezultatul:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 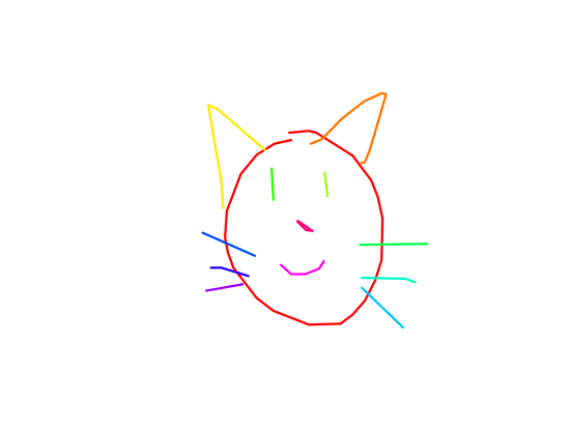
Batch-ul se va forma în felul următor:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Această implementare ni s-a părut suboptimă, deoarece formarea batch-urilor mari durează o perioadă inacceptabil de lungă, așa că am decis să ne folosim de experiența colegilor, utilizând o bibliotecă puternică OpenCV. La acea vreme nu exista un pachet gata pentru R (nu există nici acum), așa că a fost scrisă o implementare minimă a funcționalității necesare în C++ cu integrare în codul R prin intermediul Rcpp.
Pentru a rezolva sarcina, au fost utilizate următoarele pachete și biblioteci:
OpenCV pentru lucrul cu imagini și desenarea liniilor. Au fost utilizate biblioteci și fișiere de antet sistemice preinstalate, precum și linkare dinamică.
xtensor pentru lucrul cu tablouri multidimensionale și tensori. Am utilizat fișiere de antet incluse în pachetul R cu același nume. Biblioteca permite manipularea tablourilor multidimensionale, atât în ordinea row major, cât și în ordinea column major.
ndjson pentru parsarea JSON-ului. Această bibliotecă este folosită în xtensor automat, în cazul în care este disponibilă în proiect.
RcppThread pentru organizarea procesării multithreading a vectorilor din JSON-uri. Am folosit fișierele de antet furnizate de acest pachet. Spre deosebire de RcppParallel pachetul se distinge printre altele printr-un mecanism încorporat de întrerupere a loop-ului (interrupt).
Merită menționat că xtensor s-a dovedit a fi o adevărată descoperire: pe lângă faptul că dispune de un funcționalitate extinsă și performanțe ridicate, dezvoltatorii săi s-au dovedit a fi foarte receptivi și au răspuns rapid și detaliat la întrebările apărute. Cu ajutorul lor, am reușit să implementăm transformările matricelor OpenCV în tensori xtensor, precum și o metodă de combinare a tensurilor tridimensionale ale imaginilor într-un tensor cvadridimensional de dimensiuni corecte (practic, batch).
Materiale pentru studierea Rcpp, xtensor și RcppThread
Pentru compilarea fișierelor care utilizează fișiere de sistem și link-uri dinamice cu bibliotecile instalate în sistem, am folosit mecanismul de pluginuri implementat în pachetul Rcpp. Pentru a găsi automat căile și flagurile am folosit o utilitară populară linux pkg-config.
Implementarea pluginului Rcpp pentru utilizarea bibliotecii OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Posibile nume de pachet
  pkg_config_name <- c("opencv", "opencv4")
  # Fișierul binar al utilitarului pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Verificarea existenței utilitarului în sistem
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Verificarea existenței fișierului de configurare OpenCV pentru pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Ca urmare a activității pluginului, în timpul compilării vor fi înlocuite următoarele valori:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Codul pentru implementarea parcingului JSON și formarea unui lot pentru a fi transmis în model este prezentat sub spoiler. Adăugăm inițial directorul local al proiectului pentru a căuta fișierele header (necesar pentru ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementarea transformării JSON în tensor în C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Acest cod trebuie plasat într-un fișier src/cv_xt.cpp și compilat cu comanda Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); de asemenea, va fi necesar nlohmann/json.hpp din . Codul este împărțit în mai multe funcții:
to_xt— funcție șablonizată pentru transformarea matricii de imagine (cv::Mat) în tensorxt::xtensor;parse_json— funcția parcurge stringul JSON, extragând coordonatele punctelor, ambalându-le într-un vector;ocv_draw_lines— din vectorul obținut de puncte desenează linii colorate;process— combină funcțiile descrise mai sus, adăugând și posibilitatea de scalare a imaginii obținute;cpp_process_json_str— un wrapper pentru funcțiaprocess, care exportă rezultatul într-un obiect R (masiv multidimensional);cpp_process_json_vector— un wrapper pentru funcțiacpp_process_json_str, care permite procesarea unui vector de stringuri în mod multithread.
Pentru desenarea liniilor colorate s-a folosit modelul de culoare HSV urmat de conversia în RGB. Să testăm rezultatul:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 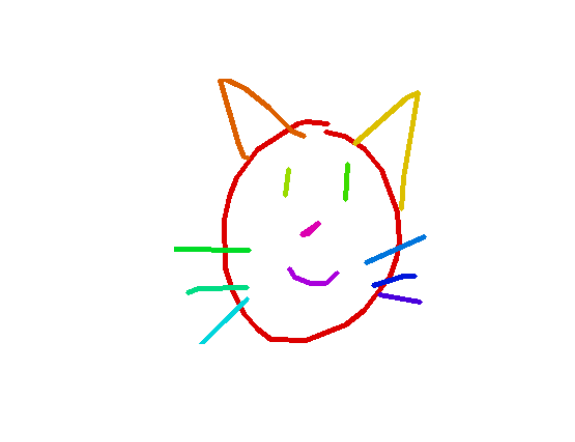
Compararea vitezei de execuție a implementărilor în R și C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parametrii de benchmark
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Efectuarea măsurătorii
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>         <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("timp mediu, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 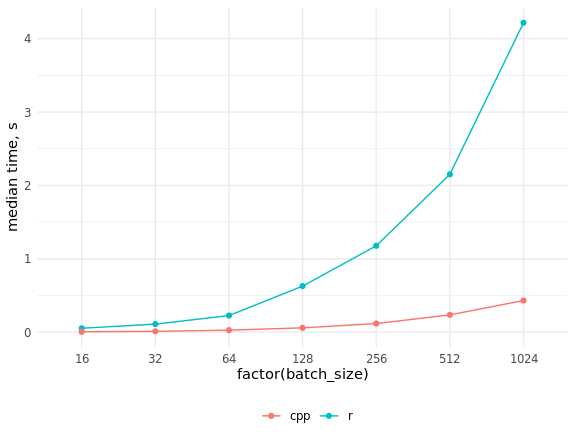
După cum vedem, creșterea vitezei s-a dovedit a fi foarte semnificativă, și nu este posibil să ajungem codul C++ prin paralelizarea codului R.
3. Iteratori pentru extragerea batch-urilor din DB
R are a well-deserved reputation as a language for processing data that fits into RAM, while Python is more characteristic of iterative data processing, allowing for easy and seamless implementation of out-of-core computations (computations using external memory). A classic and relevant example for us in the context of the task described is deep neural networks, trained using the gradient descent method, with gradient approximation at each step on a small batch of observations, or mini-batch.
Deep learning frameworks written in Python have special classes that implement iterators over data: tables, images in folders, binary formats, etc. You can use ready-made options or write your own for specific tasks. In R, we can take advantage of all the possibilities of the Python library keras with its various backends using the eponymous package, which in turn works on top of the package reticulate. The latter deserves a separate extensive article; it not only allows you to run Python code from R but also facilitates the transfer of objects between R and Python sessions, automatically performing all necessary type conversions.
We have freed ourselves from the need to store all data in RAM by using MonetDBLite; all "neural network" work will be handled by the original code in Python; we only need to write an iterator for the data, as there is no ready-made solution for this scenario in either R or Python. There are essentially two requirements for it: it must return batches in an infinite loop and maintain its state between iterations (the latter can be simply implemented in R using closures). Previously, it was necessary to explicitly convert R arrays to numpy arrays within the iterator, but the current version of the package keras does this automatically.
The iterator for training and validation data turned out as follows:
Iterator for training and validation data
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
The function takes a variable with a database connection, the row numbers used, the number of classes, the batch size, and the scale (scale = 1 corresponds to rendering images of 256x256 pixels, scale = 0.5 — 128x128 pixels), and a color indicator (color = FALSE sets the rendering in grayscale when used culoare = TRUE fiecare trăsătură este desenată cu o nouă culoare) și un indicator de preprocesare pentru rețelele pre-antrenate pe imagenet. Acestuia îi este necesar să scaleze valorile pixelilor din intervalul [0, 1] în intervalul [-1, 1], care a fost utilizat în timpul antrenării livrate împreună cu keras modelele.
Funcția externă conține verificarea tipurilor de argumente, o tabelă data.table cu numere de rând amestecate aleatoriu din samples_index și numerele batch-urilor, un contor și numărul maxim de batch-uri, precum și o expresie SQL pentru extragerea datelor din baza de date. În plus, am definit în interior un echivalent rapid al funcției keras::to_categorical(). Am folosit aproape toate datele pentru antrenare, lăsând 0.5% pentru validare, astfel că dimensiunea epocii a fost limitată de parametrul steps_per_epoch la apelul keras::fit_generator(), și condiția if (i > max_i) s-a activat doar pentru iteratorul de validare.
În funcția internă are loc extragerea indicilor de rând pentru următorul batch, extragerea înregistrărilor din baza de date cu creșterea contorului batch-urilor, parsarea JSON-urilor (funcția cpp_process_json_vector(), scrisă în C++) și crearea array-urilor corespunzătoare imaginilor. Apoi se creează vectorii one-hot cu etichete de clasă, array-urile cu valori de pixeli și etichetele sunt combinate într-o listă, care devine valoarea returnată. Pentru accelerarea lucrului, s-a utilizat crearea indicilor în tabele data.table și modificarea prin referință — fără aceste «trucuri», pachetul data.table este destul de greu de imaginat cum ar funcționa eficient cu volume de date semnificative în R.
Rezultatele măsurătorilor vitezei de lucru pe un Core i5 de laptop arată astfel:
Benchmark-ul iteratorului
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indeces for the training set
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indeces for the validation set
val_ind <- ind[-train_ind]
rm(ind)
# Scale factor
scale <- 0.5

# Conducting the measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 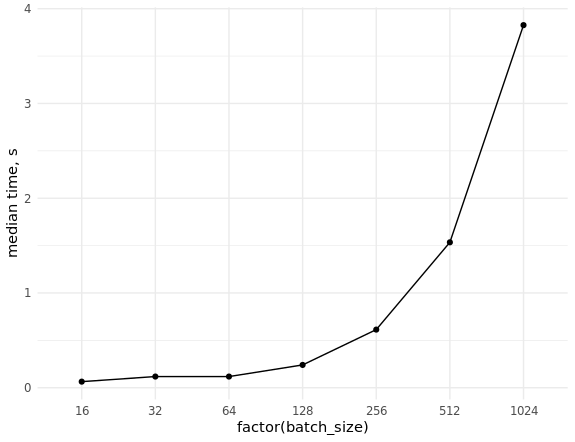
Dacă există o cantitate suficientă de RAM, se poate accelera semnificativ funcționarea bazei de date prin transferul acesteia în RAM (pentru sarcina noastră, 32 GB sunt suficiente). În Linux, implicit, se montează o partiție /dev/shm, care ocupă până la jumătate din volumul RAM-ului. Se poate aloca și mai mult, modificând /etc/fstab, astfel încât să rezulte o înregistrare de forma tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Este obligatoriu să repornim și să verificăm rezultatul, executând comanda df -h.
Iteratorul pentru datele de testare este mult mai simplu, deoarece întregul set de date de testare încap în RAM:
Iteratorul pentru datele de testare
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Selectarea arhitecturii modelului
Prima dintre arhitecturile folosite a fost , ale cărei caracteristici sunt discutate în mesaj. Aceasta este inclusă în livrarea standard keras și, în consecință, este disponibilă în pachetul omonim pentru R. Însă, la încercarea de a o folosi cu imagini monocromatice, s-a dovedit un lucru ciudat: tensorul de intrare trebuie să aibă întotdeauna dimensiunea (batch, height, width, 3), adică numărul de canale nu poate fi schimbat. În Python, această constrângere nu există, așa că ne-am grăbit și am scris propria noastră implementare a acestei arhitecturi, urmând articolul original (fără dropout, care există în varianta Keras):
Arhitectura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Dezavantajele acestei abordări sunt evidente. Vrem să verificăm multe modele, dar nu dorim să rescriem fiecare arhitectură manual. De asemenea, am fost lipsiți de posibilitatea de a utiliza greutățile modelelor pre-antrenate pe imagenet. Ca de obicei, studiul documentației a ajutat. Funcția get_config() permite obținerea unei descrieri a modelului într-o formă editabilă (base_model_conf$layers — o listă simplă de tip R), iar funcția from_config() efectuează conversia inversă într-un obiect model:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Acum nu este dificil să scriem o funcție universală pentru obținerea oricăreia dintre modelele livrate keras cu greutăți antrenate pe imagenet sau fără:
Funcția pentru a încărca arhitecturi gata făcute
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Verificarea argumentelor
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Obținem obiectul din pachetul keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Verificarea existenței obiectului în pachet
  if (is.null(model_fun)) {
    stop("Modelul ", shQuote(name), " nu a fost găsit.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Dacă imaginea nu este color, schimbăm dimensiunea intrării
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Când se utilizează imagini monocromatice, greutțile pre-antrenate nu sunt folosite. Acest lucru ar putea fi remediat: folosind funcția get_weights() pentru a obține greutățile modelului sub formă de listă de array-uri R, schimbați dimensiunea primului element din această listă (luând un singur canal de culoare sau medind cele trei), iar apoi încărcați greutățile înapoi în model folosind funcția set_weights(). Nu am adăugat această funcționalitate, deoarece la acel moment era deja clar că este mai eficient să lucrăm cu imagini color.
Am efectuat majoritatea experimentelor utilizând versiunile 1 și 2 ale mobilenet, precum și resnet34. În această competiție, arhitecturi mai moderne, precum SE-ResNeXt, s-au comportat bine. Din păcate, nu am avut implementări gata disponibile, iar propriile noastre nu le-am scris (dar cu siguranță le vom scrie).
5. Parametrizarea scripturilor
Pentru comoditate, tot codul pentru lansarea antrenamentului a fost organizat sub formă de script unic, parametrizat folosind în următorul mod:
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Afișează acest mesaj.
  -l --list-models            Listează modelele disponibile.
  -m --model=          Numele modelului rețelei neuronale [default: mobilenet_v2].
  -b --batch-size=      Dimensiunea lotului [default: 32].
  -s --scale-factor=   Factorul de scară [default: 0.5].
  -c --color                  Folosește linii colorate [default: FALSE].
  -d --db-dir=          Calea către directorul bazei de date [default: Sys.getenv("db_dir")].
  -r --validate-ratio= Raportul de validare a eșantioanelor [default: 0.995].
  -n --n-gpu=         Numărul de GPU-uri [default: 1].
'
args <- docopt::docopt(doc)
Pachet docopt reprezintă o implementare pentru R. Cu ajutorul său, scripturile sunt lansate cu comenzi simple precum Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db sau ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, dacă fișierul train_nn.R este executabil (această comandă va lansa antrenamentul modelului resnet50 pe imagini colorate de dimensiuni 128x128 pixeli, baza de date trebuie să se afle în folderul /home/andrey/doodle_db). În lista pot fi adăugate rata de învățare, tipul optimizerului și orice alte parametrii configurabili. În timpul pregătirii publicației, s-a constatat că arhitectura mobilenet_v2 din versiunea actualizată keras în R utilizare din cauza modificărilor neînregistrate în pachetul R — așteptăm să se remedieze.
Această abordare a permis accelerarea semnificativă a experimentelor cu diferite modele comparativ cu lansarea mai tradițională a scripturilor în RStudio (ca o alternativă posibilă, am menționat pachetul ). Dar principalul avantaj constă în posibilitatea de a gestiona cu ușurință pornirea scripturilor în Docker sau pur și simplu pe server, fără a instala RStudio pentru aceasta.
6. Dockerizarea scripturilor
Am folosit Docker pentru a asigura portabilitatea mediului de antrenament al modelelor între membrii echipei și pentru desfășurarea rapidă în cloud. Începerea familiarizării cu acest instrument relativ neobișnuit pentru programatorii R poate fi realizată prin serii de publicații sau prin .
Docker permite atât crearea de imagini personalizate "de la zero", cât și utilizarea altor imagini ca bază pentru a crea propriile imagini. Analizând opțiunile existente, am ajuns la concluzia că instalarea driverelor NVIDIA, CUDA+cuDNN și a bibliotecilor Python reprezintă o parte considerabilă din imagine, așa că am decis să folosim imaginea oficială ca bază. tensorflow/tensorflow:1.12.0-gpu, adăugând acolo pachetele R necesare.
Fișierul final Docker a ieșit astfel:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Pentru comoditate, pachetele utilizate au fost mutate în variabile; majoritatea scripturilor scrise sunt copiate în interiorul containerelor în timpul construirii. De asemenea, am schimbat shell-ul în /bin/bash pentru a facilita utilizarea conținutului /etc/os-release. Acest lucru a permis evitarea necesității de a specifica versiunea sistemului de operare în cod.
În plus, a fost scris un mic script bash care permite rularea containerului cu diverse comenzi. Acestea pot fi scripturi pentru antrenarea rețelelor neuronale, care au fost plasate anterior în interiorul containerului, sau shell-ul pentru depanare și monitorizarea funcționării containerului:
Script pentru rularea containerului
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Dacă acest bash script este rulat fără parametri, în interiorul containerului va fi apelat un script train_nn.R cu valori implicite; dacă primul argument pozițional este „bash”, atunci containerul va porni în modul interactiv cu shell-ul de comandă. În toate celelalte cazuri, se fac substituții ale valorilor argumentelor poziționale: CMD="Rscript /app/train_nn.R $@".
Merită menționat că directoarele cu datele sursă și baza de date, precum și directorul pentru salvarea modelelor antrenate sunt montate în interiorul containerului din sistemul gazdă, permițând accesul la rezultatele execuției scripturilor fără manipulații suplimentare.
7. Utilizarea mai multor GPU în Google Cloud
Una dintre caracteristicile competiției a fost datele destul de zgomotoase (vezi imaginea principală, preluată de la @Leigh.plt din ODS-slack). Combaterea acestei probleme a fost ajutată de batch-uri mari, iar după experimente pe un PC cu 1 GPU am decis să explorăm antrenarea modelelor pe mai multe GPU în cloud. Am folosit Google Cloud () datorită diversității mari de configurații disponibile, prețurilor acceptabile și a bonusului de 300 $; din lăcomie, am comandat un instanț cu 4xV100 cu SSD și mult RAM, și aceasta a fost o mare greșeală. O astfel de mașină consumă rapid bani, iar experimentele fără un pipeline bine definit te pot falimenta. Pentru scopuri de învățare, mai bine este să iei K80. Totuși, cantitatea mare de RAM a fost utilă - SSD-ul din cloud nu a impresionat prin rapiditate, așa că baza de date a fost mutată pe dev/shm.
Cel mai interesant fragment de cod este cel responsabil pentru utilizarea mai multor GPU. Mai întâi, modelul este creat pe CPU folosind un manager de context, exact ca în Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Apoi, modelul necompilat (acest lucru este important) este copiat pe numărul specificat de GPU disponibili, și abia după aceea este compilat:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Nu am reușit să implementăm metoda clasică de înghețare a tuturor straturilor, cu excepția ultimului, antrenând ultimul strat, dezghețând și continuând antrenarea modelului în întregime pentru mai multe GPU.
Am monitorizat antrenarea fără utilizarea tensorboard, limitându-ne la înregistrarea jurnalelor și salvarea modelelor cu nume informative după fiecare epocă:
Callback-uri
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. În loc de concluzie
O serie de probleme cu care ne-am confruntat nu au fost încă rezolvate:
- în keras nu există o funcție gata făcută pentru căutarea automată a celor mai bune viteze de învățare (analog cu
lr_finderîn biblioteca fast.ai); depunând unele eforturi, se pot porta implementări externe pe R, de exemplu, ; - ca urmare a punctului anterior, nu am reușit să găsim viteza corectă de învățare atunci când folosim mai multe GPU-uri;
- lipsesc arhitecturi moderne de rețele neuronale, în special cele pre-antrenate pe imagenet;
- nu există politica one cycle și ratele de învățare discriminative (cosine annealing la cererea noastră a fost , mulțumesc ).
Ce a fost util să extragem din această competiție:
- Pe hardware relativ slab, putem lucra fără dificultate cu volume de date considerabile (de multe ori mai mari decât dimensiunea RAM-ului). Pachetul data.table economisește memorie prin modificarea în locație a tabelelor, ceea ce permite evitarea copiei acestora, și, atunci când este utilizat corect, demonstrează aproape întotdeauna cea mai mare viteză dintre toate instrumentele cunoscute pentru limbajele de scripting. Salvarea datelor într-o bază de date permite, în multe cazuri, să nu ne facem griji despre necesitatea de a încărca întregul set de date în RAM.
- Funcțiile lente în R pot fi înlocuite cu unele rapide în C++ folosind pachetul Rcpp. Dacă, în plus, folosim RcppThread sau RcppParallel, obținem implementări multi-platforme multi-threaded, așadar, codul la nivel de R nu necesită paralelizare.
- Pachetul Rcpp poate fi folosit fără cunoștințe avansate de C++, minimum necesar fiind prezentat . Fișierele de antet pentru o serie de biblioteci C excelente, cum ar fi xtensor sunt disponibile pe CRAN, astfel formându-se o infrastructură pentru realizarea proiectelor care integrează în R cod de înaltă performanță din C++. Un alt avantaj este evidențierea sintaxei și analizorul static de cod C++ în RStudio.
- docopt permite rularea scripturilor autonome cu parametrii. Aceasta este convenabilă pentru utilizarea pe un server remote, inclusiv în docker. E inconvenient să efectuezi experimente de lungă durată cu antrenarea rețelelor neuronale în RStudio, iar instalarea IDE-ului pe server nu este întotdeauna justificată.
- Docker asigură portabilitatea codului și reproducibilitatea rezultatelor între dezvoltatori cu versiuni diferite de sisteme de operare și biblioteci, precum și ușurința de a lansa pe servere. Poți rula întregul pipeline pentru antrenament cu o singură comandă.
- Google Cloud este o opțiune accesibilă pentru a experimenta cu hardware scump, dar este important să alegi cu atenție configurațiile.
- Măsurarea performanței unor fragmente de cod este foarte utilă, mai ales în combinație cu R și C++, iar cu pachetul bench — devine și foarte ușor.
În general, această experiență a fost foarte utilă și continuăm să lucrăm la soluționarea unor probleme menționate.
Sursa: habr.com
