

TL;DR: Cu patru ani în urmă, am părăsit Google cu ideea unui nou instrument pentru monitorizarea serverelor. Ideea era de a combina într-un singur serviciu funcții de obicei izolate, și analiza jurnalelor, colectarea metricilor, și a tablourilor de bord. Unul dintre principii este că serviciul trebuie să fie cu adevărat rapid, oferind dezvoltatorilor o muncă ușoară, interactivă și plăcută. Aceasta necesită procesarea seturilor de date de câțiva gigabiți în fracțiuni de secundă, fără a depăși bugetul. Instrumentele existente pentru lucru cu jurnale sunt adesea lente și neîndemânatice, așa că ne-am confruntat cu o sarcină bună: a dezvolta un instrument bine gândit pentru a oferi utilizatorilor noi senzații de lucru.
În acest articol, descriem cum am rezolvat această problemă la Scalyr aplicând metode vechi, o abordare brută, eliminând straturile inutile și evitând structurile de date complexe. Aceste lecții le puteți aplica la propriile dvs. provocări ingineresti.
Puterea școlii vechi
Analiza jurnalelor începe de obicei cu căutarea: găsirea tuturor mesajelor care corespund unui anumit șablon. La Scalyr, aceasta înseamnă zeci sau sute de gigabiți de jurnale provenind de pe mai multe servere. Abordările moderne presupun, în general, construirea unei structuri complexe de date, optimizată pentru căutare. Am văzut cu siguranță asta la Google, unde sunt foarte buni în astfel de lucruri. Dar ne-am oprit la o abordare mult mai brută: scanarea liniară a jurnalelor. Și a funcționat - oferim o interfață cu căutare cu un ordin de magnitudine mai rapidă decât a concurenților (consultați animația de la final).
Realizarea cheie a fost că procesoarele moderne sunt de fapt foarte rapide în operațiuni simple și directe. Este ușor să ratezi acest lucru în sisteme complexe și multi-stratate care depind de viteza I/O și operațiunile de rețea, care sunt foarte comune astăzi. Așadar, am dezvoltat un design care minimizează numărul de straturi și de gunoi inutil. Cu mai multe procesoare și servere în paralel, viteza de căutare ajunge la 1 TB pe secundă.
Concluzii cheie din acest articol:
- Căutarea brută este o abordare perfect viabilă pentru a rezolva probleme reale, la scară largă.
- Forța brută este o tehnică de proiectare, nu o eliberare de muncă. Ca orice tehnică, este mai bine adaptată pentru anumite probleme decât pentru altele, și poate fi implementată prost sau bine.
- Forța brută este deosebit de eficientă pentru a atinge stabilitate performanță.
- Utilizarea eficientă a forței brute necesită optimizarea codului și aplicarea în timp util a unui număr suficient de resurse. Aceasta este potrivită dacă serverele dumneavoastră sunt supuse unei mari sarcini, fără a fi legată de utilizatori, iar operațiunile utilizatorilor rămân prioritare.
- Performanța depinde de designul întregului sistem, nu doar de algoritmul buclei interne.
(Această articole descrie căutarea datelor în memorie. În majoritatea cazurilor, când un utilizator caută în loguri, serverele Scalyr deja le-au stocat la cache. În articolul următor, vom discuta despre căutarea în loguri necache-uite. Se aplică aceleași principii: cod eficient, metoda forței brute cu resurse computaționale mari).
Metoda forței brute
În mod tradițional, căutarea într-un set mare de date se face după indexul cuvintelor cheie. În contextul logurilor de server, aceasta înseamnă a căuta fiecare cuvânt unic în jurnal. Pentru fiecare cuvânt, trebuie să se compună o listă a tuturor aparițiilor. Acest lucru facilitează găsirea tuturor mesajelor cu acest cuvânt, de exemplu 'eroare', 'firefox' sau 'transaction_16851951' — pur și simplu ne uităm în index.
Am folosit această abordare în Google și a funcționat bine. Dar în Scalyr căutăm în loguri byte cu byte.
De ce? Dintr-o perspectivă algoritmică abstractă, indecșii cuvintelor cheie sunt mult mai eficienți decât căutarea brută. Cu toate acestea, nu vindem algoritmi, vindem performanță. Și performanța nu înseamnă doar algoritmi, ci și inginerie sistemică. Trebuie să luăm în considerare totul: volumul de date, tipul de căutare, echipamentul disponibil și contextul software. Am decis că pentru problema noastră specifică, o variantă precum 'grep' se potrivește mai bine decât un index.
Indecșii sunt excelenți, dar au limitări. Un singur cuvânt este ușor de găsit. Însă căutarea mesajelor cu mai multe cuvinte, precum 'googlebot' și '404', este deja mult mai complicată. Căutarea unei fraze precum 'exceptie necontrolata' necesită un index mai voluminos, care înregistrează nu doar toate mesajele cu acest cuvânt, ci și locația specifică a cuvântului.
Dificultatea reală apare atunci când căutați nu cuvinte. Să presupunem că doriți să vedeți câte vizite vin de la roboți. Prima idee ar fi căutarea în jurnale după cuvântul „bot”. Așa veți găsi câțiva roboți: Googlebot, Bingbot și mulți alții. Dar aici „bot” este mai mult o parte decât un cuvânt. Dacă căutăm „bot” în indice, nu vom găsi mesajele care includ cuvântul „Googlebot”. Dacă verificăm fiecare cuvânt din indice și apoi scanăm indicele pe baza cuvintelor cheie găsite, căutarea devine mult mai lentă. Drept rezultat, unele programe de analiză a jurnale nu permit căutarea după părți de cuvinte sau (în cel mai bun caz) permit utilizarea unei sintaxe speciale cu o performanță mai scăzută. Vrem să evităm acest lucru.
O altă problemă este punctuația. Doriți să găsiți toate cererile de la 50.168.29.7? Что насчёт отладки логов, содержащих [eroare]? Индексы обычно пропускают пунктуацию.
În cele din urmă, inginerii iubesc instrumentele puternice și, uneori, problema poate fi rezolvată doar cu ajutorul expresiilor regulate. Indicele cuvintelor cheie nu este foarte potrivit pentru acest lucru.
În plus, indicii suntcomplexi. Fiecare mesaj trebuie adăugat în mai multe liste de cuvinte cheie. Aceste liste trebuie menținute într-un format ușor de căutat. Cererile cu fraze, fragmente de cuvinte sau expresii regulate trebuie traduse în operațiuni cu mai multe liste, iar rezultatele scanate și combinate pentru a obține un set rezultant. În contextul unui serviciu mult utilizator mare, această complexitate creează probleme de performanță care nu sunt vizibile atunci când analizăm algoritmii.
Indicii cuvintelor cheie ocupă de asemenea mult spațiu, iar stocarea este o cheltuială majoră în sistemul de gestionare a jurnalele.
Pe de altă parte, fiecare căutare poate consuma multă putere de calcul. Utilizatorii noștri apreciază căutarea rapidă pe interogări unice, dar astfel de interogări sunt realizate relativ rar. Pentru căutările tipice, de exemplu, pentru panoul de monitorizare, aplicăm tehnici speciale (despre care vom vorbi în articolul următor). Alte interogări sunt destul de rare, așa că de obicei nu trebuie să procesăm mai mult de una deodată. Dar asta nu înseamnă că serverele noastre nu sunt ocupate: ele sunt încărcate cu primirea, analizarea și comprima mesajelor noi, evaluarea notificărilor, comprimarea datelor vechi etc. Astfel, avem o rezervă considerabilă de procesoare care pot fi utilizate pentru a executa interogările.
Forța brutală funcționează dacă ai o problemă brutală (și multă putere).
Forța brutală funcționează cel mai bine pe sarcini simple cu bucle interne mici. De multe ori poți optimiza bucla internă pentru a funcționa la viteze foarte mari. Dacă codul este complex, atunci este mult mai greu de optimizat.
Inițial, codul nostru pentru căutare avea o buclă internă destul de mare. Stocăm mesaje pe pagini de 4K; fiecare pagină conține unele mesaje (în UTF-8) și metadate pentru fiecare mesaj. Metadatele sunt o structură în care sunt codificate lungimea valorii, ID-ul intern al mesajului și alte câmpuri. Bucla de căutare arăta așa:
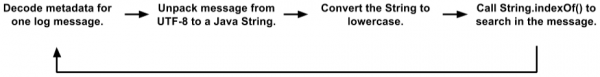
Aceasta este o variantă simplificată în comparație cu codul real. Dar chiar și aici se pot observa mai multe plasamente de obiecte, copii de date și apeluri de funcții. JVM optimizează destul de bine apelurile de funcții și alocă obiecte efemere, așa că acest cod a funcționat mai bine decât ne-ar fi meritat. În timpul testării, clienții l-au folosit cu succes. Dar, în cele din urmă, am trecut la un nou nivel.
(Te poți întreba de ce stocăm mesajele într-un format de 4K, cu text și metadate, în loc să lucrăm direct cu jurnalurile. Există numeroase motive, toate având legătură cu faptul că motorul Scalyr seamănă mai mult cu o bază de date distribuită decât cu un sistem de fișiere. Căutarea textuală este adesea combinată cu filtre de tip SGBD pe câmpuri după parsarea jurnalelor. Putem căuta simultan în multe mii de jurnale, iar fișierele text simple nu sunt potrivite pentru managementul nostru tranzacțional, replicat și distribuit al datelor).
Inițial, părea că un astfel de cod nu este foarte potrivit pentru optimizarea prin metoda de forță brută. «Lucrul adevărat» în String.indexOf() nu ocupa nici măcar o proporție semnificativă în profilul CPU. Asta înseamnă că optimizarea doar a acestui metodă nu ar aduce un efect semnificativ.
Așa s-a întâmplat că stocăm metadatele la începutul fiecărei pagini, iar textul tuturor mesajelor este împachetat în UTF-8 la celălalt capăt. Profitând de acest lucru, am rescris ciclul pentru a căuta pe întreaga pagină:
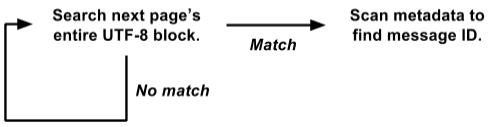
Această versiune funcționează direct pe reprezentarea raw byte[] și efectuează căutarea tuturor mesajelor simultan pe întreaga pagină de 4K.
Este mult mai ușor de optimizat pentru metoda de forță brută. Ciclul de căutare intern este apelat simultan pentru întreaga pagină de 4K, și nu separat pentru fiecare mesaj. Nu există copiere de date, nici alocare de obiecte. Iar operațiile mai complexe cu metadatele sunt apelate doar în cazul unui rezultat pozitiv, nu pentru fiecare mesaj. Astfel am eliminat o mulțime de costuri suplimentare, iar restul încărcăturii este concentrată într-un mic ciclu de căutare intern, care este bine adaptat pentru optimizare ulterioară.
Algoritmul nostru de căutare efectiv se bazează pe . Este similar cu algoritmul Boyer-Moore cu sărituri de aproximativ lungime a șirului de căutare la fiecare pas. Principala diferență este că verifică doi biți deodată, pentru a minimiza coincidențele false.
Implementarea noastră necesită crearea unei tabele de căutare de 64K pentru fiecare căutare, dar aceasta este o futilitate în comparație cu gigabyte-urile de date în care căutăm. Bucla internă procesează câteva gigabyte pe secundă pe un singur nucleu. În practică, performanța stabilă este de aproximativ 1,25 GB pe secundă pe fiecare nucleu, iar există potențial de îmbunătățire. Unele suprasarcini din afara buclei interne ar putea fi eliminate, iar noi plănuim să experimentăm cu bucla internă în C în loc de Java.
Aplicăm puterea
Am discutat despre faptul că căutarea în loguri poate fi realizată „brut”, dar câtă „putere” avem? Nu puțină.
1 nucleu: Folosit corect, un nucleu modern de procesor este destul de puternic pe cont propriu.
8 nuclee: În prezent, lucrăm pe servere Amazon hi1.4xlarge și i2.4xlarge SSD, fiecare având 8 nuclee (16 fire). Așa cum s-a menționat anterior, de obicei aceste nuclee sunt ocupate cu operațiuni de fundal. Atunci când un utilizator efectuează o căutare, operațiunile de fundal sunt suspendate, eliberând toate cele 8 nuclee pentru căutare. Căutarea se termină de obicei în fracțiuni de secundă, după care munca de fundal își reia activitatea (programul de reglementare garantează că fluxul de interogări nu interferează cu munca importantă de fundal).
16 nuclee: Pentru fiabilitate, organizăm serverele în grupuri master/slave. Fiecare master are un server SSD și unul EBS subordonat. Dacă serverul principal pică, serverul SSD preia imediat locul acestuia. Aproape tot timpul masterul și slavele funcționează normal, astfel încât fiecare bloc de date este disponibil pentru căutare pe două servere diferite (serverul subordonat EBS are un procesor slab, așa că nu îl luăm în considerare). Împărțim sarcinile între ele, astfel încât dispunem în total de 16 nuclee.
Multe nuclee: În viitorul apropiat, vom distribui datele pe servere astfel încât toate să participe la procesarea fiecărei cereri deloc triviale. Fiecare nucleu va lucra. [Notă: am realizat un plan și am crescut viteza de căutare la 1 TB/s, vezi nota de la finalul articolului].
Simplitatea asigură fiabilitate
Un alt avantaj al metodei brute este performanța destul de stabilă. De obicei, căutarea nu este prea sensibilă la detaliile sarcinii și setului de date (cred că acesta este motivul pentru care se numește „brut”).
Indicele cuvintelor cheie poate oferi uneori rezultate incredibil de rapide, iar în alte ocazii nu. Să spunem că ai 50 GB de jurnale în care termenul 'customer_5987235982' apare exact de trei ori. Căutarea acestui termen verifică direct din index cele trei locații și se finalizează instantaneu. Dar o căutare complexă cu wildcard-uri poate scana mii de cuvinte cheie și poate dura mult timp.
Pe de altă parte, căutarea prin forță brută pentru orice interogare se realizează cu o viteză mai mult sau mai puțin constantă. Căutarea cuvinte lungi este mai bună, dar chiar și căutarea unui singur caracter se desfășoară destul de repede.
Simplicitatea metodei de forță brută înseamnă că performanța sa este aproape de maximul teoretic. Există mai puține șanse pentru suprasarcină neașteptată a discurilor, conflicte la blocări, urmărirea pointerilor și alte mii de motive pentru eșecuri. Tocmai am verificat interogările efectuate de utilizatorii Scalyr săptămâna trecută pe serverul nostru cel mai ocupat. Au fost 14.000 de interogări. Exact opt dintre acestea au durat mai mult de o secundă; 99% au fost finalizate în termen de 111 milisecunde (dacă nu ai folosit unelte de analiză a jurnanelor, crede-mă: asta este rapid).
O performanță stabilă și de încredere este esențială pentru utilizarea eficientă a serviciului. Dacă acesta se blochează periodic, utilizatorii îl vor percepe ca fiind nesigur și îl vor folosi cu reticență.
Căutarea în jurnale în acțiune
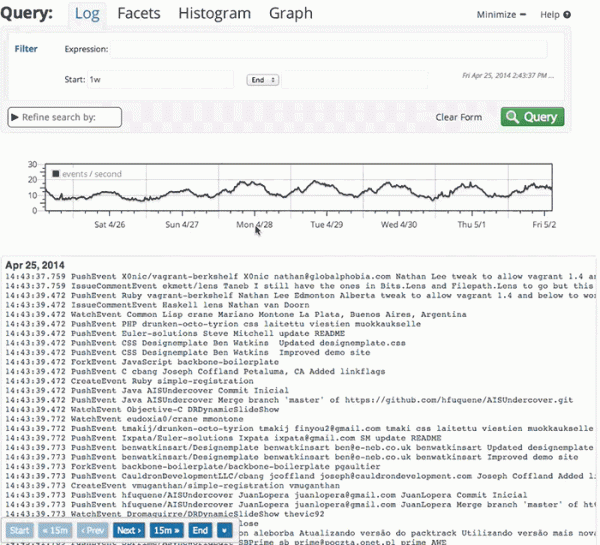
Iată o mică animație care arată căutarea Scalyr în acțiune. Avem un cont demo în care importăm fiecare eveniment din fiecare depozit public de pe Github. În această demonstrație, analizez datele din ultima săptămână: aproximativ 600 MB de jurnale brute.
Videoclipul a fost înregistrat în direct, fără pregătire specială, pe desktopul meu (aproximativ 5000 de kilometri de la server). Performanța pe care o vei vedea se datorează în mare parte , precum și unui backend rapid și fiabil. De fiecare dată când apare o pauză fără indicatorul 'loading', eu fac o pauză pentru a-ți permite să citești ce intenționez să apăs.
În concluzie
Atunci când procesați volume mari de date, este important să alegeți un algoritm bun, dar „bun” nu înseamnă „ciudat”. Gândiți-vă cum va funcționa codul vostru în practică. Analiza teoretică a algoritmilor ignoră anumite variabile care pot avea o mare importanță în lumea reală. Algoritmii mai simpli sunt mai ușor de optimizat și sunt mai stabili în situații limită.
De asemenea, gândiți-vă la contextul în care codul va fi executat. În cazul nostru, avem nevoie de servere suficient de puternice pentru a gestiona sarcinile în fundal. Utilizatorii inițiază căutări relativ rar, așa că putem împrumuta un întreg grup de servere pentru o perioadă scurtă, necesară pentru a efectua fiecare căutare.
Prin metoda forței brute, am realizat o căutare rapidă, fiabilă și flexibilă în setul de jurnale. Sperăm că aceste idei vor fi utile pentru proiectele voastre.
Revizuire: titlul și textul s-au schimbat de la „Căutare la o viteză de 20 GB pe secundă” la „Căutare la o viteză de 1 TB pe secundă” pentru a reflecta creșterea performanței în ultimii câțiva ani. Această creștere a vitezei este în principal rezultatul schimbării tipului și numărului de servere EC2 pe care le ridicăm astăzi pentru a deservi o bază de clienți crescută. Ne așteptăm la schimbări în curând, care vor aduce o altă creștere semnificativă a eficienței, iar noi așteptăm cu nerăbdare ocazia de a vorbi despre aceasta.
Sursa: habr.com
