

Baza de date pentru serii temporale (TSDB, time series database) în Prometheus 2 este un exemplu excelent de soluție inginerescă, care oferă îmbunătățiri semnificative față de stocarea v2 din Prometheus 1 în ceea ce privește viteza de acumulare a datelor și execuția interogărilor, eficiența utilizării resurselor. Am implementat Prometheus 2 în Percona Monitoring and Management (PMM) și am avut ocazia să analizez performanța TSDB din Prometheus 2. În acest articol, voi relata rezultatele acestor observații.
Încărcătura medie de lucru Prometheus
Pentru cei care sunt obișnuiți să lucreze cu baze de date de uz general, încărcătura obișnuită de lucru a lui Prometheus este destul de curioasă. Viteza de acumulare a datelor tinde să ajungă la o valoare stabilă: de obicei, serviciile pe care le monitorizați trimit un număr aproximativ constant de metrici, iar infrastructura se schimbă relativ lent.
Interogările de informații pot veni din diverse surse. Unele dintre acestea, cum ar fi alertele, tind și ele către o valoare stabilă și previzibilă. Altele, cum ar fi interogările utilizatorilor, pot provoca vârfuri, deși acest lucru nu este caracteristic pentru cea mai mare parte a încărcăturii.
Test de încărcare
În timpul testării, m-am concentrat pe capacitatea de a acumula date. Am desfășurat Prometheus 2.3.2, compilat cu Go 1.10.1 (ca parte a PMM 1.14) pe un serviciu Linode, folosind acest script: . Pentru a genera o încărcare cât mai realistă, cu ajutorul acestuia am lansat câteva noduri MySQL cu o încărcătură reală (Testul TPC-C Sysbench), fiecare dintre ele emulând 10 noduri Linux/MySQL.
Toate testele de mai jos au avut loc pe un server Linode cu opt nuclee virtuale și 32 GB de memorie, pe care au fost lansate 20 de simulări de încărcare pentru monitorizarea a două sute de instanțe MySQL. Sau, în termeni Prometheus, 800 de ținte (targets), 440 de scrapes pe secundă, 380 de mii de înregistrări (samples) pe secundă și 1,7 milioane de serii temporale active.
Design
Abordarea obișnuită a bazelor de date tradiționale, inclusiv cea utilizată de Prometheus 1.x, este legată de . Dacă aceasta nu este suficientă pentru a face față încărcăturii, veți întâmpina întârzieri mari, iar unele interogări nu vor fi executate. Utilizarea memoriei în Prometheus 2 se configurează prin cheia storage.tsdb.min-block-duration, care definează cât de mult timp vor fi stocate în memorie înregistrările înainte de a fi scrise pe disc (implicit, două ore). Cantitatea necesară de memorie va depinde de numărul de serii temporale, etichete (labels) și intensitatea colectării datelor (scrapes) în combinație cu fluxul de intrare brut. În ceea ce privește spațiul de stocare, Prometheus tinde să folosească 3 octeți pe înregistrare (sample). Pe de altă parte, cerințele de memorie sunt mult mai mari.
Deși există posibilitatea de a configura dimensiunea blocului, nu este recomandat să o faceți manual, așa că vă aflați în situația de a oferi lui Prometheus atâta memorie câtă va solicita pentru încărcătura dumneavoastră.
Dacă nu este suficientă memorie pentru a susține fluxul de metri, Prometheus va cădea din cauza lipsei de memorie sau va fi omorât de OOM killer.
Adăugarea de swap pentru a amâna momentul căderii atunci când lui Prometheus îi termină memoria nu ajută foarte mult, deoarece utilizarea acestei funcții cauzează un consum exploziv de memorie. Cred că este o problemă legată de Go, de garbage collector și de modul în care acesta lucrează cu swap.
O altă abordare interesantă ar fi configurarea scrierii blocului head pe disc la un moment prestabilit, în loc să fie măsurată începând de la startul procesului.
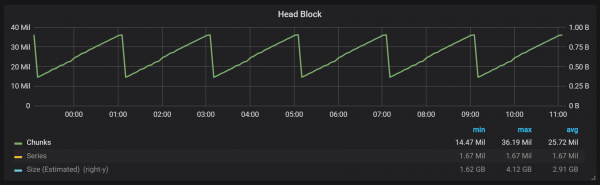
Așa cum puteți vedea din grafic, scrierile pe disc au loc la fiecare două ore. Dacă schimbați parametrul min-block-duration la o oră, aceste scrieri vor avea loc la fiecare oră, începând după o jumătate de oră.
Dacă doriți să folosiți acest grafic și alte grafice în instalarea dumneavoastră Prometheus, puteți utiliza acest . A fost dezvoltat pentru PMM, dar cu câteva modificări minore, se potrivește oricărei instalări Prometheus.
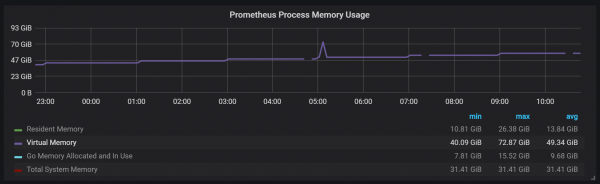
Avem un bloc activ, numit block head, care este stocat în memorie; blocurile cu date mai vechi sunt accesibile prin mmap(). Acest lucru elimină necesitatea de a configura cache-ul separat, dar înseamnă de asemenea că trebuie să lăsați suficient spațiu pentru cache-ul sistemului de operare, dacă doriți să faceți interogări la datele mai vechi decât cele conținute în block head.
Și mai înseamnă că consumul de memorie virtuală de către Prometheus va părea destul de ridicat, lucru de care nu ar trebui să vă îngrijorați.
Un alt aspect interesant al designului este utilizarea WAL (write ahead log). După cum se poate observa din documentația despre stocare, Prometheus folosește WAL pentru a evita pierderile în caz de prăbușire. Mecanismele specifice care garantează reziliența datelor, din păcate, sunt insuficient documentate. Versiunea Prometheus 2.3.2 scrie WAL pe disc la fiecare 10 secunde, iar această opțiune nu poate fi configurată de utilizator.
Compacții
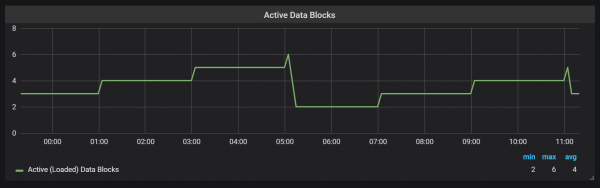
Prometheus TSDB este proiectată după modelul unui stocare LSM (Log Structured Merge — copac structurat prin jurnal cu fuziune): blocul head este scris periodic pe disc, în același timp, mecanismul de compacție combină mai multe blocuri pentru a evita scanarea unui număr prea mare de blocuri la interogări. Aici se poate observa numărul de blocuri pe care le-am observat în sistemul de testare după o zi de încărcare.
Dacă doriți să aflați mai multe despre stocare, puteți studia fișierul meta.json, care conține informații despre blocurile existente și cum au fost create acestea.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Compacțiile în Prometheus sunt legate de momentul în care blocul head este scris pe disc. În acel moment, pot fi efectuate mai multe astfel de operațiuni.
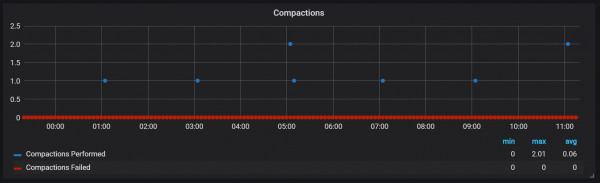
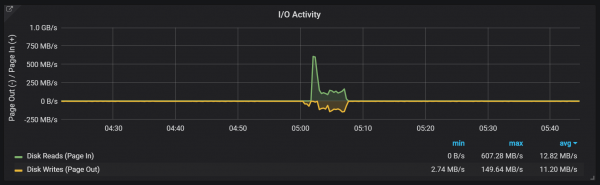
Se pare că compactările nu sunt limitate și pot provoca mari fluctuații ale I/O-ului de disc în timpul executării.
Fluctuații ale utilizării CPU
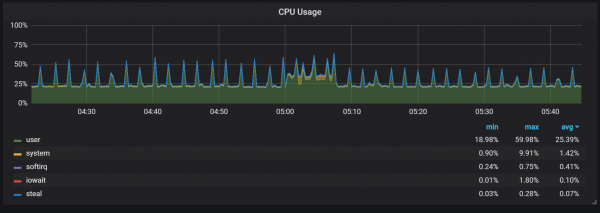
Desigur, acest lucru afectează negativ viteza de funcționare a sistemului și reprezintă, de asemenea, o provocare serioasă pentru stocările LSM: cum să realizăm compactări pentru a susține o viteză mare a interogărilor, fără a provoca un overhead prea mare?
Utilizarea memoriei în procesul de compactare pare, de asemenea, destul de interesantă.
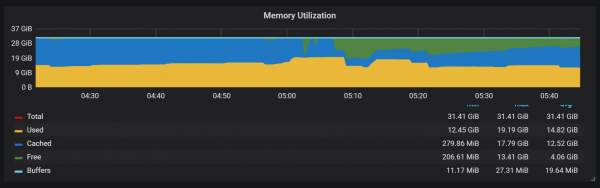
Putem observa cum, după compactare, o mare parte din memorie își schimbă starea de la Cached la Free: asta înseamnă că informațiile potențial valoroase au fost eliminate. Este interesant dacă este folosit fadvice() sau o altă tehnică de minimizare, sau dacă aceasta este cauzată de faptul că cache-ul a fost eliberat de blocurile distruse în timpul compactării?
Recuperare după incident
Restaurarea după defecțiuni necesită timp, și acest lucru este justificat. Pentru un flux de intrare de un milion de înregistrări pe secundă, a trebuit să aștept aproximativ 25 de minute pentru ca restaurarea să aibă loc, având în vedere discul SSD.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Pornind Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)" level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)" level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))" level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)" level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Începerea ascultării conexiunilor" address=:9090 level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Pornind TSDB ..." level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="bloc sănătos găsit" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="prefixul routerului" prefix=\/prometheus level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="bloc sănătos găsit" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="bloc sănătos găsit" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0 level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="bloc sănătos găsit" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="bloc sănătos găsit" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Corupția WAL detectată; tăiere" err="checksum CRC32 neașteptat d0465484, want 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363 level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB pornit" level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Încărcarea fișierului de configurare" filename=\/etc\/prometheus.yml level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Încărcarea fișierului de configurare completă" filename=\/etc\/prometheus.yml level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Serverul este gata pentru a primi cereri web."Principala problemă a procesului de recuperare este consumul ridicat de memorie. Deși într-o situație normală serverul poate funcționa stabil cu aceeași cantitate de memorie, la o cădere poate să nu se repornească din cauza OOM. Singura soluție pe care am găsit-o este să opresc colectarea datelor, să pornesc serverul, să îi permit să se recupereze și să îl repornesc cu colectarea activă.
Încălzire
Un alt comportament de care trebuie să ținem cont în timpul procesului de încălzire este raportul de performanță scăzută și consumul ridicat de resurse imediat după pornire. În timpul unor, dar nu tuturor, pornirilor am observat o sarcină serioasă pe CPU și memorie.
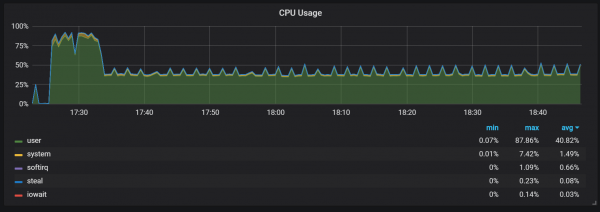
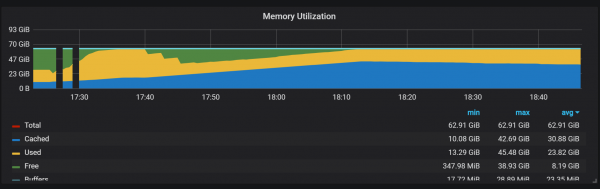
Scăderile în utilizarea memoriei sugerează că Prometheus nu poate configura toate colectările de la început, iar unele informații pot fi pierdute.
Nu am identificat motivele exacte pentru încărcarea ridicată a procesorului și memoriei. Suspectez că aceasta este legată de crearea unor noi serii temporale în head block cu o frecvență mare.
Vârfuri de încărcare pe CPU
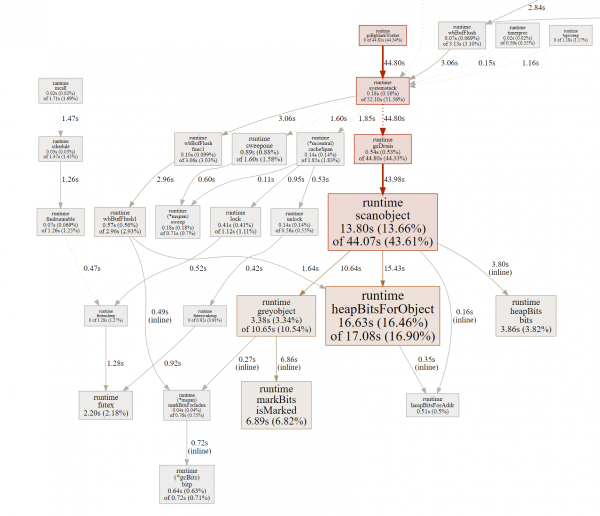
Pe lângă compresiunile care generează o încărcare destul de mare pe I/O, am observat vârfuri severe de încărcare pe procesor la fiecare două minute. Exploziile sunt mai lungi în cazul unui flux de intrare ridicat și pare că sunt cauzate de colectorul de gunoi Go, cel puțin unele nuclee sunt complet încărcate.
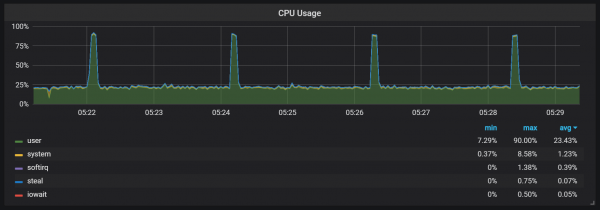
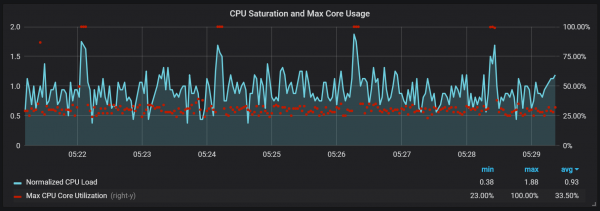
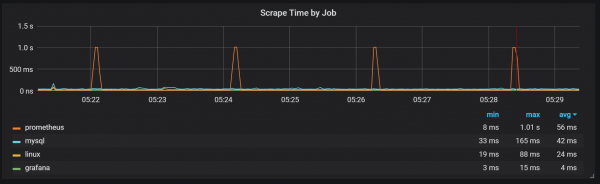
Aceste vârfuri nu sunt deloc neglijabile. Pare că atunci când apar, punctul de intrare intern și metricile Prometheus devin inaccesibile, ceea ce cauzează pierderi de date în aceleași intervale de timp.
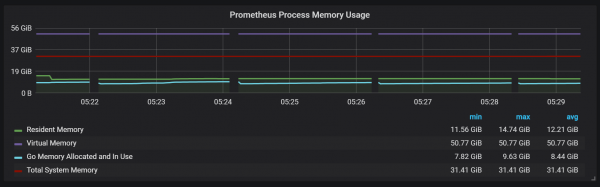
De asemenea, se poate observa că exportatorul Prometheus se blochează timp de o secundă.
Putem observa corelații cu curățarea gunoiului (GC).
Concluzie
TSDB în Prometheus 2 funcționează rapid, fiind capabil să gestioneze milioane de serii temporale și în același timp mii de înregistrări efectuate pe secundă, folosind un hardware destul de modest. Utilizarea CPU-ului și a I/O-ului pe disc este, de asemenea, impresionantă. Exemplul meu a arătat până la 200.000 de metrici pe secundă pe un singur nucleu utilizat.
Pentru planificarea extinderii, trebuie să ținem cont de volumele suficiente de memorie, iar aceasta ar trebui să fie memorie reală. Volumul de memorie utilizată pe care l-am observat a fost de aproximativ 5 GB pentru 100.000 de înregistrări pe secundă de flux de intrare, ceea ce, împreună cu cache-ul sistemului de operare, dă aproximativ 8 GB de memorie ocupată.
Desigur, mai este mult de lucru pentru a domoli vârfurile de CPU și I/O pe disc, și nu este surprinzător, având în vedere cât de tânăr este încă TSDB Prometheus 2 în comparație cu InnoDB, TokuDB, RocksDB, WiredTiger, dar toate acestea au avut probleme asemănătoare la începutul ciclului de viață.
Sursa: habr.com
