

Introducere
În acest articol, vă voi vorbi despre cunoscutul algoritm Huffman și despre aplicațiile sale în compresia datelor.
În rezultat, vom scrie un arhivator simplu. Despre aceasta mai fusese , dar fără o implementare practică. Materialul teoretic din acest post provine din lecțiile de informatică din școală și din cartea lui Robert Lafore „Structuri de date și algoritmi în Java”. Așadar, să trecem la subiect!
Puțin gândire
Într-un fișier text obișnuit, un caracter este codificat cu 8 biți (codificare ASCII) sau 16 (codificare Unicode). Mai departe, vom analiza codificarea ASCII. De exemplu, să luăm șirul s1 = „SUSIE SAYS IT IS EASYn”. În total, în șir sunt 22 de caractere, desigur, inclusiv spațiile și caracterul de întoarcere la linie - 'n'. Fișierul care conține acest șir va avea o dimensiune de 22*8 = 176 biți. Imediat se pune întrebarea: este rațional să folosim toți cei 8 biți pentru a codifica 1 caracter? Noi, până la urmă, nu folosim toate caracterele din codificarea ASCII. Chiar dacă le-am folosi, ar fi mai rațional să dăm celei mai frecvente litere — S — cel mai scurt cod posibil, iar pentru cea mai rară literă — T (sau U, sau 'n') — să dăm un cod mai lung. Aceasta este esența algoritmului Huffman: trebuie găsit cea mai optimă variantă de codificare, astfel încât fișierul să aibă dimensiunea minimă. Este absolut normal că diferite caractere vor avea lungimi diferite ale codului — pe aceasta se bazează algoritmul.
Codificare
De ce să nu dăm caracterului 'S' un cod, de exemplu, cu o lungime de 1 bit: 0 sau 1. Să luăm 1. Atunci, celui de-al doilea caracter cel mai des întâlnit — ' ' (spațiul) — îi dăm 0. Imaginați-vă că ați început să decodificați mesajul dvs. — șirul codificat s1 — și vedeți că codul începe cu 1. Ce să facem: este caracterul S sau este vreun alt caracter, de exemplu A? De aceea apare o regulă importantă:
Niciun cod nu trebuie să fie prefix pentru altul
Această regulă este cheia algoritmului. Prin urmare, crearea unui cod începe cu un tabel de frecvență, în care este specificată frecvența (numărul de apariții) fiecărui caracter:
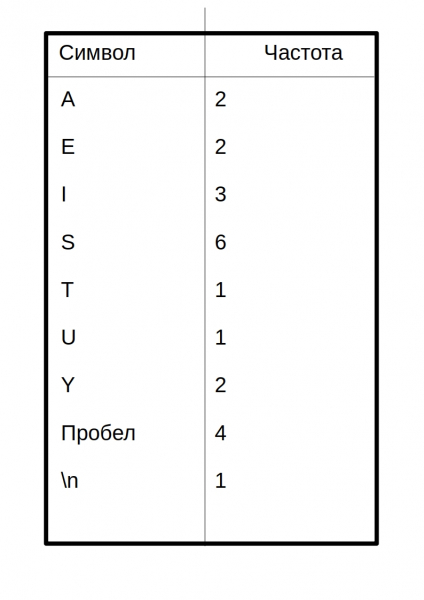 Caracterele cu cea mai mare frecvență trebuie să fie codificate cu cel mai mic număr posibil de biți. Iată un exemplu de una dintre posibilele tabele de coduri:
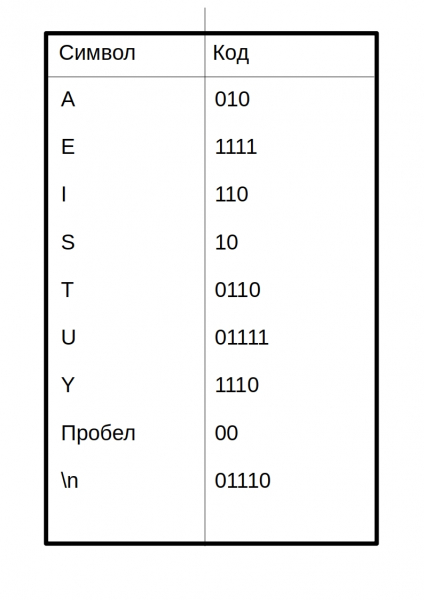 Astfel, mesajul codificat va arăta așa:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Codul fiecărui caracter este separat printr-un spațiu. În realitate, într-un fișier comprimat, nu va fi așa!
Se ridică întrebarea: cum a conceput acest novice codul pentru a crea o tabelă de coduri? Despre aceasta va fi vorba mai jos.
Construirea arborelui Huffman
Aici intervin arborii binari de căutare. Nu vă faceți griji, metodele de căutare, inserare și ștergere nu sunt necesare aici. Iată structura arborelui în Java:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Acesta nu este codul complet, codul complet va fi mai jos.
Iată algoritmul de construire a arborelui:
- Creează un obiect Node pentru fiecare caracter din mesaj (string s1). În cazul nostru vor fi 9 noduri (obiecte Node). Fiecare nod constă din două câmpuri de date: caracter și frecvență.
- Creează un obiect Tree (BinaryTree) pentru fiecare dintre nodurile Node. Nodul devine rădăcina arborelui.
- Introduceți aceste arbori în coada de prioritate. Cu cât frecvența este mai mică, cu atât prioritatea este mai mare. Astfel, la extragere se alege întotdeauna arborele cu cea mai mică frecvență.
Apoi, trebuie să executați ciclic următoarele:
- Extrageți două arbori din coada de prioritate și faceți-i descendenți ai unui nou nod (nodul creat recent fără caracter). Frecvența noului nod este suma frecvențelor celor două arbori descendenți.
- Pentru acest nod creați un arbore cu rădăcina în acest nod. Introduceți acest arbore din nou în coada de prioritate. (Deoarece arborele are o frecvență nouă, cel mai probabil va ocupa o nouă poziție în coadă.)
- Continuați executarea pașilor 1 și 2 până când în coadă rămâne un singur arbore — arborele Huffman.
Să analizăm acest algoritm pe stringul s1:
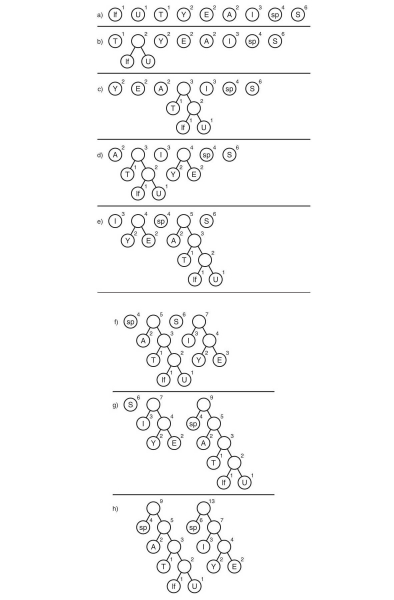
Aici simbolul «lf» (linefeed) indică trecerea la o nouă linie, «sp» (space) — este un spațiu.
Ce urmează?
Am obținut arborele Huffman. Ei bine, și ce facem cu el? Nici măcar nu îl vor lua gratis. Apoi, trebuie să urmărim toate căile posibile de la rădăcină la frunzele arborelui. Să convenim să marcăm muchia 0, dacă duce la descendentul din stânga și 1 — dacă duce la dreptul. Strict vorbind, în aceste denumiri, codul caracterului este călătoria de la rădăcina arborelui până la frunza care conține acel caracter.
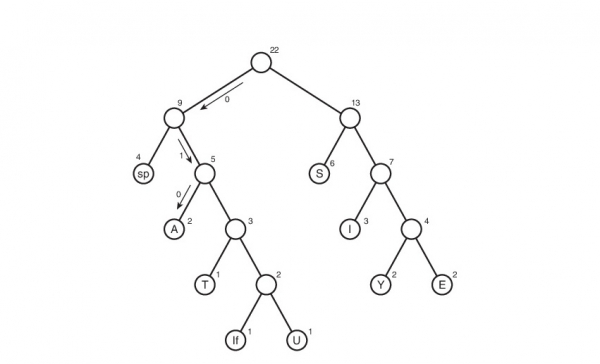
În acest mod a rezultat tabela codurilor. Observăm că, dacă analizăm această tabelă, putem trasa concluzia despre „greutatea” fiecărui simbol — aceasta este lungimea codului său. Astfel, în formă comprimată, fișierul inițial va avea o greutate de: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 biți. La început, avea 176 biți. Prin urmare, l-am redus într-o măsură semnificativă, de 176/65 = 2.7 ori! Dar aceasta este o utopie. Un coeficient atât de mare este puțin probabil să fie obținut. De ce? Despre asta vom discuta puțin mai târziu.
Decodare
Ei bine, probabil că a rămas să ne ocupăm de cel mai simplu lucru — decodarea. Cred că mulți dintre voi ați intuit că nu putem crea un fișier comprimat fără niciun indiciu despre modul în care a fost codificat — nu vom putea să-l decodificăm! Da, mi-a fost greu să conștientizez acest lucru, dar va trebui să creăm un fișier text table.txt cu tabela de comprimare:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Scrierea tabelei sub forma ‘simbol’«cod simbol». De ce 01110 nu are simbol? De fapt, el are un simbol, doar că instrumentele java pe care le-am utilizat pentru a-l scrie în fișier convertesc caracterul de trecere la o nouă linie — ‘n’ -într-o trecere la o nouă linie (oricât de absurd ar suna). De aceea, linia goală de sus este simbolul pentru codul 01110. Pentru codul 00, simbolul este un spațiu la începutul liniei. Voi spune din start că metoda noastră de stocare a tabelei este foarte rațională și poate pierde eficiență. Dar este simplă pentru înțelegere și implementare. Voi fi încântat să ascult recomandările voastre în comentarii cu privire la optimizare.
Având această tabelă, decodarea devine foarte simplă. Să ne amintim ce regulă am urmat când am creat codificarea:
Niciun cod nu ar trebui să fie prefixul altui cod
Aici intervine o ușurare. Citim secvențial bit cu bit și, de îndată ce sirul obținut d, format din biții citiți, coincide cu codificarea corespunzătoare simbolului character, știm imediat că simbolul character a fost codificat (și numai acesta!). Apoi, scriem character în sirul de decodare (sirul care conține mesajul decodat), resetăm sirul d, și continuăm să citim fișierul codificat.
Implementarea
A sosit timpul să pun la respect codul meu și să scriu un arhivator. Să-l numim Compressor.
Să începem cu începutul. În primul rând, scriem clasa Node:
public class Node {
    private int frequence; // frecvență
    private char letter; // literă
    private Node leftChild; // copil stâng
    private Node rightChild; // copil drept

    public Node(char letter, int frequence) { // constructorul
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} // suprascrierea constructorului pentru noduri fără nume (vezi mai sus la secțiunea despre construirea arborilor Huffman)
    public void addChild(Node newNode) { // adaugă copil
        if (leftChild == null) // dacă stângul este gol => dreptul este de asemenea gol => adăugăm la stâng
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) // în general, devine copil drept
                rightChild = newNode; // va fi cel cu frecvență mai mică
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); // frecvența finală
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { // verificare frunză
        return leftChild == null && rightChild == null;
    }
}
Acum arborele:
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Coada de priorități:
import java.util.ArrayList; // da-da, coada va fi bazată pe listă

class PriorityQueue {
    private ArrayList data; // lista cozii
    private int nElems; // numărul de elemente din coadă

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // inserare
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { // dacă frecvența arborelui inserat este mai mică
                    data.add(i, newTree); // atunci mutăm toate arborile de pe pozițiile din dreapta cu 1 celulă
                    break; // apoi plasăm noul arbore în poziția arborelui curent
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // creștem numărul de elemente cu 1
    }

    public BinaryTree remove() { // eliminare din coadă
        BinaryTree tmp = data.get(0); // copiem elementul eliminat
        data.remove(0); // de fapt, îl eliminăm
        nElems--; // scădem numărul de elemente cu 1
        return tmp; // returnăm elementul eliminat (elementul cu cea mai mică frecvență)
    }
}
Clasă care creează arborele Huffman:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // dimensiunea tabelului de codare
    private String myString; // mesaj
    private BinaryTree huffmanTree; // arborele Huffman
    private int[] freqArray; // tabela de frecvență
    private String[] encodingArray; // tabela de codare


    //----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmul este descris mai sus
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // dacă simbolul există în șir
                Node newNode = new Node((char) i, freqArray[i]); // atunci creează un Node pentru acesta
                BinaryTree newTree = new BinaryTree(newNode); // și creează un BinaryTree pentru Node
                pq.insert(newTree); // inserează în coadă
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // extrage primul arbore din coadă.

            try {
                BinaryTree tree2 = pq.remove(); // extrage al doilea arbore din coadă

                Node newNode = new Node(); // creează un nou Node
                newNode.addChild(tree1.getRoot()); // face ca cele două arbori extrase să fie descendenții
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // a rămas un singur arbore în coadă
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // umple tabela de codare
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // pentru depanare
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Tabela de codare====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Clasă care conține codul care codifică/decodifică:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // dimensiunea tabelului
    private HuffmanTree mainHuffmanTree; // arborele Huffman (folosit doar pentru comprimat)
    private String myString; // mesajul original
    private int[] freqArray; // tabelul de frecvență
    private String[] encodingArray; // tabelul de codare
    private double ratio; // coeficientul de compresie


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // pentru comprimare
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // pentru extragere;

    // ---------------------------------------compresie-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // șir intermediar (fără zerouri suplimentare)
        //System.out.println("=============================Compresie=======================");
        //displayEncodingArray();
        for (int i = 0; i
        // e nevoie să adăugăm zerouri la sfârșit (poate 1, nu contează)
        byte counter = 0; // numărul de zerouri adăugate la sfârșit (un byte este suficient: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta; counter++) { // delta - numărul de zerouri adăugate
            intermidiate += "0";
        }

        // combinarea numărului de zerouri adăugate în reprezentarea binară și șirul intermediar
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // coeficientul idealizat
        setCompressionRatio();
        //System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // calcularea coeficientului idealizat
        double sumA = 0, sumB = 0; // A-suma originală
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // compresie finală
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------sfârșitul compresiei----------------------------------------------------------------
    // ------------------------------------------------------------extragere-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        //displayEncodingArray();
        // obține numărul de zerouri inserate
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, deoarece primul byte conține numărul de zerouri inserate
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // dacă se potrivește
                    decompressed += (char)j; // atunci adăugăm elementul
                    current = ""; // și resetăm șirul curent
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // pentru depanare
        System.out.println("======================Tabel de codare====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            //if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            //}
        }
        System.out.println("========================================================");
    }
}
Clasă care facilitează scrierea în fișiere:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Calea este greșită sau fișierul nu există!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Clasă care facilitează citirea din fișiere:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // dacă a ajuns la finalul fișierului
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
Și, clasa principală:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // Indicați instrucțiunea prin argumentele din linia de comandă
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Formatul argumentelor de intrare este incorect");
            System.out.println("Citiți Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Calea este incorectă sau fișierul nu există!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Codarea curentă a fișierului nu este acceptată");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // creează fișier cu tabela de codare:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Calea către fișierul comprimat: " + compressedFile.getAbsolutePath());
        System.out.println("Calea către tabela de codare " + table.getAbsolutePath());
        System.out.println("Fără tabel, fișierul nu va putea fi extras!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // coeficient idealizat
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // coeficient real

        System.out.println("Coeficientul idealizat al compresiei este " + idealRatio);
        System.out.println("Coeficientul de compresie ținând cont de tabela de codare " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // citim fișierul comprimat
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! verificați aici:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // metoda returnează EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        // citim tabela de codare:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // sar peste prima linie goală
        	encodingArray[(byte)'n'] = fi.readLine(); // citim codul pentru 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // extragere:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Calea către fișierul extras " + extractedFile.getAbsolutePath());
    }
}
Fișierul cu instrucțiuni readme.txt urmează să-l scrieți singuri 🙂
Concluzie
Probabil că acestea sunt toate cele pe care voiam să le spun. Dacă aveți ceva de spus despre necompetența mea în îmbunătățirile codului, algoritmului, sau orice optimizare, nu ezitați să scrieți. Dacă am omis să explic ceva, de asemenea, scrieți-mi. Aștept cu nerăbdare comentariile voastre!
P.S.
Da, da, sunt încă aici, pentru că nu am uitat de coeficient. Pentru șirul s1, tabela de codificare cântărește 48 de biți — mult mai mult decât fișierul inițial, și nu am uitat de zerourile adiționale (numărul de zerouri adăugate este 7) => coeficientul de comprimare va fi mai mic de unu: 176/(65 + 48*8 + 7)=0.38. Dacă ați observat și voi acest lucru, să știți că ați fost foarte căliți. Da, această implementare va fi extrem de ineficientă pentru fișiere mici. Dar ce se întâmplă cu fișierele mari? Dimensiunile fișierelor depășesc cu mult dimensiunea tabelului de codificare. Aici algoritmul funcționează exact cum trebuie! De exemplu, pentru archivatorul oferă un coeficient real (nu idealizat), egal cu 1.46 — aproape de o dată și jumătate! Și da, s-a presupus că fișierul va fi în limba engleză.
Sursa: habr.com
