

Preludiu
Acest articol este dedicat arborilor binari de căutare. Recent am scris un articol despre Acolo nu am acordat prea multă atenție arborilor binari, deoarece metodele de căutare, inserare și ștergere nu erau relevante. Acum am decis să scriu un articol tocmai despre arbori. Probabil că să începem.
Un arbore este o structură de date formată din noduri conectate prin muchii. Se poate spune că un arbore este un caz particular de graf. Iată un exemplu de arbore:
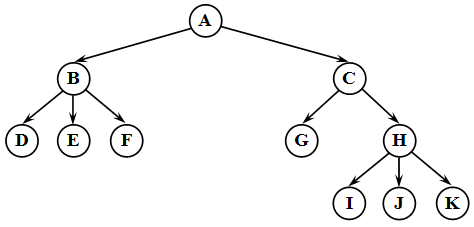
Acesta nu este un arbore binar de căutare! Totul este sub cat!
Terminologie
Rădăcină
Rădăcina arborului este cel mai de sus nod. În exemplu, acesta este nodul A. În arbore, de la rădăcină la orice alt nod poate duce doar un singur drum! De fapt, orice nod poate fi considerat ca rădăcina subarborelui corespunzător acestui nod.
Părinți / descendenți
Toate nodurile, cu excepția rădăcinii, au exact o muchie care duce în sus către un alt nod. Nodul situat deasupra nodului curent se numește părinte al acestui nod. Nodul situat sub nodul curent, care este conectat cu acesta, se numește descendent al acestui nod. Să luăm un exemplu. Să luăm nodul B, astfel încât părintele său va fi nodul A, iar descendenții săi vor fi nodurile D, E și F.
Foaie
Un nod care nu are descendenți se va numi frunză a arborului. În exemplu, frunzele vor fi nodurile D, E, F, G, I, J, K.
Aceasta este terminologia de bază. Alte concepte vor fi discutate mai departe. Așadar, un arbore binar este un arbore în care fiecare nod va avea cel mult doi descendenți. Așa cum ați ghicit, arborele din exemplu nu va fi binar, deoarece nodurile B și H au mai mult de doi descendenți. Iată un exemplu de arbore binar:
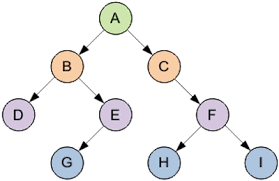
În nodurile arborului poate fi orice informație. Arborele binar de căutare este un arbore binar, pentru care caracteristicile următoare sunt caracteristice:
- Ambele subarbori - stâng și drept - sunt arbori binari de căutare.
- La toate nodurile subarborelui stâng al oricărui nod X, valorile cheilor de date sunt mai mici decât valoarea cheii de date a nodului X.
- La toate nodurile subarborelui drept al oricărui nod X, valorile cheilor de date sunt mai mari sau egale cu valoarea cheii de date a nodului X.
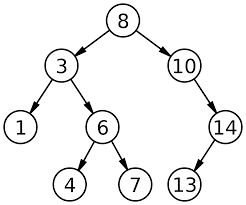
Cheia — orice caracteristică a nodului (de exemplu, un număr). Cheia este necesară pentru a putea găsi elementul arborelui căruia îi corespunde această cheie. Exemplu de arbore binar de căutare:
Reprezentarea arborului
Pe măsură ce avansăm, voi prezenta câteva (posibil incomplete) fragmente de cod pentru a îmbunătăți înțelegerea dvs. Codul complet va fi la finalul articolului.
Arborele este alcătuit din noduri. Structura unui nod:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...alte metode ale nodului
}
Fiecare nod are doi fii (este posibil ca fiii leftChild și/sau rightChild să conțină valoarea null). Probabil ați înțeles că în acest caz numărul data reprezintă datele stocate în nod; key este cheia nodului.
Am rezolvat nodul, acum să discutăm despre problemele actuale ale arborilor. Aici și mai departe, prin "arbore" voi înțelege conceptul de arbore binar de căutare. Structura unui arbore binar:
public class BinaryTree<T> {
     private Node<T> root;

    //metodele arborelui
}
Ca și câmp al clasei, ne va trebui doar rădăcina arborelui, deoarece de la rădăcină, folosind metodele getLeftChild() și getRightChild(), se poate ajunge la orice nod din arbore.
Algoritmi în arbore
Căutarea
Să presupunem că aveți un arbore construit. Cum găsiți un element cu cheia key? Trebuie să vă deplasați pe rând de la rădăcină în josul arborelui și să comparați valoarea key cu cheia nodului curent: dacă key este mai mic decât cheia nodului curent, treceți la fiul stâng al nodului; dacă este mai mare - la fiul drept; dacă cheile sunt egale - nodul căutat a fost găsit! Codul corespunzător:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Dacă current devine egal cu null, înseamnă că căutarea a atins finalul arborelui (la nivel conceptual, vă aflați într-un loc inexistent al arborelui - un fiu al unei frunze).
Să examinăm eficiența algoritmului de căutare pe un arbore echilibrat (un arbore în care nodurile sunt distribuite mai mult sau mai puțin uniform). Atunci eficiența căutării va fi O(log(n)), cu logaritm la baza 2. Observați: dacă în arborele echilibrat sunt n elemente, înseamnă că vor fi log(n) la baza 2 niveluri ale arborelui. Iar în timpul căutării, cu un pas al buclei, coborâți un nivel.
Inserare
Dacă ați înțeles esența căutării, atunci nu va fi greu să înțelegeți inserția. Trebuie să coborâți până la frunza arborelui (conform regulilor de coborâre descrise în căutare) și să deveniți descendentul său — stâng, sau drept, în funcție de cheie. Implementare:
   public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
În acest caz, trebuie să păstrăm informația despre părintele nodului curent, pe lângă nodul curent. Când current devine egal cu null, variabila parent va conține frunza de care avem nevoie.
Eficiența inserției va fi, evident, aceeași ca și la căutare — O(log(n)).
Ștergere
Ștergerea este cea mai complexă operație care trebuie efectuată cu arborele. Este clar că mai întâi trebuie să găsim elementul pe care dorim să-l ștergem. Dar ce urmează? Dacă pur și simplu atribuim valoarea null legăturii sale, vom pierde informația despre subarborele având acest nod ca rădăcină. Metodele de ștergere a arborilor se împart în trei cazuri.
Primul caz. Nodul șters nu are descendenți.
Dacă nodul șters nu are descendenți, atunci înseamnă că este o frunză. Prin urmare, putem pur și simplu să atribuim valorile null câmpurilor leftChild sau rightChild ale părintelui său.
Al doilea caz. Nodul șters are un descendent.
Acest caz nu este foarte complicat. Să ne întoarcem la exemplul nostru. Să presupunem că dorim să ștergem elementul cu cheia 14. Să admităm că, fiind un descendent drept al nodului cu cheia 10, orice descendent al său (în acest caz, dreptul) va avea o cheie mai mare de 10, așa că putem să-l „tăiem” cu ușurință din arbore, iar părintele său va fi conectat direct la descendentul nodului șters, adică nodul cu cheia 10 va fi conectat la nodul 13. O situație similară ar fi dacă dorim să ștergem un nod care este descendent stâng al părintelui său. Gândiți-vă la asta zilnic — o analogie exactă.
Al treilea caz. Nodul are doi descendenți.
Cazul cel mai complex. Să-l analizăm pe un exemplu nou.
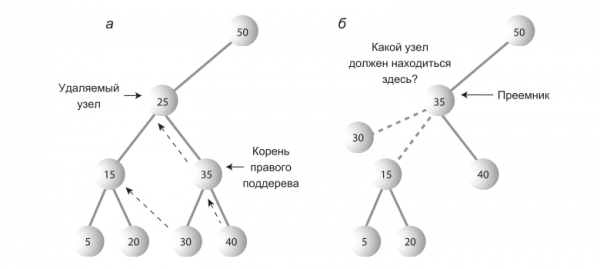
Căutarea succesorului.
Să presupunem că trebuie să eliminăm un nod cu cheia 25. Pe cine vom pune în locul său? Cineva dintre urmașii săi (descendenți sau descendenți ai descendenților) ar trebui să devină succesorul(cel care va ocupa locul nodului eliminat).
Cum putem înțelege cine ar trebui să devină succesor? Este evident că acesta este un nod din arbore, ale cărui cheie este următoarea ca mărime față de nodul eliminat. Algoritmul este următorul. Trebuie să ne deplasăm la descendentul său din dreapta (întotdeauna la dreapta, deoarece s-a spus deja că cheia succesorului este mai mare decât cheia nodului eliminat) și apoi să parcurgem lanțul descendenților din stânga acestui descendent din dreapta. În exemplul nostru, trebuie să ne deplasăm la nodul cu cheia 35 și apoi să coborâm la frunză de-a lungul lanțului descendenților săi din stânga — în acest caz, acest lanț este format doar din nodul cu cheia 30. Strict vorbind, căutăm cel mai mic nod din setul nodurilor mai mari decât nodul căutat.
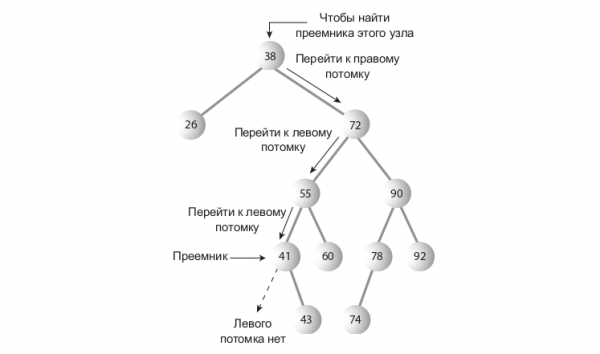
Codul metodei de căutare a succesorului:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // părintele succesorului
        Node<T> successor = deleteNode; // succesorul
        Node<T> current = successor.getRightChild(); // nodul „de parcurs”
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // la ieșirea din ciclu avem succesorul și părintele succesorului
        if (successor != deleteNode.getRightChild()) { // dacă succesorul nu este identic cu descendentul din dreapta al nodului eliminat
            parentSuccessor.setLeftChild(successor.getRightChild()); // părintele său își ia descendentul succesorului, pentru a nu-l pierde
            successor.setRightChild(deleteNode.getRightChild()); // legăm succesorul de descendentul din dreapta al nodului eliminat
        }
        return successor;
    }
Codul complet al metodei delete:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // În funcție de faptul dacă nodul care trebuie eliminat este copil stâng sau drept al părintelui său, variabila booleană isLeftChild va avea valoarea true sau false, respectiv.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // primul caz
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // al doilea caz
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // al treilea caz
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
Complexitatea poate fi aproximată la O(log(n)).
Căutarea maximului/minimului într-un arbore
Este evident cum să găsim valoarea minimă/maximum în arbore — trebuie să trecem succesiv prin lanțul de elemente stângi/drepte al arborelui, respectiv; când ajungeți la o frunză, aceasta va fi elementul minim/maxim.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
Complexitatea — O(log(n))
Parcurgere simetrică
Parcurgerea — vizitarea fiecărui nod al arborelui cu scopul de a face o acțiune asupra acestuia.
Algoritmul de parcurgere simetrică recursivă:
- Faceți o acțiune cu copilul stâng
- Faceți o acțiune cu sine însuși
- Faceți o acțiune cu copilul drept
Cod:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");//Aici poate fi orice
            inOrder(current.getRightChild());
        }
    }
Concluzie
În sfârșit! Dacă am omis ceva sau aveți sugestii, vă aștept în comentarii. Așa cum am promis, iată codul complet.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Degenerare la O(n)
Mulți dintre voi ați observat: dar ce ar fi dacă am face ca arborele să devină dezechilibrat? De exemplu, să adăugăm în arbore noduri cu chei în creștere: 1,2,3,4,5,6… Atunci, arborele va semăna cu o listă legată. Și da, arborele își va pierde structura ramificată, iar, prin urmare, eficiența accesului la date. Complexitatea operațiunilor de căutare, inserare și ștergere va deveni similară cu cea a unei liste legate: O(n). Aici se manifestă, din punctul meu de vedere, unul dintre cele mai importante dezavantaje ale arborilor binari.
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Nu sunt aici de foarte mult timp pe Haber și mi-ar plăcea să știu despre ce subiecte ați dori să vedeți mai multe articole?
Structuri de date
Algoritmi (DP, recursivitate, compresia datelor etc.)
Aplicarea structurilor de date și algoritmilor în viața reală
Programarea aplicațiilor Android în Java
Programarea aplicațiilor web în Java
2 utilizatori au votat. 1 utilizator s-a abținut.
Sursă: habr.com
