

KDB+, produs al companiei — este o bază de date colunară extrem de rapidă, recunoscută în cercuri restrânse, destinată stocării seriilor temporale și pentru calculele analitice pe baza acestora. Inițial, aceasta s-a bucurat de o popularitate mare în industria financiară — este utilizată de toate cele mai importante 10 bănci de investiții și de multe fonduri de hedging cunoscute, burse și alte organizații. Recent, cei de la KX au decis să își extindă baza de clienți și acum oferă soluții și în alte domenii, unde există un volum mare de date organizate în funcție de timp sau în alt mod — telecomunicații, bioinformatică, producție etc. De asemenea, au devenit parteneri ai echipei Aston Martin Red Bull Racing în Formula 1, ajutând la colectarea și procesarea datelor din senzorii mașinilor și la analizarea testelor în tunelul aerodinamic. În acest articol, vreau să explic ce caracteristici fac ca KDB+ să fie super-performantă, de ce companiile sunt dispuse să cheltuie sume mari pe aceasta și, în cele din urmă, de ce, de fapt, nu este o bază de date.
În acest articol, voi încerca să explic în general ce reprezintă KDB+, ce posibilități și limitări are, și care este utilitatea sa pentru companiile care doresc să proceseze volume mari de date. Nu voi intra în detalii despre implementarea KDB+ și despre limbajul său de programare Q. Ambele subiecte sunt foarte ample și merită articole separate. Multe informații despre aceste subiecte pot fi găsite pe site-ul code.kx.com, inclusiv o carte despre Q — Q For Mortals (vezi linkul de mai jos).
Câteva termeni
- Bază de date în memorie. O bază de date care stochează datele în memoria operațională pentru a accelera accesul. Avantajele acestei baze sunt clare, iar dezavantajele — riscul de pierdere a datelor, necesitatea de a avea multă memorie pe server.
- Bază de date colunară. O bază de date în care datele sunt stocate pe coloane, nu înregistrare cu înregistrare. Principalul avantaj al acestei baze este că datele dintr-o coloană sunt stocate împreună pe disc și în memorie, ceea ce accelerează semnificativ accesul la acestea. Nu este necesar să se încarce coloanele care nu sunt utilizate în cerere. Principalul dezavantaj — este complicat să modifici și să ștergi înregistrări.
- Serie temporală. Date or time type column data. Generally, the order of such data is important for determining which entry precedes or follows the current one or for applying functions whose results depend on the order of entries. Classical databases are built on a completely different principle — representing a collection of records as a set, where the order of entries is fundamentally not defined.
- Vector. In the context of KDB+, this is a list of elements of one atomic type, such as numbers. In other words, an array of elements. Unlike lists, arrays can be stored compactly and processed using vector processor instructions.
Context istoric
The KX company was founded in 1993 by Arthur Whitney, who previously worked at Morgan Stanley on the A+ language, a successor to APL — a very original and once-popular language in the financial world. Naturally, at KX, Arthur continued in the same spirit and created the vector-functional language K, guided by ideas of radical minimalism. Programs in K look like a chaotic collection of punctuation and special symbols, the meaning of which depends on the context, and each operation carries much more meaning than in conventional programming languages. As a result, a program in K takes up minimal space — a few lines can replace pages of text from a verbose language like Java — and is a super-concentrated implementation of an algorithm.
A function in K that implements most of the LL1 parser generator according to the specified grammar:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,"(""]};0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:1_r),"]";""]]}
Această filozofie a eficienței extreme cu un minim de mișcare a fost implementată de Arthur și în KDB+, care a apărut în 2003 (cred că acum e clar de unde provine litera K în denumire) și care nu este altceva decât un interpret al celei de-a patra versiuni a limbajului K. Pe K a fost adăugată o versiune mai prietenoasă cu utilizatorul numită Q. În Q a fost, de asemenea, inclusă suportul pentru un dialect specific SQL – QSQL, iar în interpretator – suport pentru tabele ca tip de date sistemice și instrumente pentru lucrul cu tabele în memorie și pe disc etc.
Astfel, din perspectiva utilizatorului, KDB+ este pur și simplu un interpret al limbajului Q cu suport pentru tabele și expresii asemănătoare SQL în stil LINQ din C#. Aceasta este cea mai importantă diferență a KDB+ față de alte baze de date și principalul său avantaj competitiv, care adesea este trecut cu vederea. Nu este o bază de date + un limbaj auxiliar, ci un limbaj de programare complet puternic + suport integrat pentru funcțiile bazei de date. Această distincție va juca un rol determinativ în enumerarea tuturor avantajelor KDB+. De exemplu…
Dimensiune
Din punct de vedere modern, KDB+ are un dimensiuni absolut microscopice. Este, în sens literal, un singur fișier executabil de dimensiune mai mică de un megabyte și un fișier text mic cu anumite funcții sistemice. De fapt, este mai mic de un megabyte, iar companiile plătesc zeci de mii de dolari pe an pentru un singur procesor pe server pentru acest program.
- Această dimensiune permite KDB+ să funcționeze perfect pe orice hardware – de la microcomputerele Pi până la servere cu terabytes de memorie. Funcționalitatea nu este afectată în niciun fel, dimpotrivă, Q pornește instantaneu, ceea ce permite utilizarea sa și ca un limbaj de script.
- Cu o asemenea dimensiune, interpretatorul Q se încadrează complet în cache-ul procesorului, ceea ce accelerează executarea programelor.
- Având o dimensiune atât de mică a fișierului executabil, procesul Q ocupă extrem de puțin spațiu în memorie, se pot rula sute de procese. În plus, la nevoie, Q poate opera și cu zeci-sute de gigabytes de memorie în cadrul unui singur proces.
Universalitate
Q se potrivește perfect pentru cele mai diverse sarcini. Procesul Q poate funcționa ca o bază de date istorică și poate oferi acces rapid la terabytes de informații. De exemplu, avem zeci de baze de date istorice, în care unele dintre acestea conțin o zi de date necomprimate ce ocupă mai mult de 100 de gigabytes. Cu toate acestea, cu limite rezonabile, o interogare în baza de date va fi efectuată în zeci-sute de milisecunde. În general, pentru cererile utilizatorilor avem un timeout universal de 30 de secunde, care se declanșează foarte rar.
Cu aceeași ușurință, Q poate fi o bază de date în memorie. Adăugarea de date noi în tabelele din memorie se face atât de repede, încât factorul limitativ sunt cererile utilizatorilor. Datele din tabele sunt stocate pe coloane, ceea ce înseamnă că orice operațiune pe o coloană va folosi cache-ul procesorului la maximum. În plus, în KX s-au străduit să implementeze toate operațiunile de bază, cum ar fi cele aritmetice, prin instrucțiuni vectoriale ale procesorului, maximizând astfel viteza acestora. Q poate efectua și sarcini neobișnuite pentru bazele de date — de exemplu, poate procesa date de flux și calcula în „timp real” (cu o întârziere de la zeci de milisecunde la câteva secunde, în funcție de sarcină) diferite funcții agregate pentru instrumente financiare pe diferite intervale de timp sau poate construi un model al influenței unei tranzacții asupra pieței și să efectueze profilarea acesteia practic imediat după ce a fost realizată. În astfel de sarcini, cel mai adesea, întârzierea majoră este adusă nu de Q, ci de necesitatea sincronizării datelor din diferite surse. Viteza ridicată este atinsă datorită faptului că datele și funcțiile care le procesează sunt într-un singur proces, iar procesarea se reduce la executarea câtorva expresii QSQL și joinuri, care nu sunt interpretate, ci executate în cod binar.
În cele din urmă, pe Q se pot scrie și orice procese de servicii. De exemplu, procesele Gateway, care distribuie automat cererile utilizatorilor către bazele de date și serverele necesare. Programatorul are libertatea de a implementa orice algoritm pentru echilibrarea, prioritizarea, toleranța la defecțiuni, drepturile de acces, cotele și, în general, orice altceva își dorește. Principala problemă aici este că va trebui să implementeze toate acestea singur.
Pentru exemplu, voi enumera ce tipuri de procese avem. Toate acestea sunt utilizate activ și lucrează împreună, integrând zeci de baze diferite, procesând date din numeroase surse și servind sute de utilizatori și aplicații.
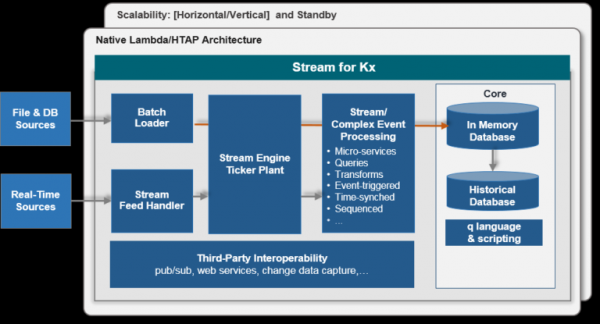
- Conectorii (feedhandler) pentru sursele de date. Aceste procese utilizează de obicei biblioteci externe, care sunt încărcate în Q. Interfața C în Q este extrem de simplă și permite cu ușurință crearea de funcții proxy pentru orice bibliotecă C/C++. Q este suficient de rapid pentru a gestiona, de exemplu, fluxul de mesaje FIX de pe toate bursele de acțiuni europene simultan.
- Distribuitorii de date (tickerplant), care servesc ca intermediar între conectori și consumatori. În același timp, ei scriu datele primite într-un jurnal binar special, asigurându-se că consumatorii nu pierd conexiuni sau nu sunt afectați de reporniri.
- Baze de date in-memory (rdb). Aceste baze oferă acces maxim de rapiditate la datele brute și proaspete, păstrându-le în memorie. De obicei, ele acumulează date în tabele pe parcursul zilei și le resetează noaptea.
- Baze de date persistente (pdb). Aceste baze asigură păstrarea datelor din ziua curentă în baza de date istorică. De obicei, spre deosebire de rdb, ele nu păstrează datele în memorie, ci folosesc un cache special pe disc pe parcursul zilei și copiază datele la miezul nopții în baza de date istorică.
- Baze de date istorice (hdb). Aceste baze oferă acces la datele din zilele, lunile și anii anteriori. Dimensiunea lor (în zile) este limitată doar de capacitatea hard disk-urilor. Datele pot fi stocate oriunde, în special pe discuri diferite pentru a accelera accesul. Există posibilitatea de a comprima datele folosind mai multe algoritmi la alegere. Structura bazei este bine documentată și simplă, datele fiind stocate în fișiere obișnuite, permițând astfel procesarea acestora inclusiv cu ajutorul sistemului de operare.
- Baze de date cu informații agregate. Acestea păstrează diverse agregări, de obicei grupate pe instrumente și intervale de timp. Baze de date in-memory își actualizează starea la fiecare mesaj primit, în timp ce cele istorice păstrează datele pre-calculat pentru a accelera accesul la datele istorice.
- În cele din urmă, procesele gateway, care deservă aplicații și utilizatori. Q permite implementarea completă a procesării asincrone a mesajelor primite, distribuirea acestora între baze de date, verificarea drepturilor de acces și altele. Observ că mesajele nu sunt limitate și cel mai adesea nu sunt expresii SQL, așa cum se întâmplă în alte baze de date. Cel mai adesea, expresia SQL este ascunsă într-o funcție specială și este construită pe baza parametrilor solicitați de utilizator — se realizează conversia timpului, filtrarea, datele sunt normalizate (de exemplu, prețul acțiunilor este ajustat dacă au avut loc plăți de dividende) și altele.
Arhitectura tipică pentru un tip de date:
Viteză
Deși Q este un limbaj interpretat, este de asemenea un limbaj vectorial. Aceasta înseamnă că multe funcții încorporate, în special cele aritmetice, acceptă argumente de orice formă — numere, vectori, matrice, liste, iar de la programator se așteaptă să implementeze programul ca operațiuni asupra array-urilor. Într-un astfel de limbaj, dacă adunați două vectori de un milion de elemente, nu mai contează că limbajul este interpretat, adunarea se va realiza printr-o funcție binară ultra-optimizată. Deoarece cea mai mare parte a timpului în programele scrise în Q este dedicată operațiunilor cu tabele care utilizează aceste funcții de bază vectorizate, rezultatul este o viteză de lucru destul de bună, care permite procesarea unui volum uriaș de date chiar și într-un singur proces. Aceasta este similar cu bibliotecile matematice din Python — deși Python este un limbaj destul de lent, are multe biblioteci excelente precum numpy, care permit procesarea datelor numerice cu viteza unui limbaj compilat (apropos, numpy este ideologic apropiat de Q).
În plus, KX a abordat cu mare atenție proiectarea tabelelor și optimizarea interacțiunii cu acestea. În primul rând, suportă mai multe tipuri de indexuri, care sunt susținute de funcții încorporate și pot fi aplicate nu doar coloanelor tabelelor, ci și oricăror vectori - grupare, sortare, atribut de unicitate și grupare specială pentru bazele de date istorice. Indexul este aplicat simplu și corectat automat la adăugarea elementelor în coloană/vector. Indexurile pot fi aplicate cu succes pe coloanele tabelelor atât în memorie, cât și pe disc. La executarea unei interogări QSQL, indexurile sunt utilizate automat, dacă este posibil. În al doilea rând, lucrul cu datele istorice este realizat printr-un mecanism de mapare a fișierelor OS (memory map). Tabelele mari nu sunt niciodată încărcate în memorie, în locul acestora, coloanele necesare sunt mapate direct în memorie și se încarcă doar acea parte din ele (în acest sens, indexurile ajută mult), care este necesară. Pentru programator nu există nicio diferență dacă datele sunt în memorie sau nu, mecanismul de lucru cu mmap fiind complet ascuns în adâncurile Q.
KDB+ este o bază de date non-relațională, tabelele pot conține date arbitrare, iar ordinea rândurilor din tabel nu se schimbă la adăugarea de noi elemente și poate și trebuie utilizată la scrierea interogărilor. Această caracteristică este esențială pentru lucrul cu serii temporale (date de pe burse, telemetrie, loguri de evenimente), deoarece dacă datele sunt sortate în funcție de timp, utilizatorului nu-i sunt necesare trucuri SQL pentru a găsi prima sau ultima linie în funcție de timp sau N linii, să determine care linie urmează după linia N etc. Încă și mai simplificate sunt join-urile tabelelor, de exemplu, pentru 16000 de tranzacții VOD.L (Vodafone), ultima cotație dintr-un tabel de 500 de milioane de elemente durează aproximativ o secundă pe disc și zeci de milisecunde în memorie.
Un exemplu de join pe timp — tabelul quote este mapat în memorie, deci nu este necesar să specifici VOD.L în where, indexul pe coloana sym este utilizat implicit și faptul că datele sunt sortate pe timp. Aproape toate join-urile în Q sunt funcții obișnuite, și nu parte din expresia select:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
În cele din urmă, merită menționat că inginerii de la KX, începând cu Arthur Whitney însuși, sunt cu adevărat obsedati de eficiență și fac tot posibilul pentru a extrage maximum din funcțiile standard Q și pentru a optimiza cele mai frecvente tipare de utilizare.
Rezultatul
KDB+ este popular în rândul afacerilor în primul rând datorită versatilității sale remarcabile - servește la fel de bine atât ca o bază de date in-memory, cât și ca o bază de date pentru stocarea terabiților de date istorice, și ca o platformă pentru analiza datelor. Datorită faptului că procesarea datelor se realizează direct în baza de date, se obține o viteză mare de lucru și economisirea resurselor. Un limbaj de programare complet, integrat cu funcțiile bazei de date, permite implementarea pe o singură platformă a întregului set de procese necesare - de la obținerea datelor până la procesarea cererilor utilizatorilor.
Informații suplimentare
Dezavantaje
Un inconvenient semnificativ al KDB+ / Q este pragul ridicat de acces. Limbajul are o sintaxă ciudată, unele funcții sunt foarte suprasarcinate (value, de exemplu, are aproximativ 11 variante de utilizare). Cel mai important, acesta necesită o abordare radical diferită pentru scrierea programelor. În limbajul vectorial, trebuie să gândești constant în termeni de transformări de array-uri, toate ciclurile fiind implementate prin câteva variante de funcții map/reduce (care se numesc adverbs în Q), niciodată nu trebuie să încerci să economisești, înlocuind operațiile vectoriale cu cele atomice. De exemplu, pentru a găsi indexul N-ing al unei apariții a unui element într-un array, trebuie să scrii:
1. (where element=vector)[N]
deși aceasta poate părea extrem de ineficientă în termeni de C / Java (= creează un vector boolean, unde returnează indecșii elementelor true în acesta). Dar această formă face sensul expresiei mai clar și utilizezi operații vectoriale rapide în locul celor lente atomice. Diferența conceptuală între limbajul vectorial și celelalte este comparabilă cu diferența dintre abordările imperativ și funcțional în programare, și trebuie să te pregătești pentru asta.
Unii utilizatori sunt, de asemenea, nemulțumiți de QSQL. Motivul este că acesta seamănă doar cu SQL-ul real. În realitate, este doar un interpret al expresiilor asemănătoare SQL, care nu suportă optimizarea interogărilor. Utilizatorul trebuie să scrie singur interogări optime, și anume în Q, ceea ce mulți nu sunt pregătiți să facă. Pe de altă parte, desigur, întotdeauna poți să scrii singur o interogare optimă, fără a te baza pe un optimizer necunoscut.
Ca un avantaj, cartea despre Q — Q For Mortals este disponibilă gratuit pe , unde sunt adunate și multe alte materiale utile.
Un alt dezavantaj major este costul licenței. Acesta se ridică la zeci de mii de dolari pe an pentru un CPU. Numai companiile mari își pot permite astfel de cheltuieli. În ultimele timpuri, KX a făcut politica de licențiere mai flexibilă, oferind posibilitatea de a plăti doar pentru timpul de utilizare sau de a închiria KDB+ în cloud-urile Google și Amazon. De asemenea, KX oferă pentru descărcare (versiune de 32 de biți sau 64 de biți la cerere).
Concurenți
Există destul de multe baze de date specializate, construite pe principii similare — coloanele, in-memory, orientate spre volume foarte mari de date. Problema este că acestea sunt baze de date specializate. Un exemplu concludent este Clickhouse. Această bază de date are un principiu de stocare a datelor pe disc și de construcție a indexului foarte asemănător cu KDB+, anumite interogări le execută mai rapid decât KDB+, deși nu esențial. Dar chiar și ca bază de date, Clickhouse este mai specializată decât KDB+ — analiza web vs. serii temporale arbitrare (această distincție este foarte importantă — din cauza ei, de exemplu, Clickhouse nu are capacitatea de a utiliza ordonarea înregistrărilor). Însă, cel mai important, Clickhouse nu are versatilitatea KDB+, un limbaj care ar permite prelucrarea datelor direct în bază, fără a le încărca în prealabil într-o aplicație separată, construind expresii SQL arbitrare, aplicând funcții arbitrare în interogare, creând procese independente de execuția funcțiilor istorice ale bazei. Prin urmare, este dificil să compari KDB+ cu alte baze de date; acestea pot fi mai bune în anumite scenarii de utilizare sau pur și simplu mai bune când vine vorba de sarcinile clasice ale bazelor de date, dar nu cunosc un alt instrument la fel de eficient și versatil pentru prelucrarea datelor temporale.
Integrarea cu Python
Pentru a facilita lucrul cu KDB+ pentru oamenii care nu sunt familiarizați cu tehnologia, KX a creat biblioteci pentru integrarea strânsă cu Python într-un singur proces. Se poate apela orice funcție Python din Q, și invers — apela orice funcție Q din Python (în special expresii QSQL). Bibliotecile convertește, atunci când este necesar (din motive de eficiență nu întotdeauna), datele din formatul unui limbaj în formatul altuia. În consecință, Q și Python trăiesc într-un astfel de simbioză strânsă încât limitele dintre ele se estompează. Ca rezultat, programatorul are, pe de o parte, acces complet la numeroasele biblioteci utile Python, iar pe de altă parte, obține o bază rapidă integrată în Python pentru lucrul cu Big Data, ceea ce este deosebit de util pentru cei care se ocupă cu învățarea automată sau modelarea.
Lucrul cu Q în Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Linkuri
Site-ul companiei —
Site pentru dezvoltatori —
Cartea Q For Mortals (în engleză) —
Articole despre utilizările KDB+/Q de către angajații kx —
Sursa: habr.com
