

În proiectele noastre folosim arhitectura de microservicii. Atunci când apar puncte slabe în performanță, se pierde destul de mult timp cu monitorizarea și analiza logurilor. Când logăm timpii operațiunilor individuale în fișierul de log, de obicei este dificil să înțelegem ce a condus la apelarea acestor operațiuni, să urmărim secvența de acțiuni sau să observăm decalajul temporal al unei operațiuni față de alta în diferite servicii.
Pentru a minimiza munca manuală, am decis să folosim unul dintre instrumentele de trasare. Despre cum și pentru ce se poate folosi trasarea și cum am procedat noi, va fi vorba în acest articol.
Ce probleme pot fi rezolvate cu ajutorul trasării
- Identificarea punctelor slabe în performanță, atât în cadrul unui singur serviciu, cât și în întregul arbore de execuție între toate serviciile implicate. De exemplu:
- Multitudinea de apeluri scurte și secvențiale între servicii, de exemplu, pentru geocodare sau către baza de date.
- Așteptări lungi în I/O, de exemplu, transferul de date prin rețea sau citirea de pe disc.
- Parseuri lungi de date.
- Operațiuni lungi care necesită CPU.
- Segmente de cod care nu sunt necesare pentru obținerea rezultatului final și pot fi eliminate sau executate diferit.
- A înțelege clar în ce ordine sunt apelate operațiunile și ce se întâmplă când se execută o operațiune.

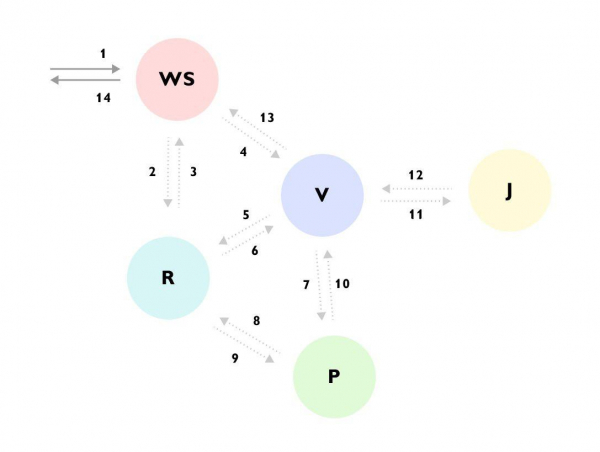
Se poate observa că, de exemplu, cererea a ajuns la serviciul WS -> serviciul WS a completat datele prin serviciul R -> apoi a trimis cererea către serviciul V -> serviciul V a încărcat multe date din serviciul R -> a accesat serviciul P -> serviciul P a accesat din nou serviciul R -> serviciul V a ignorat rezultatul și a solicitat serviciul J -> și abia apoi a returnat răspunsul serviciului WS, continuând în paralel să calculeze ceva.
Fără o astfel de trasare sau o documentație detaliată a întregului proces, este foarte greu să înțelegi ce se întâmplă, mai ales la prima vizionare a codului, care este dispersat pe diverse servicii și ascuns în spatele multor bean-uri și interfețe. - Colectarea informațiilor despre arborele de execuție pentru o analiză ulterioară amânată. La fiecare etapă de execuție în trasare se pot adăuga informații care sunt disponibile în acel moment, pentru a analiza ulterior ce date de intrare au condus la un astfel de scenariu. De exemplu:
- ID-ul utilizatorului
- Drepturile
- Tipul metodei selectate
- Log sau eroare de execuție
- Transformarea traselor într-un subset de metrici și analiza ulterioară în formă de metrici.
Ce poate loga trasarea. Span
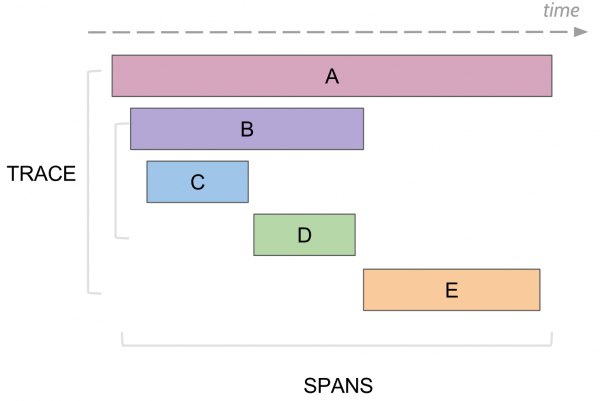
În trasare există noțiunea de span, care este un echivalent al unui log, în consolă. Un span are:
- Un nume, de obicei denumirea metodei care a fost executată
- Numele serviciului în care a fost generat span-ul
- Un ID unic propriu
- Informații meta sub formă de key/value, pe care le-am logat în el. De exemplu, parametrii metodei sau dacă metoda a terminat cu o eroare sau nu
- Timpul de început și sfârșit al execuției acestui span
- ID-ul span-ului părinte
Fiecare span este trimis la collector-ul de span-uri pentru a fi salvat în bază pentru vizualizare ulterioară imediat ce și-a terminat execuția. Ulterior, se poate construi un arbore al tuturor span-urilor conectându-le după id-ul părintelui. La analiză, se pot găsi, de exemplu, toate span-urile dintr-un anumit serviciu care au durat mai mult de un anumit timp. Apoi, trecând la un span specific, se poate vedea tot arborele deasupra și dedesubtul acestui span.
Opentrace, Jaeger și cum am implementat asta pentru proiectele noastre
Există un standard comun , care descrie cum și ce trebuie colectat, fără a lega trasarea de o anumită implementare într-un limbaj specific. De exemplu, în Java, toată activitatea cu trasările este realizată printr-un API comun Opentrace, iar sub acesta poate fi ascuns, de exemplu, Jaeger sau o implementare implicită goală care nu face nimic.
Noi folosim ca implementare a Opentrace. Acesta constă din mai multe componente:
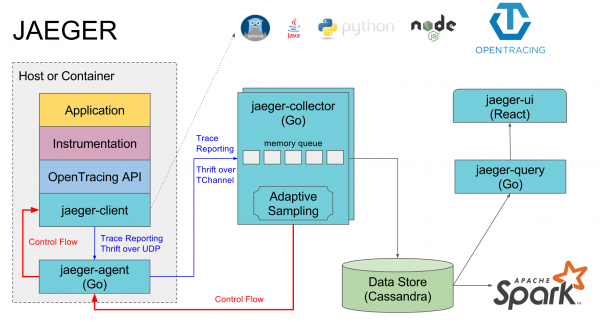
- Jaeger-agent — un agent local, care, de obicei, se află pe fiecare mașină și în care loghează serviciile pe un port implicit local. Dacă agentul nu este disponibil, trasările tuturor serviciilor de pe această mașină sunt, de obicei, dezactivate.
- Jaeger-collector — în care toți agenții trimit trasările colectate, iar acesta le stochează în baza de date aleasă.
- Baza de date — preferata lor este Cassandra, dar noi folosim Elasticsearch, există implementări și pentru câteva alte baze de date și o implementare în memorie care nu salvează nimic pe disc.
- Jaeger-query — este un serviciu care accesează baza de date și returnează deja trasările colectate pentru analiză.
- Jaeger-ui — este o interfață web pentru căutarea și vizualizarea trasărilor, care accesează jaeger-query.
Un component separat îl reprezintă implementarea opentrace jaeger pentru limbaje specifice, prin care span-urile sunt trimise la jaeger-agent.
se reduce la implementarea interfeței io.opentracing.Tracer, după care toate traseele vor fi trimise prin intermediul său către agentul real.
De asemenea, pentru componentele Spring se poate conecta și implementarea de la Jaeger care va configura automat trasarea pentru tot ce trece prin aceste componente, de exemplu, cererile HTTP în controlere, interogările către baza de date prin jdbc etc.
Logarea traseelor în Java
La un nivel superior trebuie creat primul Span, acesta poate fi realizat automat, de exemplu, de un controler Spring la primirea unei cereri, sau manual dacă nu există. Apoi, acesta este transmis prin Scope mai de jos. Dacă vreo metodă de mai jos vrea să adauge un Span, ea ia din Scope currentul activeSpan, creează un nou Span și indică că părintele său este activeSpan primit, și face noul Span activ. Atunci când apelează servicii externe, acestea primesc actualul activeSpan și acele servicii creează noi spane legate de acest span.
Toată activitatea se desfășoară prin instanța Tracer, care poate fi obținută prin mecanismul DI sau GlobalTracer.get() ca o variabilă globală, dacă mecanismul DI nu funcționează. În mod implicit, dacă tracer nu a fost inițializat, va returna NoopTracer, care nu face nimic.
Apoi, din tracer, prin ScopeManager se obține currentul scope, se creează un nou scope din cel curent legat de noul span, iar mai apoi se închide Scope-ul creat, care închide spanul creat și revine la starea activă a Scope-ului anterior. Scope-ul este legat de fir, prin urmare, în programarea multi-threaded, nu trebuie uitat să se transmită activeSpan-ul în alt fir, pentru a activa ulterior Scope-ul altui fir legat de acest span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Facem lucruri.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "eroare", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // PASUL 2 DE MAI SUS: reactivăm Span în callback, trecând true la
            // startActive() dacă când trebuie să încheiem Span-ul.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Pentru programarea multi-thread, există, de asemenea, TracedExecutorService și wrapper-uri similare care transmit automat span-ul curent în firul de execuție atunci când rulează sarcini asincrone:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Pentru cererile HTTP externe există
HttpClient httpClient = new TracingHttpClientBuilder().build();Problemele cu care ne-am confruntat
- Beans și DI nu funcționează întotdeauna dacă tracer-ul nu este folosit în serviciu sau componentă, atunci Tracer-ul poate să nu funcționeze și va trebui să folosești GlobalTracer.get().
- Anotațiile nu funcționează dacă nu este o componentă sau un serviciu, sau dacă apelul metodei se face dintr-o metodă vecină a aceleași clase. Trebuie să fii atent, să verifici ce funcționează și să folosești crearea manuală a trace-ului dacă @Traced nu funcționează. De asemenea, poți adăuga un compilator suplimentar pentru anotațiile java, atunci ar trebui să funcționeze peste tot.
- În versiunile mai vechi de spring și spring boot, auto-configurarea opentracing spring cloud nu funcționează din cauza erorilor în DI, atunci dacă dorești ca trace-urile să funcționeze automat în componentele spring, poți face analogic cu
- În groovy, nu funcționează try with resources, trebuie folosit neapărat try finally.
- Fiecare serviciu trebuie să aibă propriul spring.application.name sub care vor fi logate trace-urile. De fapt, un nume separat pentru producție și test, pentru a nu se amesteca.
- Dacă folosești GlobalTracer și tomcat, toate serviciile lansate în acest tomcat au un singur GlobalTracer, așa că toate vor avea același nume de serviciu.
- Când adaugi trace-uri într-o metodă, trebuie să te asiguri că nu este apelată în buclă de prea multe ori. Trebuie să adaugi un singur trace comun pentru toate apelurile, care va loga timpul total de execuție. Altfel, va apărea o încărcare excesivă.
- Odată, în jaeger-ui, am făcut cereri prea mari pentru un număr mare de trace-uri și, deoarece nu așteptam răspunsul, le-am făcut din nou. În consecință, jaeger-query a început să consume multă memorie și să încetinească elastic. A ajutat un restart al jaeger-query.
Eșantionarea, stocarea și vizualizarea trace-urilor
Există trei tipuri :
- Const care trimite și salvează toate trace-urile.
- Probabilistic care filtrează trace-urile cu o probabilitate specificată.
- Limitarea ratei care restricționează numărul de trace-uri pe secundă. Aceste setări pot fi configurate fie la client, fie pe jaeger-agent sau în colector. În prezent, în stiva noastră de validatori se utilizează const 1, deoarece cererile nu sunt foarte multe, dar durează mult timp. În viitor, dacă aceasta va pune o presiune excesivă asupra sistemului, putem limita.
Dacă folosești Cassandra, în mod implicit ea stochează trace-urile doar timp de două zile. La noi se folosește și trace-urile sunt păstrate pe termen nelimitat și nu sunt șterse. Pentru fiecare zi se creează un index separat, de exemplu, jaeger-service-2019-03-04. În continuare, trebuie configurată o curățare automată a trace-urilor vechi.
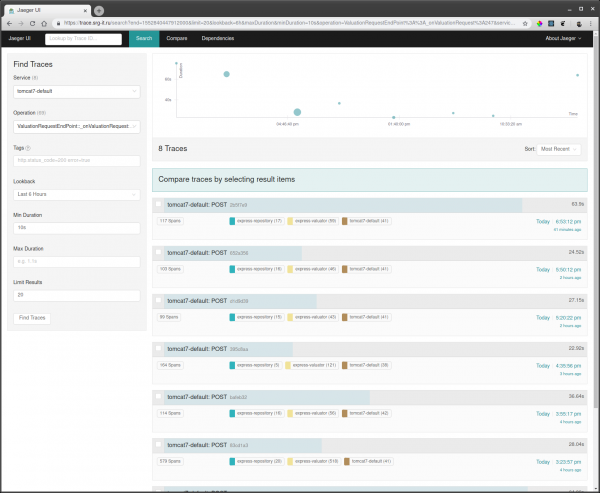
Pentru a vizualiza trace-urile, trebuie să:
- Selectezi serviciul pe care vrei să-l filtrezi, de exemplu, tomcat7-default pentru serviciul care rulează în Tomcat și care nu poate avea un nume propriu.
- Apoi, să alegi operația, intervalul de timp și timpul minim al operației, de exemplu, de la 10 secunde, pentru a lua doar execuțiile lungi.

- Accesezi unul dintre trace-uri și vezi ce a încetinit acolo.

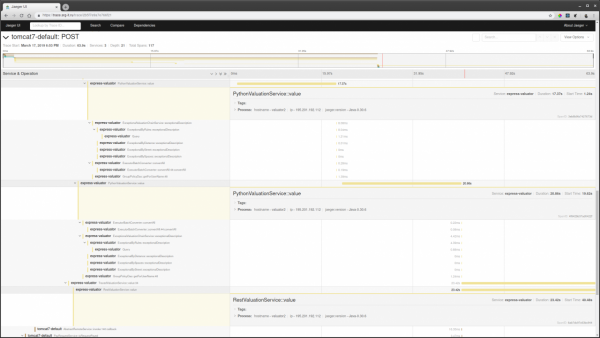
De asemenea, dacă se cunoaște un id al cererii, se poate găsi trace-ul după acest id prin căutarea tag-urilor, dacă acest id este logat în span-ul trace-ului.
Documentație
- Documentația OpenTracing
- Documentația Jaeger
- Conectarea Jaeger Java
- Conectarea Spring OpenTracing
Articole
- Jaeger OpenTracing și Microservicii în proiecte reale folosind PHP și Golang
- Evoluția Tracer-ului Distribuit la Uber Engineering
- Rularea Jaeger Agent pe hardware dedicat
Video
- Cum am folosit Jaeger și Prometheus pentru a oferi interogări ultra-rapide utilizatorilor — Bryan Boreham
- Intro: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, "O mică poveste despre o mare victorie: OpenTracing, AWS și Jaeger"
Sursa: habr.com
