

Anunț
Colegi, în mijlocul verii, planific să public un nou ciclu de articole despre proiectarea sistemelor de servicii de masă: „Experimentul VTrade” — o încercare de a scrie un cadru pentru sistemele de tranzacționare. În acest ciclu, vom analiza teoria și practica construirii unei burse, a unei licitații și a unui magazin. La finalul articolului, propun să votăm pentru cele mai interesante subiecte pentru voi.
Acesta este articolul de încheiere al ciclului despre aplicațiile reactive distribuite folosind Erlang/Elixir. În puteți găsi fundamentele teoretice ale arhitecturii reactive. ilustrează principalele modele și mecanisme de construire a acestor sisteme.
Astăzi vom discuta despre dezvoltarea bazei de cod și a proiectelor în general.
Organizarea serviciilor
În viața reală, când dezvoltăm un serviciu, adesea trebuie să combinăm mai multe modele de interacțiune într-un singur controler. De exemplu, serviciul de utilizatori, care se ocupă de gestionarea profilurilor utilizatorilor proiectului, trebuie să răspundă la cererile req-resp și să anunțe actualizările profilurilor prin pub-sub. Acest caz este destul de simplu: pentru messaging există un singur controler care implementa logica serviciului și publică actualizările.
Situația devine mai complexă atunci când trebuie să implementăm un serviciu distribuit rezistent la erori. Să ne imaginăm că cerințele pentru utilizatori s-au schimbat:
- acum serviciul trebuie să proceseze cereri pe 5 noduri din cluster,
- să aibă capacitatea de a executa sarcini de fundal pentru procesare,
- și de asemenea să fie capabil să gestioneze dinamic listele de abonamente pentru actualizările profilurilor.
Observație: Problema stocării consistente și replicării datelor nu o discutăm. Să presupunem că aceste probleme au fost soluționate anterior și că în sistem există deja un strat de stocare fiabil și scalabil, iar handlerii au mecanisme de interacțiune cu acesta.
Descrierea formală a serviciului utilizatori s-a complicat. Din perspectiva programatorului, datorită utilizării messaging-ului, modificările sunt minime. Pentru a satisface prima cerință, trebuie să configurăm balansarea la punctul de schimb req-resp.
Cererea de procesare a sarcinilor de fundal apare frecvent. În users, acestea pot fi verificări ale documentelor utilizatorilor, procesarea multimedia încărcate sau sincronizarea datelor cu rețelele sociale. Aceste sarcini trebuie cumva distribuite în cadrul cluster-ului și controlate în ceea ce privește progresul. Prin urmare, avem două opțiuni de soluționare: fie utilizăm șablonul de distribuție a sarcinilor din articolul anterior, fie, dacă acesta nu se potrivește, scriem un planificator de sarcini personalizat, care va gestiona grupul de procesatori așa cum avem nevoie.
Punctul 3 necesită extinderea șablonului pub-sub. Iar pentru realizare, după crearea punctului de schimb pub-sub, trebuie să pornim suplimentar controlerul acestui punct în cadrul serviciului nostru. Astfel, parcă scoatem logica de procesare a abonării și dezabonării din stratul de messaging în implementarea users.
În cele din urmă, decompunerea sarcinii a arătat că pentru a satisface cerințele trebuie să pornim pe noduri diferite 5 instanțe ale serviciului și să creăm o entitate suplimentară – controlerul pub-sub, care este responsabil de abonare.
Pentru a porni 5 procesatori nu este necesar să schimbăm codul serviciului. Singura acțiune suplimentară – configurarea regulilor de echilibrare pe punctul de schimb, despre care vom vorbi mai târziu.
De asemenea, a apărut o complexitate suplimentară: controlerul pub-sub și planificatorul de sarcini personalizat trebuie să funcționeze într-o singură instanță. Din nou, serviciul de messaging, ca element fundamental, trebuie să ofere un mecanism pentru alegerea unui lider.
Alegerea liderului
În sistemele distribuite, alegerea liderului este o procedură de numire a unui singur proces, responsabil pentru planificarea procesării distribuite a unei anumite sarcini.
În sistemele care nu sunt predispuse la centralizare, se utilizează algoritmi universali și algoritmi bazați pe consens, cum ar fi paxos sau raft.
Deoarece messaging este brokerul și elementul central, el cunoaște toate controlerele serviciului – candidații la poziția de lider. Messaging poate numi un lider fără a organiza o votare.
Toate serviciile, după ce au fost pornite și conectate la punctul de schimb, primesc un mesaj sistemic #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. În cazul în care LeaderPid coincide cu pid procesul curent, acesta este numit lider, iar lista Servers include toate nodurile și parametrii lor.
At the moment a new node joins and an active cluster node is disconnected, all service controllers receive #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} și #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} corespunzător.
Thus, all components are aware of all changes, and at any given moment, there is guaranteed to be one leader in the cluster.
Intermediaries
To implement complex distributed processing processes, as well as in tasks of optimizing the existing architecture, it is convenient to use intermediaries.
To avoid changing service codes and to handle, for example, tasks of additional processing, routing, or message logging, a proxy handler can be placed before the service, which will perform all the additional work.
A classic example of pub-sub optimization is a distributed application with a business core that generates update events, such as price changes in the market, and an access layer — N servers providing a websocket API for web clients.
If we tackle it head-on, servicing the client looks as follows:
- the client establishes connections with the platform. On the server side, where the traffic is terminated, a process is launched to service this connection.
- within the context of the servicing process, authorization and subscription to updates occur. The process calls the subscribe method for the topics.
- after the event is generated in the core, it is delivered to the processes servicing the connections.
Imagine we have 50,000 subscribers to the topic "news". The subscribers are evenly distributed across 5 servers. As a result, each update arriving at the exchange point will be replicated 50,000 times: 10,000 times on each server, corresponding to the number of subscribers on it. Not a very efficient scheme, right?
To improve the situation, we will introduce a proxy that has the same name as the exchange point. The global name register should be able to return the nearest process by name, which is important.
We will run this proxy on the access layer servers, and all our processes servicing the websocket API will subscribe to it, rather than the original pub-sub exchange point in the core. The proxy subscribes to the core only in the case of unique subscriptions and replicates the incoming message to all its subscribers.
As a result, only 5 messages will be sent between the core and the access servers, instead of 50,000.
Routing and load balancing
Req-Resp
In the current implementation of messaging, there are 7 request distribution strategies:
default. Cererea este trimisă tuturor controlerilor.round-robin. Se face o iterație și o distribuție ciclică a cererilor între controlere.consensus. Controlerele care servesc serviciul se împart în lider și subalterni. Cererile sunt trimise doar liderului.consensus & round-robin. În grup există un lider, dar cererile sunt distribuite între toți membrii.sticky. Se calculează o funcție hash și se leagă de un anumit procesor. Cererile ulterioare cu această semnătură ajung la același procesor.sticky-fun. La inițializarea punctului de schimb se transmite suplimentar o funcție de calculare a hash-ului pentrustickybalansare.distracția. Analogu cu sticky-fun, dar suplimentar putem redirecționa, respinge sau preprocesa.
Strategia de distribuție este stabilită la inițializarea punctului de schimb.
Pe lângă balansare, messagingul permite etichetarea entităților. Să analizăm tipurile de etichete din sistem:
- Eticheta de conectare. Permite înțelegerea prin ce conexiune au venit evenimentele. Se folosește atunci când procesul controlerului se conectează la un singur punct de schimb, dar cu diferite chei de rutare.
- Eticheta de serviciu. Permite gruparea procesorilor pentru un singur serviciu și extinderea capacităților de rutare și balansare. Pentru un model req-resp, rutarea este liniară. Trimitem o cerere la punctul de schimb, care apoi o transmite serviciului. Dar dacă vrem să împărțim procesorii în grupuri logice, această împărțire se realizează prin etichete. La specificarea unei etichete, cererea va fi direcționată către un anumit grup de controlere.
- Eticheta cererii. Permite deosebirea răspunsurilor. Deoarece sistemul nostru este asincron, pentru a procesa răspunsurile serviciului trebuie să avem posibilitatea de a specifica RequestTag la trimiterea cererii. Prin aceasta vom putea înțelege la ce cerere a venit răspunsul.
Pub-sub
Pentru pub-sub, lucrurile sunt puțin mai simple. Avem un punct de schimb la care se publică mesaje. Punctul de schimb distribuie mesajele între abonați, care s-au abonat la cheile de rutare dorite (poate fi spus că este un analog al temelor).
Scalabilitate și disponibilitate
Scalabilitatea sistemului în ansamblu depinde în totalitate de gradul de scalabilitate al straturilor și componentelor sistemului:
- Serviciile se scalează prin adăugarea de noduri suplimentare în cluster cu gestionarii acestui serviciu. În timpul exploatării experimentale, se poate alege politica optimă de echilibrare.
- Serviciul de messaging, în cadrul unui cluster separat, se scalează, în general, fie prin mutarea punctelor de schimb foarte solicitate pe noduri separate ale clusterului, fie prin adăugarea proceselor proxy în zonele foarte solicitate ale clusterului.
- Scalabilitatea întregului sistem, ca caracteristică, depinde de flexibilitatea arhitecturii și de capacitatea de a combina unele clustere într-o entitate logică comună.
Succesul unui proiect depinde adesea de simplitatea și rapidezea scalării. Messaging-ul în actuala sa implementare crește odată cu aplicația. Chiar dacă ne lipsesc un cluster de 50-60 de mașini, putem recurge la federare. Din păcate, tema federării depășește limita acestui articol.
Rezervare
În analiza echilibrării încărcăturii, am discutat deja despre rezervarea controlerelor de servicii. Totuși, messaging-ul trebuie să fie rezervat și el. În cazul căderii unui nod sau a unei mașini, messaging-ul trebuie să se recupereze automat, și asta în cel mai scurt timp.
În proiectele mele, folosesc noduri suplimentare care preiau sarcina în cazul unei căderi. În Erlang există o implementare standard a modului distribuit pentru aplicațiile OTP. Modul distribuit este exact ceea ce realizează recuperarea în cazul unei defecțiuni prin lansarea aplicației căzute pe un alt nod deja pornit. Procesul este transparent, după o defecțiune aplicația se mută automat pe nodul de failover. Puteți citi mai multe despre această funcționalitate. .
Performanță
Să încercăm măcar aproximativ să comparăm performanța rabbitmq cu messaging-ul nostru personalizat.
Am găsit testării rabbitmq de către echipa openstack.
În punctul 6.14.1.2.1.2.2 din documentul original este prezentat rezultatul RPC CAST:
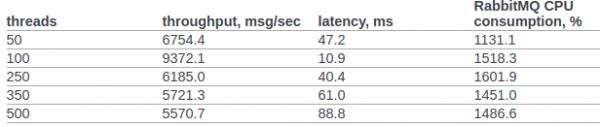
Preliminar, nu vom face nicio modificare suplimentară în nucleul sistemului de operare sau în Erlang VM. Condițiile pentru testare:
- erl opts: +A1 +sbtu.
- Testul în cadrul unui singur nod Erlang este derulat pe un laptop cu un vechi i7 în versiune mobilă.
- Testele de cluster se desfășoară pe servere cu rețea de 10G.
- Codul rulează în containere docker. Rețeaua este în modul NAT.
Codul testului:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenariul 1: Testul se desfășoară pe un laptop cu un vechi i7 mobil. Testul, messaging și serviciul rulează pe un singur nod într-un singur container Docker:
Secvențial 10000 de cicluri în ~0 secunde (26987 cicluri/s)
Secvențial 20000 de cicluri în ~1 secundă (26915 cicluri/s)
Secvențial 100000 de cicluri în ~4 secunde (26957 cicluri/s)
Paralel 2 100000 de cicluri în ~2 secunde (44240 cicluri/s)
Paralel 4 100000 de cicluri în ~2 secunde (53459 cicluri/s)
Paralel 10 100000 de cicluri în ~2 secunde (52283 cicluri/s)
Paralel 100 100000 de cicluri în ~3 secunde (49317 cicluri/s)
Scenariul 2: 3 noduri rulând pe mașini diferite sub Docker (NAT).
Secvențial 10000 de cicluri în ~1 secundă (8684 cicluri/s)
Secvențial 20000 de cicluri în ~2 secunde (8424 cicluri/s)
Secvențial 100000 de cicluri în ~12 secunde (8655 cicluri/s)
Paralel 2 100000 de cicluri în ~7 secunde (15160 cicluri/s)
Paralel 4 100000 de cicluri în ~5 secunde (19133 cicluri/s)
Paralel 10 100000 de cicluri în ~4 secunde (24399 cicluri/s)
Paralel 100 100000 de cicluri în ~3 secunde (34517 cicluri/s)
În toate cazurile, utilizarea procesorului nu a depășit 250%
Concluzii
Sper că acest ciclu nu arată ca o descărcare a conștiinței și că experiența mea va aduce un real beneficiu atât cercetătorilor în sisteme distribuite, cât și practicienilor care sunt la începutul construției arhitecturilor distribuite pentru sistemele lor de afaceri și care se uită cu interes la Erlang/Elixir, dar se întreabă dacă merită...
Fotografie
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Ce teme ar trebui să discut detaliat în cadrul ciclului „Experiment VTrade”?
Teoria: Piețele, ordinele și perioada lor de valabilitate: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Cartea de ordine. Teoria și practica implementării cărții cu grupări
Vizualizarea tranzacțiilor: Tick-uri, bare, rezoluții. Cum să stocați și cum să asamblați
Backoffice. Planificare și dezvoltare. Controlul angajaților și investigarea incidentelor
API. Studăm ce interfețe sunt necesare și cum să le implementăm
Stocarea informațiilor: PostgreSQL, Timescale, Tarantool în sistemele de tranzacționare
Reactivitatea în sistemele de tranzacționare
Altele. Voi scrie în comentarii
Au votat 6 utilizatori. 4 utilizatori s-au abținut.
Sursa: habr.com
