

Salut, Habr!
Astăzi ne vom exercita abilitățile de utilizare a instrumentelor de grupare și vizualizare a datelor în Python. În setul de date furnizat vom analiza câteva caracteristici și vom crea un set de vizualizări.
După tradiție, la început, ne vom defini obiectivele:
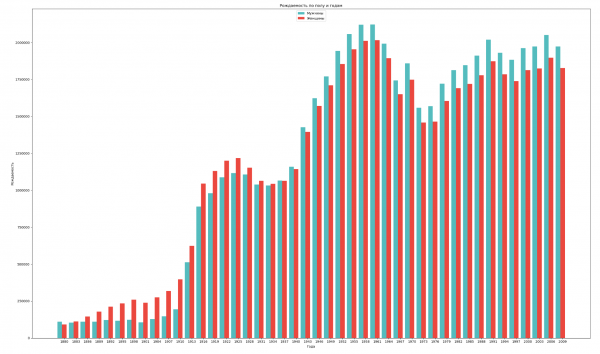
- Să grupăm datele pe sex și an și să vizualizăm dinamica totală a nașterilor pentru ambele sexe;
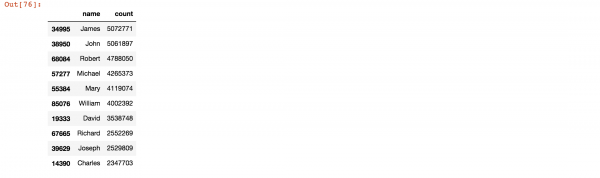
- Să găsim cele mai populare nume din întreaga istorie;
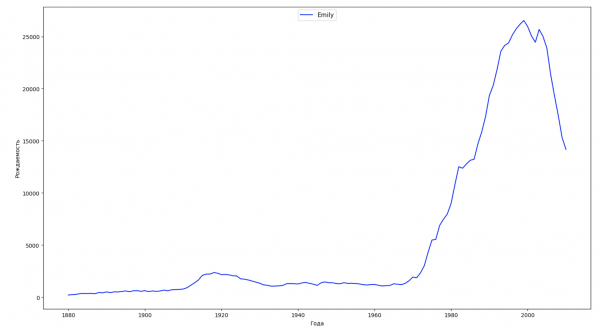
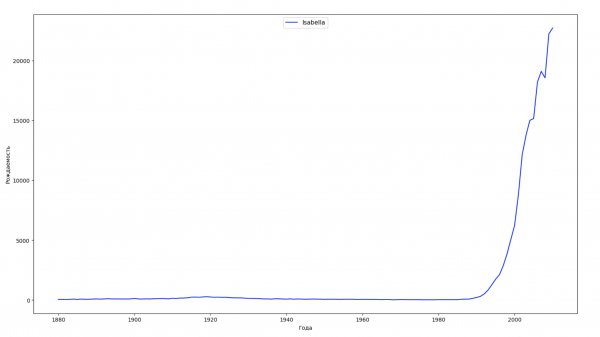
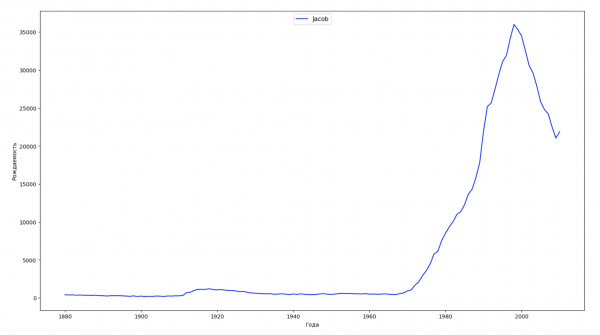
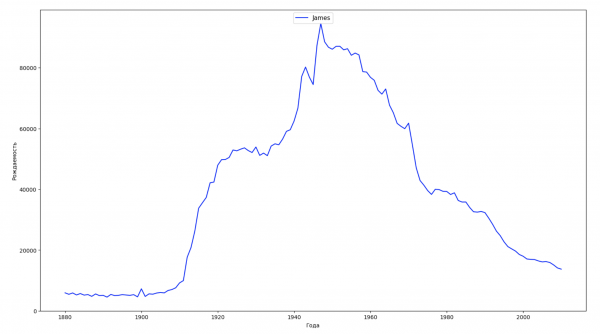
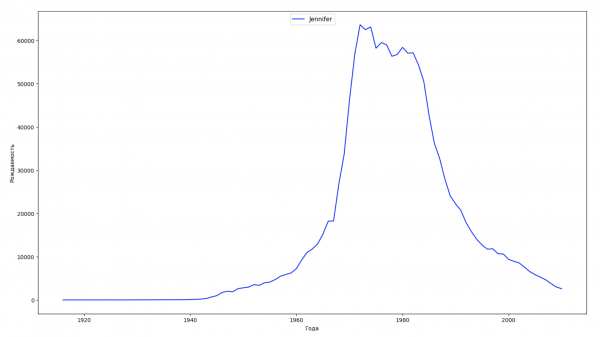
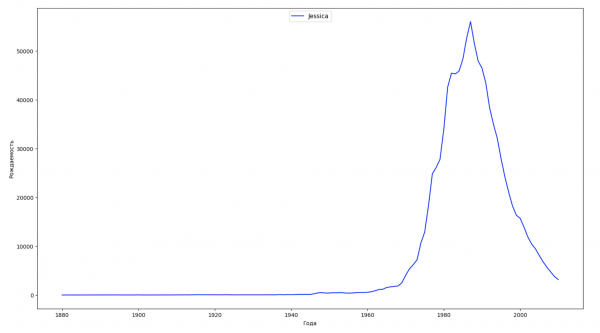
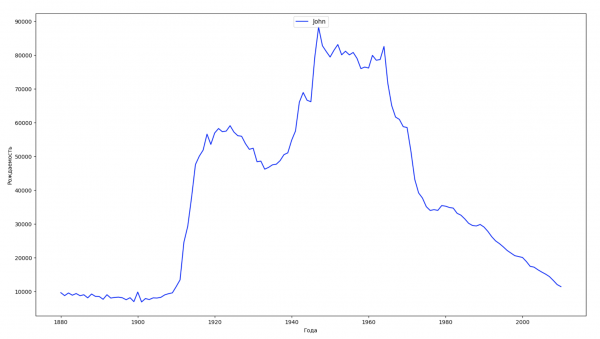
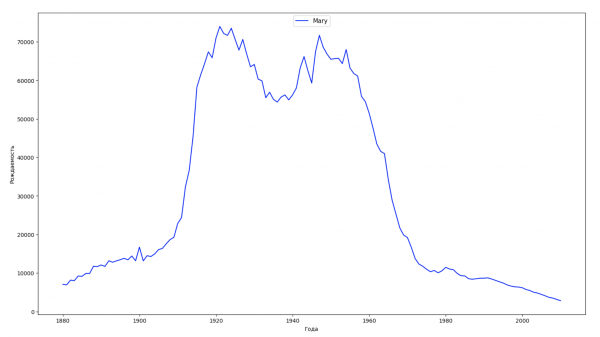
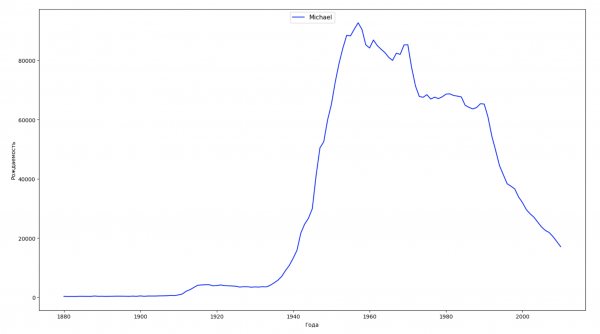
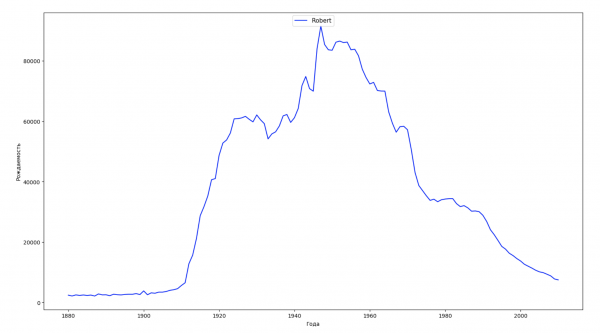
- Să împărțim întreaga perioadă de timp din date în 10 părți și să găsim pentru fiecare cea mai populară nume pentru fiecare sex. Pentru fiecare nume găsit, să vizualizăm dinamica sa pe întreaga perioadă;
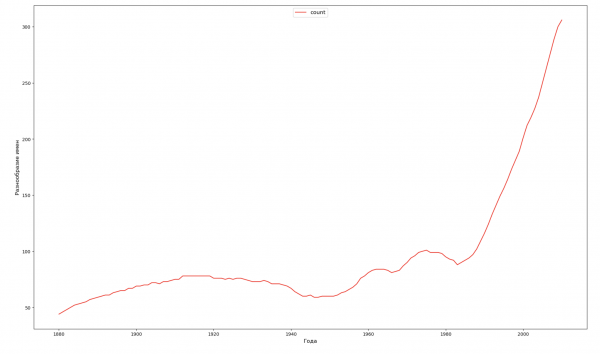
- Pentru fiecare an, să calculăm câte nume acoperă 50% din oameni și să vizualizăm (vom vedea diversitatea numelui pentru fiecare an);
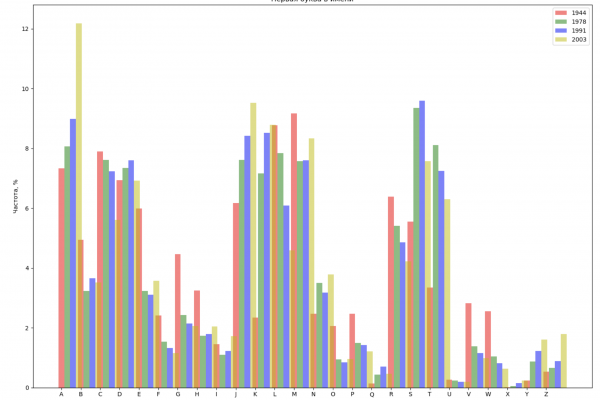
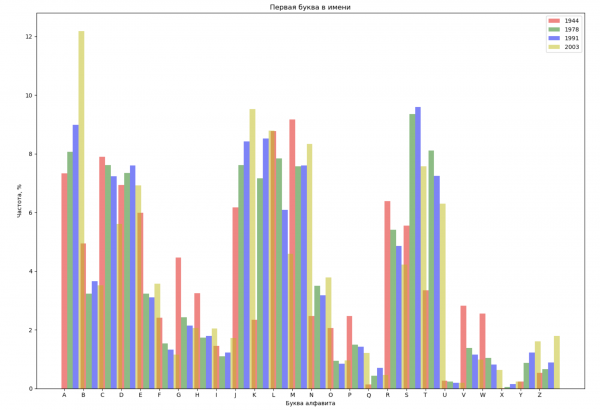
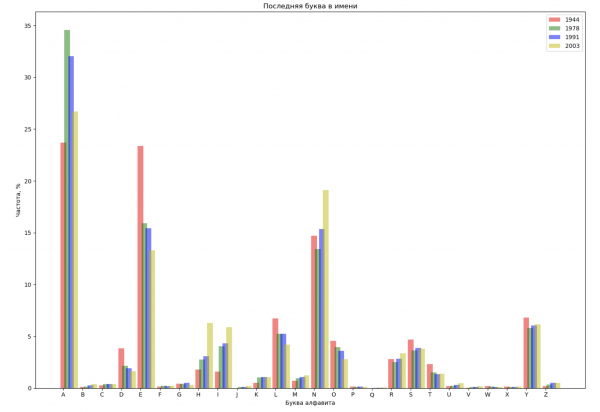
- Să alegem 4 ani din întreaga perioadă și să afișăm pentru fiecare an distribuția după prima literă a numelui și după ultima literă a numelui;
- Să realizăm o listă cu câțiva oameni celebri (președinți, cântăreți, actori, personaje de film) și să evaluăm influența lor asupra dinamicii numelui. Să construim o vizualizare expresivă.
Mai puține cuvinte, mai mult cod!
Să începem.
Vom grupa datele pe sex și an și vom vizualiza dinamica totală a nașterilor pentru ambele sexe:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

years = np.arange(1880, 2011, 3)
datalist = 'https://raw.githubusercontent.com/wesm/pydata-book/2nd-edition/datasets/babynames/yob{year}.txt'
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)
sex = result.groupby('sex')
births_men = sex.get_group('M').groupby('year', as_index=False)
births_women = sex.get_group('F').groupby('year', as_index=False)
births_men_list = births_men.aggregate(np.sum)['count'].tolist()
births_women_list = births_women.aggregate(np.sum)['count'].tolist()

fig, ax = plt.subplots()
fig.set_size_inches(25,15)

index = np.arange(len(years))
stolb1 = ax.bar(index, births_men_list, 0.4, color='c', label='Bărbați')
stolb2 = ax.bar(index + 0.4, births_women_list, 0.4, alpha=0.8, color='r', label='Femei')

ax.set_title('Nașterile pe sexe și ani')
ax.set_xlabel('Ani')
ax.set_ylabel('Nașteri')
ax.set_xticklabels(years)
ax.set_xticks(index + 0.4)
ax.legend(loc=9)

fig.tight_layout()
plt.show()
Să găsim cele mai populare nume din întreaga istorie:
years = np.arange(1880, 2011)

dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe)

result = pd.concat(dataframes)
names = result.groupby('name', as_index=False).sum().sort_values('count', ascending=False)
names.head(10)
Vom împărți întreaga perioadă de timp din date în 10 părți și pentru fiecare vom găsi cel mai popular nume pentru fiecare sex. Pentru fiecare nume găsit, vom vizualiza dinamica acestuia de-a lungul timpului:
years = np.arange(1880, 2011)
part_size = int((years[years.size - 1] - years[0]) / 10) + 1
parts = {}
def GetPart(year):
    return int((year - years[0]) / part_size)
for year in years:
    index = GetPart(year)
    r = years[0] + part_size * index, min(years[years.size - 1], years[0] + part_size * (index + 1))
    parts[index] = str(r[0]) + '-' + str(r[1])

dataframe_parts = []
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframe_parts.append(dataframe.assign(years=parts[GetPart(year)]))
    dataframes.append(dataframe.assign(year=year))

result_parts = pd.concat(dataframe_parts)
result = pd.concat(dataframes)

result_parts_sums = result_parts.groupby(['years', 'sex', 'name'], as_index=False).sum()
result_parts_names = result_parts_sums.iloc[result_parts_sums.groupby(['years', 'sex'], as_index=False).apply(lambda x: x['count'].idxmax())]
result_sums = result.groupby(['year', 'sex', 'name'], as_index=False).sum()

for groupName, groupLabels in result_parts_names.groupby(['name', 'sex']).groups.items():
    group = result_sums.groupby(['name', 'sex']).get_group(groupName)
    fig, ax = plt.subplots(1, 1, figsize=(18,10))

    ax.set_xlabel('Ani')
    ax.set_ylabel('Natalitate')
    label = group['name']
    ax.plot(group['year'], group['count'], label=label.aggregate(np.max), color='b', ls='-')
    ax.legend(loc=9, fontsize=11)

    plt.show()
Pentru fiecare an, vom calcula câte nume acoperă 50% din oameni și vom vizualiza aceste date:
dataframe = pd.DataFrame({'year': [], 'count': []})
years = np.arange(1880, 2011)
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    names['sum'] = names.sum()['count']
    names['percent'] = names['count'] / names['sum'] * 100
    names = names.sort_values(['percent'], ascending=False)
    names['cum_perc'] = names['percent'].cumsum()
    names_filtered = names[names['cum_perc'] <= 50]
    dataframe = dataframe.append(pd.DataFrame({'year': [year], 'count': [names_filtered.shape[0]]}))

fig, ax1 = plt.subplots(1, 1, figsize=(22,13))
ax1.set_xlabel('Ani', fontsize = 12)
ax1.set_ylabel('Diversitate a numelui', fontsize = 12)
ax1.plot(dataframe['year'], dataframe['count'], color='r', ls='-')
ax1.legend(loc=9, fontsize=12)

plt.show()
Vom alege 4 ani din întreaga perioadă și vom ilustra pentru fiecare an distribuția pe prima și ultima literă a numelui:
de la string import ascii_lowercase, ascii_uppercase

fig_first, ax_first = plt.subplots(1, 1, figsize=(14,10))
fig_last, ax_last = plt.subplots(1, 1, figsize=(14,10))

index = np.arange(len(ascii_uppercase))
years = [1944, 1978, 1991, 2003]
colors = ['r', 'g', 'b', 'y']
n = 0
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    count = names.shape[0]

    dataframe = pd.DataFrame({'letter': [], 'frequency_first': [], 'frequency_last': []})
    for letter in ascii_uppercase:
        countFirst = (names[names.name.str.startswith(letter)].count()['count'])
        countLast = (names[names.name.str.endswith(letter.lower())].count()['count'])

        dataframe = dataframe.append(pd.DataFrame({
            'letter': [letter],
            'frequency_first': [countFirst / count * 100],
            'frequency_last': [countLast / count * 100]}))

    ax_first.bar(index + 0.3 * n, dataframe['frequency_first'], 0.3, alpha=0.5, color=colors[n], label=year)
    ax_last.bar(index + bar_width * n, dataframe['frequency_last'], 0.3, alpha=0.5, color=colors[n], label=year)
    n += 1

ax_first.set_xlabel('Litera alfabetului')
ax_first.set_ylabel('Frecvență, %')
ax_first.set_title('Prima literă a numelui')
ax_first.set_xticks(index)
ax_first.set_xticklabels(ascii_uppercase)
ax_first.legend()

ax_last.set_xlabel('Litera alfabetului')
ax_last.set_ylabel('Frecvență, %')
ax_last.set_title('Ultima literă a numelui')
ax_last.set_xticks(index)
ax_last.set_xticklabels(ascii_uppercase)
ax_last.legend()

fig_first.tight_layout()
fig_last.tight_layout()

plt.show()
Să facem o lista cu câțiva oameni celebri (președinți, cântăreți, actori, personaje de film) și să evaluăm influența lor asupra dinamicii numelui:
celebrities = {'Frank': 'M', 'Britney': 'F', 'Madonna': 'F', 'Bob': 'M'}
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)

for celebrity, sex in celebrities.items():
    names = result[result.name == celebrity]
    dataframe = names[names.sex == sex]
    fig, ax = plt.subplots(1, 1, figsize=(16,8))

    ax.set_xlabel('Ani', fontsize = 10)
    ax.set_ylabel('Nașteri', fontsize = 10)
    ax.plot(dataframe['year'], dataframe['count'], label=celebrity, color='r', ls='-')
    ax.legend(loc=9, fontsize=12)

    plt.show()
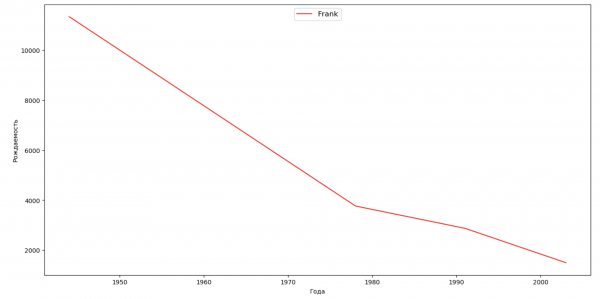
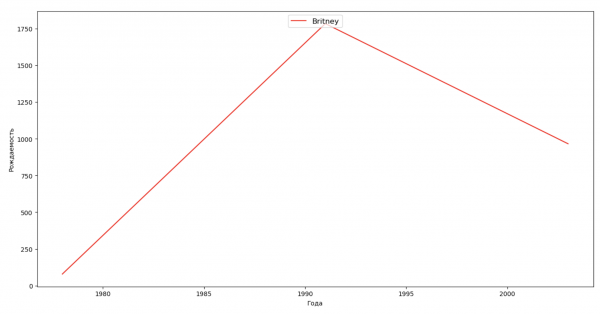
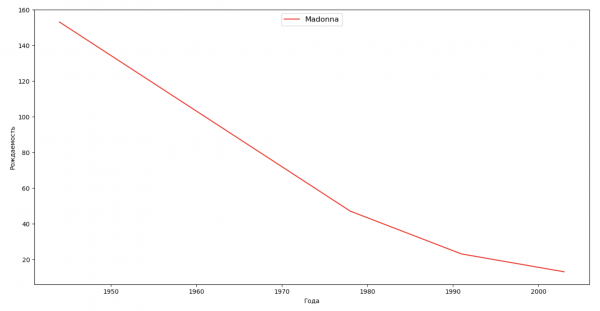
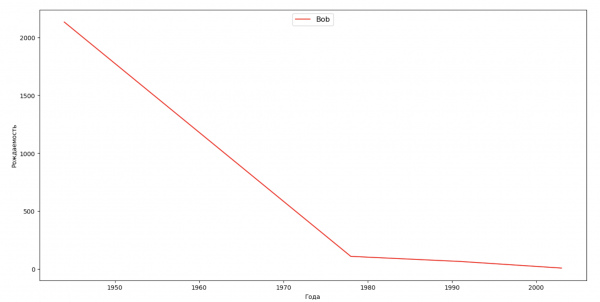
Ca un exercițiu, din ultimul exemplu poți adăuga în vizualizare perioada de viață a celebrității, pentru a evalua impactul lor asupra dinamicii numelui.
Astfel, toate obiectivele noastre au fost atinse și realizate. Am stăpânit utilizarea instrumentelor de grupare și vizualizare a datelor în Python și vom continua să lucrăm cu datele. Fiecare va putea să își exprime concluziile pe baza datelor deja prezentate și vizualizate.
Tutore pentru toți!
Sursa: habr.com
