

Aș dori să vă povestesc despre un mecanism interesant de lucru cu configurația unui sistem distribuit. Configurația este prezentată direct în limbajul compilabil (Scala) folosind tipuri sigure. În această postare este analizat un exemplu al acestei configurații și sunt discutate diferitele aspecte ale integrării configurației compilabile în procesul general de dezvoltare.
()
Introducere
Construirea unui sistem distribuit de încredere implică utilizarea unei configurații corecte pe toate nodurile, sincronizată cu celelalte noduri. De obicei, se folosesc tehnologii DevOps (terraform, ansible sau ceva similar) pentru generarea automată a fișierelor de configurație (adesea specifice fiecărui nod). De asemenea, ne-ar plăcea să ne asigurăm că toate nodurile interacționează folosind protocoale identice (inclusiv versiuni identice). În caz contrar, va exista incompatibilitate în sistemul nostru distribuit. În lumea JVM, una dintre consecințele acestei cerințe este necesitatea de a folosi peste tot aceeași versiune a bibliotecii care conține mesajele protocolului.
Ce ne putem spune despre testarea unui sistem distribuit? Desigur, presupunem că toate componentele au unit-testuri, înainte de a trece la testarea de integrare. (Pentru a putea extrapola rezultatele testelor pe runtime, trebuie să ne asigurăm că avem un set identic de biblioteci atât în etapa de testare, cât și în runtime.)
Atunci când lucrăm cu teste de integrare, de multe ori este mai simplu să folosim un classpath uniform pe toate nodurile. Ne va rămâne doar să ne asigurăm că același classpath este folosit și în runtime. (Deși este posibil să se ruleze noduri diferite cu classpath-uri diferite, acest lucru complică întreaga configurație și îngreunează desfășurarea și testele de integrare.) În cadrul acestei postări, presupunem că pe toate nodurile va fi folosit același classpath.
Configurarea evoluează împreună cu aplicația. Pentru a identifica diferitele etape ale evoluției programelor, folosim versiuni. Este logic să identificăm și diferitele versiuni ale configurațiilor. Configurația în sine ar trebui să fie plasată într-un sistem de control al versiunilor. Dacă în producție există o singură configurație, putem folosi pur și simplu numărul versiunii. Dacă sunt utilizate mai multe instanțe de producție, atunci va fi necesar să avem mai multe
ramuri de configurație și o etichetă suplimentară în afară de versiune (de exemplu, numele ramurii). Astfel, vom putea identifica în mod clar configurația exactă. Fiecare identificator de configurație corespunde în mod unic unei combinații specifice de noduri distribuite, porturi, resurse externe, versiuni de biblioteci. În cadrul acestui articol, vom presupune că există doar o singură ramură și că putem identifica configurația în mod obișnuit folosind trei numere, separate prin punct (1.2.3).
În mediile moderne, fișierele de configurație sunt create manual destul de rar. De cele mai multe ori, ele sunt generate în timpul desfășurării și nu mai sunt modificate (pentru a ). Se ridică o întrebare pe bună dreptate: de ce mai folosim încă formatul text pentru stocarea configurației? O alternativă viabilă ar fi utilizarea codului obișnuit pentru configurație și obținerea avantajelor prin verificări în timpul compilării.
În acest articol, explorăm ideea de a reprezenta configurația în interiorul artefactului compilat.
Configurarea compilată
În această secțiune este prezentat un exemplu de configurație statică compilată. Se implementează două servicii simple — un serviciu de echo și un client al serviciului de echo. Pe baza acestor două servicii se construiesc două variante ale sistemului. Într-o variantă, ambele servicii sunt situate pe același nod, iar în cealaltă variantă — pe noduri diferite.
De obicei, un sistem distribuit conține mai multe noduri. Nodurile pot fi identificate prin valori de un anumit tip NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
sau
case class NodeId(hostName: String)sau chiar
object Singleton
type NodeId = Singleton.type
Nodurile îndeplinesc diverse roluri, pe ele sunt rulante servicii și între ele pot fi stabilite conexiuni TCP/HTTP.
Pentru a descrie conexiunea TCP, avem nevoie de cel puțin un număr de port. De asemenea, ne-ar plăcea să reflectăm protocolul care este acceptat pe acest port, pentru a ne asigura că atât clientul, cât și serverul folosesc același protocol. Vom descrie conexiunea utilizând următoarea clasă:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])unde Port — un număr întreg simplu Int indicând intervalul valorilor permise:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Tipuri rafinate
Vezi biblioteca și . Pe scurt, biblioteca permite adăugarea de restricții la tipuri, verificate la momentul compilării. În acest caz, valorile permise pentru numărul de port sunt numere întregi de 16 biți. Pentru configurații compilate, utilizarea bibliotecii refined nu este obligatorie, dar permite îmbunătățirea capacităților compilatorului în verificarea configurației.
Pentru protocoalele HTTP (REST), pe lângă numărul de port, s-ar putea să avem nevoie și de calea către serviciu:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Tipuri fantomă
Pentru a identifica protocolul la momentul compilării, folosim un parametru de tip care nu este utilizat în interiorul clasei. Această soluție este legată de faptul că, în timpul execuției, nu folosim instanța protocolului, dar dorim ca compilatorul să verifice compatibilitatea protocoalelor. Datorită specificării protocolului, nu vom putea transmite un serviciu nepotrivit ca dependență.
Unul dintre protocoalele comune este REST API cu serializare Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]unde RequestMessage — tipul cererii, ResponseMessage — tipul răspunsului.
Desigur, se pot folosi și alte descrieri ale protocoalelor care oferă acuratețea necesară descrierii noastre.
Pentru scopurile acestui articol, vom folosi o versiune simplificată a protocolului:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Aici cererea este un șir adăugat la url, iar răspunsul este șirul returnat în corpul răspunsului HTTP.
Configurația serviciului este descrisă prin numele serviciului, porturi și dependențe. Aceste elemente pot fi reprezentate în Scala în mai multe moduri (de exemplu, HList-uri, tipuri de date algebraice). Pentru scopurile acestui articol, vom folosi Cake Pattern și vom reprezenta modulele prin traitModel. (Cake Pattern nu este un element obligatoriu al abordării descrise. Este doar una dintre posibilele implementări.)
Dependențele dintre servicii pot fi reprezentate sub forma unor metode care returnează porturi EndPointale altor noduri:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Pentru a crea un serviciu echo, este suficient doar numărul portului și indicația că acest port suportă protocolul echo. Nu am fi fost nevoiți să specificăm un port concret, deoarece trăsăturile permite declararea metodelor fără implementare (metode abstracte). În acest caz, la crearea unei configurații specifice, compilatorul ne-ar solicita să oferim implementarea metodei abstracte și să furnizăm numărul portului. Deoarece am implementat metoda, la crearea unei configurații specifice nu trebuie să specificăm un alt port. Se va folosi valoarea implicită.
În configurația clientului, declarăm dependența de serviciul echo:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Dependența are același tip ca și serviciul exportat echoService. În special, în clientul echo, cerem același protocol. Prin urmare, când conectăm cele două servicii, putem fi siguri că totul va funcționa corect.
Implementarea serviciilor
Pentru a porni și opri serviciul, este necesară o funcție. (Posibilitatea de a opri serviciul este critică pentru testare.) Din nou, sunt disponibile mai multe variante pentru implementarea unei astfel de funcții (de exemplu, am putea utiliza clase de tip pe baza tipului de configurație). În scopul acestui post, vom folosi Cake Pattern. Vom reprezenta serviciul printr-o clasă cats.Resource, deoarece în această clasă sunt deja prevăzute mijloace pentru eliberarea sigură și garantată a resurselor în caz de probleme. Pentru a obține resursa, trebuie să furnizăm configurația și contextul runtime pregătit. Funcția de pornire a serviciului ar putea avea următoarea formă:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
unde
Configurație— tipul de configurație pentru acest serviciuAddressResolver— obiect de execuție care permite aflarea adreselor altor noduri (vezi mai departe)
și celelalte tipuri din bibliotecă cats:
F[_]— tip de efect (în cel mai simplu cazF[A]poate fi doar o funcție() => A. În acest post vom utilizacats.IO.)Reader[A,B]— un sinonim mai mult sau mai puțin pentru funcțieA => Bcats.Resource— resursă care poate fi obținută și eliberatăTimer— cronometru (permite a dormi pentru o perioadă de timp și a măsura intervalele de timp)ContextShift— analogExecutionContextApplicative— clasă de tip efect care permite combinarea efectelor separate (aproape o monadă). În aplicații mai complexe, este, probabil, mai bine să folosimMonad/ConcurrentEffect.
Folosind această semnătură a funcției, putem implementa mai multe servicii. De exemplu, un serviciu care nu face nimic:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Vezi. , în care sunt implementate alte servicii — ,
și .)
Un nod reprezintă un obiect care poate porni mai multe servicii (pornirea lanțului de resurse este asigurată prin Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Rețineți că specificăm tipul exact de configurație necesar pentru acest nod. Dacă uităm să specificăm vreun tip de configurație cerut de un serviciu separată, va apărea o eroare de compilare. De asemenea, nu vom putea porni nodul dacă nu furnizăm un obiect care are un tip potrivit cu toate datele necesare.
Rezolvarea denumirilor nodurilor
Pentru a ne conecta la un nod la distanță, avem nevoie de o adresă IP reală. Este foarte posibil ca adresa să devină cunoscută mai târziu decât celelalte părți ale configurației. Prin urmare, avem nevoie de o funcție care să mapeze identificatorul nodului la adresă:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Se pot propune mai multe modalități de implementare a unei astfel de funcții:
- Dacă adresele devin cunoscute înainte de desfășurare, putem genera cod Scala cu
adresele și apoi putem lansa construcția. În acest caz, se va efectua compilarea și se vor rula teste.
În acest caz, funcția va fi cunoscută static și poate fi reprezentată în cod sub formă de mapare.Map[NodeId, NodeAddress]. - În unele cazuri, adresa validă devine cunoscută doar după ce nodul a fost pornit.
În acest caz, putem implementa un „serviciu de descoperire” (discovery), care se pornește înaintea celorlalte noduri și toate nodurile se vor înregistra în acest serviciu și vor solicita adresele altor noduri. - Dacă putem modifica
/etc/hosts, atunci putem folosi nume predefinite pentru gazde (de exemplu,my-project-main-nodeșiecho-backend) și pur și simplu legăm aceste nume
de adresele IP în cadrul desfășurării.
În cadrul acestei postări, nu vom analiza aceste cazuri mai în detaliu. Pentru exemplul nostru
didactic, toate nodurile vor avea o singură adresă IP — 127.0.0.1.
În continuare, vom analiza două opțiuni pentru sistemul distribuit:
- Plasarea tuturor serviciilor pe un singur nod.
- Și plasarea serviciului de echo și a clientului de echo pe noduri diferite.
Configurare pentru :
Configurare pentru un singur nod
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identificatorul nodului unic
  \/\/ configurația serverului
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Specificație sigură pentru portul de serviciu. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configurația clientului

  \/** Vom folosi serviciul oferit de aceeași gazdă. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configurația controller-ului de ciclu de viață
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 secunde suplimentare pentru a avea 10 cereri, nu 9.
}
Obiectul implementează configurația atât pentru client cât și pentru server. De asemenea, se utilizează configurația ciclului de viață pentru a încheia programul după un interval. lifetime atunci când se încheie programul. (Ctrl-C funcționează, de asemenea, și eliberează corect toate resursele.)
Același set de trait-uri pentru configurație și implementări poate fi folosit pentru a crea un sistem format din :
Configurare pentru două noduri
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specificația dependenței
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 secunde suplimentare pentru a avea 10 cereri, nu 9.

    def testMessage: String = "dolly"
  }
Important! Please note how service linking is performed. We specify the service implemented by one node as the implementation of the dependency method of another node. The type of dependency is checked by the compiler, as it contains the protocol type. When running, the dependency will contain the correct identifier of the target node. Thanks to this scheme, we specify the port number exactly once and always refer to the correct port.
Implementation of two nodes in the system
For this configuration, we use the same service implementations without changes. The only difference is that we now have two objects implementing different sets of services:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
The first node implements the server and only requires the server configuration. The second node implements the client and uses a different part of the configuration. Additionally, both nodes need lifecycle management. The server node runs indefinitely until stopped SIGTERMwhile the client node terminates after a while. See .
Overall development process
Let’s see how this configuration approach affects the overall development process.
The configuration will be compiled together with the rest of the code and an artifact (.jar) will be generated. It seems reasonable to place the configuration in a separate artifact. This is because we can have multiple configurations based on the same code. Again, artifacts corresponding to different branches of configuration can be generated. Along with the configuration, dependencies on specific library versions are preserved and these versions are kept forever, whenever we decide to deploy this version of the configuration.
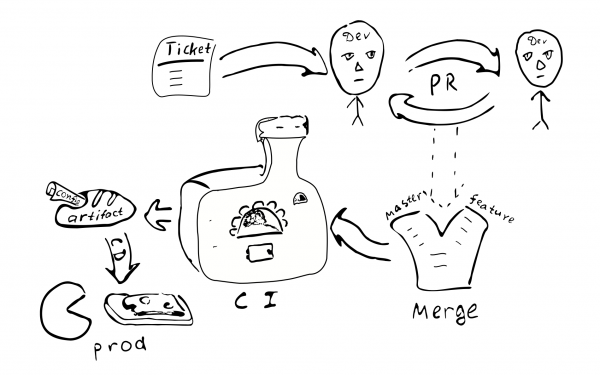
Any change in the configuration turns into a change in the code. Therefore, each such
change will be covered by the usual quality assurance process:
Ticket in the bug tracker -> PR -> review -> merge with the corresponding branches ->
integration -> deployment
Main consequences of implementing compile-time configuration:
Configurarea va fi convenită pe toate nodurile sistemului distribuit. Având în vedere că toate nodurile primesc aceeași configurație dintr-o sursă unică.
Este problematic să schimbi configurația doar pe unul dintre noduri. Prin urmare, "desincronizarea configurației" (configuration drift) este puțin probabilă.
Devine mai dificil să faci modificări mici în configurație.
Majoritatea modificărilor de configurație vor avea loc în cadrul procesului general de dezvoltare și vor fi supuse revizuirii.
Este necesar un depozit separat pentru a stoca configurația de producție? Într-o astfel de configurație pot fi incluse parole și alte informații secrete, accesul la care am dori să-l restricționăm. Pe această bază, pare logic să păstrăm configurația finală într-un depozit separat. Se poate împărți configurația în două părți: una care conține parametrii de configurație publici și alta care conține parametrii cu acces restricționat. Aceasta va permite majorității dezvoltatorilor să aibă acces la parametrii generali. O astfel de separare nu este greu de realizat, folosind trait-uri intermediare care conțin valori implicite.
Varianta posibilă
Să comparăm configurația compilată cu unele alternative comune:
- Fișier text pe mașina țintă.
- Depozit centralizat de tip cheie-valoare (
etcd/zookeeper). - Componente ale procesului care pot fi reconfigurate/repornește fără a reporni procesul.
- Stocarea configurației în afara artefactului și controlul versiunilor.
Fișierele text oferă o flexibilitate semnificativă în ceea ce privește modificările mici. Administratorul de sistem poate accesa nodul remote, face modificările în fișierele corespunzătoare și reporni serviciul. Pentru sisteme mari, totuși, o astfel de flexibilitate poate fi nedorită. Modificările efectuate nu lasă urme în alte sisteme. Nimeni nu revizuiește modificările. Este greu de stabilit cine a efectuat modificările și din ce motiv. Modificările nu sunt testate. Dacă sistemul este distribuit, administratorul poate uita să facă modificarea corespunzătoare pe celelalte noduri.
(De asemenea, trebuie menționat că utilizarea unei configurații compilate nu exclude posibilitatea utilizării fișierelor text în viitor. Va fi suficient să adăugăm un parser și un validator care să ofere același tip. Configurație, și putem folosi fișiere text. De aici rezultă că complexitatea sistemului cu o configurație compilată este oarecum mai mică decât complexitatea unui sistem care folosește fișiere text, deoarece pentru fișierele text este necesar un cod suplimentar.)
Un depozit centralizat de cheie-valoare este un mecanism bun pentru distribuirea meta-parametrilor unei aplicații distribuite. Trebuie să stabilim ce sunt parametrii de configurare și ce sunt doar date. Să presupunem că avem o funcție C => A => B, unde parametrii C se schimbă rar, iar datele A — frecvent. În acest caz, putem spune că C — parametrii de configurare, iar A — datele. Pare că parametrii de configurare diferă de date prin faptul că în general se schimbă mai rar decât datele. De asemenea, datele vin de obicei dintr-o sursă (de la utilizator), iar parametrii de configurare dintr-o altă sursă (de la administratorul sistemului).
Dacă parametrii care se schimbă rar trebuie actualizați fără a reporni programul, atunci acest lucru poate duce adesea la complicarea programului, deoarece va fi necesar să găsim o modalitate de a furniza parametrii, de a-i stoca, analiza și verifica, de a procesa valori incorecte. Prin urmare, din perspectiva reducerii complexității programului, are sens să reducerea numărului de parametri care pot fi modificați în timpul funcționării programului (sau să nu mai susțină deloc astfel de parametri).
Din perspectiva acestui post, vom distinge între parametrii statici și dinamici. Dacă logica de funcționare a serviciului necesită modificarea parametrilor în timpul execuției programului, atunci numim acești parametri dinamici. În caz contrar, parametrii sunt statici și pot fi configurați utilizând o configurație compilabilă. Pentru reconfigurarea dinamică, s-ar putea să avem nevoie de un mecanism de repornire a unor părți ale programului cu noii parametrii, similar cu repornirea proceselor unui sistem de operare. (În opinia noastră, este de dorit să se evite reconfigurarea în timp real, deoarece crește complexitatea sistemului. Dacă este posibil, este mai bine să utilizăm funcționalitățile standard ale sistemului de operare pentru a reporni procesele.)
Unul dintre aspectele importante ale utilizării configurației statice, care îi determină pe oameni să ia în considerare reconfigurarea dinamică, este timpul necesar sistemului pentru a reîncărca după actualizarea configurației (downtime). Într-adevăr, dacă trebuie să facem modificări în configurația statică, va trebui să repornim sistemul pentru ca noile valori să intre în vigoare. Problema downtime-ului are o gravitate diferită pentru diferite sisteme. În unele cazuri, este posibil să planificăm repornirea într-un moment în care încărcătura este minimă. În cazul în care se cere asigurarea unui serviciu continuu, se poate implementa . În acest caz, atunci când trebuie să repornim sistemul, lansăm o instanță paralelă a acestui sistem, comutăm balansorul pe aceasta și așteptăm să se finalizeze conexiunile vechi. După ce toate conexiunile vechi s-au încheiat, opriți instanța veche a sistemului.
Să analizăm acum problema stocării configurației în interiorul artefactului sau în afara acestuia. Dacă stocăm configurația în interiorul artefactului, atunci, măcar, am avut ocazia, în timpul construirii artefactului, să ne asigurăm că configurația este corectă. În cazul în care configurația se află în afara artefactului controlat, este greu de urmărit cine și de ce a făcut modificări în acest fișier. Cât de important este acest lucru? După părerea noastră, pentru multe sisteme de producție este esențial să existe o configurație stabilă și de înaltă calitate.
Versiunea artefactului permite determinarea momentului în care a fost creat, ce valori conține, ce funcții sunt activate/dezactivate, cine este responsabil pentru orice modificare a configurației. Desigur, păstrarea configurației în interiorul artefactului necesită eforturi, așa că trebuie luată o decizie conștientă.
Pro și contra
Aș dori să mă opresc asupra avantajelor și dezavantajelor tehnologiei propuse.
Avantajele
Mai jos este lista principalelor capacități ale configurației compilate a sistemului distribuit:
- Verificare statică a configurației. Permite să fiți siguri că
configurația este corectă. - Un limbaj de configurație bogat. De obicei, alte metode de configurare sunt limitate la substituirea variabilelor de tip șir. Utilizând Scala, devin disponibile o gamă largă de capabilități ale limbajului pentru a îmbunătăți configurația. De exemplu, putem folosi
traituri pentru valori implicite, putem grupa parametrii cu ajutorul obiectelor, putem face referire la val-uri, declarate o singură dată (DRY) în domeniul de vizibilitate cuprinzător. Se pot instanția direct în configurație orice clase (Seq,Map, clase personalizate). - DSL. În Scala există o serie de capabilități lingvistice care facilitează crearea de DSL. Aceste capabilități pot fi folosite pentru a implementa un limbaj de configurație care să fie mai convenabil pentru grupul țintă de utilizatori, astfel încât configurația să fie cel puțin lizibilă pentru experții din domeniu. Experții pot, de exemplu, să participe la procesul de revizuire a configurației.
- Integritate și sincronizare între noduri. Unul dintre avantajele stocării configurației întregului sistem distribuit într-un singur punct este că toate valorile sunt declarate exact o dată și apoi reutilizate oriunde sunt necesare. Utilizarea tipurilor fantomă pentru a declara porturile permite garantarea faptului că în toate configurațiile corecte ale sistemului, nodurile utilizează protocoale compatibile. Existența dependențelor clare și obligatorii între noduri garantează că toate serviciile vor fi interconectate.
- Calitate înaltă a modificărilor. Modificările în configurație, prin utilizarea unui proces comun de dezvoltare, fac disponibile standarde înalte de calitate și pentru configurație.
- Actualizarea simultană a configurației. Implementarea automată a sistemului după modificările aduse configurației garantează că toate nodurile vor fi actualizate.
- Simplificarea aplicației. Aplicația nu necesită parsare, verificare a configurației și gestionarea valorilor incorecte. Astfel, complexitatea aplicației este redusă. (Unele complicații ale configurației observate în exemplul nostru nu sunt o trăsătură a configurației compilabile, ci doar o decizie conștientă, generată de dorința de a oferi o tipare mai sigură.) Este destul de ușor să revenim la configurația obișnuită — este suficient să implementăm părțile lipsă. De exemplu, putem începe cu o configurație compilabilă, amânând implementarea părților suplimentare până când acestea sunt cu adevărat necesare.
- Configurație versionată. Deoarece modificările configurației urmează aceeași soartă ca orice alte modificări, la ieșire obținem un artefact cu o versiune unică. Acest lucru ne permite, de exemplu, să revenim la o versiune anterioară a configurației, dacă este necesar. Putem utiliza chiar și configurația de acum un an și sistemul va funcționa exact la fel. O configurație stabilă îmbunătățește previzibilitatea și fiabilitatea sistemului distribuit. Deoarece configurația este fixată în etapa de compilare, este destul de greu de falsificat în producție.
- Modularitate. Cadrele propuse sunt modulare, iar modulele pot fi combinate în diferite variante pentru a obține sisteme diverse. În special, putem configura un sistem pentru a rula pe un singur nod într-o variantă, iar în alta — pe mai multe noduri. Se pot crea mai multe configurații pentru instanțele de producție ale sistemului.
- Testare. Înlocuind servicii individuale cu obiecte mock, putem obține mai multe versiuni ale sistemului, convenabile pentru testare.
- Testarea integrării. Prezența unei configurații unice a întregului sistem distribuit asigură posibilitatea de a rula toate componentele într-un mediu controlat în cadrul testării de integrare. Este ușor de emulator, de exemplu, o situație în care anumite noduri devin inaccesibile.
Dezavantaje și limitări
Configurarea compilabilă diferă de alte abordări de configurare și pentru unele aplicații poate să nu fie potrivită. Iată câteva dezavantaje:
- Configurație statică. Uneori este necesar să modificați rapid configurația în producție, ocolind toate mecanismele de protecție. În cadrul acestei abordări, acest lucru poate fi mai complicat. Cel puțin, compilarea și desfășurarea automată vor fi în continuare necesare. Aceasta este atât o caracteristică utilă a abordării, cât și un dezavantaj în unele cazuri.
- Generarea configurației. În cazul în care fișierul de configurație este generat de un instrument automat, poate fi necesar un efort suplimentar pentru integrarea scriptului de compilare.
- Instrumentar. În prezent, utilitarele și metodele destinate lucrului cu configurația se bazează pe fișiere text. Nu toate aceste utilitare/metode vor fi disponibile în cazul unei configurații compilabile.
- Este necesară o schimbare de mentalitate. Dezvoltatorii și DevOps au fost obișnuiți cu fișierele text. Însăși ideea de a compila configurația poate fi oarecum surprinzătoare și neobișnuită și poate provoca respingere.
- Este necesar un proces de dezvoltare de înaltă calitate. Pentru a folosi confortabil configurația compilabilă, este necesară automatizarea completă a procesului de compilare și desfășurare a aplicației (CI/CD). În caz contrar, va fi suficient de incomod.
Să ne oprim și asupra unor limitări ale exemplului discutat, care nu sunt legate de ideea de configurație compilabilă:
- Dacă furnizăm informații de configurație suplimentare, care nu sunt utilizate de nod, compilatorul nu ne va ajuta să descoperim lipsa implementării. Această problemă poate fi rezolvată prin renunțarea la Cake Pattern și utilizarea unor tipuri mai stricte, de exemplu,
HListsau tipuri de date algebraice (case class-uri) pentru a reprezenta configurația. - În fișierul de configurație există stringuri care nu se referă la configurația propriu-zisă: (
pachet,import, declarații de obiecte;override defPentru parametrii care au valori implicite, este posibil să se evite parțial acest lucru prin implementarea unui DSL propriu. În plus, alte tipuri de configurare (de exemplu, XML) impun, de asemenea, anumite restricții asupra structurii fișierului. - În cadrul acestei postări, nu discutăm despre reconformarea dinamică a unui cluster de noduri similare.
Concluzie
În această postare, am analizat ideea de a reprezenta configurația în codul sursă utilizând capabilitățile avansate ale sistemului de tipuri din Scala. Această abordare poate fi aplicată în diferite aplicații ca înlocuire a metodelor tradiționale de configurare bazate pe fișiere XML sau text. Deși exemplul nostru este implementat în Scala, aceleași idei pot fi transferate în alte limbaje compilate (cum ar fi Kotlin, C#, Swift, ...). Această abordare poate fi testată într-unul dintre următoarele proiecte, iar în cazul în care nu se potrivește, se poate trece la fișierele text, adăugând detaliile lipsă.
Firește, configurația compilabilă necesită un proces de dezvoltare de înaltă calitate. În schimb, se asigură calitate și fiabilitate ridicate ale configurațiilor.
Abordarea discutată poate fi extinsă:
- Se pot utiliza macrocomenzi pentru a efectua verificări la timpul compilării.
- Se poate implementa un DSL pentru a reprezenta configurația într-o formă accesibilă utilizatorilor finali.
- Se poate implementa o gestionare dinamică a resurselor cu ajustarea automată a configurației. De exemplu, atunci când numărul de noduri din cluster se schimbă, este necesar ca (1) fiecare nod să primească o configurație ușor diferită; (2) managerul clusterului să primească informații despre noile noduri.
Mulțumiri
Aș dori să le mulțumesc lui Andrei Saksonov, Pavel Popov și Anton Nehaev pentru critica constructivă a schiței articolului.
Sursa: habr.com
