

Prefață
Destul de des, utilizatorii, dezvoltatorii și administratorii bazei de date MS SQL Server se confruntă cu probleme de performanță a bazei de date sau a SGBD-ului în ansamblu, astfel încât monitorizarea MS SQL Server este foarte relevantă.
Acest articol este o completare la articolul și în acesta vor fi analizate unele aspecte ale monitorizării MS SQL Server, în special: cum să determinăm rapid ce resurse lipsesc, precum și recomandări pentru configurarea flagurilor de urmărire.
Pentru a utiliza scripturile de mai sus, este necesar să creați schema inf în baza de date dorită astfel:
Crearea schemei inf
use ;
go
create schema inf;
Metoda de identificare a lipsei de memorie RAM
Primul indicator al lipsei de memorie RAM este cazul în care instanța MS SQL Server consumă întreaga memorie RAM alocată.
Pentru aceasta, vom crea următoarea vedere inf.vRAM:
Crearea vederii inf.vRAM
CREA vizualizarea [inf].[vRAM] ca
select a.[TotalAvailOSRam_Mb]						--cât de mult RAM disponibil pe server în MB
		 , a.[RAM_Avail_Percent]					--procentul de RAM liber pe server
		 , a.[Server_physical_memory_Mb]				--cât de mult RAM total pe server în MB
		 , a.[SQL_server_committed_target_Mb]			--cât de mult RAM este alocat pentru MS SQL Server în MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--cât de mult RAM folosește MS SQL Server în prezent în MB
		 , a.[SQL_RAM_Avail_Percent]				--procent de RAM liber pentru MS SQL Server în raport cu tot RAM-ul alocat pentru MS SQL Server
		 , a.[StateMemorySQL]						--este RAM-ul suficient pentru MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				--procentul de RAM rezervat pentru MS SQL Server în raport cu tot RAM-ul serverului
		 --este RAM-ul suficient pentru server
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Avertisment' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Pericol' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Avertisment' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Atunci, pentru a determina că instanța MS SQL Server consumă toată memoria alocată, se poate folosi următoarea interogare:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Dacă indicatorul SQL_server_physical_memory_in_use_Mb nu este constant mai mic decât SQL_server_committed_target_Mb, este necesar să se verifice statisticile de așteptare.
Pentru a determina lipsa memoriei RAM prin statisticile de așteptare, să creăm vizualizarea inf.vWaits:
Crearea vizualizării inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --numele tipului de așteptare
        [wait_time_ms] / 1000.0 AS [WaitS],--Timpul total de așteptare pentru acest tip în milisecunde. Acest timp include signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Timpul total de așteptare pentru acest tip în milisecunde fără signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Diferența între timpul de semnalizare al firului ce așteaptă și timpul de început al execuției
        [waiting_tasks_count] AS [WaitCount],--Numărul așteptărilor pentru acest tip. Acest contor se crește de fiecare dată când începe o așteptare
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Timpul total de așteptare pentru acest tip în milisecunde. Acest timp include signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Timpul total de așteptare pentru acest tip în milisecunde fără signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Diferența între timpul de semnalizare al firului ce așteaptă și timpul de început al execuției
	    [W1].[WaitCount] AS [WaitCount],--Numărul așteptărilor pentru acest tip. Acest contor se crește de fiecare dată când începe o așteptare
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- prag procentual
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
În acest caz, insuficiența memoriei RAM poate fi determinată prin următoarea interogare:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Aici trebuie să ne concentrăm asupra indicatorilor Percentage și AvgWait_S. Dacă acestea sunt semnificativa în total, există o probabilitate mare că instanței MS SQL Server îi lipsește memorie RAM. Valorile semnificative sunt definite individual pentru fiecare sistem. Totuși, putem începe cu următorul indicator: Percentage>=1 și AvgWait_S>=0.005.
Pentru a obține indicatorii în sistemul de monitorizare (de exemplu, Zabbix), putem crea următoarele două interogări:
- cât la sută ocupă tipurile de așteptare pe RAM (suma pentru toate aceste tipuri de așteptare):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - cât în milisecunde durează tipurile de așteptare pe RAM (valoarea maximă dintre toate întârzierile medii pentru toate aceste tipuri de așteptare):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Pe baza dinamicii valorilor obținute pentru acești doi indicatori, putem concluziona dacă memoria RAM este suficientă pentru instanța MS SQL Server.
Metoda de identificare a încărcării excesive pe CPU
Pentru a identifica lipsa timpului de procesor, este suficient să utilizăm reprezentarea sistemului sys.dm_os_schedulers. Aici, dacă indicatorul runnable_tasks_count este constant mai mare decât 1, există o mare probabilitate că numărul de nuclee nu este suficient pentru instanța MS SQL Server.
Pentru a obține indicatorul în sistemul de monitorizare (de exemplu, Zabbix), putem crea următoarea interogare:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
Pe baza dinamicii valorilor obținute pentru acest indicator, putem concluziona dacă timpul de procesor (numărul de nuclee CPU) este suficient pentru instanța MS SQL Server.
Cu toate acestea, este important să reținem că cererile pot solicita simultan mai multe thread-uri. Uneori, optimizatorul nu poate evalua corect complexitatea cererii în sine. Astfel, pot fi alocate prea multe thread-uri unei cereri, care în acel moment nu pot fi procesate simultan. Aceasta provoacă, de asemenea, un tip de așteptare legat de lipsa timpului procesorului și de creșterea cozii pentru planificatori, care utilizează nuclee specifice ale CPU-ului, adică indicatorul runnable_tasks_count în aceste condiții va crește.
În acest caz, înainte de a crește numărul de nuclee CPU, este necesar să se configureze corect proprietățile de paralelism ale instanței MS SQL Server și, începând din versiunea 2016, să se configureze corect proprietățile de paralelism pentru bazele de date necesare:
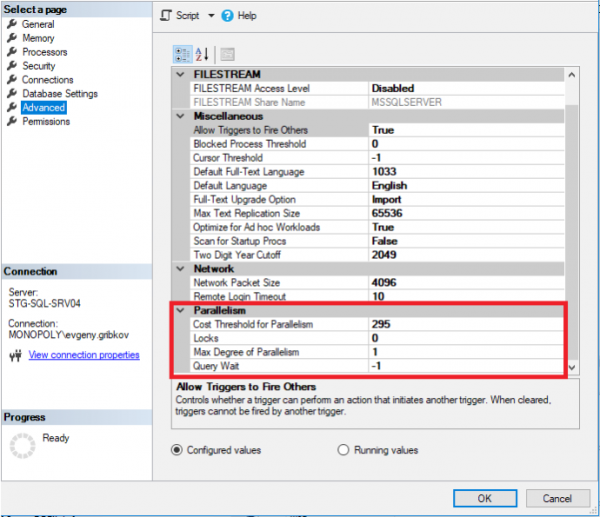
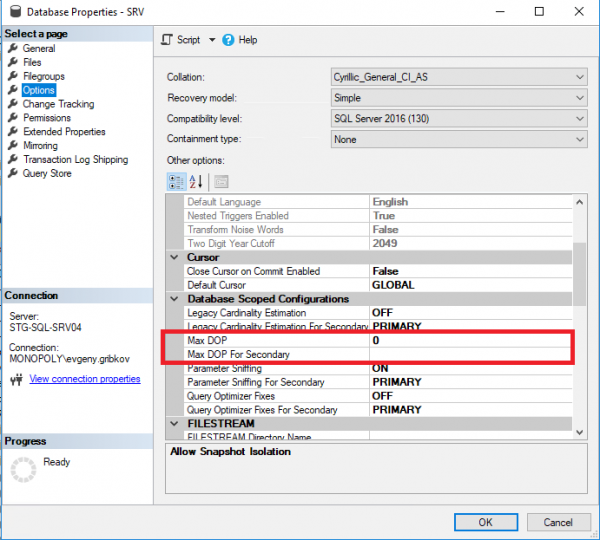
Aici este important să acordăm atenție următoarelor parametri:
- Max Degree of Parallelism - stabilește numărul maxim de thread-uri care pot fi alocate fiecărei cereri (implicit este setat la 0 - restricționat doar de sistemul de operare și edite MS SQL Server)
- Cost Threshold for Parallelism - costul estimat al paralelismului (implicit este setat la 5)
- Max DOP - stabilește numărul maxim de thread-uri care pot fi alocate fiecărei cereri la nivel de bază de date (dar nu mai mult decât valoarea proprietății „Max Degree of Parallelism”) (implicit este setat la 0 - restricționat doar de sistemul de operare și edite MS SQL Server, precum și restricționat de proprietatea „Max Degree of Parallelism” a întregii instanțe MS SQL Server)
Aici nu se poate oferi o rețetă universală bună pentru toate cazurile, adică trebuie analizate cererile complexe.
Din experiența proprie, recomand următorul algoritm de acțiune pentru sistemele OLTP pentru configurarea proprietăților de paralelism:
- în primul rând, interziceți paralelismul, setând pentru întreaga instanță Max Degree of Parallelism la 1
- analizați cele mai complexe cereri și alegeți numărul optim de thread-uri pentru acestea
- setați Max Degree of Parallelism la numărul optim de thread-uri stabilit în punctul 2, precum și pentru fiecare bază de date, setați valoarea Max DOP obținută din punctul 2
- analizați cele mai complexe cereri și identificați efectele negative ale multi-threading-ului. Dacă există, atunci creșteți Cost Threshold for Parallelism.
Pentru sisteme precum 1C, Microsoft CRM și Microsoft NAV, în cele mai multe cazuri, interzicerea multi-threading-ului va fi suficientă.
De asemenea, dacă este instalată ediția Standard, de cele mai multe ori va fi suficientă interzicerea procesării multi-fir, având în vedere că această ediție are o limitare privind numărul de nuclee CPU.
Pentru sistemele OLAP, algoritmul descris mai sus nu este adecvat.
Din experiența personală, recomand următorul algoritm de acțiune pentru sistemele OLAP pentru configurarea proprietăților de concurență:
- analizați cele mai complexe cereri și alegeți numărul optim de thread-uri pentru acestea
- setați Max Degree of Parallelism la un număr optim de fire, obținut din punctul 1, precum și pentru baze de date specifice setați valoarea Max DOP, obținută din punctul 1, pentru fiecare bază de date
- analizați cele mai costisitoare interogări și identificați efectul negativ al limitării concurenței. Dacă acesta există, fie reduceți valoarea Cost Threshold for Parallelism, fie repetați pașii 1-2 ai acestui algoritm
Așadar, pentru sistemele OLTP, trecem de la procesarea unifir la procesarea multifir, iar pentru sistemele OLAP, invers, trecem de la procesarea multifir la procesarea unifir. Astfel, se pot adapta setările optime ale concurenței atât pentru o anumită bază de date, cât și pentru întregul exemplu MS SQL Server.
Este, de asemenea, important să înțelegem că setările proprietăților de concurență trebuie schimbate în timp, în funcție de rezultatele monitorizării performanței MS SQL Server.
Recomandări pentru configurarea flagurilor de urmărire
Din experiența mea și a colegilor mei, pentru o funcționare optimă, recomand să setați următoarele flaguri de urmărire la nivel de lansare a serviciului MS SQL Server pentru versiunile 2008-2016:
- 610 — Reducerea jurnalizării inserțiilor în tabele indexate. Poate ajuta la inserțiile în tabele cu un număr mare de înregistrări și multe tranzacții, în condiții de așteptări lungi frecvente ale WRITELOG din cauza modificărilor din indici.
- 1117 — Dacă un fișier din grupul de fișiere îndeplinește cerințele pragului de creștere automată, toate fișierele din grupul de fișiere se măresc.
- 1118 — Forțează toate obiectele să fie amplasate în extentii diferite (interzicerea extensiilor mixte), ceea ce minimizează necesitatea de a scana pagina SGAM, care este folosită pentru a urmări extentiile mixte.
- 1224 — Dezactivează aglomerarea blocajelor pe baza numărului de blocaje. Cu toate acestea, utilizarea prea activă a memoriei poate activa aglomerarea blocajelor.
- 2371 — Schimbă pragul actualizării automate fixe a statisticilor în pragul actualizării automate dinamice a statisticilor. Este important pentru actualizarea planurilor de interogări legate de tabele mari, unde determinarea incorectă a numărului de înregistrări duce la planuri de execuție greșite.
- 3226 — Suprimă mesajele despre executarea cu succes a copiei de rezervă în jurnalul erorilor.
- 4199 — Activează modificările în optimizerul de interogări, emise în pachetele de actualizare cumulative și în pachetele de actualizare SQL Server.
- 6532-6534 — Activează îmbunătățirea performanței operațiunilor de interogare cu tipuri de date spațiale.
- 8048 — Transformă obiectele de memorie, partitionate pe NUMA, în partitionate pe CPU.
- 8780 — Activează alocarea suplimentară de timp pentru compilarea planului de interogare. Unele interogări fără acest flag pot fi respinse, deoarece nu au un plan de interogare (eroare foarte rară).
- 8780 — 9389 — Activează un buffer de memorie temporar suplimentar dinamic pentru operatorii de modul batch, permițând operatorului de modul batch să solicite memorie suplimentară și să evite transferul de date în tempdb, dacă este disponibilă memorie suplimentară.
De asemenea, până în versiunea 2016 este util să activezi flagul de înregistrare 2301, care include optimizarea extinsă a suportului pentru decizii, ajutând astfel la alegerea unor planuri de interogare mai corecte. Totuși, începând cu versiunea 2016, acesta are adesea un efect negativ asupra timpului total de execuție a interogărilor.
De asemenea, pentru sistemele cu foarte multe indecși (de exemplu, pentru bazele de date 1C), recomand activarea flagului de înregistrare 2330, care dezactivează colectarea utilizării indecșilor, ceea ce are un impact pozitiv asupra sistemului.
Mai multe detalii despre flagurile de înregistrare pot fi găsite.
La linkul de mai sus, este important să se țină cont de versiunile și compilările MS SQL Server, deoarece pentru versiunile mai noi unele flaguri de înregistrare sunt activate implicit sau nu au niciun efect.
Activarea și dezactivarea flagului de înregistrare se poate face folosind comenzile DBCC TRACEON și DBCC TRACEOFF, respectiv. Mai multe detalii puteți vedea.
Starea flagurilor de înregistrare poate fi obținută folosind comanda DBCC TRACESTATUS:
Pentru a activa steagurile de urmărire în pornirea automată a serviciului MS SQL Server, trebuie să accesați SQL Server Configuration Manager și să adăugați datele steagurilor de urmărire prin -T în proprietățile serviciului.
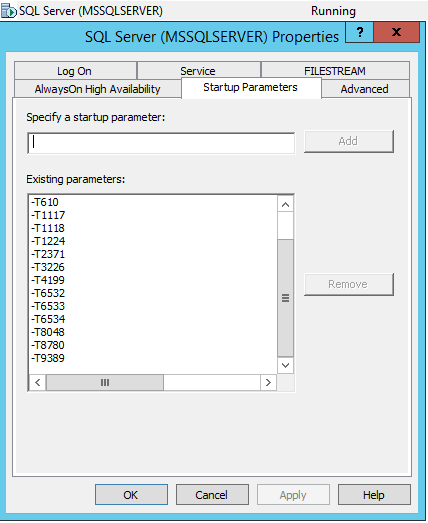
Concluzii
În acest articol, au fost discutate unele aspecte ale monitorizării MS SQL Server, care pot ajuta la identificarea rapidă a lipsei de RAM și a timpului liber al CPU-ului, precum și a altor probleme mai puțin evidente. Au fost analizate cele mai frecvent utilizate steaguri de urmărire.
Surse:
»
»
»
»
»
»
»
Sursa: habr.com
