

Salut, sunt Serghei Elanțev, dezvoltator în Yandex.Cloud. Anterior, am condus dezvoltarea echilibratorului L7 pentru portalul Yandex – colegii glumesc că, indiferent de ceea ce fac, iese un echilibrator. Voi povesti cititorilor de pe Habr cum trebuie gestionată încărcarea în platforma de cloud, cum vedem noi instrumentul ideal pentru a atinge acest obiectiv și cum ne îndreptăm spre construirea acestui instrument.
Pentru început, să introducem câteva termeni:
- VIP (Virtual IP) – adresa IP a echilibratorului
- Server, backend, instanță – mașină virtuală cu aplicația rulată
- RIP (Real IP) – adresa IP a serverului
- Healthcheck – verificarea stării de funcționare a serverului
- Zonă de disponibilitate, Availability Zone, AZ – infrastructură izolată în data center
- Regiune – o combinație de diferite AZ
Echilibratoarele de încărcare îndeplinesc trei sarcini principale: fac efectiv echilibrarea, îmbunătățesc redundanța serviciului și simplifică scalarea acestuia. Redundanța este asigurată prin gestionarea automată a traficului: echilibratorul monitorizează starea aplicației și exclude din echilibrare instanțele care nu au trecut verificarea de sănătate. Scalarea este realizată prin distribuirea uniformă a încărcăturii între instanțe, de asemenea, prin actualizarea listei de instanțe în timp real. Dacă echilibrarea nu este suficient de uniformă, unele dintre instanțe vor primi o încărcătură care depășește limita lor de operabilitate, iar serviciul va deveni mai puțin fiabil.
Echilibratoarele de încărcare sunt adesea clasificate în funcție de nivelul protocolului din modelul OSI pe care funcționează. Echilibratorul Cloud funcționează la nivelul TCP, care corespunde celui de-al patrulea nivel, L4.
Să trecem la prezentarea arhitecturii echilibratorului Cloud. Vom crește treptat nivelul de detaliu. Împărțim componentele echilibratorului în trei clase. Clasa config plane se ocupă de interacțiunea cu utilizatorul și păstrează starea dorită a sistemului. Control plane păstrează starea actuală a sistemului și gestionează sistemele din clasa data plane, care sunt responsabile direct pentru livrarea traficului de la clienți la instanțele dumneavoastră.
Data plane
Traficul ajunge pe dispozitive costisitoare numite route-uri de frontieră. Pentru a crește rezistența la defecțiuni, mai multe astfel de dispozitive funcționează simultan într-un centru de date. Apoi, traficul ajunge la echilibrarea încărcării, care pentru clienți anunță o adresă IP anycast pe toate AZ prin BGP.
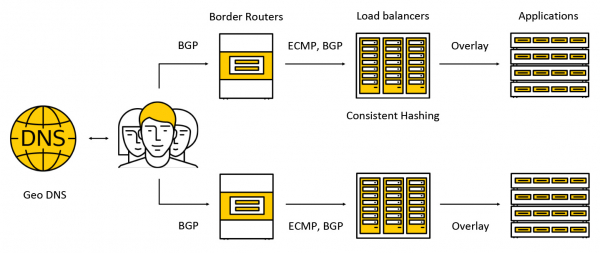
Traficul este transmis prin ECMP — o strategie de rutare, conform căreia pot exista mai multe rute la fel de bune către destinație (în cazul nostru, destinația va fi adresa IP de destinație) și pachetele pot fi trimise pe oricare dintre ele. De asemenea, noi susținem funcționarea în mai multe zone de disponibilitate conform următoarei scheme: anunțăm adresa în fiecare din zone, iar traficul ajunge la cea mai apropiată și nu iese dincolo de ea. Mai departe în post, vom analiza mai în detaliu ce se întâmplă cu traficul.
Planul de configurare
Componenta cheie a planului de configurare este API-ul, prin care se efectuează operațiunile de bază cu echilibratoarele de încărcare: crearea, ștergerea, modificarea compunerii instanțelor, obținerea rezultatelor healthchecks etc. Pe de o parte, este un API REST, iar pe de altă parte, noi în Cloud folosim foarte frecvent cadrul gRPC, așa că «traducem» REST în gRPC și apoi folosim doar gRPC. Orice solicitare conduce la crearea unei serii de sarcini idempotente asincrone, care sunt executate pe un pool comun de lucrători Yandex.Cloud. Sarcinile sunt scrise astfel încât pot fi suspendate în orice moment și apoi reluate. Acest lucru asigură scalabilitatea, repetabilitatea și logarea operațiunilor.
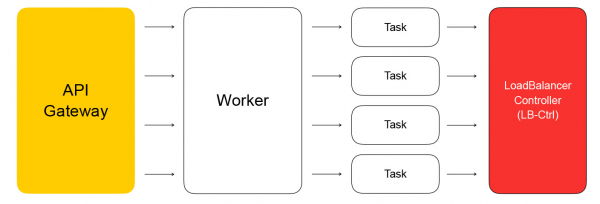
În cele din urmă, sarcina din API va face o solicitare către serviciul de control al echilibratoarelor de încărcare, care este scris în Go. Acesta poate adăuga și șterge echilibratoare, schimba compunerea backend-urilor și setările.
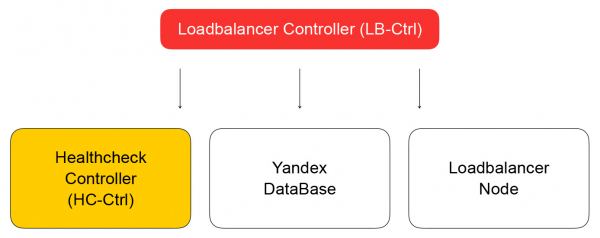
Serviciul își stochează starea în Yandex Database — o bază de date gestionată distribuită, pe care curând o veți putea folosi și dumneavoastră. În Yandex.Cloud, așa cum am mai spus, , funcționează conceptul dog food: dacă utilizăm serviciile noastre, atunci și clienții noștri le vor folosi cu plăcere. Yandex Database este un exemplu de implementare a acestui concept. Stocăm toate datele noastre în YDB și nu trebuie să ne facem griji cu privire la întreținerea și scalarea bazei: aceste probleme sunt rezolvate pentru noi, utilizăm baza ca serviciu.
Revenim la controlerul de echilibrare a încărcării. Sarcina sa este să păstreze informațiile despre echilibrator, să trimită sarcina de verificare a disponibilității mașinii virtuale către controlerul de healthcheck.
Controler de healthcheck
Acesta primește cereri pentru modificarea regulilor de verificare, le salvează în YDB, distribuie sarcini între nodurile de healthcheck și agregă rezultatele, care sunt apoi păstrate în baza de date și trimise către controlerul de echilibrare a încărcării. Acesta, la rândul său, trimite cereri pentru modificarea compunerii clusterului către data plane în loadbalancer-node, despre care voi vorbi mai jos.
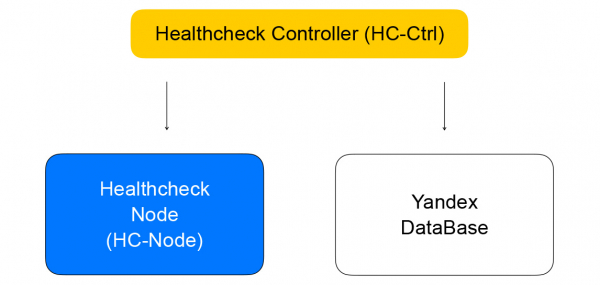
Să discutăm mai în detaliu despre healthchecks. Acestea pot fi împărțite în mai multe categorii. Verificările au diferite criterii de succes. Verificările TCP trebuie să stabilească o conexiune cu succes într-un interval de timp fixat. Verificările HTTP necesită atât o conexiune reușită, cât și primirea unui răspuns cu codul de stare 200.
De asemenea, verificările se deosebesc prin tipul de acțiune — există verificări active și pasive. Verificările pasive doar monitorizează ceea ce se întâmplă cu traficul, fără a face acțiuni speciale. Acest lucru nu funcționează foarte bine la L4, deoarece depinde de logica protocoalelor la niveluri superioare: la L4 nu există informații despre cât timp a durat operațiunea și dacă încheierea conexiunii a fost bună sau rea. Verificările active necesită ca echilibratorul să trimită cereri către fiecare instanță a serverului.
Cea mai mare parte a echilibratorilor de încărcare efectuează verificări de „vitalitate” în mod autonom. Noi, în Cloud, am decis să împărțim aceste părți ale sistemului pentru a îmbunătăți scalabilitatea. Această abordare ne va permite să creștem numărul de echilibratoare, păstrând numărul cererilor de healthcheck către serviciu. Verificările sunt efectuate de noduri separate de healthcheck, unde obiectivele verificărilor sunt fragmentate și replicate. Nu este posibil să se efectueze verificări de pe un singur host, deoarece acesta ar putea eșua. Atunci nu vom obține starea instanțelor verificate de acesta. Efectuăm verificări ale oricărei instanțe de pe cel puțin trei noduri de healthcheck. Obiectivele verificărilor sunt fragmentate între noduri folosind algoritmi de hashing consistent.
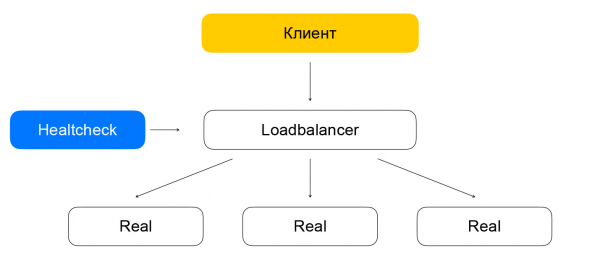
Separarea între balansare și healthcheck poate duce la probleme. Dacă nodul healthcheck face cereri către instanță, ocolind balansorul (care în acel moment nu gestionează traficul), apare o situație ciudată: resursa pare că este activă, dar traficul nu ajunge la ea. Rezolvăm această problemă astfel: garantăm că traficul healthcheck trece prin balansori. Cu alte cuvinte, schema de mutare a pachetelor de trafic de la clienți și de la healthchecks diferă minim: în ambele cazuri, pachetele vor ajunge la balansori care le vor livra resurselor țintă.
Diferența este că clienții fac cereri la VIP, iar healthchecks se adresează fiecărui RIP separat. Aici apare o problemă interesantă: oferim utilizatorilor noștri posibilitatea de a crea resurse în rețele IP gri. Să ne imaginăm că există doi proprietari diferiți de cloud care și-au ascuns serviciile în spatele balansorilor. Fiecare dintre ei are resurse în subnetul 10.0.0.1/24, cu adrese identice. Trebuie să găsim o modalitate de a le distinge, iar aici trebuie să ne adâncim în structura rețelei virtuale a Yandex.Cloud. Detalii mai bine aflați în , ceea ce este important acum este că rețeaua este stratificată și conține tuneluri care pot fi distinse după id-ul subnetului.
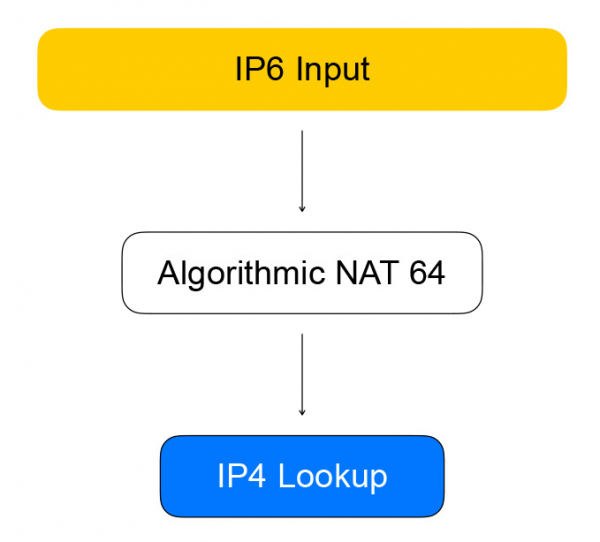
Nodurile healthcheck se adresează balansorilor folosind așa-numite adrese quasi-IPv6. Adresa quasi este o adresă IPv6, în care este încorporată o adresă IPv4 și id-ul subnetului utilizatorului. Traficul ajunge la balansor, care extrage adresa IPv4 a resursei, înlocuiește IPv6 cu IPv4 și trimite pachetul în rețeaua utilizatorului.
Traficul invers se desfășoară de asemenea: balansorul observă că destinația este o rețea gri din partea healthchecker-ilor și transformă IPv4 în IPv6.
VPP — inima planului de date
Balansorul este implementat pe tehnologia Vector Packet Processing (VPP) — un cadru de la Cisco pentru procesarea pachetelor de trafic de rețea. În cazul nostru, cadrul funcționează deasupra bibliotecii de gestionare a dispozitivelor de rețea în spațiul utilizatorului — Data Plane Development Kit (DPDK). Acest lucru asigură o performanță ridicată în procesarea pachetelor: în kernel se desfășoară mult mai puține întreruperi, nu există comutări de context între kernel space și user space.
VPP mergează și mai departe, extragând și mai multă performanță din sistem prin combinarea pachetelor în batch-uri. Creșterea performanței se datorează utilizării agresive a cache-urilor procesorului modern. Se folosesc atât cache-uri de date (pachetele sunt procesate „în vectori”, datele fiind aproape una de cealaltă), cât și cache-uri de instrucțiuni: în VPP, procesarea pachetelor urmează un grafic, în nodurile căruia se află funcții care îndeplinesc o singură sarcină.
De exemplu, procesarea pachetelor IP în VPP are loc în următoarea ordine: mai întâi, în nodul de analiză, se face parsing-ul antetelor pachetelor, după care acestea sunt trimise într-un nod care redirecționează pachetele mai departe conform tabelelor de rutare.
Puțin hardcore. Autorii VPP nu fac compromisuri în utilizarea cache-urilor procesorului, astfel că codul tipic de procesare a vectorilor de pachete conține vectorizare manuală: există un ciclu de procesare, în care se rulează situația „avem patru pachete în coadă”, apoi același lucru pentru două, apoi pentru unul. Se folosesc adesea instrucțiuni de prefetch, care încarcă date în cache-uri pentru a accelera accesul la acestea în iterațiile următoare.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // procesarea mai multor pachete simultan
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prefetch pentru următoarea iterație. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // de fapt, procesare a datelor
        /* verifică enqueue-urile speculative, poate schimbă cadrul curent următor */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // procesarea pachetelor câte unul
    }

    // batch procesat
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Astfel, Healthchecks accesează VPP prin IPv6, care le transformă în IPv4. Acest lucru este realizat de un nod din grafic pe care îl numim NAT algoritmic. Pentru traficul de întoarcere (și conversia din IPv6 în IPv4) există aceleași noduri de NAT algoritmic.
Traficul direct de la clienții echilibratorului trece prin nodurile graficului care efectuează efectiv echilibrarea.
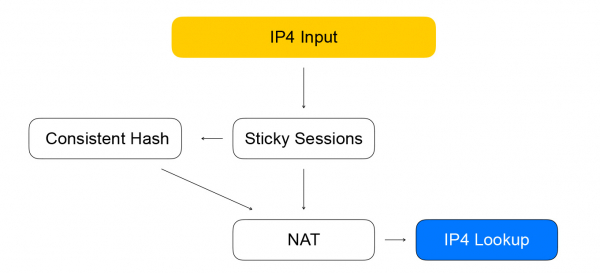
Primul nod - sesiuni sticky. Aici se păstrează un hash de pentru sesiunile stabilite. 5-tuple include adresa și portul clientului de la care se transmite informația, adresa și porturile resurselor disponibile pentru primirea traficului, precum și protocolul de rețea.
Hash-ul de 5-tuple ne ajută să realizăm mai puține calcule în nodul următor de hashing consistent, precum și să gestionăm mai bine modificările listei resurselor din spatele echilibrorului de sarcină. Atunci când un pachet ajunge la echilibrorul de sarcină, pentru care nu există sesiune, acesta este trimis la nodul de hashing consistent. Aici are loc echilibrarea prin hashing consistent: alegem o resursă din lista resurselor 'active' disponibile. Apoi, pachetele sunt trimise la nodul NAT, care efectuează înlocuirea efectivă a adresei de destinație și recalcularea checksum-urilor. Așa cum puteți observa, urmăm regulile VPP — similar cu similar, grupăm calcule asemănătoare pentru a crește eficiența cache-urilor procesorului.
Hashing consistent
De ce am ales exact acesta și ce este de fapt? Pentru început, să luăm în considerare problema anterioară — alegerea resursei din listă.
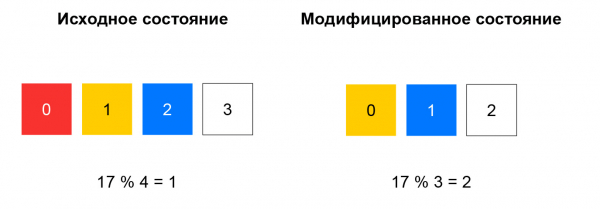
În cazul hashing-ului inconsistent, se calculează hash-ul pachetului de intrare, iar resursa este aleasă din listă pe baza restului împărțirii acestui hash la numărul de resurse. Atâta timp cât lista rămâne neschimbată, acest sistem funcționează bine: trimitem întotdeauna pachetele cu același 5-tuple către aceeași instanță. Dacă, de exemplu, o resursă a încetat să mai răspundă la health checks, atunci pentru o parte semnificativă din hashes alegerea se va schimba. Clientul va pierde conexiunile TCP: un pachet, care anterior ajungea la instanța A, poate începe să ajungă la instanța B, care nu este familiarizată cu sesiunea pentru acest pachet.
Hashing-ul consistent rezolvă problema descrisă. Cel mai simplu se poate explica această conceptie astfel: imaginați-vă că aveți un inel pe care distribuiți resursele pe baza hash-ului (de exemplu, pe IP:port). Alegerea resursei este ca și cum ați roti roata într-un unghi determinat de hash-ul pachetului.
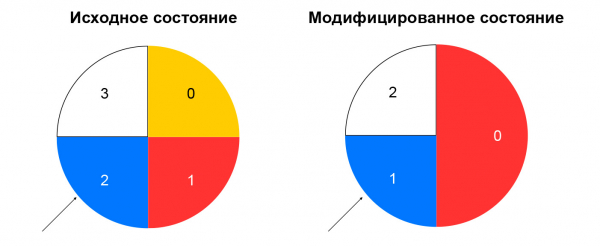
Astfel, se minimizează redistribuirea traficului atunci când se schimbă compunerea resurselor. Eliminarea unei resurse va afecta doar partea din inelul hashing-ului consistent pe care se afla această resursă. Adăugarea unei resurse schimbă, de asemenea, distribuția, dar avem un nod de sesiuni persistente, care permite menținerea sesiunilor deja stabilite pe resursele noi.
Am discutat despre ce se întâmplă cu traficul direct între balansor și resurse. Acum să ne ocupăm de traficul invers. Acesta urmează aceeași schemă ca și traficul verificărilor — prin NAT algoritmic, adică prin NAT invers 44 pentru traficul clienților și prin NAT 46 pentru traficul de verificare a stării. Ne ținem de schema proprie: unificăm traficul de verificare a stării și traficul real al utilizatorilor.
Loadbalancer-node și componente în ansamblu
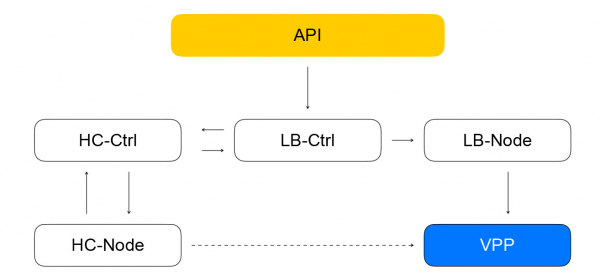
Despre compoziția balansorilor și a resurselor din VPP informează serviciul local — loadbalancer-node. Acesta se abonează la fluxul de evenimente de la loadbalancer-controller, poate construi diferența între starea curentă a VPP și starea țintă, obținută de la controller. Obținem un sistem închis: evenimentele din API ajung la controller-ul balansorului, care dă sarcini controller-ului de verificare a stării pentru a verifica "vitalitatea" resurselor. Acesta, la rândul său, dă sarcini în healthcheck-node și agregă rezultatele, după care le trimite înapoi controller-ului balansorilor. Loadbalancer-node se abonează la evenimentele de la controller și schimbă starea VPP. Într-un astfel de sistem, fiecare serviciu cunoaște doar ceea ce este necesar despre serviciile învecinate. Numărul de legături este limitat, iar noi avem posibilitatea de a exploata și scala independent diverse segmente.
Ce întrebări am reușit să evităm
Toate serviciile noastre în control plane sunt scrise în Go și au caracteristici bune de scalabilitate și fiabilitate. În Go există multe biblioteci open-source pentru construirea sistemelor distribuite. Folosim activ GRPC, toate componentele conțin o implementare open-source a descoperirii serviciilor — serviciile noastre monitorizează starea de funcționare a celorlalte, pot schimba compoziția lor dinamic și am împletit acest lucru cu balansarea GRPC. De asemenea, pentru metrici folosim o soluție open-source. În data plane am obținut o performanță decentă și un rezerva mare de resurse: a fost foarte dificil să construim un stand care să ne limiteze în performanța VPP, nu în placa de rețea hardware.
Probleme și soluții
Ce nu a funcționat foarte bine? În Go, gestionarea memoriei este automată, dar scurgerile de memorie tot pot apărea. Cea mai simplă modalitate de a le gestiona este să rulați goroutines și să nu uitați să le încheiați. Concluzie: urmăriți consumul de memorie al programelor Go. Adesea, un bun indicator este numărul de goroutines. În această poveste, există și un avantaj: în Go, este ușor să obții date despre runtime - despre consumul de memorie, despre numărul de goroutines lansate și despre multe alte parametrii.
În plus, Go poate că nu este cea mai bună alegere pentru testele funcționale. Acestea sunt destul de verbose, iar abordarea standard 'rulați totul în CI ca un pachet' nu se potrivește foarte bine. Motivul este că testele funcționale sunt mai exigente în ceea ce privește resursele și pot apărea timeout-uri reale. Din această cauză, testele pot eșua, deoarece CPU-ul este ocupat cu testele unitate. Concluzie: executați, pe cât posibil, testele 'grele' separat de testele unitate.
Arhitectura microserviciilor bazate pe evenimente este mai complicată decât monolitul: a căuta în jurnalele de pe zeci de mașini diferite nu este foarte convenabil. Concluzie: dacă faceți microservicii, gândiți-vă din timp la trasarea acestora.
Planurile noastre
Vom lansa un balansor intern, un balansor IPv6, vom adăuga suport pentru scenarii Kubernetes, vom continua să sharduim serviciile noastre (în prezent, doar healthcheck-node și healthcheck-ctrl sunt sharduite), vom adăuga noi healthchecks, precum și vom implementa o agregare inteligentă a verificărilor. Considerăm posibilitatea de a face serviciile noastre și mai independente - astfel încât acestea să comunice nu direct între ele, ci prin intermediul unei cozi de mesaje. În Cloud a apărut recent un serviciu compatibil SQS. .
Recent a avut loc lansarea publică a Yandex Load Balancer. Explorați serviciul, gestionați balansorii în modul dorit și creșteți reziliența proiectelor dumneavoastră!
Sursa: habr.com
