

Dacă folosești o bază de date pentru serii temporale (timeseries db, ) ca principal depozit pentru un site de statistici, poți obține multă durere de cap în locul unei soluții eficiente. Lucrez la un proiect care utilizează o astfel de bază, iar uneori InfluxDB, despre care va fi vorba, a oferit surprize neașteptate.
Declinarea: problemele menționate se referă la versiunea InfluxDB 1.7.4.
De ce serii temporale?
Proiectul constă în urmărirea tranzacțiilor în diferite blockchain-uri și afișarea statisticilor. Concret, ne uităm la emiterea și arderea stablecoin-urilor (). Pe baza acestor tranzacții trebuie să construim grafice și să prezentăm tabele sumare.
În analiza tranzacțiilor a venit ideea: să folosim baza de date pentru serii temporale InfluxDB ca principal depozit. Tranzacțiile sunt puncte în timp și se integrează bine în modelul unei serii temporale.
Funcțiile de agregare păreau, de asemenea, foarte convenabile - pentru procesarea graficelor pe o perioadă lungă sunt ideale. Utilizatorul are nevoie de un grafic pe un an, iar baza conține un set de date cu un interval de cinci minute. Să-i trimitem toate cele o sută de mii de puncte nu are sens - pe lângă procesarea îndelungată, ele nici nu vor încăpea pe ecran. Se poate scrie o implementare personalizată pentru mărirea intervalului, sau se pot folosi funcțiile de agregare încorporate în Influx. Cu ajutorul lor, se pot grupa datele pe zile și trimite cele 365 de puncte necesare.
M-a deranjat puțin că, de obicei, astfel de baze sunt folosite pentru colectarea metricilor. Monitorizarea serverelor, dispozitive IoT, tot ce generează milioane de puncte de tipul: [<timp> - <valoarea metricii>]. Dar dacă baza funcționează bine cu un flux mare de date, de ce un volum mic ar trebui să cauzeze probleme? Cu această idee, am decis să lucrăm cu InfluxDB.
Ce este convenabil în InfluxDB
Pe lângă funcțiile de agregare menționate, există încă o caracteristică minunată - interogări continue (). Aceasta este un programator încorporat în baza de date, care poate procesa datele conform unui program. De exemplu, se pot grupa toate înregistrările pe parcursul unei zile la fiecare 24 de ore, se poate calcula media și se poate înregistra un nou punct într-o altă tabelă fără a scrie biciclete personale.
De asemenea, este politici de păstrare () — configurarea ștergerii datelor după o anumită perioadă. Este util când, de exemplu, este necesar să păstrezi încărcarea CPU-ului pe o săptămână cu măsurători la fiecare secundă, însă pe o distanță de câteva luni o astfel de precizie nu este necesară. În această situație, se poate proceda astfel:
- creați o interogare continuă pentru agregarea datelor într-un alt tabel;
- pentru primul tabel, definiți o politică de ștergere a metricilor mai vechi de o săptămână.
Și Influx va reduce automat dimensiunea datelor și va șterge cele inutile.
Despre datele stocate
Nu sunt multe date stocate: aproximativ 70 de mii de tranzacții și încă un milion de puncte cu informații de piață. Adăugarea de noi înregistrări — nu mai mult de 3000 de puncte pe zi. De asemenea, sunt metrici pentru site, dar acolo datele sunt puține și, conform politicii de stocare, sunt păstrate nu mai mult de o lună.
Probleme
În timpul dezvoltării și testării ulterioare a serviciului, au apărut tot mai multe probleme critice în exploatarea InfluxDB.
1. Ștergerea datelor
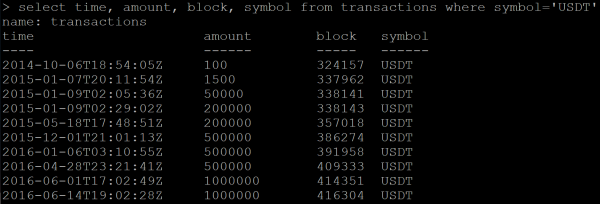
Există o serie de date cu tranzacții:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Rezultatul:
Trimit comanda de ștergere a datelor:
DELETE FROM transactions WHERE symbol='USDT'Apoi fac o interogare pentru a obține datele deja șterse. Și Influx, în loc de un răspuns gol, returnează o parte din datele care ar trebui să fie șterse.
Încerc să șterg tabelul complet:
DROP MEASUREMENT transactionsVerific ștergerea tabelului:
SHOW MEASUREMENTSNu observ tabelul în listă, dar noua interogare de date încă returnează același set de tranzacții.
Problema a apărut o singură dată, deoarece cazul de ștergere este un caz izolat. Dar acest comportament al bazei de date nu se încadrează clar în limitele unei funcționări „corecte”. Mai târziu am găsit pe github o problemă deschisă de aproape un an pe această temă.
În rezultat, a ajutat ștergerea și restabilirea întregii baze.
2. Numere cu virgulă flotantă
Calculul matematic utilizând funcțiile încorporate în InfluxDB dă erori de precizie. Nu că ar fi ceva neobișnuit, dar este deranjant.
În cazul meu, datele au o componentă financiară și aș dori să le procesăm cu o mare precizie. Din această cauză, în planuri este renunțarea la interogările continue.
3. Interogările continue nu pot fi adaptate la diferite fusuri orare
Serviciul include o tabelă cu statisticile zilnice ale tranzacțiilor. Pentru fiecare zi, trebuie să grupăm toate tranzacțiile efectuate în acea zi. Totuși, ziua pentru fiecare utilizator va începe la momente diferite, astfel că setul de tranzacții va varia. Conform UTC, există de decalaj, pentru care trebuie să agregăm datele.
În InfluxDB, atunci când grupăm pe baza timpului, putem specifica suplimentar un decalaj, de exemplu, pentru ora Moscovei (UTC+3):
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Însă rezultatul interogării va fi incorect. Dintr-un anumit motiv, datele grupate pe zile vor începe chiar din anul 1677 (InfluxDB acceptă oficial intervale temporale din acel an):
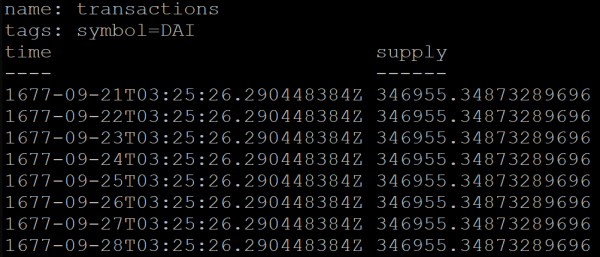
Pentru a evita această problemă, am transferat temporar serviciul pe UTC+0.
4. Performanța
Pe internet există multe benchmark-uri care compară InfluxDB cu alte baze de date. La prima întâlnire, păreau materiale de marketing, dar acum consider că există o parte de adevăr în ele.
Îți voi prezenta un caz.
Serviciul oferă o metodă API, care returnează statisticile pentru ultimele 24 de ore. La calculări, metoda interoghează baza de date de trei ori cu aceste interogări:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCExplicație:
- În prima interogare obținem cele mai recente puncte pentru fiecare monedă cu date de piață. Opt puncte pentru opt monede în cazul meu.
- A doua interogare obține un singur punct, cel mai recent.
- A treia interogare solicită lista tranzacțiilor efectuate în ultimele 24 de ore, acestea putând fi câteva sute.
Precizez că în InfluxDB, indecșii se construiesc automat pe baza etichetelor și timpului, ceea ce accelerază interogările. În prima interogare symbol — este o etichetă.
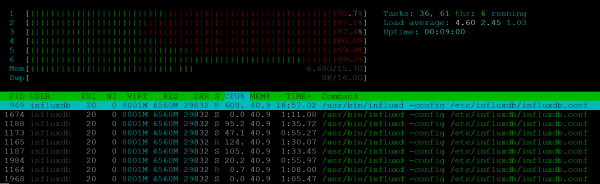
Am efectuat un test de stres pentru această metodă API. La 25 RPS, serverul arăta o încărcare completă a șase CPU:
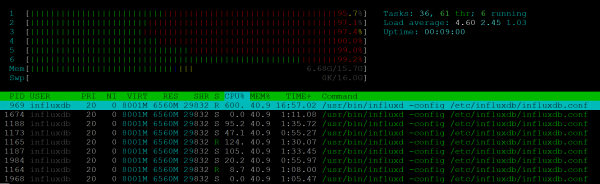
În același timp, procesul NodeJs nu genera deloc severitate.
Viteza de execuție a început să degradeze la 7-10 RPS: dacă un client putea primi un răspuns în 200 ms, atunci 10 clienți trebuiau să aștepte câte o secundă. 25 RPS este limita la care stabilitatea a avut de suferit, clienții primeau erori 500.
Cu o astfel de performanță, utilizarea Influx în proiectul nostru este imposibilă. Mai mult, în proiectul în care monitorizarea trebuie să fie demonstrată unui număr mare de clienți, pot apărea probleme similare, iar serverul de metrici va fi suprasolicitat.
Ieșire
Concluzia principală din experiența obținută este că nu trebuie să folosești o tehnologie necunoscută în proiect fără o analiză suficientă. O simplă verificare a tichetelor deschise pe github ar fi putut oferi informații care să prevină alegerea InfluxDB ca stocare principală de date.
InfluxDB ar fi trebuit să se potrivească bine cu cerințele proiectului meu, dar, așa cum a arătat practica, această bază de date nu răspunde nevoilor și are numeroase probleme.
În depozitul proiectului este deja disponibilă versiunea 2.0.0-beta, rămâne de sperat că în a doua versiune vor exista îmbunătățiri semnificative. Între timp, voi studia documentația TimescaleDB.
Sursa: habr.com
