

Bună! Vreau să explic pe înțelesul tuturor mecanica apariției steal-ului în cadrul mașinilor virtuale și unele artefacte neașteptate pe care am reușit să le descoperim în cercetarea pe care am realizat-o, în care am fost implicat ca director tehnic al platformei cloud. . Platforma funcționează pe KVM.
Timpul de steal CPU este perioada în care o mașină virtuală nu primește resurse de procesor pentru execuția sa. Acest timp este contabilizat doar în sistemele de operare guest din mediile de virtualizare. Cauzele pentru care aceste resurse alocate dispar sunt foarte neclare, la fel ca în viață. Dar am decis să investigăm, chiar am efectuat o serie de experimente. Nu că acum știm totul despre steal, dar avem câteva informații interesante de împărtășit.
1. Ce este steal
Deci, steal este o metrică care indică lipsa timpului de procesor pentru procesele din cadrul mașinii virtuale. Așa cum este descris , steal este timpul în care hypervisor-ul execută alte procese pe sistemul de operare host, deși a pus procesul mașinii virtuale în coadă pentru execuție. Cu alte cuvinte, steal este calculat ca diferența dintre momentul în care procesul este gata să fie executat și momentul în care i se alocă timpul de procesor.
Metrică steal este obținută de nucleul mașinii virtuale de la hypervisor. Cu toate acestea, hypervisor-ul nu precizează ce alte procese execută, pur și simplu „cât timp sunt ocupat, nu pot acorda timp ție”. Suportul pentru calcularea steal-ului pe KVM a fost adăugat în . Există două aspecte cheie aici:
- Mașina virtuală află despre steal de la hypervisor. Așadar, din punct de vedere al pierderilor, pentru procesele din cadrul mașinii virtuale, acesta este o măsurătoare indirectă, care poate fi supusă diferitelor distorsiuni.
- Hypervisor-ul nu împărtășește cu mașina virtuală informații despre ce altceva este ocupat, esențial este că nu îi alocă timp. Din această cauză, mașina virtuală nu poate identifica distorsiunile din indicatorul steal, care ar putea fi evaluate în funcție de natura proceselor concurente.
2. Ce influențează steal
2.1. Calcularea steal-ului
Practic, steal-ul este calculat aproximativ la fel ca timpul obișnuit de utilizare a procesorului. Informațiile despre cum se calculează utilizarea nu sunt multe. Probabil pentru că majoritatea consideră această întrebare evidentă. Dar aici pot apărea și capcane. Pentru a înțelege acest proces, se poate citi : veți afla despre o mulțime de detalii legate de calcularea utilizării și despre situațiile în care acest calcul poate fi greșit din următoarele motive:
- Supraîncălzirea procesorului, în care sunt pierdute ciclurile.
- Activarea/dezactivarea turbo boost-ului, rezultând o modificare a frecvenței de ceas a procesorului.
- Schimbarea duratei timpului de procesare, care apare atunci când se utilizează tehnologii de economisire a energiei procesorului, cum ar fi SpeedStep.
- Problema calculului mediu: estimarea utilizării de 80 % într-un interval de un minut poate ascunde un vârf de 100 %.
- Lock-ul ciclic (spin lock) face ca procesorul să fie utilizat, dar procesul utilizatorului nu vede progrese în execuția sa. Drept urmare, utilizarea procesorului calculată va fi de 100 %, în ciuda faptului că timpul fizic de procesare nu va fi consumat de proces.
Nu am găsit articole care să descrie un astfel de calcul pentru steal (dacă știți, vă rog să împărtășiți în comentarii). Însă, judecând după surse, mecanismul de calcul este același ca și pentru utilizare. Pur și simplu, în nucleu se adaugă un alt contor, direct pentru procesul KVM (procesul mașinii virtuale), care măsoară durata petrecută de procesul KVM în așteptarea timpului de procesare. Contorul preia informații despre procesor din specificațiile sale și verifică, dacă toate ciclurile sale au fost utilizate de procesul virtual. Dacă da, considerăm că procesorul a fost dedicat exclusiv procesului mașinii virtuale. În caz contrar, informăm că procesorul s-a ocupat cu altceva, a apărut steal.
Procesul de calcul al steal-ului este supus acelorași probleme ca și calculul obișnuit al utilizării. Nu se poate spune că aceste probleme apar frecvent, dar arată descurajator.
2.2. Tipurile de virtualizare pe KVM
În general, există trei tipuri de virtualizare, toate fiind suportate de KVM. Tipul de virtualizare poate influența mecanismul de apariție a steal-ului.
Translație. În acest caz, funcționarea sistemului de operare al mașinii virtuale cu dispozitivele fizice ale hypervizorului se desfășoară aproximativ așa:
- Sistemul de operare gazdă trimite o comandă către dispozitivul său gazdă.
- Driverul dispozitivului gazdă primește comanda, formează o cerere pentru BIOS-ul dispozitivului și o trimite către hypervizor.
- Procesul hipervizorului traduce comenzile în comenzi pentru dispozitivul fizic, asigurându-le, printre altele, o securitate mai mare.
- Driverul dispozitivului fizic primește comanda modificată și o trimite mai departe către dispozitivul fizic.
- Rezultatele execuției comenzilor se întorc pe același traseu.
Avantajul traducerii este că permite emularea oricărui dispozitiv și nu necesită pregătirea specială a nucleului sistemului de operare. Dar pentru aceasta se plătește, în primul rând, cu performanța.
Virtualizarea hardware. În acest caz, dispozitivul la nivel hardware înțelege comenzile din sistemul de operare. Acesta este cel mai rapid și bun mod. Din păcate, însă, nu toate dispozitivele fizice, hipervizoarele și sistemele de operare invitate îl suportă. În prezent, principalele dispozitive care suportă virtualizarea hardware sunt procesoarele.
Paravirtualizarea. Este cea mai răspândită variantă de virtualizare a dispozitivelor pe KVM și, în general, cel mai comun mod de virtualizare pentru sistemele de operare invitate. Particularitatea sa este că lucrul cu unele subsisteme ale hipervizorului (de exemplu, cu stiva de rețea sau de disc) sau alocarea paginilor de memorie se realizează prin intermediul API-ului hipervizorului, fără traducerea comenzilor de nivel inferior. Dezavantajul acestui mod de virtualizare este necesitatea modificării nucleului sistemului de operare invitat, astfel încât acesta să poată interacționa cu hipervizorul prin acest API. Dar, de obicei, aceasta se rezolvă prin instalarea de drivere speciale pe sistemul de operare invitat. În KVM, acest API se numește .
Prin paravirtualizare, comparativ cu traducerea, drumul până la dispozitivul fizic este semnificativ scurtat datorită trimiterii comenzilor direct din mașina virtuală către procesul hipervizorului de pe gazdă. Aceasta permite accelerarea execuției tuturor instrucțiunilor din interiorul mașinii virtuale. În KVM, acest lucru este asigurat de API-ul virtio, care funcționează doar pentru anumite dispozitive, cum ar fi adaptorul de rețea sau cel de disc. De aceea, în interiorul mașinilor virtuale sunt instalate drivere virtio.
Partea negativă a unei astfel de accelerări este că nu toate procesele care se desfășoară în interiorul mașinii virtuale rămân acolo. Acest lucru generează anumite efecte secundare, care pot duce la apariția unor probleme. O analiză detaliată a acestei chestiuni recomand să începeți cu .
2.3. Programarea „echitabilă”
O mașină virtuală pe un hipervizor este, de fapt, un proces obișnuit care se supune legilor de programare (distribuirea resurselor între procese) în nucleul Linux, așa că hai să o examinăm mai detaliat.
În Linux se folosește așa-numitul CFS, Completely Fair Scheduler, care, începând cu nucleul 2.6.23, a devenit managerul implicit. Pentru a înțelege acest algoritm, se pot citi Linux Kernel Architecture sau sursele. Esența CFS constă în distribuirea timpului procesorului între procese în funcție de durata execuției acestora. Cu cât un proces necesită mai mult timp de procesor, cu atât primește mai puțin din acest timp. Acest lucru garantează o execuție „corectă” a tuturor proceselor - astfel încât un proces să nu utilizeze constant toate procesoarele, iar celelalte procese să poată fi executate.
Uneori, această paradigmă duce la artefacte interesante. Utilizatorii de mult timp ai Linux își amintesc cu siguranță de înghețarea editorului de texte obișnuit pe desktop în timpul lansării aplicațiilor care consumă multe resurse, cum ar fi compilatoarele. Aceasta se întâmpla deoarece sarcinile care consumau puține resurse ale aplicațiilor de desktop concurau cu sarcinile care consumau activ resurse, cum ar fi compilatorul. CFS consideră că acest lucru nu este corect, așa că oprește periodic editorul de texte și permite procesorului să prelucreze sarcinile compilatorului. Aceasta a fost corectată cu ajutorul mecanismului , dar au rămas multe alte particularități în distribuția timpului procesorului între sarcini. De fapt, aceasta nu este o poveste despre cum este totul rău în CFS, ci o încercare de a atrage atenția asupra faptului că distribuția „corectă” a timpului procesorului nu este o sarcină trivială.
Un alt aspect important al planificatorului este preemptarea. Acesta este necesar pentru a înlătura un proces prea ocupat de pe procesor și a permite altora să lucreze. Procesul de înlăturare se numește comutare de context; în timpul acesteia se păstrează întregul context al sarcinii: starea stivei, registrele și altele. După aceea, procesul este trimis să aștepte, iar altul îi ia locul. Aceasta este o operație costisitoare pentru sistemul de operare și se utilizează rar, dar în esență nu este nimic greșit în ea. Comutarea frecventă a contextului poate indica o problemă în sistemul de operare, dar de obicei se desfășoară continuu și nu semnalează nimic special.
Această poveste lungă este necesară pentru a explica un fapt: cu cât mai multe resurse ale procesorului încearcă să consume un proces într-un planificator Linux corect, cu atât mai repede va fi oprit pentru a permite altor procese să lucreze. Faptul că este corect sau nu este o întrebare complicată, care se rezolvă diferit sub diverse încărcări. Până de curând, în Windows planificatorul era orientat spre procesarea privilegiată a aplicațiilor desktop, ceea ce ducea la blocarea proceselor de fond. În Sun Solaris erau cinci clase diferite de planificatoare. Când a fost implementată virtualizarea, a fost adăugat un al șaselea. , pentru că cele cinci anterioare nu funcționau corespunzător cu virtualizarea Solaris Zones. O cercetare detaliată a acestei teme o recomand să înceapă cu cărți precum sau .
2.4. Cum monitorizăm steal?
Monitorizarea steal-ului în interiorul unei mașini virtuale, ca și orice altă metrică de procesor, este simplă: se poate folosi orice instrument de colectare a metricalor procesorului. Principalul lucru este ca virtualizarea să fie pe Linux. În Windows, din motive necunoscute, această informație nu este disponibilă pentru utilizatori. 🙁
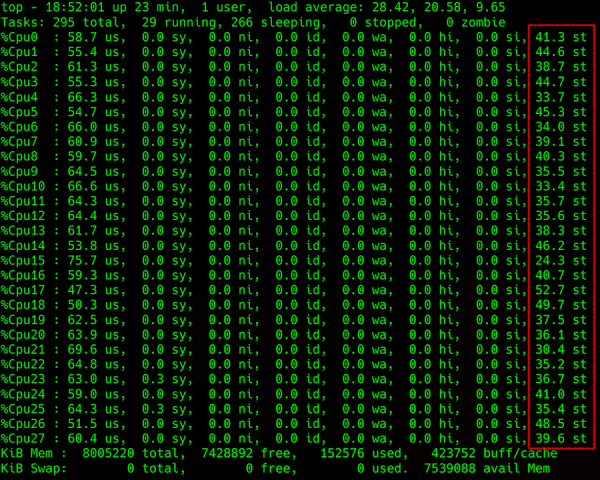
Ieșirea comenzii top: detalierea încărcării procesorului, în ultima coloană din dreapta — steal
Dificultatea apare când încercăm să obținem aceste informații de la hypervisor. Se poate încerca prezicerea steal-ului pe mașina gazdă, de exemplu, prin parametrul Load Average (LA) — valoarea medie a numărului de procese care așteaptă în coadă pentru a fi executate. Metoda de calcul al acestui parametru nu este simplă, dar în general, dacă LA, normalizat în funcție de numărul de fire de execuție al procesorului, este mai mare de 1, aceasta indică faptul că serverul Linux este supraîncărcat cu ceva.
Ce așteaptă toate aceste procese? Răspunsul evident este procesorul. Dar răspunsul nu este complet corect, pentru că uneori procesorul este liber, iar LA atinge valori ridicate. Amintiți-vă, . La fel se poate întâmpla și cu discul și cu alte dispozitive de intrare/ieșire. Dar, de fapt, procesele pot aștepta finalizarea oricărei blocări, fie că este fizică, legată de un dispozitiv de intrare/ieșire, fie că este logică, cum ar fi un mutex. De asemenea, includ blocările la nivel hardware (de exemplu, răspunsul de pe disc) sau la nivel logic (așa-numitele primitve de blocare, care includ o mulțime de entități, mutex-uri adaptive și spin, semafoare, variabile de condiție, blocări rw, blocări ipc…).
O altă caracteristică a LA este că se consideră ca o medie la nivelul sistemului de operare. De exemplu, 100 de procese concurează pentru un singur fișier, iar atunci LA=50. O astfel de valoare mare, aparent, sugerează că sistemul de operare are probleme. Dar pentru un cod prost scris, aceasta poate fi o stare normală, în timp ce, în mod paradoxal, doar acela are probleme, iar celelalte procese din sistemul de operare nu sunt afectate.
Din cauza acestui mediu (care acoperă cel puțin un minut), stabilirea unui anumit lucru pe baza indicatorului LA nu este cea mai plăcută activitate, având rezultate foarte neclare în diverse cazuri. Dacă încercați să înțelegeți, veți observa că pe articolele de pe Wikipedia și alte resurse disponibile sunt descrise doar cele mai simple cazuri, fără o explicație profundă a procesului. Toți cei interesați sunt invitați, din nou, — mai departe pe linkuri. Pentru cei care găsesc greu limba engleză — .
3. Efectele speciale
Acum ne vom concentra asupra principalelor cazuri de apariție a steal, cu care ne-am confruntat. Voi povesti despre cum decurg din toate cele spuse mai sus și cum se corelează cu indicatorii de pe hypervisor.
Reutilizarea. Cel mai simplu și frecvent: hypervisorul este suprautilizat. Adevărat, foarte multe mașini virtuale sunt pornite, consumul de procesor în interiorul lor este mare, concurența este mare, iar utilizarea LA este mai mare de 1 (în normalizarea pe firele de procesor). În toate mașinile virtuale, totul este încetinit. Steal-ul, transmis de hypervisor, de asemenea, crește, trebuie să redistribuiți sarcina sau să opriți pe cineva. În general, totul este logic și clar.
Paravirtualizare versus instanțe unice. Pe hiper-vizor există o singură mașină virtuală, care consumă o parte mică din resursele sale, dar generează o povară mare în ceea ce privește input/output, de exemplu prin disc. Și dintr-un motiv oarecare, apare un mic steal, de până la 10% (așa cum arată câteva experimente realizate).
Un caz interesant. Steal-ul apare tocmai din cauza blocajelor la nivelul driverelor paravirtualizate. În interiorul mașinii virtuale se generează o întrerupere, care este procesată de driver și apoi trimisă la hiper-vizor. Din cauza procesării întreruperii la hiper-vizor, pentru mașina virtuală, acest lucru apare ca un request trimis, este pregătită de execuție și așteaptă procesorul, dar nu primește timp de procesor. Mașina virtuală crede că acest timp a fost furat.
Acest lucru se întâmplă în momentul trimiterii bufferului, care pleacă în kernel space-ul hiper-vizorului și începem să-l așteptăm. Cu toate acestea, din punctul de vedere al mașinii virtuale, aceasta ar trebui să revină imediat. Prin urmare, conform algoritmului de calcul al steal-ului, acest timp este considerat furat. Cel mai probabil, în această situație pot exista și alte mecanisme (de exemplu, procesarea altor sys calls), dar nu ar trebui să fie foarte diferite.
Programatorul împotriva mașinilor virtuale cu sarcină mare. Când o mașină virtuală suferă de steal mai mult decât altele, acest lucru este legat de programator. Cu cât un proces încarcă mai mult procesorul, cu atât programatorul îl va expulza mai repede, astfel încât și celelalte să poată lucra. Dacă mașina virtuală consumă puțin, aproape că nu va observa steal-ul: procesul său a stat liniștit și a așteptat, deci trebuie să i se ofere mai mult timp. Dacă mașina virtuală generează o sarcină maximă pe toate nucleele sale, este expulzată mai des de pe procesor și se va încerca să nu i se ofere mult timp.
Și mai rău este când procesele din interiorul mașinii virtuale încearcă să obțină mai mult timp de procesor, deoarece nu fac față procesării datelor. Atunci sistemul de operare de pe hiper-vizor, printr-o optimizare corectă, va oferi tot mai puțin timp de procesor. Acest proces se desfășoară în avalanșă, iar steal-ul sare în sus, deși celelalte mașini virtuale ar putea să nu-l observe aproape deloc. Cu cât sunt mai multe nuclee, cu atât mai rău pentru mașina afectată. Pe scurt, cele mai afectate sunt mașinile virtuale cu sarcină mare și un număr mare de nuclee.
LA scăzut, dar există steal. Dacă LA este aproximativ 0,7 (adică, hiper-vizorul pare subîncărcat), dar în interiorul unor mașini virtuale separate se observă steal:
- Varianta menționată anterior cu paravirtualizare. Mașina virtuală poate primi metrici care indică un procent de steal, deși hypervisorul funcționează corect. Conform rezultatelor experimentelor noastre, acest tip de steal nu depășește 10% și nu ar trebui să aibă un impact semnificativ asupra performanței aplicațiilor din interiorul mașinii virtuale.
- Parametrul LA este calculat greșit. Mai exact, în fiecare moment specific, este calculat corect, dar la o medie pe o minută, rezultatul este subestimat. De exemplu, dacă o mașină virtuală consumă toate CPU-urile hypervisorului timp de exact o jumătate de minut, atunci LA pe hypervisor va fi 0,15; patru astfel de mașini virtuale, funcționând simultan, vor da 0,6. Însă, faptul că fiecare dintre ele a avut un procent de steal de aproximativ 25% pe indicatorul LA timp de o jumătate de minut nu va mai putea fi recuperat.
- Din nou, din cauza scheduler-ului, care a decis că cineva consumă prea mult și ar trebui să aștepte. Între timp, voi comuta contextul, voi procesa întreruperile și mă voi ocupa de alte sarcini importante ale sistemului. Ca urmare, unele mașini virtuale nu observă probleme, în timp ce altele experimentează o degradare serioasă a performanței.
4. Alte distorsiuni
Există încă o sută de motive pentru distorsiuni în returnarea corectă a timpului de procesare pe mașina virtuală. De exemplu, dificultățile în calcul sunt generate de hyperthreading și NUMA. Acestea complică definitiv alegerea nucleului pentru execuția procesului, deoarece scheduler-ul folosește coeficienți - greutăți care, la comutarea contextului, fac calculul și mai complex.
Distorsiunile pot apărea și din cauza tehnologiilor precum turbo boost sau, dimpotrivă, a modului de economisire a energiei, care la calcularea utilizării pot crește sau reduce artificial frecvența sau chiar cuantumul de timp pe server. Activarea turbo boost-ului reduce performanța unui fir de procesor din cauza creșterii performanței altuia. În acel moment, informația despre frecvența actuală a procesorului nu este transmisă mașinii virtuale, iar aceasta crede că timpul ei este furat (de exemplu, a solicitat 2 GHz, dar a primit jumătate).
În general, pot exista multe cauze pentru distorsiuni. Într-un sistem specific, puteți descoperi altceva. Cel mai bine este să începeți cu cărțile către care am oferit linkuri mai sus și să colectați statistici de la hypervisor folosind utilitare precum perf, sysdig, systemtap, dintre care .
5. Concluzii
- Une anumită cantitate de steal poate apărea din cauza paravirtualizării și poate fi considerată normală. Pe internet se scrie că această valoare poate ajunge la 5-10%. Depinde de aplicațiile din interiorul mașinii virtuale și de încărcătura pe care o generează asupra dispozitivelor fizice. Este important să se acorde atenție modului în care se simt aplicațiile din interiorul mașinilor virtuale.
- Raportul dintre încărcătura pe hypervisor și steal-ul din interiorul mașinii virtuale nu este întotdeauna direct corelat; ambele evaluări ale steal-ului pot fi eronate în anumite situații, în funcție de diferitele încărcături.
- Scheduler-ul are o aversiune față de procesele care cer prea mult. Se străduiește să ofere mai puțin celor care cer mai mult. Marii furnizori virtuali sunt o problemă.
- Un mic steal poate fi normal și fără paravirtualizare (ținând cont de încărcătura din interiorul mașinii virtuale, particularitățile încărcărilor vecinilor, distribuția încărcăturii pe fire și alți factori).
- Dacă doriți să determinați steal-ul într-un sistem specific, este necesar să explorați diverse opțiuni, să colectați metrice, să le analizați cu atenție și să gândiți cum să distribuiți sarcina uniform. Este posibil ca abaterile să apară în orice scenariu, care trebuie confirmate experimental sau analizate în debugger-ul kernel-ului.
Sursa: habr.com
