

Jurnalizarea este o parte esențială a sistemului, care ne permite să înțelegem dacă acesta funcționează (sau nu), așa cum ne așteptăm. În condițiile arhitecturii microserviciilor, lucrul cu jurnalele devine o disciplină de sine stătătoare a unei olimpiade speciale. Trebuie să rezolvăm imediat o mulțime de întrebări:
- cum să scriem jurnale din aplicație;
- unde să scriem jurnalele;
- cum să livrăm jurnalele pentru stocare și procesare;
- cum să procesăm și să stocăm jurnalele.
Aplicarea tehnologiilor populare de containerizare adaugă dificultăți suplimentare în găsirea soluțiilor pentru această problemă.
Acesta este exact subiectul expunerii lui Yuri Bushmelev «Harta dificultăților în colectarea și livrarea jurnalele»
Cine este interesat, vă rog să citiți mai departe.
Mă numesc Yuri Bushmelev. Lucrez la Lazada. Astăzi voi vorbi despre cum am gestionat jurnalele noastre, cum le-am colectat și ce scriem în ele.
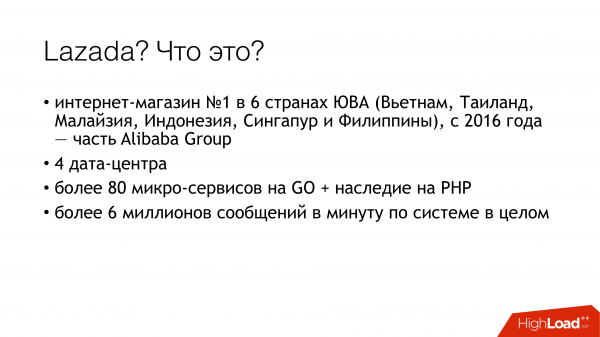
De unde suntem? Cine suntem? Lazada este magazinul online nr. 1 în șase țări din Asia de Sud-Est. Toate aceste țări sunt distribuite pe centre de date. În prezent, avem 4 centre de date. De ce este important? Pentru că unele soluții au fost dictate de faptul că legătura între centre este foarte slabă. Avem o arhitectură microservicii. Am fost surprins să descopăr că avem deja 80 de microservicii. Când am început să mă ocup de jurnale, erau doar 20. În plus, există un segment destul de mare de legacitate PHP, cu care trebuie să trăim și să ne împăcăm. Toate acestea generează în prezent mai mult de 6 milioane de mesaje pe minut în întreg sistemul. Mai departe, voi arăta cum încercăm să gestionăm asta și de ce este așa.
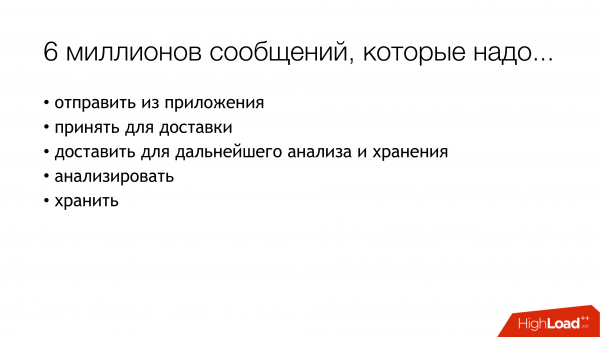
Trebuie să gestionăm aceste 6 milioane de mesaje cumva. Ce trebuie să facem cu ele? 6 milioane de mesaje, care trebuie să:
- fie trimise din aplicație
- fie primite pentru livrare
- fie livrate pentru analiză și stocare.
- să fie analizate
- să fie stocate cumva.
Când au apărut trei milioane de mesaje, aveam un aspect similar. Pentru că am început cu câțiva bănuți. Este clar că acolo se scriu logurile aplicațiilor. De exemplu, nu m-am putut conecta la baza de date, m-am putut conecta la baza de date, dar nu am putut citi ceva. Dar, în afară de asta, fiecare microserviciu al nostru scrie și un log de acces. Fiecare cerere care ajunge la microserviciu cade în log. De ce facem asta? Dezvoltatorii vor să aibă posibilitatea de a face tracing. În fiecare log de acces există un câmp traceid, pe baza căruia o interfață specială reconstruiește întreaga lanț și arată frumos tracing-ul. Tracing-ul arată cum a trecut cererea și asta îi ajută pe dezvoltatorii noștri să facă față mai repede oricărei probleme neidentificate.
Cum trăim cu asta? Acum voi rezuma câteva opțiuni — cum se rezolvă, de fapt, această problemă. Cum să abordăm sarcina de colectare, transmitere și stocare a logurilor.
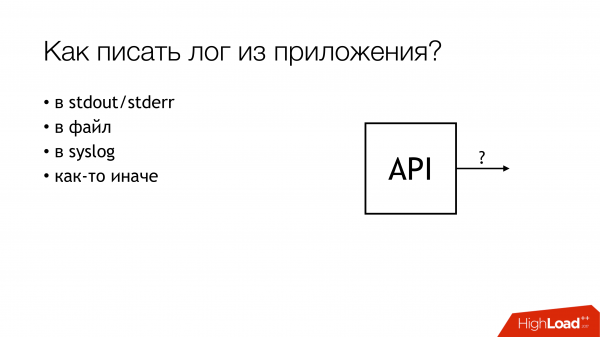
Cum să scrii din aplicație? Este clar că există diferite metode. În special, există cele mai bune practici, așa cum ne spun specialiștii trendy. Există și stilul vechi în două forme, așa cum ne-au povestit bătrânii. Există și alte metode.
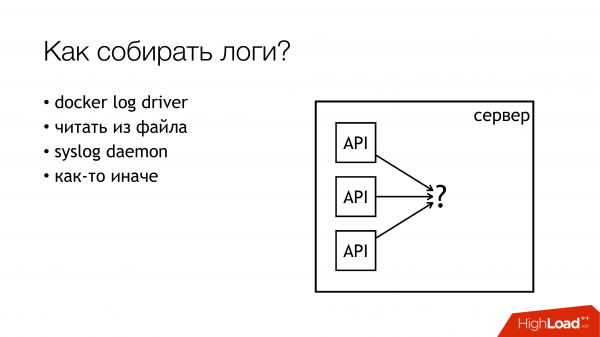
În ceea ce privește colectarea logurilor, situația este similară. Opțiunile pentru rezolvarea acestei părți specifice nu sunt foarte multe. Au devenit mai multe, dar încă nu sunt foarte multe.
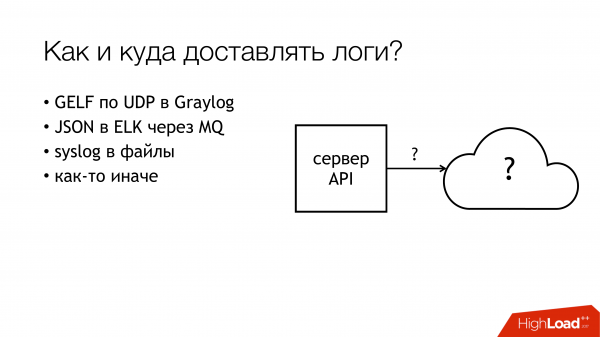
Dar în ceea ce privește livrarea și analiza ulterioară — numărul de variații începe să explodeze. Nu voi descrie fiecare opțiune acum. Cred că principalele opțiuni sunt cunoscute tuturor celor interesați de acest subiect.
Voi arăta cum am făcut asta la Lazada și cum a început totul, de fapt.
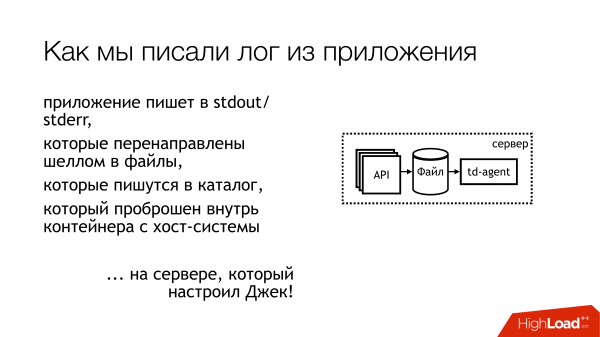
Acum un an am venit la Lazada și am fost trimis pe un proiect despre loguri. Așa era situația. Logul din aplicație era scris în stdout și stderr. Totul a fost făcut conform tendințelor. Dar mai departe dezvoltatorii acestea le-au scos din fluxurile standard, iar apoi infrastructura se va ocupa de ele. Între specialiștii în infrastructură și dezvoltatori mai sunt și cei care se ocupă de lansări, care au spus: „ehh… bine, hai să le punem într-un fișier, doar cu shell”, și totul. Și, deoarece totul se desfășura într-un container, le-am pus direct în containerul respectiv, am mapat un director în interior și le-am pus acolo. Cred că tuturor le este destul de clar ce a rezultat din asta.
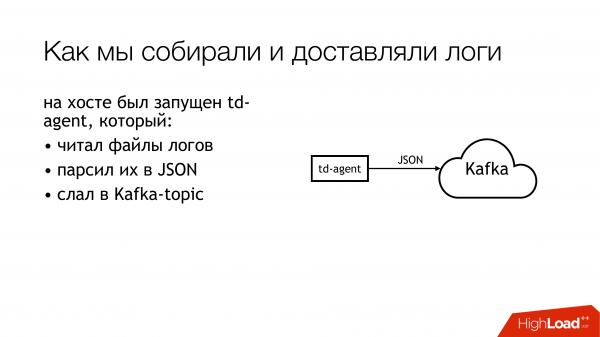
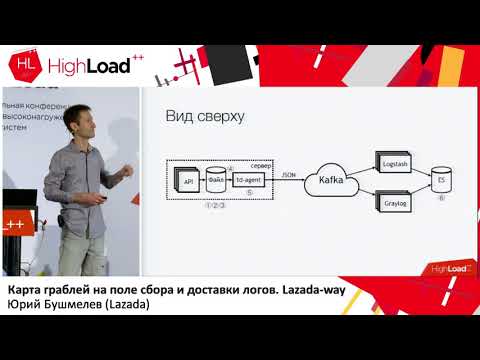
Să ne uităm puțin mai departe. Cum am livrat aceste loguri. Cineva a ales td-agent, care de fapt este fluentd, dar nu chiar fluentd. Nu am înțeles relația dintre aceste două proiecte, dar pare că este vorba de același lucru. Și acest fluentd, scris în Ruby, citea fișierele de log, le analiza în JSON după anumite expresii regulate. Apoi le trimitea în Kafka. În Kafka, pentru fiecare API, aveam 4 subiecte separate. De ce 4? Pentru că există live, există staging și pentru că sunt stdout și stderr. Dezvoltatorii le creează, iar cei care se ocupă de infrastructură trebuie să le configureze în Kafka. În plus, Kafka era controlată de un alt departament. Așadar, era nevoie să se creeze un tichet pentru a se crea cele 4 subiecte pentru fiecare API. Toată lumea uita de asta. În general, a fost haos.
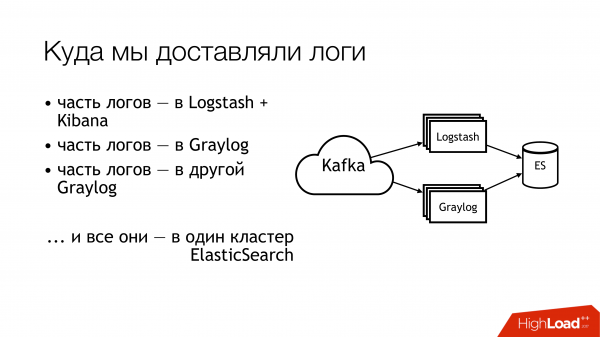
Ce am făcut mai departe cu asta? Am trimis-o în Kafka. Apoi, din Kafka, jumătate din loguri s-au dus în Logstash. Cealaltă jumătate a logurilor s-a împărțit. O parte s-a dus într-un Graylog, iar partea – în alt Graylog. În final, totul s-a dus într-un singur cluster Elasticsearch. Deci, tot acest haos ajungea în cele din urmă acolo. Nu trebuie să procedăm așa!
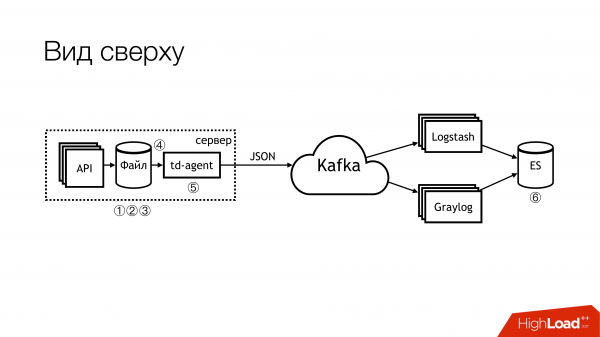
Așa arată dacă ne uităm de sus, de la distanță. Nu trebuie să procedați așa! Aici, numerele indică imediat locurile problematice. De fapt, sunt mai multe, dar 6 sunt efectiv problematice, cu care trebuie să facem ceva. Despre acestea voi povesti separat.
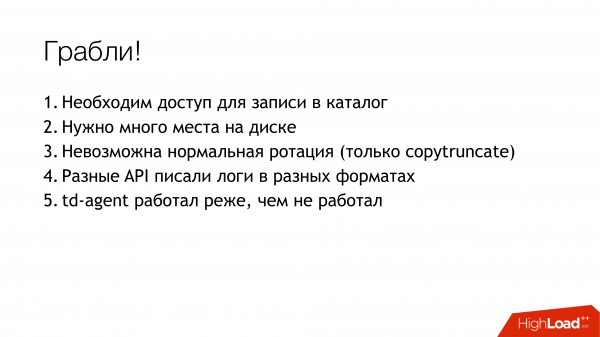
Aici (1,2,3) se scriu fișiere și, în consecință, aici sunt imediat trei capcane.
Primul (1) – trebuie să le scriem undeva. Nu întotdeauna ne-ar plăcea să permitem API-ului să scrie direct în fișier. Ar fi de preferat ca API-ul să fie izolat într-un container, iar și mai bine – să fie read-only. Eu sunt administrator de sistem, așa că am o viziune puțin alternativă asupra acestor lucruri.
Un al doilea punct (2,3) — primim multe cereri în API. API-ul scrie multe date într-un fișier. Fișierele cresc. Trebuie să le rotim. Altfel, nu o să avem loc pe discuri. Rotirea lor este complicată, deoarece sunt redirecționate prin shell într-un catalog. Nu putem să le rotim. Nu putem spune aplicației să redeschidă descriptorii. Deoarece dezvoltatorii se vor uita la tine ca la un nebun: „Ce descriptorii? Noi scriem direct în stdout”. Inginerii de infrastructură au implementat copytruncate în logrotate, care face pur și simplu o copie a fișierului și truncatează originalul. Prin urmare, între aceste procese de copiere, de obicei, terminăm parți de pe disc.
(4) Am avut diferite formate în diferite API-uri. Ele se asemănau puțin, dar a fost necesar să scriem regex-uri diferite. Deoarece totul era gestionat de Puppet, existau multe clase interconectate cu propriile lor probleme. În plus, td-agent putea consuma multă memorie, putea fi lent, putea doar să facă pe că lucrează și să nu facă nimic. Din exterior, era imposibil să înțelegem că nu face nimic. În cel mai bun caz, se oprea și cineva îl repunea în funcțiune apoi. Mai precis, apărea un alert și cineva mergea să-l repună manual.
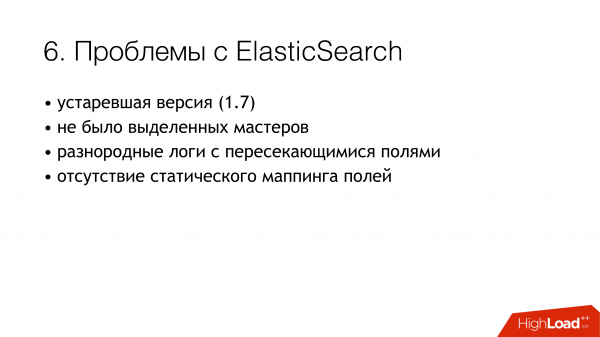
(6) Cea mai mare problemă a fost elasticsearch. Deoarece era o versiune veche. Deoarece nu aveam maeștri dedicați la acel moment. Aveam jurnale eterogene, ale căror câmpuri se puteau suprapune. Jurnale diferite ale unor aplicații diferite se puteau scrie cu aceleași denumiri de câmpuri, dar cu date diferite de interior. De exemplu, un jurnal poate primi un Integer în câmpul level. Alt jurnal poate primi un String în câmpul level. În absența unui mapping static, obținem o situație interesantă. Dacă după rotația indexului în elasticsearch primul mesaj care ajunge este un string, atunci totul merge normal. Dar dacă primul mesaj vine cu un Integer, atunci toate mesajele ulterioare care vin cu un String sunt pur și simplu eliminate. Deoarece tipurile de câmp nu corespund.
Am început să ne punem aceste întrebări. Am decis să nu căutăm vinovați.
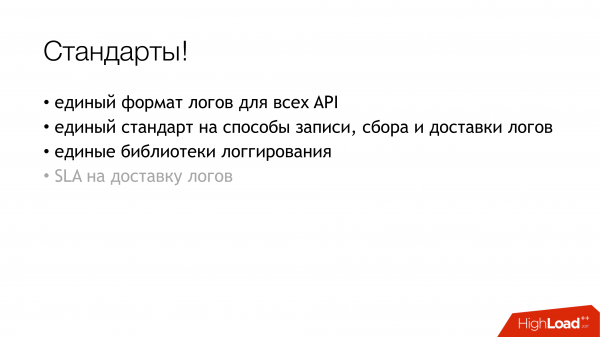
Dar trebuie să facem ceva! Este evident că trebuie stabilite norme. Unele norme au existat deja. Altele au fost introduse puțin mai târziu. Din fericire, un format unic de jurnale pentru toate API-urile fusese deja aprobat la acea dată. Acesta este specificat direct în standardele de interacțiune ale serviciilor. Prin urmare, cei care doresc să primească jurnale trebuie să le scrie în acest format. Dacă cineva nu scrie jurnale în acest format, înseamnă că nu garantăm nimic.
În continuare, aș dori să stabilim un standard unic pentru metodele de înregistrare, livrare și colectare a jurnalele. Adică, unde să le scriem și cu ce să le livrăm. Situația ideală este atunci când în proiecte se folosește aceeași bibliotecă. Există o bibliotecă separată pentru jurnale pentru Go, există o bibliotecă separată pentru PHP. Toți cei pe care îi avem ar trebui să le folosească. În prezent, aș spune că avem acest lucru realizat în aproximativ 80%. Dar unii continuă să mănânce cactuși.
Și acolo, în dreapta (în slide), abia-abia începe să apară „SLA pentru livrarea jurnalele”. Deocamdată nu avem, dar lucrăm la asta. Pentru că este foarte convenabil când infrastructura spune că dacă scrieți într-un anumit format într-un anumit loc și nu mai mult de N mesaje pe secundă, atunci noi le vom livra acolo cu o probabilitate de X. Asta elimină o mulțime de dureri de cap. Dacă avem SLA, atunci este pur și simplu minunat!
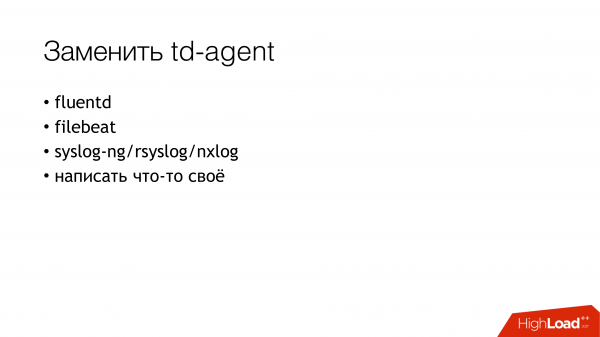
Cum am început să rezolvăm problema? Principalul obstacol a fost cu td-agent. Era neclar unde se duc jurnalele noastre. Se livrează? Se colectează? Unde sunt de fapt? Prin urmare, primul punct a fost să înlocuim td-agent. Opțiunile pentru a-l înlocui le-am schițat aici pe scurt.
Fluentd. În primul rând, m-am întâlnit cu el la locul de muncă anterior, și acolo cădea periodic. În al doilea rând, este același lucru, doar că optimizat.
Filebeat. Ce a fost convenabil pentru noi? Faptul că este scris în Go, iar noi avem o mare expertiză în Go. Prin urmare, dacă era necesar, puteam cumva să-l adaptăm. De aceea nu l-am luat. Ca să nu existe niciun motiv de a începe să-l rescriem pentru noi.
O soluție evidentă pentru administrator rămân diversele syslog-uri într-o asemenea cantitate (syslog-ng/rsyslog/nxlog).
Sau să scriem ceva propriu, dar am abandonat asta, la fel ca și filebeat. Dacă ar fi să scriem ceva, atunci mai bine am scrie ceva util pentru afaceri. Pentru livrarea jurnalele, mai bine să luăm ceva deja existent.
Prin urmare, alegerea a fost practic o alegere între syslog-ng și rsyslog. Am înclinat spre rsyslog doar pentru că aveam deja clase pentru rsyslog în Puppet și nu am găsit nicio diferență evidentă între ele. Ce este syslog acolo, este syslog și aici. Da, unii au documentația mai proastă, alții mai bună. Unul face într-un fel, iar celălalt - în alt fel.
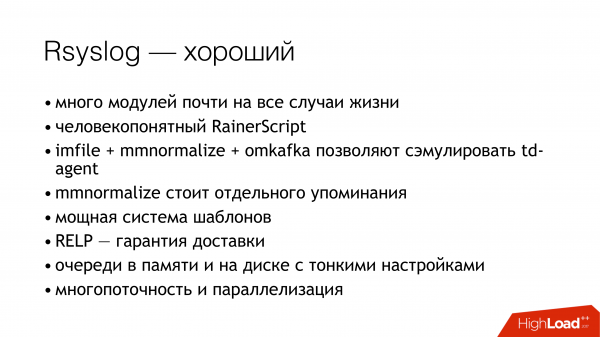
Și puțin despre rsyslog. În primul rând, e grozav, pentru că are multe module. Are un RainerScript prietenos pentru utilizatori (un limbaj de configurare modern). Un bonus excelent este că am putut simula comportamentul td-agent folosind unelte standard, iar pentru aplicații nu s-a schimbat nimic. Asta înseamnă că schimbăm td-agent cu rsyslog, iar restul rămâne neschimbat. Și obținem imediat livrarea funcțională. În continuare, mmnormalize - este o chestie grozavă în rsyslog. Permite parsearea jurnalelor, dar nu prin Grok și regexp. Creează un arbore sintactic abstract. Parsează jurnalele aproximativ așa cum compilează un compilator sursele. Asta permite o funcționare foarte rapidă, consumă puțin CPU și este, în general, o chestie foarte bună. Există o grămadă de alte bonusuri. Nu mă voi opri asupra lor.
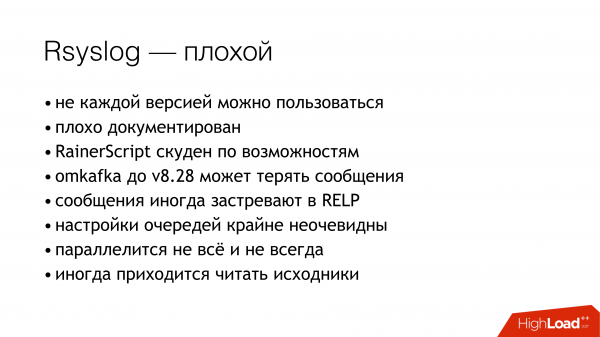
Rsyslog are o grămadă de dezavantaje. Acestea sunt aproximativ la fel ca și bonusurile. Problemele principale sunt că trebuie să știi cum să-l configurezi și trebuie să alegi versiunea corespunzătoare.
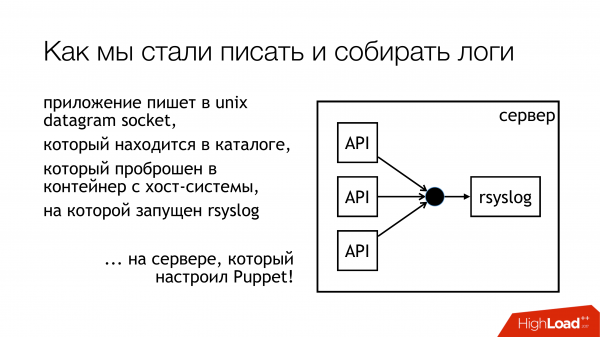
Am decis că vom scrie jurnalele în socket unix. Și nu în /dev/log, pentru că acolo avem o aglomerare de jurnale de sistem, unde journald este în acest pipeline. Așadar, haideți să scriem într-un socket personalizat. Îl vom conecta la un ruleset separat. Nu vom amesteca nimic. Totul va fi transparent și clar. Așa am procedat. Directorul cu aceste socketuri este standardizat și este transmis în toate containerele. Containerele pot vedea socketul de care au nevoie, se pot deschide și pot scrie în el.
De ce nu un fișier? Pentru că toată lumea a citit , care încerca să transmită un fișier în docker și descoperea că, după repornirea rsyslog, descriptorul de fișier se schimbă, iar docker pierde acest fișier. Se ține deschis altceva, dar nu socketul pe care se scrie. Am decis că vom ocoli această problemă și, de asemenea, vom ocoli problema blocării.
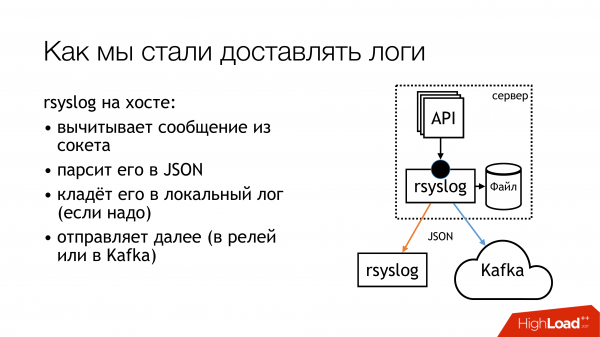
Rsyslog efectuează acțiunile indicate pe diapozitiv și trimite jurnalele fie în relaye, fie în Kafka. Kafka corespunde vechii metode. Relay - este pur și simplu rsyslog folosit pentru livrarea jurnalelor. Fără Message Queue, cu unelte standard din rsyslog. În principiu, funcționează.
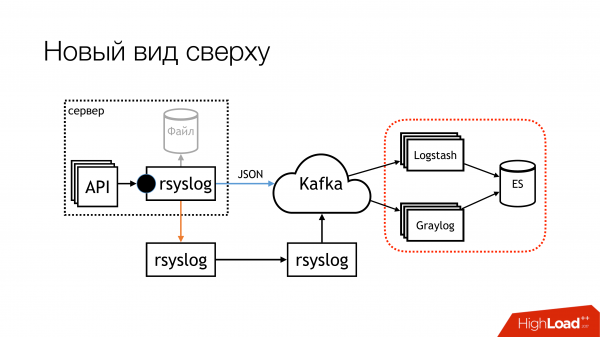
Dar sunt nuanțe în modul de a le introduce în această parte (Logstash/Graylog/ES). Această parte (rsyslog-rsyslog) este folosită între centrele de date. Aici există un link TCP comprimat, care permite economisirea lățimii de bandă și, în consecință, crește probabilitatea de a primi unele jurnale din alt centru de date în condițiile în care canalul este congestionat. De aceea, avem Indonezia, unde situația este complicată. Acolo este o problemă constantă.
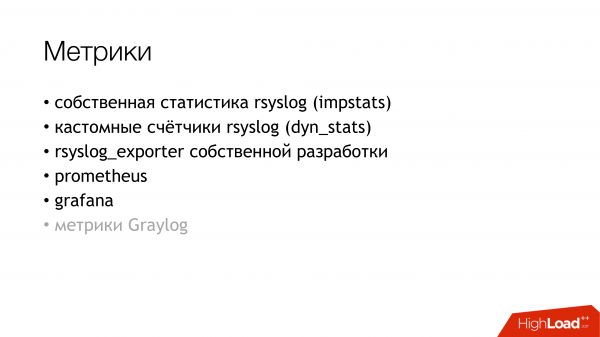
Ne-am gândit cum să monitorizăm, care este probabilitatea ca jurnalele pe care le-am înregistrat din aplicație să ajungă la destinație? Am decis să creăm metrici. Rsyslog are un modul de colectare a statisticilor, care include diverse contoare. De exemplu, poate să îți arate dimensiunea cozii sau câte mesaje au ajuns într-o anumită acțiune. Din acestea, putem extrage ceva. În plus, are contoare personalizate care pot fi configurate și care vor arăta, de exemplu, numărul de mesaje pe care le-a înregistrat o anumită API. Ulterior, am scris rsyslog_exporter în Python și am trimis toate acestea în Prometheus și am construit grafice. Ne doream foarte mult metrici din Graylog, dar deocamdată nu am reușit să le configurăm.
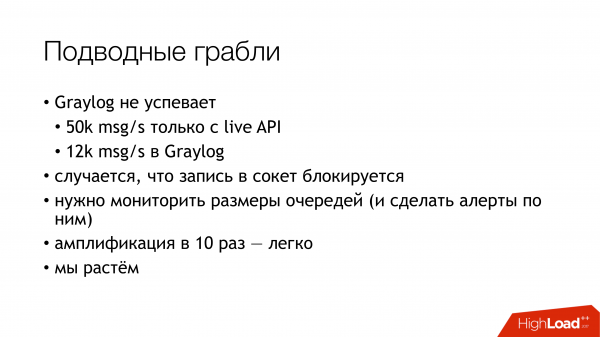
Cu ce probleme ne-am confruntat? Problemele au apărut când am descoperit (SURPRIZĂ!), că API-urile noastre Live scriu 50k mesaje pe secundă. Asta este doar API-ul Live, fără staging. Iar Graylog ne arată doar 12 mii de mesaje pe secundă. Și a apărut o întrebare rațională, unde sunt resturile? Din asta am dedus că Graylog pur și simplu nu face față. Am verificat și, într-adevăr, Graylog cu Elasticsearch nu a putut face față acestui volum.
În continuare, alte descoperiri pe care le-am făcut în proces.
Înscrierea în socket-uri este blocată. Cum s-a întâmplat asta? Atunci când am folosit rsyslog pentru livrare, la un moment dat, canalul dintre centrele de date s-a rupt. Livrarea s-a oprit într-un loc, livrarea s-a oprit în alt loc. Toate acestea au afectat mașina cu API-uri care scriu în socket-ul rsyslog. Acolo s-a umplut coada. Apoi s-a umplut coada pentru scrierea în socket-ul Unix, care are, în mod implicit, 128 de pachete. Și următorul write() în aplicație este blocat. Când ne-am uitat în biblioteca pe care o folosim în aplicațiile noastre scrise în Go, scria că scrierea în socket se face în modul non-blocant. Eram convinși că nimic nu este blocat. Pentru că citisem. , care a scris despre asta. Dar există un detaliu. În jurul acestei apelări a fost un ciclu infinit, în care încercam constant să trimitem un mesaj în socket. Asta nu am observat. A trebuit să rescriem biblioteca. De atunci, a suferit câteva modificări, dar acum ne-am eliberat de blocaje în toate subsistemele. De aceea, putem opri rsyslog, și nimic nu se va prăbuși.
Trebuie să monitorizăm dimensiunea cozilor, ceea ce ajută să nu cădem în aceste capcane. În primul rând, putem monitoriza când începem să pierdem mesaje. În al doilea rând, putem monitoriza că avem, în principiu, probleme cu livrarea.
Și un alt aspect neplăcut — amplificarea de 10 ori în arhitectura microserviciilor — este foarte ușoară. Nu avem atât de multe cereri de intrare, dar din cauza grafului, pe care aceste mesaje îl urmează mai departe, din cauza jurnalelor de acces, creștem efectiv încărcătura din jurnal de aproximativ zece ori. Din păcate, nu am reușit să calculez cifrele exacte, dar microserviciile sunt așa. Trebuie să ținem cont de acest lucru. Rezultatul este că, în prezent, subsistemul de colectare a jurnaleleor este cel mai solicitat în Lazada.
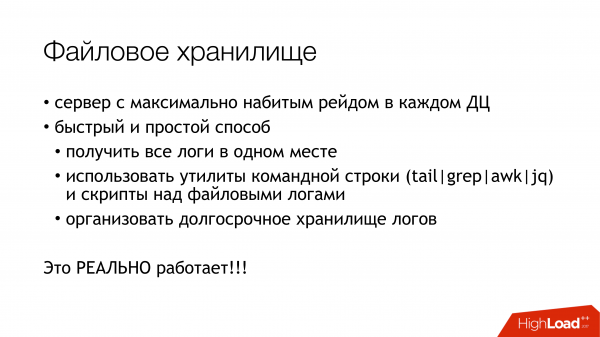
Cum rezolvăm problema elasticsearch? Dacă trebuie să obțineți rapid jurnalele într-un singur loc, fără a alerga prin toate mașinile și a le aduna, folosiți un sistem de stocare a fișierelor. Asta funcționează garantat. Se poate face din orice server. Trebuie pur și simplu să conectați niște discuri și să instalați syslog. După asta, veți avea toate jurnalele într-un singur loc. Apoi, puteți configura cu răbdare elasticsearch, graylog, sau altceva. Dar deja veți avea toate jurnalele și, în plus, le puteți stoca atâta timp cât vă permit unitățile de disc.
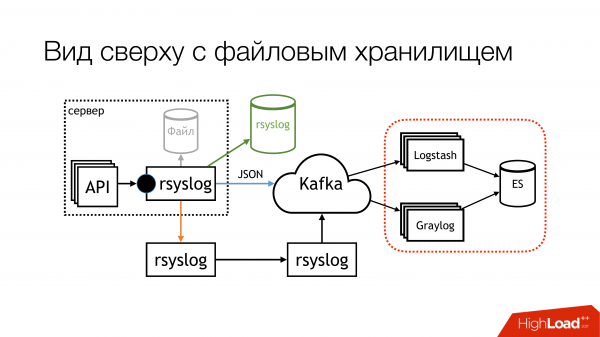
La momentul prezentării mele, schema arăta astfel. Practic am încetat să scriem în fișiere. Probabil, în curând, vom deconecta resturile. Pe mașinile locale, pe care sunt pornite API-urile, nu vom mai scrie în fișiere. În primul rând, există un sistem de stocare a fișierelor care funcționează foarte bine. În al doilea rând, pe aceste mașini se termină constant spațiul, trebuie să-l monitorizăm constant.
Această parte cu Logstash și Graylog, pur și simplu ne complică viața. De aceea, trebuie să ne eliberăm de ea. Trebuie să alegem ceva unul.
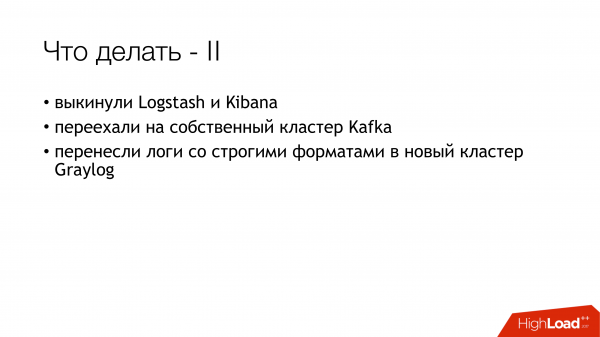
Am decis să renunțăm la Logstash și Kibana. Pentru că avem un departament de securitate. Care este legătura? Legătura este că Kibana fără X-Pack și fără Shield nu permite delimitarea drepturilor de acces la loguri. Așa că am ales Graylog. Are tot ce avem nevoie. Nu-mi place, dar funcționează. Am achiziționat hardware nou, am instalat Graylog proaspăt acolo și am mutat toate logurile cu formate stricte într-un Graylog separat. Am rezolvat problema cu diferitele tipuri de câmpuri identice din punct de vedere organizațional.
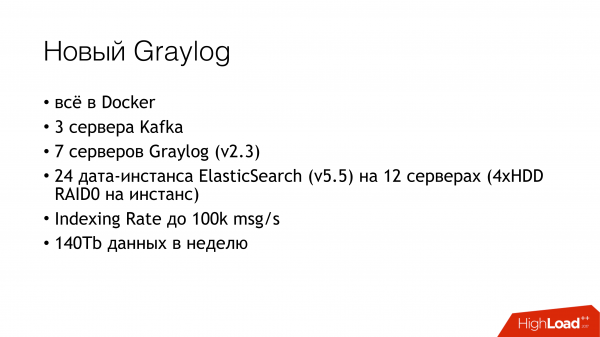
Ce include, de fapt, noul Graylog? Am notat totul în Docker. Am luat o mulțime de servere, am desfășurat trei instanțe Kafka, șapte servere Graylog versiunea 2.3 (pentru că ne doream versiunea 5 de Elasticsearch). Totul a fost ridicat pe RAID-uri din HDD-uri. Am observat o rată de indexare de până la 100.000 de mesaje pe secundă. Am văzut că avem 140 terabyte de date pe săptămână.
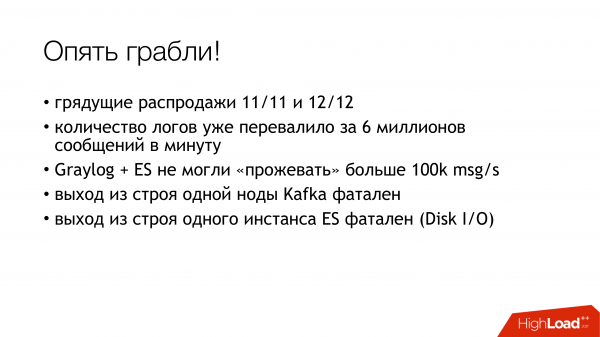
Iarăși am dat peste aceleași probleme! Avem două vânzări în așteptare. Am ajuns la 6 milioane de mesaje. Graylog-ul nostru nu reușește să proceseze totul. Trebuie să găsim o modalitate de a supraviețui din nou.
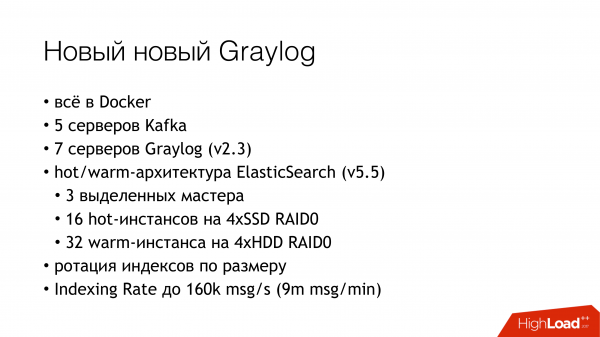
Așa am supraviețuit. Am adăugat încă câteva servere și SSD-uri. În acest moment, trăim în felul acesta. Acum reușim să procesăm deja 160.000 de mesaje pe secundă. Încă nu am atins limita, deci nu este clar cât de mult vom putea extrage din acest sistem.
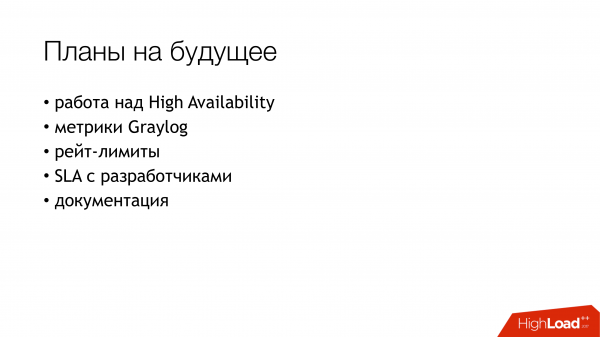
Așa arată planurile noastre pentru viitor. Dintre acestea, cel mai important este, probabil, disponibilitatea mare. Momentan nu o avem. Câteva mașini sunt configurate identic, dar totul trece în continuare printr-o singură mașină. Trebuie să ne alocăm timp pentru a configura failover-ul între ele.
Colectarea metricilor din Graylog.
Implementarea limitării ratei pentru ca o API care a luat-o razna să nu ne afecteze lățimea de bandă și celelalte aspecte.
Și, în final, semnarea unui SLA cu dezvoltatorii, în care să stabilim că putem gestiona un anumit volum. Dacă scrieți mai mult, ne pare rău.
Și redactarea documentației.
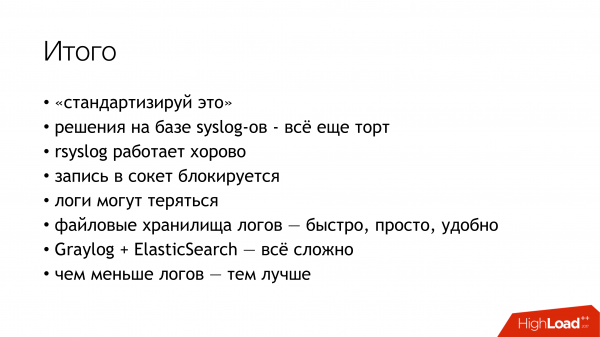
Pe scurt, concluziile a tot ce am trecut. În primul rând, standarde. În al doilea rând, syslog - este tort. În al treilea rând, rsyslog funcționează exact așa cum este prezentat pe diapozitiv. Și haideți să trecem la întrebări.
Întrebări.
Întrebare: De ce ați decis totuși să nu luați... (filebeat?)
Răspuns: Trebuie să scriem în fișier. Nu ne-am dorit deloc. Când API-ul tău scrie mii de mesaje pe secundă, chiar dacă rotiți fișierul o dată pe oră, tot nu este o opțiune. Se poate scrie în pipe. La care dezvoltatorii m-au întrebat: „Ce se întâmplă dacă procesul în care scriem se oprește”? Pur și simplu nu am găsit un răspuns și am spus: „Bine, atunci să nu facem așa.”
Întrebare: De ce nu scrieți jurnalele direct în HDFS?
Răspuns: Aceasta este următoarea etapă. Ne-am gândit la ea încă de la început, dar, având în vedere că în prezent nu avem resurse pentru a ne ocupa de asta, este și va rămâne o soluție pe termen lung.
Întrebare: Formatul pe coloane ar fi mai potrivit.
Răspuns: Înțeleg totul. Suntem de acord în totalitate.
Întrebare: Scrieți în rsyslog. Acolo sunt disponibile atât TCP, cât și UDP. Dar dacă folosiți UDP, cum garantați livrarea?
Răspuns: Există două aspecte. Primul, le spun imediat tuturor că nu garantăm livrarea jurnalelor. Deoarece atunci când dezvoltatorii vin și spun: „Haideți să începem să scriem date financiare acolo, iar voi le veți stoca undeva în caz că se întâmplă ceva”, le răspundem „Excelent! Haideți să faceți blocări la scrierea în socket și să faceți acest lucru în tranzacții, astfel încât să ne asigurați că ați pus asta în socket și v-ați asigurat că noi am primit acea informație de cealaltă parte.” Și în acel moment, toată lumea devine imediat dezinteresată. Și dacă nu sunt interesați, ce întrebări mai avem noi? Dacă nu doriți să garantați scrierea în socket, de ce ar trebui să garantăm livrarea? Facem eforturi maxime. Ne străduim cu adevărat să livrăm cât mai mult și cât mai bine, dar nu oferim 100% garanție. Așadar, nu este nevoie să scrieți date financiare acolo. Există baze de date pentru tranzacții.
Întrebare: Atunci când API-ul generează un mesaj în jurnal și predă controlul microserviciilor, v-ați confruntat vreodată cu problema că mesajele de la diferite microservicii sosesc în ordine greșită? Din această cauză apare confuzia.
Răspuns: Este normal ca acestea să sosească în ordine diferită. Trebuie să fiți pregătiți pentru asta. Deoarece orice livrare pe rețea nu vă garantează ordinea sau trebuie să investești special resurse pentru asta. Dacă ne uităm la stocările de fișiere, fiecare API își salvează jurnalele în fișierul său. De fapt, rsyslog le organizează pe categorii. Fiecare API are jurnalele sale, la care se poate merge și verifica, iar apoi, în acest jurnal, se pot corela în funcție de timestamp. Dacă se uită în Graylog, acolo se vor sorta după timestamp. Totul va fi bine.
Întrebare: Timestamp-ul poate diferi cu câteva milisecunde.
Răspuns: Timestamp-ul este generat de API. Asta este, de fapt, toată esența. Avem NTP. API-ul generează timestamp-ul chiar în mesaj. Nu este adăugat de rsyslog.
Întrebare: Nu este foarte clar cum interacționează centrele de date. În cadrul centrului de date este clar cum s-au colectat și procesat logurile. Cum are loc interacțiunea între centrele de date? Sau fiecare centru de date își duce viața separat?
Răspuns: Aproape. Fiecare țară se află într-un singur centru de date. Momentan nu avem dispersie, astfel încât o țară să fie găzduită în mai multe centre de date. Deci nu trebuie să le integrăm. În interiorul fiecărui centru există un Log Relay. Acesta este un server Rsyslog. De fapt, sunt două mașini de management. Sunt configurate identic. Dar momentan, traficul trece prin una dintre ele. Aceasta agregă toate logurile. Are o coadă de discuri pentru orice eventualitate. Compresionează logurile și le trimite în centrul de date central (cel din Singapore), unde sunt trimise mai departe în Graylog. Și în fiecare centru de date există un storage de fișiere propriu. În cazul în care pierdem conexiunea, avem toate logurile acolo. Ele vor rămâne acolo. Vor fi păstrate.
Întrebare: În situații neplanificate, obțineți loguri de acolo?
Răspuns: Poți merge acolo (la storage-ul de fișiere) și verifica.
Întrebare: Cum monitorizați că nu pierdeți loguri?
Răspuns: De fapt, le pierdem și monitorizăm acest lucru. Monitorizarea a fost activată acum o lună. În biblioteca utilizată de Go API, există metrici. Aceasta poate contabiliza de câte ori nu a reușit să scrie în socket. Momentan există o heuristica sofisticată. Există un buffer. Acesta încearcă să scrie din el un mesaj în socket. Dacă bufferul se umple, începe să le abandoneze. Și contabilizează câte a abandonat. Dacă acolo încep să se umple contoarele, aflăm despre asta. Acestea sosesc acum și în Prometheus, iar în Grafana poți vedea graficele. Se pot configura alerte. Dar momentan nu este clar cui să le trimitem.
Întrebare: În Elasticsearch, păstrați logurile cu redundanță. Câte replici aveți?
Răspuns: O replică.
Întrebare: Asta este doar o replică?
Răspuns: Este un master și o replică. Datele sunt stocate în două exemplare.
Întrebare: Ați ajustat cumva dimensiunea bufferului Rsyslog?
Răspuns: Scriem datagrame într-un socket unix personalizat. Asta ne impune imediat o limitare de 128 kilobiți. Nu putem scrie mai mult de atât. Acest lucru este stipulat în standard. Cei care vor să intre în storaje, scriu 128 kilobiți. Bibliotecile, de altfel, taie mesajul și marchează faptul că mesajul a fost tăiat. În standardul mesajului nostru există un câmp special care arată dacă acesta a fost tăiat la scriere sau nu. Așadar, avem posibilitatea de a urmări și acest aspect.
Întrebare: Scrieți JSON-uri defecte?
Răspuns: JSON-ul defect va fi respins fie în timpul relay-ului, pentru că pachetul este prea mare. Fie va fi respins de Graylog, pentru că nu va putea să parseze JSON-ul. Dar aici sunt nuanțe care trebuie rezolvate, și acestea sunt în mare parte legate de rsyslog. Am deja câteva issue completate acolo, la care trebuie să mai lucrăm.
Întrebare: De ce Kafka? Ați încercat RabbitMQ? Nu se descurcă Graylog cu astfel de încărcări?
Răspuns: La noi nu funcționează cu Graylog. Dar Graylog-ul nostru funcționează. Este o chestiune complicată. De fapt, el nu este necesar. Aș prefera să scriu din rsyslog direct în elasticsearch și să vizualizez apoi în Kibana. Dar trebuie să rezolvăm problema cu cei de la securitate. Aceasta este o posibilă direcție de dezvoltare pentru noi, când vom elimina Graylog-ul și vom folosi Kibana. Nu ar avea sens să folosim Logstash. Pentru că, pot face toate acestea cu rsyslog. Și acesta are un modul pentru a scrie în elasticsearch. Cu Graylog încercăm cumva să coabităm. Chiar l-am optimizat puțin. Dar mai este loc pentru îmbunătățiri.
Despre Kafka. Așa a fost istoric. Când am venit, ea era deja acolo și se scriau deja jurnale în ea. Noi ne-am ridicat clusterele și am mutat log-urile în ea. Noi ne ocupăm de managementul său, știm cum se simte. Despre RabbitMQ... nu ne iese cu RabbitMQ. Pe de altă parte, RabbitMQ funcționează pentru noi. Avem în producție și au fost probleme cu el. Acum, înainte de vânzarea de reduceri, l-am optimizat și a început să funcționeze corect. Dar înainte de asta, nu mă simțeam pregătit să-l pun în producție. Mai este încă un aspect. Graylog poate citi versiunea AMQP 0.9, iar rsyslog poate scrie versiunea AMQP 1.0. Nu există nicio soluție care să poată gestiona ambele. Fie este una, fie cealaltă. Așadar, în acest moment, doar Kafka. Dar au și ele nuanțele lor. Pentru că omkafka la versiunea rsyslog pe care o folosim poate pierde tot buffer-ul de mesaje pe care l-a extras din rsyslog. Până acum ne-am adaptat la asta.
Întrebare: Folosiți Kafka pentru că era deja la voi? Nu este folosită pentru alte scopuri?
Răspuns: Kafka, care era, este folosită de echipa de Data Science. Este un proiect complet separat, despre care, din păcate, nu pot spune nimic. Nu sunt la curent. A fost în administrarea echipei de Data Science. Când au început să utilizeze log-uri, au decis să o folosească, pentru a nu fi nevoie să instaleze încă una. Acum am actualizat Graylog și compatibilitatea s-a pierdut, deoarece era o versiune veche de Kafka. A trebuit să ne configurăm propria versiune. De asemenea, ne-am desfăcut aceste patru subiecte pentru fiecare API. Am creat un subiect larg pentru tot live, un subiect larg pentru toate staging-urile și pur și simplu trimitem tot acolo. Graylog le extrage pe toate acestea în paralel.
Întrebare: De ce este necesară toată această magie cu socket-urile? Ați încercat să folosiți driverul log syslog pentru containere.
Răspuns: La acel moment când ne ocupam de această problemă, relația noastră cu Docker era tensioată. Era Docker 1.0 sau 0.9. Docker, în sine, era ciudat. În al doilea rând, dacă adăugăm și loguri în el... Am o suspiciune neconfirmată că acesta trece toate logurile prin el, prin demonul Docker. Dacă un API devine instabil, celelalte API-uri dau peste problema că nu pot trimite stdout și stderr. Nu știu unde va duce asta. Am o intuiție că nu ar trebui să folosim driverul syslog Docker în acest context. Departamentul nostru de testare funcțională are propriul cluster mic Graylog cu loguri. Ei folosesc driverele de loguri ale Docker-ului și se pare că la ei merge totul bine. Dar ei scriu GELF direct în Graylog. La acel moment, când am început totul, aveam nevoie să funcționeze pur și simplu. Poate mai târziu, când cineva va veni și va spune că funcționează bine de o sută de ani, vom încerca.
Întrebare: Faceți livrarea între centrele de date pe rsyslog. De ce nu pe Kafka?
Răspuns: Facem și așa, și așa, de fapt. Din două motive. Dacă canalul este complet distrus, atunci toate logurile noastre, chiar și în format comprimat, nu trec. Iar Kafka permite pur și simplu pierderea acestora în proces. Prin acest mod ne eliberăm de blocajele acestor loguri. Folosim direct Kafka în acest caz. Dacă avem un canal bun și vrem să-l eliberăm, atunci folosim rsyslog-ul. Dar, de fapt, se poate configura astfel încât să elimine automat ceea ce nu a trecut. În acest moment folosim livrarea rsyslog direct în unele locuri, iar în altele Kafka.
Sursa: habr.com
