

Introducere în sistemele de operare
Salut, Habr! Vreau să vă prezint o serie de articole-traduceri dintr-o literatură care mi se pare interesantă - OSTEP. Acest material examinează în mod profund funcționarea sistemelor de operare de tip unix, și anume - gestionarea proceselor, diferitele planificatoare, memorie și alte componente asemănătoare care formează un sistem de operare modern. Puteți vizualiza originalul tuturor materialelor aici . Vă rog să țineți cont că traducerea a fost efectuată neprofesional (destul de liber), dar sper că am păstrat sensul general.
Lucrările de laborator pentru această materie le puteți găsi aici:
Alte părți:
De asemenea, mă puteți urmări pe canalul meu de =)
Planificare: Coada de feedback multi-nivel
În această lecție vom discuta despre problemele dezvoltării uneia dintre cele mai cunoscute abordări de
planificare, care se numește Coada de feedback multi-nivel (MLFQ). Primul planificator MLFQ a fost descris în 1962 de Fernando J. Corbató în sistemul numit
Compatible Time-Sharing System (CTSS). Aceste lucrări (inclusiv lucrările ulterioare asupra
Multics) au fost apoi propuse pentru premiul Turing. Planificatorul a fost
ulterior îmbunătățit și a căpătat forma pe care o întâlnim deja în
unele sisteme moderne.
Algoritmul MLFQ încearcă să rezolve 2 probleme fundamentale intersectate.
În primul rând, încearcă să optimizeze timpul de rotație, care, așa cum am discutat în lecția anterioară, este optimizat prin metoda de a rula la începutul cozii cele mai
scurte sarcini. Cu toate acestea, sistemul de operare nu știe cât timp va funcționa un anumit proces, iar aceasta
este o cunoaștere necesară pentru funcționarea algoritmilor SJF, STCF. În al doilea rând, MLFQ încearcă
să facă sistemul receptiv pentru utilizatori (de exemplu, pentru cei care stau și
se uită la ecran așteptând finalizarea sarcinii) și astfel să minimizeze timpul
de răspuns. Din păcate, algoritmi precum RR reduc timpul de răspuns, dar afectează extrem de
tare metricile timpului de rotație. De aici problema noastră: Cum să proiectăm
un planificator care să răspundă cerințelor noastre și în același timp să nu știe nimic despre
care despre proces, în general? Cum va putea planificatorul să studieze caracteristicile sarcinilor pe care le rulează și, astfel, să ia decizii mai bune în ceea ce privește planificarea?
care le inițiază și, astfel, să ia decizii mai bune cu privire la planificare?
Esenta problemei: Cum să planifici stabilirea sarcinilor fără o cunoaștere perfectă?
Cum să dezvolți un planificator care simultan minimizează timpul de răspuns
pentru sarcini interactive și, în același timp, minimizează timpul de execuție fără a avea cunoștințe prealabile despre timpul de execuție al sarcinii?
Notă: învățăm pe baza evenimentelor anterioare
Coada MLFQ este un exemplu excelent de sistem care învață din
evenimentele trecute pentru a prezice viitorul. Astfel de abordări sunt deseori
întâlnite în sistemele de operare (și în multe alte domenii ale informaticii, inclusiv ramuri
de predicție în hardware și algoritmi de cache). Astfel de metode
sunt eficiente atunci când sarcinile au faze de comportament, făcându-le astfel predecibile.
Cu toate acestea, trebuie să fii precaut cu această tehnică, deoarece predicțiile pot fi foarte ușor
greșite, ceea ce poate conduce sistemul să ia decizii mai slabe decât ar fi fost fără cunoștințe.
MLFQ: Reguli de bază
Să examinăm regulile de bază ale algoritmului MLFQ. Deși există mai multe implementări ale acestui algoritm, abordările de bază sunt similare.
În implementarea pe care o vom analiza, MLFQ va avea mai multe
cozi separate, fiecare având un prioritate diferită. În orice moment,
o sarcină pregătită pentru execuție se află într-o coadă. MLFQ utilizează priorități
pentru a decide ce sarcină să fie executată, adică sarcina cu prioritatea mai mare
(sarcina din coada cu cea mai mare prioritate) va fi executată prima.
Desigur, într-o coadă specifică pot exista mai multe sarcini, astfel
încât acestea vor avea aceeași prioritate. În acest caz, se va folosi mecanismul
RR pentru a planifica execuția între aceste sarcini.
Astfel, ajungem la două reguli de bază pentru MLFQ:
Regula 1: Dacă prioritatea(A) > Prioritatea(B), sarcina A va fi executată (B nu va fi)
Regula 2: Dacă prioritatea(A) = Prioritatea(B), A și B sunt executate folosind RR
Având în vedere cele de mai sus, elementele cheie ale planificării MLFQ
sunt prioritățile. În loc să aloci o prioritate fixă fiecărei sarcini
- Regulă 1: Dacă prioritatea(A) > Prioritatea(B), va fi pornită sarcina A (B nu va fi)
- Regulă 2: Dacă prioritatea(A) = Prioritatea(B), A și B vor fi pornite folosind RR
Având în vedere cele de mai sus, elementele esențiale în planificarea MLFQ
sunt prioritățile. În loc să se stabilească o prioritate fixă fiecărei
în funcție de comportamentul observat, MLFQ își ajustează prioritatea.
De exemplu, dacă o sarcină suspendă constant procesul CPU așteptând input de la tastatură,
MLFQ va menține prioritatea procesului la un nivel ridicat, deoarece aceasta este comportamentul
așteptat pentru un proces interactiv. Pe de altă parte, dacă o sarcină folosește constant și
intens CPU timp de o perioadă lungă, MLFQ îi va scădea
prioritatea. Astfel, MLFQ va învăța comportamentul proceselor în timpul execuției lor
și va utiliza aceste comportamente.
Să dăm un exemplu despre cum ar putea arăta cozile la un anumit moment
de timp, rezultând ceva de genul acesta:
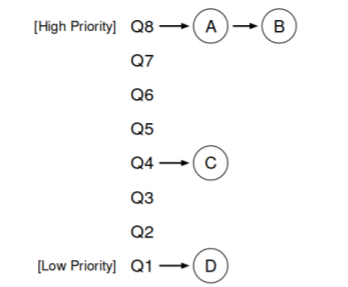
În acest diagramă, două procese A și B se află în coada cu cel mai înalt prioritate. Procesul
C se află undeva la mijloc, iar procesul D la sfârșitul cozii. Conform descrierilor de mai sus,
algoritmul MLFQ va executa sarcini doar cu cel mai înalt prioritate
conform RR, iar sarcinile C și D nu vor fi procesate.
Desigur, un snapshot static nu va oferi o imagine completă a modului în care funcționează MLFQ.
Este important să înțelegem cum se schimbă imaginea în timp.
Încercarea 1: Cum se schimbă prioritatea
În acest moment, este esențial să se decidă cum MLFQ va schimba nivelul de prioritate
al unei sarcini (și, astfel, poziția acesteia în coadă) pe parcursul ciclului său de viață. Pentru
acest lucru, este necesar să avem în vedere fluxul de lucru: un număr de
sarcini interactive cu timp scurt de execuție (și, prin urmare, o eliberare frecventă a
CPU) și câteva sarcini lungi care utilizează CPU în întreaga lor durată de execuție, unde
timpul de răspuns pentru aceste sarcini nu este important. Astfel, putem face prima încercare
de a implementa algoritmul MLFQ cu următoarele reguli:
- Regula 3: Când o sarcină intră în sistem, aceasta este plasată în coada cu cea mai mare
- prioritate.
- Regula 4a: Dacă sarcina utilizează întreaga fereastră de timp alocată, prioritatea ei
- este scăzută.
- Regula 4b: Dacă sarcina eliberează CPU înainte de expirarea ferestrei sale de timp, aceasta
- rămâne cu aceeași prioritate.
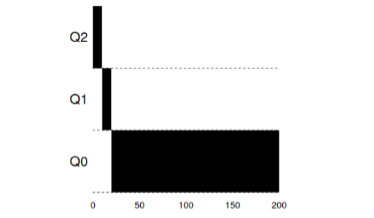
Exemplul 1: O sarcină lungă singulară
După cum se poate vedea în acest exemplu, sarcina este setată cu cea mai mare
prioritate la momentul sosirii. După o fereastră de timp de 10ms, prioritatea procesului este
scăzută de către planificator. După următoarea fereastră de timp, sarcina este, în sfârșit, scăzută la
prioritate scăzută în sistem, unde rămâne.
Exemplul 2: A fost livrată o sarcină scurtă
Acum să examinăm un exemplu despre cum MLFQ va încerca să se apropie de SJF. În acest
exemplu sunt două sarcini: A, care este o sarcină de lungă durată ce utilizează constant
CPU-ul și B, care este o sarcină scurtă și interactivă. Presupunem că
A a lucrat deja un timp până în momentul în care a apărut sarcina B.
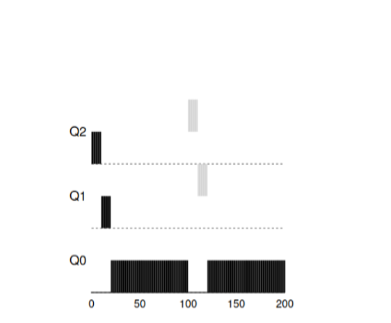
Pe acest grafic sunt vizibile rezultatele scenariului. Sarcina A, ca orice sarcină,
ce folosește CPU, s-a aflat în partea de jos. Sarcina B va sosi la timpul T=100 și va fi
plasată în coada cu prioritate maximă. Deoarece timpul său de execuție este scurt,
se va finaliza înainte de a ajunge în ultima coadă.
Din acest exemplu, trebuie să înțelegem scopul principal al algoritmului: de vreme ce algoritmul nu
știe dacă sarcina este lungă sau scurtă, la început presupune că sarcina
este scurtă și îi atribuie prioritate maximă. Dacă este într-adevăr o sarcină scurtă, atunci
se va finaliza rapid; altfel, dacă este o sarcină lungă, va coborî încet
în prioritate și în curând va demonstra că este într-adevăr o sarcină lungă, care nu
necesită răspuns.
Exemplul 3: Ce se întâmplă cu intrarea și ieșirea?
Acum să ne uităm la un exemplu cu intrare-ieșire. Așa cum a fost afirmat în regula 4b,
dacă un proces eliberează procesorul, fără a utiliza în totalitate timpul său de procesare,
atunci acesta rămâne pe același nivel de prioritate. Intențiile acestei reguli sunt destul de simple
— dacă o sarcină interactivă efectuează multe operații de intrare-ieșire, de exemplu, așteptând
apăsările utilizatorului de taste sau mouse, o astfel de sarcină va elibera procesorul
mai devreme decât perioada alocată. Nu dorim să scădem prioritățile unei astfel de sarcini,
astfel ea va rămâne pe același nivel.
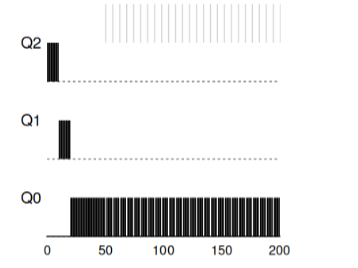
Acest exemplu arată cum va funcționa algoritmul cu astfel de procese—sarcina interactivă B, care are nevoie de CPU doar pentru 1ms înainte de a efectua
procesul de intrare-ieșire și sarcina lungă A, care își folosește tot timpul CPU-ul.
MLFQ menține procesul B cu prioritate maximă, deoarece eliberează constant
CPU-ul. Dacă B este o sarcină interactivă, algoritmul a atins
țelul său de a lansa rapid sarcinile interactive.
Problemele cu algoritmul MLFQ de actualitate
În exemplele anterioare, am construit o variantă de bază a MLFQ. Și se pare că aceasta
își face treaba bine și corect, distribuind timpul de procesare între
sarcinile lungi și permițând sarcinilor scurte sau celor care fac mult
input-output să se execute rapid. Din păcate, această abordare conține mai multe
probleme serioase.
În primul rând, problema foametei: dacă în sistem există multe sarcini interactive,
cele vor consuma tot timpul procesorului, astfel încât nicio sarcină lungă
nu va avea șansa să se execute (vor fi înfometate).
În al doilea rând, utilizatorii pricepuți ar putea scrie programele lor astfel încât
să păcălească planificatorul. Păcălul constă în a face ceva pentru a determina
planificatorul să aloce mai mult timp de procesare. Algoritmul care
a fost descris mai sus este destul de vulnerabil la astfel de atacuri: înainte ca fereastra de timp să se încheie
, trebuie să efectuezi o operațiune de input-output (către un fișier, nu contează care)
și astfel să eliberezi CPU-ul. Un astfel de comportament va permite să rămâi în aceeași
coadă și să obții iarăși un procent mai mare din timpul procesorului. Dacă faci
asta corect (de exemplu, să te execuți 99% din timpul ferestrei înainte de a elibera CPU-ul),
o astfel de sarcină va putea monopoliza pur și simplu procesorul.
În cele din urmă, programul își poate schimba comportamentul în timp. Sarcinile
care au folosit CPU-ul pot deveni interactive. În exemplul nostru, astfel de
sarcini nu vor primi tratamentul adecvat din partea planificatorului, așa cum ar fi primit alte
(inițiale) sarcini interactive.
Întrebare pentru sală: ce atacuri asupra planificatorului s-ar putea realiza în lumea modernă?
Încercarea 2: Creșterea priorității
Să încercăm să schimbăm regulile și să vedem dacă putem evita problemele de
foamete. Ce am putea face pentru a garanta că sarcinile legate de
CPU primesc timpul lor (chiar dacă nu pentru mult timp).
Ca o soluție simplă la problemă, s-ar putea propune creșterea periodică
a priorității tuturor acestor sarcini din sistem. Există multe moduri
de a atinge asta, să încercăm să implementăm, ca exemplu, ceva simplu: să
schimbăm toate sarcinile la cea mai înaltă prioritate, de aici noua regulă:
- Rule5: După un anumit timp, S va traduce toate sarcinile din sistem în cea mai înaltă prioritate.
Noua noastră regulă rezolvă două probleme deodată. În primul rând, procesele
nu vor suferi de foame: sarcinile aflate în cea mai înaltă prioritate vor împărți
timpul de procesor conform algoritmului RR și astfel toate procesele vor primi
timp de procesor. În al doilea rând, dacă un anumit proces, care anterior utiliza
doar procesorul, devine interactiv, acesta va rămâne în coada cu cea mai înaltă
prioritate după ce a obținut o dată o creștere a priorității la maxim.
Să luăm un exemplu. În acest scenariu, să considerăm un proces care utilizează
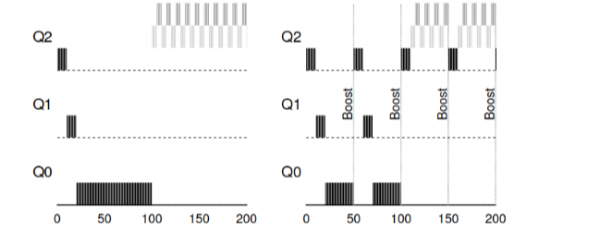
CPU și două procese interactive, scurte. În stânga, imaginea arată comportamentul fără o creștere a priorității, iar astfel sarcina lungă începe să sufere de foame după sosirea a două sarcini interactive în sistem. În dreapta, fiecare 50ms are loc o creștere a priorității, astfel toate procesele primesc garantat timp de procesor și vor fi lansate periodic. 50ms este doar un exemplu; în realitate, acest număr este puțin mai mare.
Este evident că adăugarea timpului periodic de creștere S duce la
o întrebare inevitabilă: ce valoare ar trebui setată? Unul dintre inginerii de sisteme respectați, John Ousterhout, numea astfel de valori în sisteme ca fiind constante voo-doo
, deoarece ele necesitau cumva magie neagră pentru a fi setate corect. Și, din păcate, S are această aromă. Dacă setăm o valoare prea mare — sarcinile lungi vor începe să sufere de foame. Dacă setăm o valoare prea mică,
sarcinile interactive nu vor primi suficient timp de procesor.
Încercarea 3: Cea mai bună contabilitate
Acum avem o altă problemă de rezolvat: cum să nu permitem să ne înșele planificatorul? Responsabilele pentru această posibilitate sunt
regulile 4a, 4b, care permit sarcinii să-și păstreze prioritatea, eliberând procesorul
până la expirarea timpului alocat. Cum putem gestiona acest lucru?
O soluție în acest caz ar putea fi cea mai bună contabilitate a timpului CPU la fiecare
nivel MLFQ. În loc să uităm timpul pe care programul l-a folosit.
regula 4a, 4b, care permite sarcinii să-și mențină prioritatea, eliberând procesorul
până la expirarea timpului alocat. Cum ne descurcăm cu asta?
Soluția în acest caz poate fi considerată cea mai bună contabilizare a timpului CPU la fiecare
nivel MLFQ. În loc să uităm timpul pe care programul l-a consumat
Când un proces a consumat timpul alocat, acesta trebuie luat în considerare și păstrat. După ce
procesul a consumat timpul alocat, acesta trebuie să fie redus la următorul
nivel de prioritate. Acum nu mai contează cum procesul își va utiliza timpul — fie că
este un proces constant pe CPU sau multiple apeluri. Astfel,
regula 4 trebuie rescrisă după cum urmează:
- Regula4: După ce o sarcină a consumat timpul alocat în coada curentă (indiferent de câte ori a eliberat CPU-ul), prioritatea unei astfel de sarcini este redusă (se mută în jos în coadă).
Să ne uităm la un exemplu:
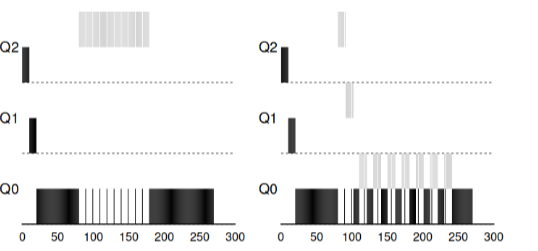 »
Imaginea arată ce se întâmplă dacă încercăm să păcălim planificatorul, așa cum
ar fi fost cu regulile anterioare 4a, 4b, rezultatul va fi pe stânga. Cu noua
regulă — rezultatul va fi pe dreapta. Până la activarea protecției, orice proces putea să efectueze I/O până la finalizare și
astfel să domine CPU-ul, după activarea protecției, indiferent de comportamentul
I/O, acesta va fi totuși scos în jos în coadă, și astfel nu va putea să obțină în mod necinstit
resursele CPU-ului.
Îmbunătățind MLFQ și alte probleme
Cu îmbunătățirile de mai sus, apar noi probleme: una dintre principalele
întrebări este cum să parametram un astfel de planificator? Adică, câte
cozi ar trebui să existe? Care ar trebui să fie dimensiunea feronului de lucru al programului în cadrul cozii? Cât
de des ar trebui să fie crescut prioritatea programului pentru a evita foametea și
a lua în considerare schimbarea comportamentului programului? La aceste întrebări, nu există un răspuns simplu
și doar experimentarea cu sarcini și configurarea ulterioară a
planificatorului poate duce la un anumit echilibru satisfăcător.
De exemplu, cele mai multe implementări MLFQ permit alocarea de intervale de timp diferite
pentru diferite cozi. Cozile de prioritate superioară primesc de obicei
intervale scurte. Aceste cozi constau din sarcini interactive,
între care comutarea este destul de sensibilă și ar trebui să dureze 10 milisecunde sau mai puțin.
În contrast, cozile de prioritate inferioară sunt compuse din sarcini lungi care folosesc
CPU. Și în acest caz, intervalele lungi se potrivesc foarte bine (100 ms).
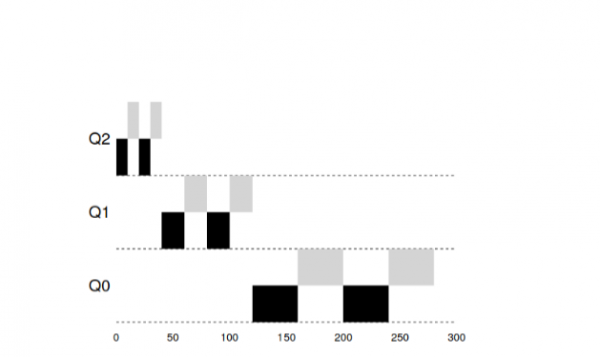
În acest exemplu, există 2 sarcini care au funcționat în coada de prioritate superioară 20
ms, împărțite în feronerie de 10ms. 40ms în coada medie (fereastra de 20ms) și în cea de prioritate scăzută
coada, fereastra temporară a devenit 40ms, unde sarcinile și-au finalizat activitatea.
Implementarea MLFQ în sistemul de operare Solaris — un tip de planificator care împarte timpul.
Planificatorul oferă un set de tabele care definesc exact cum ar trebui
să se schimbe prioritatea procesului pe parcursul vieții sale, care ar trebui să fie dimensiunea
feroneriilor alocate și cât de des trebuie să fie crescute prioritățile sarcinii. Administratorul
sistemului poate interacționa cu această tabelă și poate obliga planificatorul să se comporte
diferit. Prin implicit, în această tabelă există 60 de cozi cu o creștere treptată
a dimensiunii feroneriilor de la 20ms (prioritate mare) până la câteva sute de ms (prioritate scăzută), precum
și cu un boost al tuturor sarcinilor o dată pe secundă.
Alte planificatoare MLFQ nu utilizează tabele sau reguli clare
care sunt descrise în această lecție, dimpotrivă, ele calculează prioritățile folosind
formule matematice. De exemplu, planificatorul din FreeBSD utilizează o formulă pentru
calcularea priorității curente a sarcinii, bazată pe cât de mult procesul
a utilizat CPU. În plus, utilizarea CPU se deteriorează în timp, și astfel
creșterea priorității se face oarecum diferit față de cele descrise mai sus. Acestea sunt
așa-numitele algoritmi de decay. Începând cu versiunea 7.1, FreeBSD utilizează planificatorul ULE.
În cele din urmă, mulți planificatori au alte caracteristici. De exemplu, unii
planificatori rezervează cele mai înalte level-uri pentru funcționarea sistemului de operare, astfel
încât nicio aplicație utilizator nu va putea obține cea mai înaltă prioritate în
sistem. Unele sisteme permit oferirea de sugestii pentru a ajuta
planificatorul să stabilească corect prioritățile. De exemplu, cu ajutorul comenzii nice
se poate crește sau scădea prioritatea unei sarcini, sporind sau
reducând astfel șansele programului la timpul de procesare.
MLFQ: Concluzii
Am descris o abordare de planificare, care se numește MLFQ. Numele său
este bazat pe principiul de funcționare — are mai multe cozi și utilizează feedback-ul
pentru a determina prioritatea sarcinii.
Aspectul final al regulilor va fi următorul:
- Regula 1: Dacă prioritatea(A) > Prioritatea(B), sarcina A va fi lansată (B nu va fi)
- Regula 2: Dacă prioritatea(A) = Prioritatea(B), A și B sunt lansate folosind RR
- Regula3: Când o sarcină ajunge în sistem, aceasta este plasată în coada cu cea mai înaltă prioritate.
- Regula4: După ce o sarcină a consumat timpul alocat în coada curentă (indiferent de câte ori a eliberat CPU-ul), prioritatea unei astfel de sarcini este redusă (se mută în jos în coadă).
- Rule5: După un anumit timp, S va traduce toate sarcinile din sistem în cea mai înaltă prioritate.
MLFQ este interesant din următorul motiv — în loc să necesite cunoașterea despre
natura sarcinii dinainte, algoritmul învață comportamentul trecut al sarcinii și stabilește
prioritățile în mod corespunzător. Astfel, încearcă să se mențină pe două scaune — să atingă performanța pentru sarcini mici (SJF, STCF) și să ruleze corect sarcinile lungi,
cele care solicită CPU. De aceea, multe sisteme, inclusiv BSD și derivatele lor,
Solaris, Windows, Mac folosesc ca planificator o anumită formă a algoritmului
MLFQ ca bază fundamentală.
Materiale suplimentare:
- (computing)
Sursa: habr.com
