

Bună ziua, prieteni. Înainte de a pleca la a doua parte a sărbătorilor de mai, împărtășim cu voi un material pe care l-am tradus înainte de lansarea unui nou curs .
Dezvoltatorii de aplicații petrec mult timp comparând mai multe baze de date operaționale pentru a alege cea mai potrivită pentru sarcina de lucru preconizată. Nevoile pot include modelarea datelor simplificată, garanții de tranzacție, performanță de citire/scriere, scalabilitate orizontală și disponibilitate. De obicei, selecția începe cu categoria bazei de date, SQL sau NoSQL, deoarece fiecare categorie oferă un set clar de compromisuri. Performanța ridicată în termeni de latență redusă și lățime de bandă mare este adesea considerată o cerință fără compromisuri și, prin urmare, este necesară pentru orice bază de date din selecție.
Scopul acestui articol este de a ajuta dezvoltatorii de aplicații să facă alegerea corectă între SQL și NoSQL în contextul modelării datelor aplicației. Vom examina o bază de date SQL, și anume PostgreSQL, și două baze de date NoSQL – Cassandra și MongoDB, pentru a vorbi despre principiile fundamentale ale proiectării bazelor de date, cum ar fi crearea de tabele, completarea acestora, citirea datelor din tabel și ștergerea acestora. În articolul următor, vom aborda cu siguranță indexurile, tranzacțiile, JOIN-urile, directivele TTL și proiectarea bazelor de date pe baza JSON.
Care este diferența dintre SQL și NoSQL?
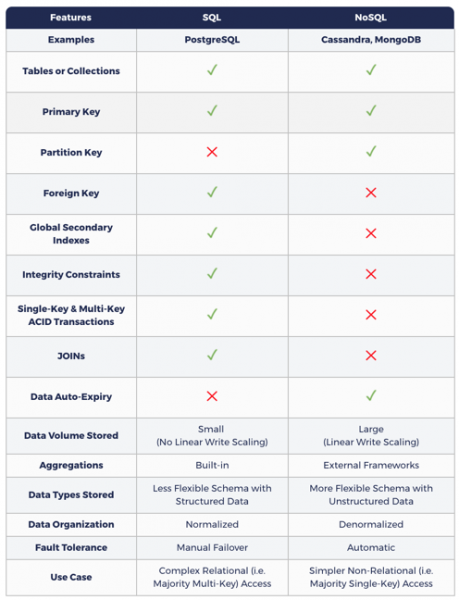
Bazele de date SQL îmbunătățesc flexibilitatea aplicației datorită garanțiilor tranzacționale ACID, precum și a capacității de a interoga datele prin JOIN în moduri neașteptate peste modelele normalizate existente ale bazelor de date relaționale.
Având în vedere arhitectura lor monolitică/pe un singur nod și utilizarea modelului de replicare master-slave pentru redundanță, bazele de date SQL tradiționale nu au două caracteristici importante - scalabilitatea liniară a scrierilor (adică partajarea automată pe mai multe noduri) și pierderile de date automate/nule. Aceasta înseamnă că volumul de date primite nu poate depăși capacitatea maximă de scriere a unui singur nod. În plus, o anumită pierdere temporară de date trebuie considerată în cazul rezilienței la defecțiuni (în arhitectura fără separarea resurselor). Aici trebuie să ai în vedere că tranzacțiile recente nu s-au reflectat încă în copia secundară (slave). Actualizările fără downtime sunt de asemenea greu de realizat în bazele de date SQL.
Bazele de date NoSQL sunt, prin natura lor, de obicei distribuite, adică datele sunt împărțite în secțiuni și repartizate pe mai multe noduri. Acestea necesită denormalizare. Acest lucru înseamnă că datele introduse trebuie de asemenea copiate de mai multe ori pentru a răspunde la cererile specifice pe care le trimiteți. Obiectivul general este de a obține o performanță înaltă prin reducerea numărului de shard-uri disponibile în timpul citirii. De aici decurge afirmația că NoSQL necesită să îți modelezi cererile, în timp ce SQL necesită să îți modelezi datele.
NoSQL se concentrează pe atingerea unei performanțe ridicate într-un cluster distribuit și acesta este principalul motiv pentru mai multe compromisuri de design ale bazelor de date, care includ pierderea garanțiilor de tranzacție ACID, JOIN-uri și indexuri secundare globale consistente.
Există o opinie că, deși bazele de date NoSQL oferă scalabilitate liniară a scrierilor și o reziliență ridicată, pierderea garanțiilor de tranzacție le face nepracticabile pentru datele critice.
Tabelul următor arată cum se diferă modelarea datelor în NoSQL față de SQL.
SQL și NoSQL: De ce avem nevoie de ambele?
Aplicațiile reale cu un număr mare de utilizatori, cum ar fi Amazon.com, Netflix, Uber și Airbnb, efectuează sarcini complexe și variate. De exemplu, o aplicație de comerț electronic asemănătoare cu Amazon.com trebuie să stocheze date ușoare, foarte critice, cum ar fi informațiile despre utilizatori, produse, comenzi și facturi, alături de date mai grele, dar mai puțin sensibile, cum ar fi recenziile produselor, mesajele de suport tehnic, activitatea utilizatorilor, feedback-ul și recomandările utilizatorilor. În mod firesc, aceste aplicații se bazează pe cel puțin o bază de date SQL împreună cu cel puțin o bază de date NoSQL. În sistemele interregionale și globale, baza de date NoSQL funcționează ca un cache georepartizat pentru datele stocate într-o sursă de încredere, baza de date SQL care funcționează într-o anumită regiune.
Cum combină YugaByte DB SQL și NoSQL?
Construit pe un motor mixt orientat pe jurnal pentru stocare, sharding automat, replicare distribuită cu consens sharding și tranzacții ACID distribuite (inspirate de Google Spanner), YugaByte DB este prima bază de date open-source din lume care este compatibilă în același timp cu NoSQL (Cassandra & Redis) și SQL (PostgreSQL). Așa cum se arată în tabelul de mai jos, YCQL, API-ul YugaByte DB compatibil cu Cassandra, adaugă conceptele de tranzacții ACID cu un singur și mai multe chei și indecși secundari globala în API-ul NoSQL, deschizând astfel o eră a bazelor de date NoSQL tranzacționale. În plus, YCQL, API-ul YugaByte DB compatibil cu PostgreSQL, adaugă conceptele de scalabilitate liniară a scrierii și redundanță automată la API-ul SQL, oferind lumii baze de date distribuite SQL. Deoarece baza de date YugaByte DB este în esență tranzacțională, API-ul NoSQL poate fi acum utilizat în contextul datelor critice.
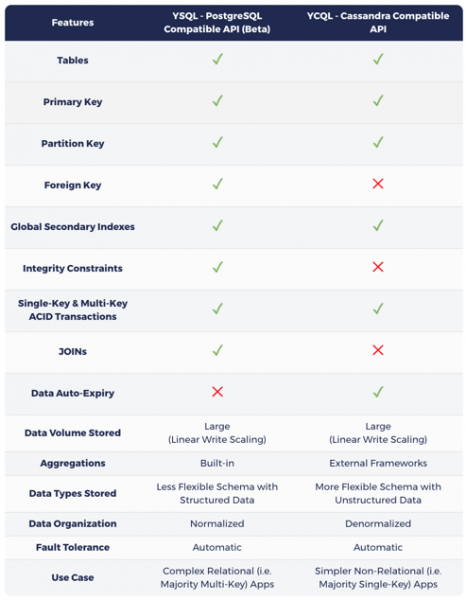
Așa cum s-a menționat anterior în articol , alegerea între SQL sau NoSQL în YugaByte DB depinde complet de caracteristicile sarcinii de lucru principale:
- Dacă sarcina principală de lucru implică operațiuni cu mai multe chei cu JOIN-uri, atunci când alegeți YSQL, trebuie să înțelegeți că cheile dumneavoastră pot fi distribuite pe mai multe noduri, ceea ce va duce la o întârziere mai mare și/sau o capacitate mai mică decât în cazul NoSQL.
- În caz contrar, alegeți oricare dintre cele două API NoSQL, având în vedere că veți obține o performanță mai bună ca urmare a interogărilor gestionate de un singur nod deodată. YugaByte DB poate servi ca o bază de date operațională unică pentru aplicații complexe reale, în care este necesară gestionarea simultană a mai multor sarcini de lucru.
La baza laboratorului de modelare a datelor (Data modeling lab) din secțiunea următoare se află bazele de date YugaByte DB compatibile cu PostgreSQL și Cassandra, spre deosebire de bazele de date de bază. Această abordare subliniază simplitatea interacțiunii cu cele două API diferite (pe două porturi diferite) ale aceleași clustere de baze de date, spre deosebire de utilizarea clusterelor complet independente ale celor două baze de date diferite.
În secțiunile următoare, ne vom familiariza cu laboratorul de modelare a datelor, pentru a ilustra diferențele și unele trăsături comune ale bazelor de date discutate.
Laboratorul de modelare a datelor
Instalarea bazelor de date
Având în vedere accentul pe proiectarea modelului de date (și nu pe arhitecturi complexe de desfășurare), vom instala bazele de date în containere Docker pe computerul local și apoi vom interacționa cu ele folosind shell-urile de comandă corespunzătoare.
Baza de date YugaByte DB compatibilă cu PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestAcces prin linia de comandă
Să ne conectăm la bazele de date, folosind shell-ul de comandă pentru API-urile corespunzătoare.
PostgreSQL
— este shell-ul de comandă pentru interacțiunea cu PostgreSQL. Pentru ușurința utilizării, YugaByte DB vine cu psql direct în folderul bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— este shell-ul de comandă pentru interacțiunea cu Cassandra și bazele sale de date compatibile prin CQL (limbajul de interogare Cassandra). Pentru confortul utilizării, YugaByte DB vine cu cqlsh în catalogul bin.
Rețineți că CQL a fost inspirat de SQL și are concepte similare de tabele, rânduri, coloane și indecși. Totuși, ca limbaj NoSQL, adaugă un set specific de restricții, majoritatea dintre care le vom discuta și în alte articole.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– este un shell de comandă pentru interacțiunea cu MongoDB. Poate fi găsit în directorul bin al instalării MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Crearea tabelului
Acum putem interacționa cu baza de date pentru a efectua diverse operațiuni folosind linia de comandă. Să începem cu crearea unui tabel care stochează informații despre melodii scrise de diferiți artiști. Aceste melodii pot face parte dintr-un album. De asemenea, atributele opționale pentru melodie sunt: anul lansării, prețul, genul și ratingul. Trebuie să luăm în considerare atributele suplimentare care ar putea fi necesare în viitor, prin câmpul "etichete". Acesta poate stoca date semi-structurate sub formă de perechi cheie-valoare.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Crearea tabelului în Cassandra este foarte similară cu PostgreSQL. Una dintre principalele diferențe este absența constrângerilor de integritate (de exemplu, NOT NULL), dar aceasta intră în responsabilitatea aplicației, nu a bazei de date NoSQL.. Cheia primară constă din cheia de partiționare (coloana Artist în exemplul de mai jos) și un set de coloane de clasificare (coloana SongTitle în exemplul de mai jos). Cheia de partiționare determină în ce partiție/shard să fie plasată linia, iar coloanele de clasificare indică modul în care datele ar trebui să fie organizate în cadrul shard-ului actual.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organizează datele în baze de date (Database) (similar cu Keyspace în Cassandra), unde există colecții (Collections) (similar cu tabelele), în care se află documente (Documents) (similar cu rândurile din tabel). În MongoDB nu este necesară definiția unei scheme inițiale. Comanda "use database", prezentată mai jos, creează un exemplar de bază de date la prima apelare și schimbă contextul pentru noua bază de date creată. Chiar și colecțiile nu trebuie create explicit, acestea sunt create automat, pur și simplu adăugând primul document într-o nouă colecție. Rețineți că MongoDB folosește în mod implicit baza de date de testare, așa că orice operațiune la nivel de colecție fără specificarea unei baze de date concrete va fi efectuată în aceasta în mod implicit.
use myNewDatabase;Obținerea informațiilor despre tabel
PostgreSQL
d Music
Table "public.music"
    Column    |         Type          | Collation | Nullable | Default
--------------+-----------------------+-----------+----------+--------
 artist       | character varying(20) |           | not null |
 songtitle    | character varying(30) |           | not null |
 albumtitle   | character varying(25) |           |          |
 year         | integer               |           |          |
 price        | double precision      |           |          |
 genre        | character varying(10) |           |          |
 criticrating | double precision      |           |          |
 tags         | text                  |           |          |
Indexes:
    "music_pkey" PRIMARY KEY, btree (artist, songtitle)
Cassandra
DESCRIBE TABLE MUSIC;
CREATE TABLE myapp.music (
    artist text,
    songtitle text,
    albumtitle text,
    year int,
    price float,
    genre text,
    tags text,
    PRIMARY KEY (artist, songtitle)
) WITH CLUSTERING ORDER BY (songtitle ASC)
    AND default_time_to_live = 0
    AND transactions = {'enabled': 'false'};
MongoDB
use myNewDatabase;
show collections;
Introducerea datelor în tabel
PostgreSQL
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Year, Price, Genre, CriticRating,
    Tags)
VALUES(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre, CriticRating)
VALUES(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre)
VALUES(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre,
    Tags)
VALUES(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
În general, expresia INSERT în Cassandra arată foarte similară cu cea din PostgreSQL. Cu toate acestea, există o diferență mare în semantica. În Cassandra INSERT este de fapt o operațiune UPSERT, unde ultimele valori sunt adăugate în rând, în cazul în care rândul există deja.
Introducerea datelor se face similar cu PostgreSQL
INSERTmai sus
.
MongoDB
Deși MongoDB este o bază de date NoSQL, similar cu Cassandra, operațiunea de introducere a datelor nu are nimic în comun cu comportamentul semantic din Cassandra. În MongoDB nu are capabilități UPSERT, ceea ce îl face similar cu PostgreSQL. Adăugarea de date implicit fără _idspecified va duce la adăugarea unui nou document în colecție.
db.music.insert( {
 artist: "Nimeni pe care nu-l cunoști",
 songTitle: "Sună-mă astăzi",
 albumTitle: "Cunoscut pe alocuri",
 year: 2015,
 price: 2.14,
 genre: "Țară",
 tags: {
 Compozitori: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Nimeni pe care nu-l cunoști",
 songTitle: "Câinele meu Spot",
 albumTitle: "Hei, acum",
 price: 1.98,
 genre: "Țară",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "Trupa Acme",
 songTitle: "Fii atent, lume",
 albumTitle:"Banii încep aici",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "Trupa Acme",
 songTitle: "Încă îndrăgostit",
 albumTitle:"Banii încep aici",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Intensiv"
 }
 }
 );
Interogarea tabelului
Probabil, cea mai semnificativă diferență între SQL și NoSQL din punct de vedere al formulărilor interogărilor constă în utilizarea formulărilor FROM și WHERE. SQL permite, după expresie, selectarea mai multor tabele, iar expresia cu FROM poate avea orice complexitate (inclusiv operații WHERE între tabele). Cu toate acestea, NoSQL tinde să impună o restricție strictă asupra JOIN , funcționând doar cu un singur tabel specificat., iar în FROMși să lucrezi doar cu o singură tabelă specificată, iar în WHERE, trebuie întotdeauna să fie specificat cheia primară. Aceasta se datorează dorinței de a îmbunătăți performanța NoSQL, despre care am discutat anterior. Această dorință conduce la o reducere a oricărei interacțiuni între tabele și chei. Poate duce la întârzieri mari în comunicarea între noduri atunci când se răspunde la o cerere și, prin urmare, este cel mai bine să fie evitat în principiu. De exemplu, Cassandra impune ca interogările să fie restricționate la anumite operatori (sunt permise doar =, IN, , =>, <=) pe cheile de partiție, cu excepția cazurilor de interogare a indexului secundar (unde este permis doar operatorul =).
PostgreSQL
Mai jos sunt trei exemple de interogări care pot fi executate cu ușurință de o bază de date SQL.
- Afișează toate melodiile artistului;
- Afișează toate melodiile artistului care corespund primei părți a titlului;
- Afișează toate melodiile artistului care au un anumit cuvânt în titlu și au un preț mai mic de 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Dintre interogările enumerate mai sus, doar prima va funcționa în Cassandra fără modificări, deoarece operatorul LIKE nu poate fi aplicat coloanelor de clustering, cum ar fi SongTitle. În acest caz, sunt permise doar operatorii = și IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Așa cum s-a arătat în exemplele anterioare, principala metodă de a crea interogări în MongoDB este . Această metodă conține explicit numele colecției (music în exemplul de mai jos), așa că interogările pe mai multe colecții sunt interzise.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Citirea tuturor rândurilor din tabel
Citirea tuturor rândurilor este pur și simplu un caz particular al modelului de interogare pe care l-am discutat anterior.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Similar cu exemplul din PostgreSQL de mai sus.
MongoDB
db.music.find( {} );Editarea datelor din tabel
PostgreSQL
PostgreSQL oferă instrucțiunea UPDATE pentru modificarea datelor. Aceasta nu are funcționalitățile UPSERT, astfel încât executarea acestei instrucțiuni va cauza o eroare, în cazul în care rândurile nu mai există în baza de date.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
În Cassandra există UPDATE un echivalent cu PostgreSQL. UPDATE are aceeași semnificație UPSERT, similar cu INSERT.
Similar cu exemplul din PostgreSQL de mai sus.
MongoDB
Operația În MongoDB, poți actualiza în totalitate un document existent sau doar anumite câmpuri. Implicit, actualizează doar un document cu semantica dezactivată. UPSERT. Actualizarea mai multor documente are un comportament similar. UPSERT Acest lucru se poate aplica, setând flag-uri suplimentare pentru operațiune. De exemplu, în exemplul de mai jos, se actualizează genul unui artist specific pe baza melodiei sale.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Ștergerea datelor din tabel.
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Similar cu exemplul din PostgreSQL de mai sus.
MongoDB
În MongoDB există două tipuri de operațiuni pentru ștergerea documentelor — și . Ambele tipuri șterg documente, dar returnează rezultate diferite.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Ștergerea tabelului.
PostgreSQL
DROP TABLE Music;Cassandra
Similar cu exemplul din PostgreSQL de mai sus.
MongoDB
db.music.drop();Concluzie
Discuțiile despre alegerea între SQL și NoSQL bântuie de mai bine de 10 ani. Există două aspecte principale ale acestei controverse: arhitectura nucleului bazei de date (SQL monolitic, tranzacțional împotriva NoSQL distribuit, netransacțional) și abordarea proiectării bazei de date (modelarea datelor în SQL împotriva modelării interogărilor tale în NoSQL).
Cu o bază de date distribuită tranzacțională, cum ar fi YugaByte DB, dezbaterile cu privire la arhitectura bazei de date pot fi ușor dissipate. Pe măsură ce volumele de date depășesc ceea ce poate fi scris pe un singur nod, o arhitectură complet distribuită, care susține scalabilitatea liniară a scrierii cu shard-uri și rebalansare automate, devine necesară.
Pe lângă ceea ce este spus într-unul dintre articolele , arhitecturile tranzacționale, stricte și corelate, sunt acum utilizate pe scară largă pentru a oferi o mai bună flexibilitate în dezvoltare decât arhitecturile netransacționale, în cele din urmă corelate.
Revenind la discuția despre proiectarea bazelor de date, este corect să spunem că ambele abordări de proiectare (SQL și NoSQL) sunt necesare pentru orice aplicație complexă din lumea reală. Abordarea SQL „modelarea datelor” permite dezvoltatorilor să răspundă mai ușor cerințelor de afaceri în continuă schimbare, în timp ce abordarea NoSQL „modelarea interogărilor” le permite acelorași dezvoltatori să opereze cu volume mari de date având latență mică și capacitate mare de procesare. Tocmai din acest motiv, YugaByte DB oferă API-uri SQL și NoSQL într-un nucleu comun, fără a promova o abordare în detrimentul celeilalte. În plus, asigurând compatibilitatea cu cele mai populare limbaje de baze de date, inclusiv PostgreSQL și Cassandra, YugaByte DB garantează că dezvoltatorii nu vor trebui să învețe un alt limbaj pentru a lucra cu nucleul de date distribuite și strict consistente.
În acest articol, am analizat cum se diferențiază principiile de bază ale proiectării bazelor de date în PostgreSQL, Cassandra și MongoDB. În articolele următoare, ne vom aprofunda în conceptele avansate de proiectare, cum ar fi indexurile, tranzacțiile, JOIN-urile, directivele TTL și documentele JSON.
Îți dorim un weekend minunat și te invităm la , care va avea loc pe 14 mai.
Sursa: habr.com
