

Piața calculului distribuit și a big data, dacă este să credem , crește cu 18-19% anual. Asta înseamnă că alegerea software-ului pentru aceste scopuri rămâne un subiect actual. În această postare vom începe cu necesitatea calculului distribuit, vom detalia alegerea software-ului, vom discuta despre aplicarea Hadoop prin intermediul Cloudera și, în final, vom vorbi despre alegerea hardware-ului și cum acesta influențează performanța în diverse moduri.
De ce este nevoie de calcul distribuit în afacerile obișnuite? Aici totul este simplu și complicat în același timp. Simplu - deoarece, în cele mai multe cazuri, realizăm calcule relativ simple pe unitate de informație. Complicat - deoarece astfel de informații sunt foarte multe. Extrem de multe. Drept urmare, trebuie . Astfel, scenariile de utilizare sunt destul de universale: calculele pot fi aplicate oriunde unde este nevoie de un număr mare de metrici pe un set de date și mai mare.
Unul dintre exemplele recente: rețeaua de pizzerii Dodo Pizza pe baza analizei bazei de date a comenzilor clienților, care a arătat că, atunci când aleg o pizza cu umplutură aleatorie, utilizatorii de obicei operează doar cu șase seturi de ingrediente de bază plus câteva aleatorii. În consecință, pizzeria și-a adaptat achizițiile. În plus, a reușit să recomande mai bine utilizatorilor produse suplimentare oferite în timpul comenzii, ceea ce a permis creșterea profitului.
Încă un exemplu: reducerea numărului de articole a permis magazinului H&M să scadă sortimentul în anumite magazine cu 40%, menținând în același timp nivelul vânzărilor. Acest lucru a fost realizat prin eliminarea articolelor cu vânzări slabe, având în vedere sezonalitatea în calcule.
Alegerea instrumentului
Standardul industrial pentru acest tip de calcul este Hadoop. De ce? Pentru că Hadoop este un cadru excelent, bine documentat (același Habr publică o mulțime de articole detaliate pe acest subiect), însoțit de un set de utilitare și biblioteci. Puteți introduce seturi uriașe de date atât structurate, cât și nestructurate, iar sistemul le va distribui între puterile de calcul. În plus, aceste puteri pot fi extinse sau dezactivate în orice moment - aceasta este scalabilitatea orizontală în acțiune.
În 2017, compania de consultanță influentă Gartner , că Hadoop își va pierde relevanța în curând. Motivul este destul de banal: analiștii consideră că companiile vor migra masiv în cloud, deoarece acolo vor putea plăti în funcție de utilizarea puterii de calcul. Al doilea factor important care ar putea „îngropa” Hadoop este viteza de lucru. Deoarece soluții precum Apache Spark sau Google Cloud DataFlow funcționează mai repede decât MapReduce, pe care se bazează Hadoop.
Hadoop se bazează pe câteva fundații, cele mai notabile dintre ele fiind tehnologiile MapReduce (sistem de distribuție a datelor pentru calcul între servere) și sistemul de fișiere HDFS. Acesta din urmă este destinat în mod special stocării informației distribuite între nodurile clusterului: fiecare bloc de dimensiune fixă poate fi plasat pe mai multe noduri, iar prin replicare se asigură rezistența sistemului la defectarea unor noduri individuale. În locul unei tabeli de fișiere se folosește un server special numit NameNode.
În ilustrația de mai jos este prezentată schema de funcționare a MapReduce. În prima etapă, datele sunt împărțite după un anumit criteriu, în a doua - sunt repartizate pe puterile de calcul, iar în a treia - se efectuează calculul.
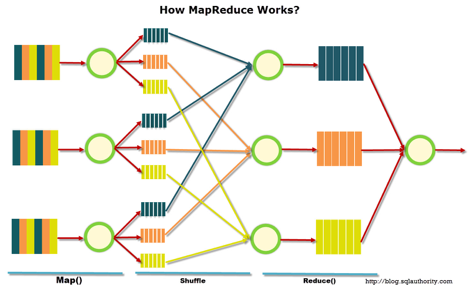
Inițial, MapReduce a fost creat de Google pentru necesitățile căutării sale. Apoi, MapReduce a devenit liber și proiectul a fost preluat de Apache. Între timp, Google a migrat către alte soluții. Un detaliu interesant: în prezent, Google are un proiect numit Google Cloud Dataflow, poziționat ca următorul pas după Hadoop, ca o înlocuire rapidă.
La o examinare mai atentă, se observă că Google Cloud Dataflow se bazează pe o variantă a Apache Beam, iar în Apache Beam este inclus un cadru bine documentat Apache Spark, ceea ce permite afirmarea că viteza de execuție a soluțiilor este aproape identică. Iar Apache Spark funcționează excelent pe sistemul de fișiere HDFS, ceea ce permite desfășurarea acestuia pe serverele Hadoop.
Adăugând la acest lucru volumul de documentație și soluții gata făcute pentru Hadoop și Spark în comparație cu Google Cloud Dataflow, alegerea instrumentului devine evidentă. Mai mult, inginerii pot decide singuri ce cod - pentru Hadoop sau Spark - să execute, în funcție de sarcină, experiență și calificare.
Cloud sau server local
Tendința de a trece complet la cloud a generat chiar și un termen interesant precum Hadoop-as-a-service. În acest scenariu, administrarea serverelor conectate devine extrem de importantă. Deoarece, din păcate, în ciuda popularității sale, Hadoop-ul simplu este un instrument destul de complex de configurat, necesitând multe ajustări manuale. De exemplu, trebuie să configurați serverele individual, să monitorizați performanțele acestora și să setați cu atenție numeroase parametrii. Cu alte cuvinte, este o muncă pentru pasionați și există o mare șansă să faceți vreo greșeală sau să omiteți ceva.
Din acest motiv, au câștigat popularitate diferite distribuții care sunt echipate inițial cu instrumente convenabile de implementare și administrare. Una dintre cele mai populare distribuții care suportă Spark și simplifică totul este Cloudera. Aceasta are atât versiuni plătite, cât și gratuite — iar în cea din urmă, toată funcționalitatea principală este disponibilă, fără restricționarea numărului de noduri.
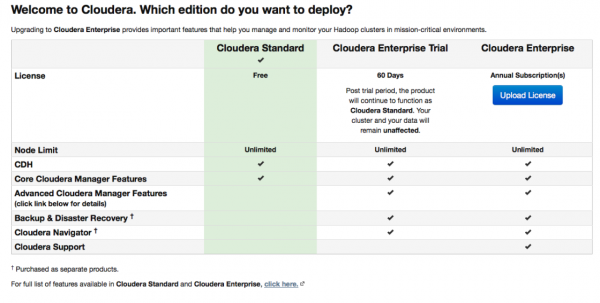
În timpul configurării Cloudera Manager se va conecta la serverele dvs. prin SSH. Un detaliu interesant: la instalare, este recomandat să specificați că se face prin așa-numitele parceli: pachete speciale, fiecare conținând toate componentele necesare, configurate să funcționeze împreună. Practic, aceasta este o versiune îmbunătățită a managerului de pachete.
După instalare, obținem o consolă de control a clusterului, unde putem vedea telemetria clusterelor, serviciile instalate și, de asemenea, veți putea adăuga/elimina resurse și edita configurația clusterului.
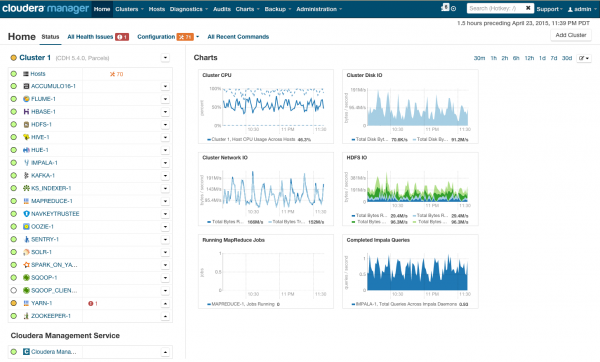
Ca rezultat, în fața dvs. apare tăierea acelei rachete care vă va duce spre viitorul luminos al BigData. Dar înainte de a spune «să plecăm», haideți să ne uităm sub capotă.
Cerințele hardware
Pe site-ul său, Cloudera menționează diferite configurații posibile. Principiile generale pe care se bazează acestea sunt prezentate în ilustrație:
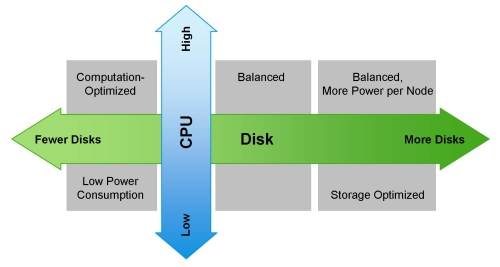
Această imagine optimistă poate fi estompată de MapReduce. Dacă ne uităm din nou la diagrama din secțiunea anterioară, devine evident că, în majoritatea cazurilor, sarcina MapReduce se poate confrunta cu un "gât de sticlă" atunci când citește date de pe disk sau din rețea. Acest lucru este, de asemenea, menționat în blogul Cloudera. Ca urmare, pentru orice calcule rapide, inclusiv prin Spark, care este adesea utilizat pentru calcule în timp real, viteza de intrare/ieșire este foarte importantă. Prin urmare, atunci când se folosește Hadoop, este esențial ca în cluster să fie incluse mașini echilibrate și rapide, ceea ce, pentru a fi blând, nu este întotdeauna asigurat în infrastructura cloud.
Echilibrul în distribuția sarcinilor este realizat prin utilizarea virtualizării OpenStack pe servere dotate cu procesoare multicore puternice. Nodurile de date au alocate resursele proprii de procesare și discuri specifice. În soluția noastră Atos Codex Data Lake Engine se obține o virtualizare extinsă, ceea ce ne aduce beneficii atât în termeni de performanță (impactul infrastructurii de rețea este minimizat), cât și de TCO (se elimină serverele fizice inutile).
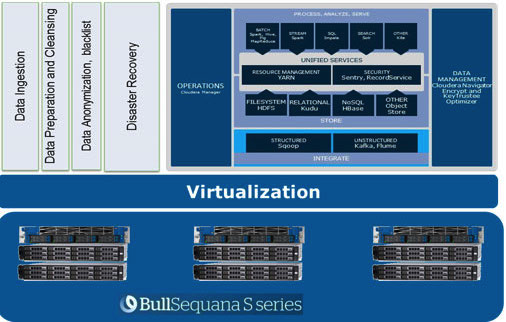
În cazul utilizării serverelor BullSequana S200, obținem o sarcină destul de uniformă, lipsită de părți înguste. Configurația minimă include 3 servere BullSequana S200, fiecare cu două JBOD, plus opțional se pot conecta servere S200 suplimentare, fiecare având patru noduri de date. Iată un exemplu de sarcină în testul TeraGen:
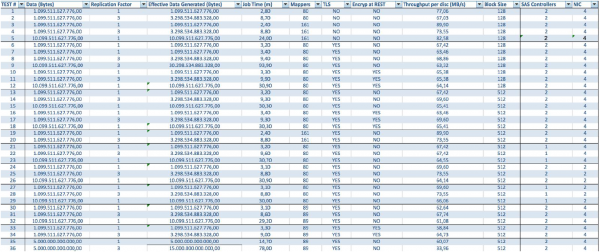
Testele cu diverse volume de date și valori de replicare arată rezultate similare în ceea ce privește distribuția sarcinii între nodurile clusterului. Mai jos este un grafic al distribuției accesului la disk din teste de performanță.
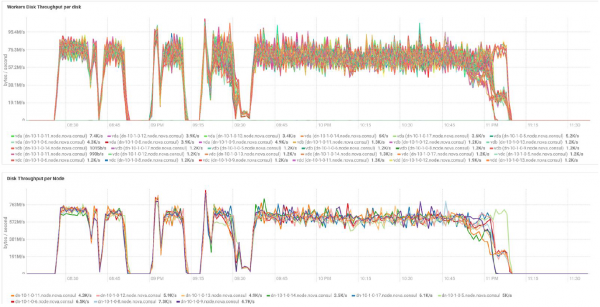
Calculul a fost realizat pe baza configurației minime din 3 servere BullSequana S200. Aceasta include 9 noduri de date și 3 noduri principale, precum și mașini virtuale rezervate pentru eventuale desfășurări de protecție pe bază de Virtualizare OpenStack. Rezultatul testului TeraSort: dimensiunea blocului de 512 MB cu un coeficient de replicare de trei și criptare este de 23,1 minute.
Cum poate fi extins sistemul? Pentru Data Lake Engine sunt disponibile diverse tipuri de extensii:
- Noduri de transfer de date: pentru fiecare 40 TB de spațiu util
- Noduri analitice cu posibilitatea de instalare a unui procesor grafic
- Alte opțiuni în funcție de necesitățile afacerii (de exemplu, dacă aveți nevoie de Kafka și altele asemănătoare)
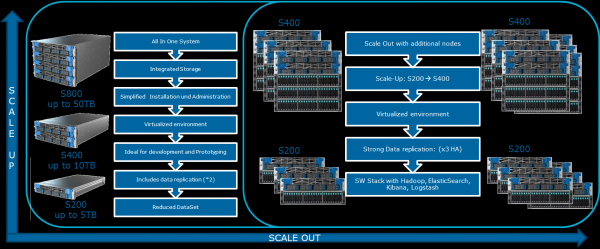
Complexul Atos Codex Data Lake Engine include atât serverele, cât și software-ul preinstalat, inclusiv pachetul Cloudera cu licență; Hadoop-ul în sine, OpenStack cu mașini virtuale bazate pe nucleul RedHat Enterprise Linux, sisteme de replicare a datelor și backup (inclusiv prin intermediul nodului de rezervă și Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine a fost prima soluție care a utilizat virtualizarea și care a fost certificată. .
Dacă sunteți interesat de detalii, vom fi bucuroși să răspundem la întrebările dumneavoastră în comentarii.
Sursa: habr.com
