

Salut tuturor! Numele meu este Pavel Agaletsky. Lucrez ca team leader într-o echipă care dezvoltă sistemul de livrare Lamoda. În 2018 am vorbit la conferința HighLoad++, iar astăzi vreau să vă prezint transcrierea prezentării mele.
Subiectul meu se concentrează pe experiența companiei noastre în implementarea sistemelor și serviciilor în diverse medii. Începând cu vremurile noastre preistorice, când implementam toate sistemele pe servere virtuale obișnuite, până la tranziția treptată de la Nomad la implementarea în Kubernetes. Voi vorbi despre motivele pentru care am făcut asta și ce probleme am întâmpinat în proces.

Implementarea aplicațiilor pe VM
Să înceapă cu faptul că acum 3 ani toate sistemele și serviciile companiei erau implementate pe servere virtuale obișnuite. Din punct de vedere tehnic, totul era organizat astfel încât tot codul sistemelor noastre era salvat și compilat prin sisteme de compilare automate, cu ajutorul Jenkins. Cu Ansible, acesta era desfășurat de pe sistemul nostru de control al versiunilor pe serverele virtuale. Fiecare sistem din compania noastră era implementat pe cel puțin 2 servere: unul era head, iar celălalt era tail. Aceste două sisteme erau absolut identice în toate setările, puterea, configurația și altele. Singura diferență era că head primea traficul utilizatorilor, iar tail nu primea niciodată traficul utilizatorilor.
De ce a fost necesar acest lucru?
Când implementam noi versiuni ale aplicației noastre, voiam să asigurăm o desfășurare fără întreruperi, adică fără consecințe vizibile pentru utilizatori. Aceasta era realizată prin faptul că versiunea compilată era desfășurată cu ajutorul Ansible pe serverul tail. Acolo, persoanele care se ocupau cu desfășurarea puteau verifica și se asigurau că totul funcționează bine: toate metricile, secțiunile și aplicațiile funcționează; scripturile necesare sunt lansate. Numai după ce se asigurau că totul este în regulă, traficul era comutat. Acesta începea să curgă pe serverul care până atunci era tail. Iar serverul care anterior era head rămânea fără trafic de utilizatori, având în continuare versiunea anterioară a aplicației noastre.
Astfel, pentru utilizatori, a fost fără întreruperi. Deoarece comutarea este instantanee, fiindcă este pur și simplu o schimbare a echilibratorului. Este foarte ușor să reveniți la versiunea anterioară, pur și simplu comutând echilibratorul înapoi. De asemenea, am putut verifica capacitatea aplicației în producție înainte ca traficul utilizatorilor să ajungă la ea, ceea ce a fost destul de convenabil.
Ce avantaje am observat în tot acest proces?
- În primul rând, este destul de simplu de utilizat. Toată lumea înțelege cum funcționează un astfel de sistem de implementare, deoarece majoritatea oamenilor au implementat vreodată pe servere virtuale obișnuite.
- Este destul de fiabil, deoarece tehnologia de implementare este simplă, testată de mii de companii. Milioane de servere sunt implementate în acest fel. Este greu să strici ceva.
- Și în final, am putut obține implementări atomice. Implementările care au loc instantaneu pentru utilizatori, fără o etapă vizibilă de comutare între versiunea veche și cea nouă.
Dar în tot acest proces am observat și câteva dezavantaje:
- Pe lângă mediul de producție, mediile de dezvoltare, există și alte medii. De exemplu, QA și preproducție. La acel moment, aveam multe servere și aproximativ 60 de servicii. Din acest motiv, a fost necesar să menținem o versiune relevantă pentru fiecare serviciu a mașinii virtuale. În plus, dacă doriți să actualizați bibliotecile sau să adăugați noi dependențe, trebuie să faceți asta în toate mediile. De asemenea, era necesar să sincronizăm momentul în care doriți să implementați o nouă versiune a aplicației cu momentul în care devops-ul va efectua setările necesare ale mediului. În acest caz, este ușor să ajungeți într-o situație în care mediul să difere considerabil între toate mediile. De exemplu, în mediul QA vor fi versiuni diferite ale bibliotecilor, iar în producție alte versiuni, ceea ce va duce la probleme.
- Dificultăți în actualizarea dependențelor aplicației dumneavoastră. Aceasta nu depinde de dumneavoastră, ci de o altă echipă. Anume, echipa devops, care întreține serverele. Trebuie să le stabiliți sarcinile corespunzătoare și să le oferiți o descriere a ceea ce doriți să realizați.
- În acea perioadă, ne-am dorit să împărțim monoliții mari pe care îi aveam în servicii mici, deoarece ne-am dat seama că numărul acestora va crește constant. La acel moment, deja aveam peste 100 dintre ele. Era necesar să creăm o mașină virtuală separată pentru fiecare nou serviciu, care necesita întreținere și implementare. În plus, era nevoie de cel puțin două mașini. La toate acestea se adăuga și un mediu QA. Acest lucru provoacă probleme și face ca crearea și lansarea de noi sisteme să fie mai complex, costisitor și de lungă durată.
Prin urmare, am decis că va fi mai convenabil să trecem de la implementarea mașinilor virtuale obișnuite la implementarea aplicațiilor noastre într-un container Docker. Având Docker, este necesară o sistemă care să poată rula aplicația într-un cluster, deoarece nu poți lansa pur și simplu un container. De obicei, vrei să monitorizezi câte containere sunt active, astfel încât să se pornească automat. Din acest motiv, a trebuit să alegem un sistem de management.
Am reflectat mult la care dintre ele să alegem. Problema era că, la acel moment, acest stack de implementare pe servere virtuale obișnuite era oarecum învechit, deoarece nu aveam cele mai recente versiuni ale sistemelor de operare. La un moment dat, avea chiar și FreeBSD, care era greu de întreținut. Ne-am dat seama că trebuie să migram cât mai repede în Docker. DevOps-ii noștri s-au uitat la experiența lor existentă cu diferite soluții și au ales un sistem numit Nomad.
Trecerea la Nomad
Nomad este un produs de la compania "HashiCorp". Aceștia sunt cunoscuți și pentru alte soluții ale lor:
"Consul" — este un instrument pentru descoperirea serviciilor.
"Terraform" — este un sistem pentru gestionarea serverelor, care vă permite să le configurați printr-o configurare, numită infrastructure-as-code.
"Vagrant" permite desfășurarea de mașini virtuale local sau în cloud prin intermediul unor fișiere de configurare specifice.
Nomad ni s-a părut o soluție suficient de simplă, la care putem trece rapid fără a modifica întreaga infrastructură. În plus, este destul de ușor de stăpânit. De aceea, l-am ales ca sistem de filtrare a containerelor noastre.
Ce aveți nevoie pentru a implementa efectiv sistemul dvs. în Nomad?
- În primul rând, aveți nevoie de imagine Docker aplicației dumneavoastră. Este necesar să o construiți și să o plasați în depozitul de imagini docker. În cazul nostru, acesta este artifactory - un sistem care permite încărcarea în el a diferitelor artefacte de diverse tipuri. Poate stoca arhive, imagini docker, pachete composer PHP, pachete NPM și așa mai departe.
- De asemenea, este necesar de configurare, care va informa Nomad ce, unde și în ce cantitate doriți să desfășurați.
Când vorbim despre Nomad, acesta folosește ca format de fișier informațional limbajul HCL, care se decodifică ca HashiCorp Configuration Language. Este un superset al Yaml, care vă permite să descrieți serviciul dumneavoastră în termenii Nomad.
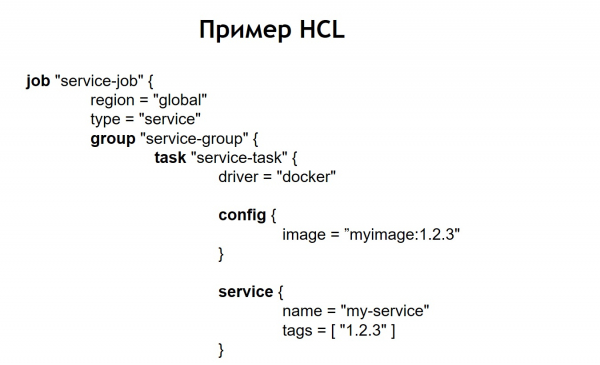
Acesta permite să specificați câte containere doriți să desfășurați, din ce imagini să le transmiteți diferite parametrii în timpul desfășurării. Astfel, alimentați acest fișier Nomad și el pornește containerele în producție conform lui.
În cazul nostru, am realizat că pur și simplu scrierea de fișiere HCL complet identice pentru fiecare serviciu nu va fi foarte convenabilă, deoarece sunt multe servicii și uneori dorim să le actualizăm. Există cazuri în care un serviciu nu este desfășurat într-un singur exemplar, ci în mai multe. De exemplu, unul dintre sistemele noastre aflate în producție are peste 100 de instanțe în producție. Acestea sunt lansate din aceleași imagini, dar diferă în setările de configurare și fișierele de configurare.
De aceea, am decis că va fi convenabil să păstrăm toate fișierele noastre de configurare pentru desfășurare într-un singur repository comun. Astfel, acestea devin vizibile: este ușor să le întrețineți și este posibil să vedeți ce sisteme avem. În caz de necesitate, nu este greu să actualizăm sau să schimbăm ceva. Adăugarea unui nou sistem nu va fi nici ea dificilă – este suficient să creați un fișier de configurare în interiorul unui nou director. În interiorul acestuia se află fișierele: service.hcl, care conține descrierea serviciului nostru, și câteva fișiere env, care permit acest serviciu, odată desfășurat în producție, să fie configurat.
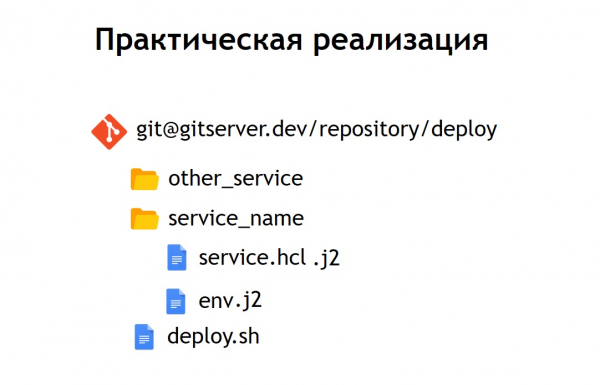
Cu toate acestea, unele dintre sistemele noastre sunt desfășurate în producție nu într-un singur exemplar, ci simultan în mai multe. Prin urmare, am decis că ne va fi convenabil să stocăm nu configurațiile în formă pură, ci versiunea lor șablonizată. Și limbajul de șablonizare pe care l-am ales este jinja 2. În acest format, păstrăm atât configurațiile serviciului, cât și fișierele env necesare pentru acesta.
În plus, am plasat în repository-ul comun pentru toate proiectele un script-deploy care permite lansarea și desfășurarea serviciului dvs. în producție, în mediu dorit și către ținta dorită. În cazul în care am transformat configurația noastră HCL într-un șablon, fișierul HCL care anterior era o configurație obișnuită Nomad a devenit într-un fel diferit.
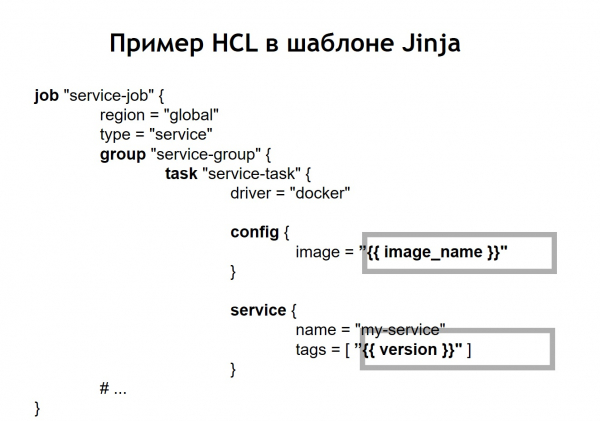
Asta înseamnă că am înlocuit anumite variabile ale configurației cu inserții de variabile provenite din fișierele env sau din alte surse. În plus, am obținut capacitatea de a genera fișiere HCL dinamic, adică putem aplica nu doar inserții obișnuite de variabile. Deoarece jinja suportă bucle și condiții, putem crea fișiere de configurație care se schimbă în funcție de locul unde desfășurați aplicațiile dvs.
De exemplu, doriți să desfășurați serviciul dvs. în pre-producție și în producție. Să presupunem că în pre-producție nu doriți să lansați cron-scripte, ci doar doriți să vedeți serviciul pe un domeniu separat pentru a verifica dacă funcționează. Pentru oricine desfășoară un serviciu, procesul pare foarte simplu și transparent. E suficient să rulați fișierul deploy.sh, să specificați ce serviciu doriți să desfășurați și către ce țintă. De exemplu, doriți să desfășurați o anumită sistem în Rusia, Belarus sau Kazahstan. Pentru aceasta, e suficient să schimbați unul dintre parametrii, iar fișierul de configurație corect va fi generat.
Când serviciul Nomad este deja desfășurat în clusterul dvs., acesta va arăta astfel.
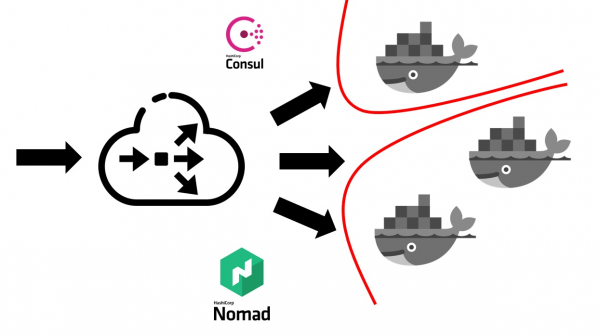
Pentru început, aveți nevoie de un anumit echilibrator extern, care va accepta tot traficul utilizatorilor. Acesta va funcționa împreună cu Consul și va afla de la el unde, pe ce nod, și prin ce adresa IP se află serviciul specific care corespunde unui anumit nume de domeniu. Serviciile în Consul apar din Nomad. Deoarece sunt produse ale aceleași companii, sunt bine interconectate. Se poate spune că Nomad știe din cutie să înregistreze toate serviciile desfășurate în el în cadrul Consul.
După ce echilibratorul dvs. extern află către ce serviciu trebuie să redirecționeze traficul, acesta îl trimite în containerele corespunzătoare aplicației dvs. Este evident că trebuie să ținem cont și de securitate. Chiar dacă toate serviciile rulează pe aceleași mașini virtuale în containere, este necesar să interzicem accesul liber din orice serviciu către orice alt serviciu. Am realizat acest lucru prin segmentare. Fiecare serviciu era rulat într-o rețea virtuală separată, pe care erau definite reguli de rutare și reguli de permisiune/interzicere a accesului la celelalte sisteme și servicii. Acestea puteau fi atât în interiorul acestui cluster, cât și în afara sa. De exemplu, dacă doriți să interziceți unui serviciu să se conecteze la o anumită bază de date, acest lucru se poate face prin segmentare la nivel de rețea. Asta înseamnă că, chiar și din greșeală, nu puteți conecta din mediu de testare la baza dvs. de date de producție.
Cât ne-a costat procesul de tranziție în termeni de resurse umane?
Tranziția întregii companii la Nomad a durat aproximativ 5-6 luni. Am migrat serviciile unul câte unul, dar într-un ritm suficient de rapid. Fiecare echipă a trebuit să creeze propriile sale containere pentru servicii.
Adoptăm o abordare conform căreia fiecare echipă este responsabilă de imaginile docker ale sistemelor sale. DevOps oferă infrastructura comună necesară pentru desfășurare, adică suportul pentru cluster, suportul pentru sistemul CI etc. În acel moment, mai mult de 60 de sisteme au migrat la Nomad, rezultând aproximativ 2000 de containere.
DevOps este responsabil pentru infrastructura generală a tot ceea ce ține de desfășurare și servere. În același timp, fiecare echipă de dezvoltare este responsabilă pentru implementarea containerelor pentru sistemul său specific, deoarece echipa știe exact ce are nevoie în acel container.
Motivele pentru care am renunțat la Nomad
Ce avantaje am obținut prin migrarea la desfășurarea cu ajutorul Nomad și Docker, printre altele?
- Noi am asigurat condiții uniforme pentru toate medii. În dezvoltare, mediu QA, pre-producție, producție se utilizează aceleași imagini de containere, cu aceleași dependențe. Prin urmare, avem practic o șansă minimă ca în producție să ajungă ceva diferit de ceea ce ați testat local sau în mediul de testare.
- De asemenea, am descoperit că este suficient să adăugăm un nou serviciu. Orice sisteme noi, din punct de vedere al desfășurării, sunt foarte ușor de lansat. Este suficient să mergeți în depozitul care stochează configurările, să adăugați acolo o nouă configurație pentru sistemul dvs. și totul este pregătit. Puteți desfășura sistemul dvs. în producție fără eforturi suplimentare din partea DevOps.
- Toate fișierele de configurare într-un singur depozit comun s-au dovedit a fi revizuite. În momentul în care desfășuram sistemele noastre folosind servere virtuale, am folosit Ansible, unde configurațiile erau păstrate în același depozit. Totuși, pentru cea mai mare parte a dezvoltatorilor, lucrul cu acest lucru a fost puțin mai complicat. Volumul de configurații și cod pe care trebuie să-l adăugați pentru a desfășura un serviciu a devenit mult mai mic. În plus, pentru DevOps este foarte simplu să-l corecteze sau să-l schimbe. În cazul tranzițiilor, de exemplu, atunci când se trece la o nouă versiune a Nomad, ei pot să ia și să actualizeze masiv toate fișierele operaționale care se află în același loc.
Dar ne-am confruntat și cu câteva dezavantaje:
S-a dovedit că nu am putut să atingem desfășurări fără cusur în cazul Nomad. La lansarea containerelor din diferite condiții, s-a putut întâmpla ca acesta să fie pornit, iar Nomad să-l perceapă ca fiind gata să primească trafic. Acest lucru se întâmpla înainte ca aplicația din interior să apuce să pornească. Din acest motiv, sistemul începea să returneze erori 500 pentru o perioadă scurtă, deoarece traficul începea să se îndrepte către un container care nu era încă pregătit să-l primească.
Ne-am confruntat cu unele bug-uri. Cea mai semnificativă problemă este că Nomad nu gestionează foarte bine un cluster mare, dacă aveți multe sisteme și containere. Când doriți să scoateți din funcționare unul dintre serverele care face parte din clusterul Nomad, există o probabilitate destul de mare ca clusterul să nu se simtă foarte bine și să se destrame. Unele containere pot, de exemplu, să cadă și să nu se repornească – acest lucru vă va costa foarte mult dacă toate sistemele dumneavoastră de producție se află în clusterul gestionat de Nomad.
De aceea, am decis să ne gândim la direcția pe care să o luăm mai departe. La acea vreme am devenit mult mai conștienți de ceea ce ne dorim să realizăm. Adică: vrem fiabilitate, puțin mai multe funcționalități decât oferă Nomad și un sistem mai matur, mai stabil.
În această privință, alegerea noastră a căzut pe Kubernetes ca cea mai populară platformă pentru lansarea clusterelor. Mai ales având în vedere că dimensiunea și numărul containerelor noastre erau destul de mari. Pentru aceste scopuri, Kubernetes s-a dovedit a fi sistemul cel mai potrivit dintre cele pe care le-am putut evalua.
Tranziția la Kubernetes
Voi explica puțin care sunt conceptele de bază în Kubernetes și cu ce se diferențiază acestea față de Nomad.
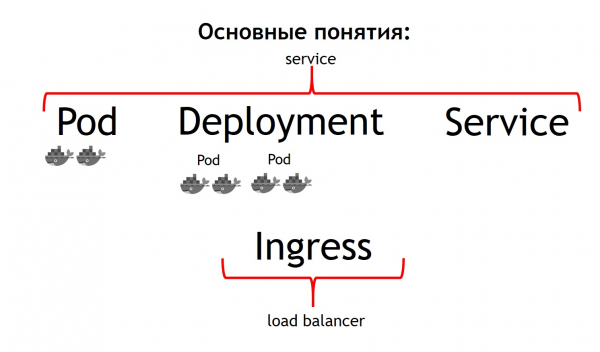
În primul rând, cel mai de bază concept în Kubernetes este conceptul de pod. Pod – este un grup de unul sau mai multe containere care sunt întotdeauna lansate împreună. Și ele funcționează ca și cum ar rula întotdeauna strict pe aceeași mașină virtuală. Ele sunt accesibile între ele prin adresa IP 127.0.0.1 pe porți diferite.
Să presupunem că aveți o aplicație PHP care constă din nginx și php-fpm – o schemă clasică. Cel mai probabil, veți dori ca atât containerele nginx cât și php-fpm să fie întotdeauna împreună. Kubernetes permite acest lucru, descriindu-le ca un singur pod comun. Acesta este exact ceea ce nu puteam obține cu ajutorul Nomad.
Al doilea concept este deployment. Problema este că un pod în sine este o entitate efemeră, se lansează și dispare. Vreți să omorâți mai întâi toate containerele anterioare și apoi să lansați direct versiunile noi sau doriți să le lansați treptat – exact de acest proces se ocupă conceptul de deployment. Acesta descrie modul în care desfășurați pod-urile, în ce număr și cum să le actualizați.
Al treilea concept este service. Serviciul dvs. este, de fapt, sistemul dvs. care primește un anumit trafic și apoi îl direcționează către unul sau mai multe poduri corespunzătoare serviciului dvs. Asta înseamnă că permiteți să se spună că tot traficul de intrare pentru un anumit serviciu cu un anumit nume trebuie trimis exact la aceste poduri. Și, în același timp, vă oferă un echilibru al traficului. Adică puteți lansa două poduri ale aplicației dvs. și tot traficul de intrare va fi echilibrat uniform între podurile care sunt asociate cu acest serviciu.
Și al patrulea concept de bază — Ingress. Acesta este un serviciu care rulează în clusterul Kubernetes. Acesta acționează ca un echilibrator extern de sarcină care preia toate cererile. Prin intermediul API-ului Kubernetes Ingress, poate determina unde trebuie direcționate aceste cereri. Și face acest lucru foarte flexibil. Puteți spune că toate cererile pentru acest host și acest URL sunt trimise la acest serviciu. Iar aceste cereri, care sosesc la acest host și un alt URL, sunt trimise la un alt serviciu.
Cel mai interesant din perspectiva celui care dezvoltă aplicația este că aveți capacitatea de a gestiona totul singur. Definind configurația Ingress, puteți trimite tot traficul care vine pe un anumit API la containere separate, specificate, de exemplu, în Go. Iar acest trafic, care vine pe același domeniu, dar la un alt URL, este trimis pe containere scrise în PHP, unde există multă logică, dar nu sunt foarte rapide.
Dacă comparăm toate aceste concepte cu Nomad, putem spune că primele trei concepte împreună constituie un serviciu. Iar ultimul concept este, în Nomad, inexistent. Am folosit un echilibrator extern pentru acesta: ar putea fi haproxy, nginx, nginx+ și așa mai departe. În cazul Kubernetes, nu trebuie să introduceți acest concept suplimentar separat. Totuși, dacă privim Ingress din interior, acesta este fie nginx, fie haproxy, fie traefik, dar cumva integrat în Kubernetes.
Toate conceptele descrise de mine sunt, în esență, resurse care există în interiorul clusterului Kubernetes. Pentru a le descrie în Kubernetes, este utilizat formatul yaml, care este mai ușor de citit și mai familiar decât fișierele HCL în cazul Nomad. Dar, din punct de vedere structural, ele descriu, de exemplu, podurile aceeași lucru. Spun – vreau să desfășor anumite poduri acolo, cu anumite imagini, într-un anumit număr.
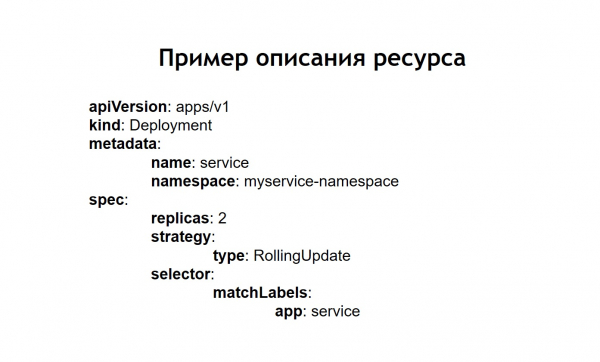
În plus, am realizat că nu vrem să creăm manual fiecare resursă individuală: deployment, servicii, Ingress și altele. În schimb, ne-am dorit să descriem fiecare sistem existent în termeni de Kubernetes la desfășurare, pentru a nu fi nevoiți să recreăm manual toate dependențele necesare în ordinea dorită. Sistemul ales pentru a ne permite acest lucru a fost Helm.
Conceptelor fundamentale în Helm
Helm este un manager de pachete pentru Kubernetes. Este foarte similar cu modul în care funcționează managerii de pachete în limbajele de programare. Ei vă permit să stocați un serviciu format, de exemplu, din deployment nginx, deployment php-fpm, configurația pentru Ingress, configmaps (aceasta este o entitate care vă permite să definiți env și alte parametri pentru sistemul dumneavoastră) sub formă de așa-numite chart-uri. În acest context, Helm funcționează deasupra Kubernetes. Adică nu este un sistem separat, ci un alt serviciu care rulează în interiorul cluster-ului. Interacționați cu el prin API-ul său folosind comenzi în linia de comandă. Avantajul și frumusețea sa constă în faptul că, chiar dacă Helm se strică sau îl ștergeți din cluster, serviciile dumneavoastră nu dispar, deoarece Helm servește practic doar pentru a lansa sistemul. Funcționarea și starea serviciilor sunt gestionate ulterior de Kubernetes.
De asemenea, am realizat că șablonizarea, pe care anterior eram nevoiți să o facem manual prin integrarea jinja în configurațiile noastre, este una dintre funcționalitățile principale ale Helm. Toate configurațiile pe care le creați pentru sistemele dumneavoastră sunt stocate în Helm sub formă de șabloane, care seamănă puțin cu jinja, dar, de fapt, folosesc șablonizarea limbajului Go, pe care Helm este scris, la fel ca și Kubernetes.
Helm ne adaugă încă câteva concepte suplimentare.
Chart — este descrierea serviciului dumneavoastră. În alte manageri de pachete, ar fi fost numit pachet, bundle sau ceva de genul acesta. Aici se numește chart.
Values – sunt variabilele pe care doriți să le folosiți pentru construirea configurațiilor din șabloane.
Release. De fiecare dată când un serviciu este implementat prin helm, primește o versiune incrementală a lansării. Helm își amintește care a fost configurația serviciului la lansările anterioare. Așadar, dacă trebuie să reveniți, este suficient să executați comanda helm callback, specificând versiunea anterioară a lansării. Chiar dacă configurația corespunzătoare nu este disponibilă în depozitul dvs. în momentul revenirii, helm își amintește cum era și va restaura sistemul la starea pe care o avea la lansarea anterioară.
În cazul în care folosim helm, configurațiile obișnuite pentru Kubernetes se transformă, de asemenea, în template-uri, în care există opțiunea de a folosi variabile, funcții și de a aplica operatori condiționali. Astfel, puteți construi configurația serviciului dvs. în funcție de mediu.
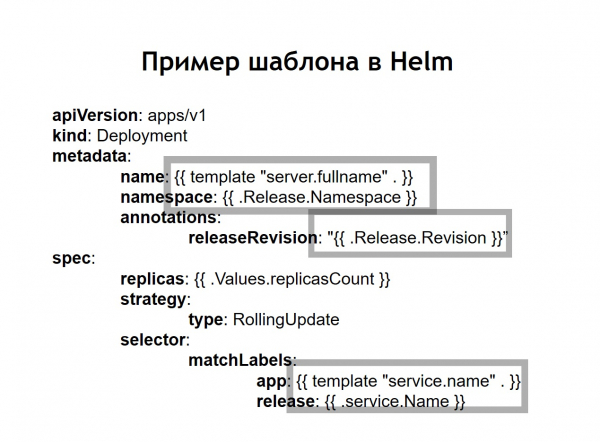
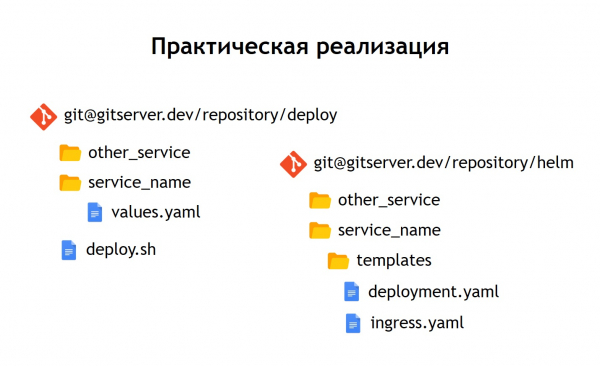
În practică, am decis să procedăm puțin diferit față de modul în care am acționat cu Nomad. Dacă în Nomad configurațiile pentru implementări și variabilele necesare pentru a implementa serviciul erau păstrate într-un singur depozit, aici am decis să le separăm în două depozite distincte. În depozitul „deploy” sunt stocate doar variabilele necesare pentru implementare, iar în depozitul „helm” sunt stocate configurațiile sau chart-urile.
Ce ne-a adus asta?
Deși în fișierele de configurație nu stocăm date cu adevărat sensibile, cum ar fi parolele pentru bazele de date. Acestea sunt stocate sub formă de secrets în Kubernetes, dar totuși, există anumite lucruri la care nu dorim să oferim acces tuturor. Prin urmare, accesul la depozitul „deploy” este mai restricționat, iar depozitul „helm” conține doar o descriere a serviciului. Din acest motiv, acesta poate fi accesat în siguranță de un cerc mai larg de persoane.
Având în vedere că avem nu doar producție, ci și alte medii, această separare ne permite să reutilizăm chart-urile helm pentru a implementa servicii nu doar în producție, ci și, de exemplu, în medii QA. Chiar și pentru a le desfășura local, folosind Minikube — este un astfel de instrument pentru rularea locală a Kubernetes.
În fiecare repository, am lăsat o separare în directoare separate pentru fiecare serviciu. Astfel, în interiorul fiecărui director se află șabloanele care se referă la graficul corespunzător și descriu resursele care trebuie desfășurate pentru a lansa sistemul nostru. În repository-ul „deploy”, am lăsat doar env-urile. În acest caz, nu am folosit șablonizarea cu jinja, deoarece helm oferă deja șablonizare din cutie – aceasta este una dintre funcțiile principale ale sale.
Am lăsat un script pentru desfășurare – deploy.sh, care simplifică și standardizează lansarea desfășurării utilizând helm. Astfel, pentru oricine dorește să desfășoare, interfața de desfășurare arată exact la fel ca în cazul desfășurării prin Nomad. Același deploy.sh, numele serviciului dvs. și locul unde doriți să-l desfășurați. Acest lucru determină ca helm să fie invocat. Acesta, la rândul său, adună configurațiile din șabloane, le integrează cu fișierele values necesare, apoi desfășoară, lansându-le în Kubernetes.
Conclusions
Serviciul Kubernetes pare mai complex decât Nomad.
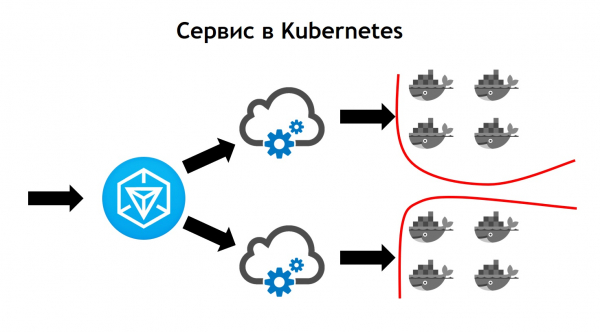
Aici, traficul de ieșire ajunge în Ingress. Acesta este controller-ul frontal care preia toate cererile și ulterior le trimite serviciilor corespunzătoare datelor cererii. El le identifică pe baza configurațiilor care fac parte din descrierea aplicației dvs. în helm și pe care dezvoltatorii le stabilesc singuri. Serviciul, la rândul său, trimite cererile către pod-urile sale, adică containerele specifice, balansând traficul de intrare între toate containerele aferente acestui serviciu. Și, bineînțeles, nu trebuie să uităm că la nivel de rețea, nu ar trebui să ne abatem de la securitate. De aceea, segmentarea funcționează în clusterul Kubernetes, bazată pe etichetare. Toate serviciile au anumite etichete, la care sunt atașate drepturile de acces ale serviciilor la resursele externe / interne, în interiorul sau în afara clusterului.
În timpul tranziției, am observat că Kubernetes are toate funcționalitățile lui Nomad, pe care l-am folosit anterior, dar adaugă și multe altele noi. Poate fi extins prin pluginuri și, de fapt, prin tipuri personalizate de resurse. Asta înseamnă că aveți posibilitatea nu doar de a folosi ceva ce vine implicit în Kubernetes, ci de a crea propria resursă și serviciu care va citi acea resursă. Aceasta oferă oportunități suplimentare de extindere a sistemului dumneavoastră fără a fi nevoie de reinstalarea Kubernetes și fără a necesita modificări.
Un exemplu de utilizare este Prometheus, care rulează în interiorul clusterei Kubernetes. Pentru a începe să colecteze metrici de la un anumit serviciu, trebuie să adăugăm în descrierea serviciului un tip suplimentar de resursă, numit serviciu-monitor. Datorită faptului că Prometheus poate citi tipuri personalizate de resurse, odată ce este pornit în Kubernetes, începe automat să colecteze metrici de la noua sistemă. Acest lucru este destul de convenabil.
Primul deploy pe care l-am realizat în Kubernetes a fost în martie 2018. Și în tot acest timp nu am avut nicio problemă. Funcționează destul de stabil fără erori semnificative. În plus, putem continua să-l extindem. În prezent, avem suficiente funcționalități în el, iar ritmul de dezvoltare al Kubernetes ne place foarte mult. În acest moment, există peste 3000 de containere în Kubernetes. Clusterul ocupă câteva noduri. În același timp, este gestionat, stabil și foarte controlabil.
Sursa: habr.com
