

La începutul acestei luni, pe 3 mai, a fost anunțată o lansare majoră a „sistemului de management pentru stocări distribuite de date în Kubernetes” - . Cu mai bine de un an în urmă, am o prezentare generală a Rook. Atunci am fost rugați să împărtășim experiența noastră de utilizare în practică — și acum, exact la un astfel de moment semnificativ în istoria proiectului, suntem bucuroși să împărtășim impresiile acumulate.
Pe scurt, Rook reprezintă un set de instrumente pentru Kubernetes, care preiau complet controlul asupra desfășurării, gestionării și recuperării automate a unor soluții de stocare, cum ar fi Ceph, EdgeFS, Minio, Cassandra, CockroachDB.
În prezent, soluția cea mai dezvoltată (și în stabilitate în stadiu) este .
Notă: printre schimbările semnificative din lansarea Rook 1.0.0, legate de Ceph, putem menționa suportul pentru Ceph Nautilus și capacitatea de a folosi NFS pentru bucket-urile CephFS sau RGW. Alte noutăți includ „maturizarea” suportului EdgeFS la nivel beta.
Așadar, în acest articol vom:
- răspunde la întrebarea ce avantaje vedem în utilizarea Rook pentru desfășurarea Ceph în clusterul Kubernetes;
- împărtăși experiența și impresiile din utilizarea Rook în production;
- explica de ce spunem „Da!” lui Rook și despre planurile noastre pentru acesta.
Să începem cu conceptele și teoria generale.
„Am un avantaj de o Rochie!” (necunoscut începător de șah)
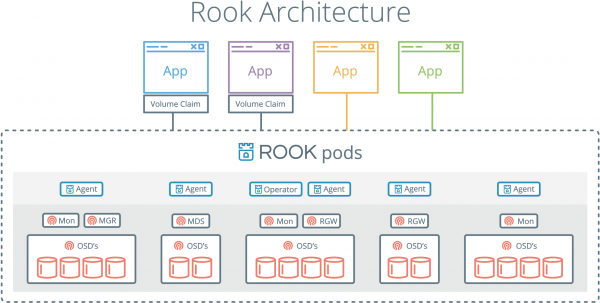
Unul dintre principalele avantaje ale Rook este că interacțiunea cu stocările de date se face prin intermediul mecanismelor Kubernetes. Asta înseamnă că nu mai este nevoie să copiezi comenzile pentru configurarea Ceph de pe o foaie în consolă.
— Vrei să desfășori CephFS în cluster? Scrie pur și simplu un fișier YAML!
— Ce? Vrei să desfășori și un obiect store cu API S3? Scrie pur și simplu un al doilea fișier YAML!
Rook a fost creat conform normelor tipice ale unui operator. Interacțiunea cu acesta se face prin intermediul , în care descriem caracteristicile necesare entităților Ceph (deoarece aceasta este singura implementare stabilă, în articol se va discuta în mod implicit despre Ceph, cu excepția cazului în care se specifică altceva). Conform parametrilor stabiliți, operatorul va executa automat comenzile necesare pentru configurare.
Să analizăm concret exemplul creării unui Object Store, mai exact — CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
Parametrii menționați în listă sunt suficient de standard și este puțin probabil să necesite comentarii, însă merită să acordați o atenție deosebită celor evidențiați în variabilele model.
Schema generală de funcționare constă în faptul că printr-un fișier YAML „comandăm” resurse, pentru care operatorul execută comenzile necesare și ne returnează un „secret” care nu este tocmai real, cu care putem lucra mai departe. (vezi mai jos). Din variabilele menționate anterior, se va compune comanda și numele secretului.
Ce este această comandă? La crearea utilizatorului pentru depozitul de obiecte, operatorul Rook va executa următoarele în interiorul pod-ului:
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"Rezultatul executării acestei comenzi va fi o structură JSON:
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Chei — ceea ce va fi necesar în viitor aplicațiilor pentru accesarea depozitului de obiecte prin API-ul S3. Operatorul Rook le alege cu amabilitate și le stochează în spațiul său de nume sub formă de secret cu numele rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Pentru a utiliza datele din acest secret, este suficient să le adăugați în container ca variabile de mediu. Ca exemplu, voi prezenta un model pentru Job, în care creăm automat bucket-uri pentru fiecare mediu utilizator:
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Toate acțiunile enumerate în acest Job au fost efectuate fără a ieși din cadrul Kubernetes. Structurile descrise în fișierele YAML sunt stocate într-un repository Git și reutilizate de mai multe ori. Acesta este un avantaj uriaș pentru inginerii DevOps și pentru procesul CI/CD în ansamblu.
Cu Rook și Rados, totul devine mai plăcut.
Utilizarea combinației Ceph + RBD impune anumite restricții în ceea ce privește montarea volumelor la pod-uri.
În special, în namespace trebuie să existe un secret pentru accesul la Ceph, astfel încât aplicațiile stateful să poată funcționa. Este normal dacă ai 2-3 medii în spațiile tale de nume: poți merge și copia secretul manual. Dar ce să faci dacă se creează un mediu separat pentru fiecare funcționalitate a dezvoltatorilor, fiecare cu propriul namespace?
Noi am rezolvat această problemă prin intermediul , care copia automat secretele în noile namespace-uri (un exemplu de acest hook este descris în ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
Cu toate acestea, utilizarea Rook elimină complet această problemă. Procesul de montare se realizează folosind driverele proprii bazate pe sau (în prezent în stadiu beta) și, prin urmare, nu necesită secrete.
Rook rezolvă automat multe probleme, ceea ce ne îndeamnă să-l folosim în noile proiecte.
Asediul Rook
Vom încheia partea practică prin implementarea Rook și Ceph pentru a efectua propriile experimente. Pentru a face mai ușor să cucerim această turn neaccessibil, dezvoltatorii au pregătit un pachet Helm. Să-l descărcăm:
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 În fișierul rook-ceph/values.yaml putem găsi numeroase setări diferite. Cel mai important este să specificăm toleranțele pentru agenți și căutare. Despre cum putem folosi mecanismul taints/tolerations, am discutat detaliat în .
Pe scurt, nu dorim ca pod-urile cu aplicația client să fie localizate pe aceleași noduri cu discurile pentru stocarea datelor. Motivul este simplu: astfel, activitatea agenților Rook nu va influența aplicația însăși.
Deci, deschidem fișierul rook-ceph/values.yaml cu editorul nostru preferat și adăugăm la final următorul bloc:
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
Pe fiecare nod rezervat pentru stocarea datelor, adăugăm taint-ul corespunzător:
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecuteApoi, instalăm chart-ul Helm cu comanda:
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephAcum trebuie să creăm un cluster și să specificăm locația :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "/mnt/osd"
    - name: host-2
      directories:
      - path: "/mnt/osd"
    - name: host-3
      directories:
      - path: "/mnt/osd"
Verificăm starea Ceph — ne așteptăm să vedem HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sDe asemenea, verificăm că pod-urile cu aplicația client nu sunt plasate pe nodurile rezervate pentru Ceph:
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameApoi, opțional, se configurează componente suplimentare. Detalii despre acestea sunt indicate în . Pentru administrare, recomandăm insistent instalarea dashboard-ului și a toolbox-ului.
Cotele Rook: ajunge Rook la toate nevoile?
După cum se vede, dezvoltarea Rook avansează rapid. Totuși, mai există probleme care ne împiedică să renunțăm complet la configurarea manuală a Ceph:
- Niciun driver Rook să exporte metricele de utilizare a blocurilor montate, ceea ce ne privează de monitorizare.
- Flexvolume și CSI nu pot schimba dimensiunea volumelor (spre deosebire de RBD), astfel că Rook pierde un instrument valoros (și uneori critic!).
- Rook încă nu este la fel de flexibil ca Ceph obișnuit. Dacă dorim să configurăm pool-ul pentru metadatele CephFS să fie stocat pe SSD, iar datele să fie pe HDD, va trebui să specificăm manual grupuri separate de dispozitive în hărțile CRUSH.
- Deși operatorul rook-ceph este considerat stabil, în prezent există probleme în actualizarea Ceph de la versiunea 13 la 14.
Conclusions
„Acum Rook este închis față de lumea exterioară de pioni, dar credem că într-o zi va juca un rol decisiv în partidă!” (citat inventat special pentru acest articol)
Proiectul Rook ne-a câștigat cu siguranță inimile - considerăm că [cu toate avantajele și dezavantajele sale] merită, cu siguranță, atenția dumneavoastră.
Planurile noastre de viitor se referă la transformarea rook-ceph într-un modul pentru , ceea ce va face utilizarea sa în numeroasele noastre clustere Kubernetes și mai simplă și mai convenabilă.
P.S.
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
