

Ca și în , a apărut o problemă cu serviciul distribuit, să-i spunem Elvin. De această dată nu am descoperit eu problema, ci mi-au raportat-o colegii din partea clienților.
Într-o dimineață m-am trezit cu un email nemulțumit din cauza întârzierilor mari în Elvin, pe care intenționam să-l lansăm în curând. În special, clientul s-a confruntat cu o întârziere de 99% în jur de 50 ms, mult peste bugetul nostru de întârziere. A fost surprinzător, deoarece testasem cu atenție serviciul, mai ales pentru întârzieri, întrucât acesta era subiectul plângerilor frecvente.
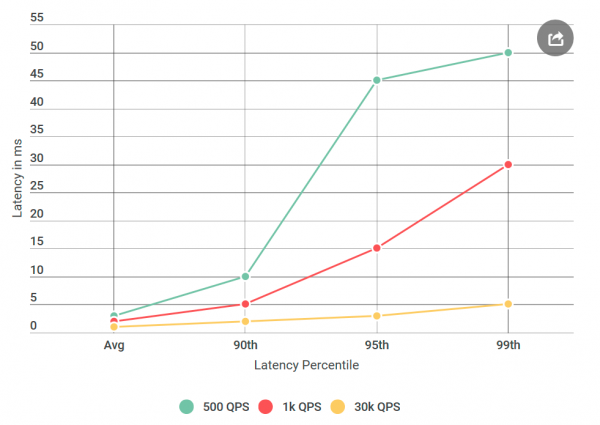
Înainte de a-l da pe Elvin în testare, am efectuat multe experimente cu 40.000 de cereri pe secundă (QPS), toate arătând întârzieri de mai puțin de 10 ms. Eram pregătit să afirm că nu sunt de acord cu rezultatele lor. Dar, aruncând o privire din nou la email, am observat ceva nou: nu testasem condițiile pe care le menționaseră, QPS-ul lor fiind mult mai mic decât al meu. Eu testasem la 40k QPS, iar ei doar la 1k. Am inițiat un alt experiment, de această dată cu un QPS mai mic, doar pentru a-i răsfăța.
Deoarece scriu despre acest lucru pe blog — probabil că ați înțeles deja: cifrele lor s-au dovedit a fi corecte. Am verificat clientul meu virtual din nou și din nou, având același rezultat: un număr mic de cereri nu doar că crește întârzierea, dar crește și numărul cererilor cu întârzieri de peste 10 ms. Cu alte cuvinte, dacă la 40k QPS aproximativ 50 de cereri pe secundă depășeau 50 ms, atunci la 1k QPS erau 100 de cereri pe secundă care depășeau 50 ms. Paradix!
Restrângem căutarea
Afară fiind cu o problemă de întârziere într-un sistem distribuit cu multe componente, primul lucru de făcut este să creăm o listă scurtă de suspecți. Să ne aprofundăm puțin în arhitectura lui Elvin:
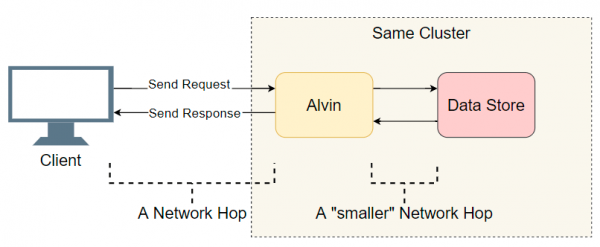
Un bun punct de plecare este lista tranzițiilor de I/O efectuate (apeluri de rețea/căutări pe disc etc.). Să încercăm să aflăm unde se află întârzierile. În afară de evidentul I/O cu clientul, Elvin face un pas suplimentar: comunică cu stocarea de date. Totuși, această stocare funcționează într-un singur cluster cu Elvin, astfel că întârzerea acolo ar trebui să fie mai mică decât cu clientul. Așadar, lista suspecților:
- Apelul de rețea de la client la Elvin.
- Apelul de rețea de la Elvin la stocarea de date.
- Căutarea pe disc în stocarea de date.
- Apel de rețea din stocarea de date către Elvin.
- Apel de rețea de la Elvin către client.
Haideți să încercăm să eliminăm unele puncte.
Stocarea de date nu are nicio vină.
Mai întâi, am transformat Elvin într-un server ping-ping, care nu procesează cererile. La primirea cererii, returnează un răspuns gol. Dacă întârzierea scade, atunci problema este în realizarea lui Elvin sau a stocării de date - nimic de neobișnuit. În primul experiment, obținem următorul grafic:
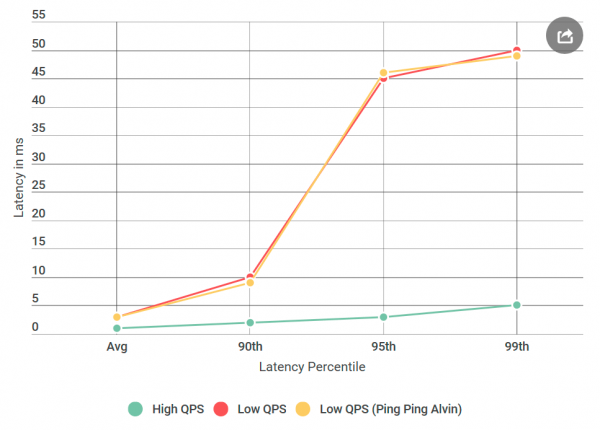
După cum vedem, folosind serverul ping-ping nu observăm nicio îmbunătățire. Aceasta înseamnă că stocarea de date nu mărește întârzierea, iar lista suspecților se reduce la jumătate:
- Apelul de rețea de la client la Elvin.
- Apel de rețea de la Elvin către client.
Groază! Lista se reduce repede. Credeam că aproape am descoperit cauza.
gRPC
Acum este momentul să vă prezint un nou jucător: . Este o bibliotecă open-source de la Google pentru comunicații intra-proces. . Deși gRPC este bine optimizată și folosită pe scară largă, eu am folosit-o pentru prima dată într-un sistem de această magnitudine, și mă așteptam ca implementarea mea să fie suboptimală - ca să mă exprim blând.
Prezența gRPC în stivă a generat o nouă întrebare: poate că implementarea mea sau gRPC provoacă problema întârzierii? Adăugăm un nou suspect pe listă:
- Clientul apelează biblioteca.
gRPC - Biblioteca
gRPCpe client efectuează un apel de rețea al bibliotecii.gRPCpe serverul - Biblioteca
gRPCse adresează lui Elvin (operația nu există în cazul serverului ping-pong).
Pentru a înțelege cum arată codul, implementarea mea client/Elvin nu se deosebește mult de exemplele client-server .
Nota: lista de mai sus este oarecum simplificată, deoarece
gRPCpermite utilizarea propriului model de flux (șablon?), în care se întrețes stiva de execuțiegRPCși implementarea utilizatorului. De dragul simplității, ne vom menține la acest model.
Profilarea va corecta totul.
Eliminând stocările de date, am crezut că aproape am terminat: „Acum e simplu! Aplicăm profilul și aflăm unde apare întârzierea”. Eu , deoarece CPU-ul este foarte rapid și de cele mai multe ori nu reprezintă un punct critic. Cele mai multe întârzieri apar atunci când procesorul trebuie să oprească procesarea pentru a face altceva. Profilarea precisă a CPU-ului este făcută tocmai pentru asta: înregistrează cu exactitate toate și oferă o înțelegere a locurilor unde apar întârzierile.
Am luat patru profiluri: pentru un QPS ridicat (latenta mică) și cu un server ping-pong pe QPS scăzut (latenta mare), atât pe partea clientului, cât și pe partea serverului. Și, doar pentru precauție, am luat și un exemplu de profil CPU. Când compar profilele, caut de obicei un stack de apeluri anormal. De exemplu, pe partea proastă cu latenta mare, se observă mult mai multe comutări de context (de 10 ori sau mai mult). Dar în cazul meu, numărul comutărilor de context a fost practic același. Spre groaza mea, nu a fost nimic semnificativ.
Diagnosticare suplimentară
Am fost în disperare. Nu știam ce alte instrumente să folosesc, iar planul meu următor consta practic în repetarea experimentelor cu variații diferite, și nu în diagnosticarea clară a problemei.
Ce-ar fi dacă
Înca de la început, m-a îngrijorat timpul de latență specific de 50 ms. Este un timp foarte mare. Am decis să extrag bucăți din cod până când voi putea determina exact care parte cauzează această eroare. A urmat un experiment care a funcționat.
Așa cum se întâmplă de obicei, în urmă pare că totul a fost evident. Am pus clientul pe aceeași mașină cu Elvin - și am trimis o cerere în localhost. Și creșterea latenței a dispărut!
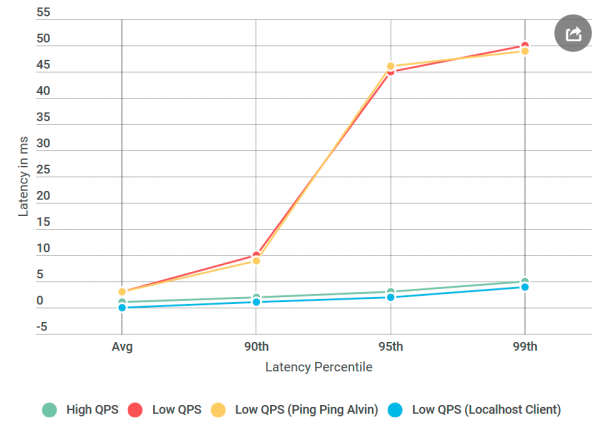
Era ceva în neregulă cu rețeaua.
Învățarea abilităților de inginer de rețea
Trebuie să recunosc: cunoștințele mele în tehnologia rețelurilor sunt groaznice, mai ales având în vedere că lucrez cu ele zilnic. Dar rețeaua era principalul suspect și trebuia să învăț cum să o diagnostic.
Din fericire, internetul iubește pe cei care vor să învețe. O combinație de ping și tracert părea a fi un început destul de bun pentru diagnosticarea problemelor de transport al rețelei.
În primul rând, am rulat pe portul TCP al lui Elvin. Am folosit parametrii impliciți - nimic special. Din peste o mie de pings, niciunul nu a depășit 10 ms, cu excepția primului pentru încălzire. Aceasta contrazice creșterea observată a latenței de 50 ms în percentilul 99: acolo, la fiecare 100 de cereri ar fi trebuit să vedem aproximativ o cerere cu latență de 50 ms.
Apoi am încercat : poate, problema este la unul dintre nodurile pe traseul dintre Elvin și client. Dar și tracert-ul a revenit cu mâinile goale.
Astfel, cauza latenței nu a fost codul meu, nu implementarea gRPC și nu rețeaua. Începusem deja să mă îngrijorez că nu voi înțelege niciodată asta.
Acum, pe ce sistem de operare ne aflăm
gRPC este folosit pe scară largă în Linux, dar pentru Windows este o excepție. Am decis să fac un experiment, care a funcționat: am creat o mașină virtuală Linux, am compilat Alvin pentru Linux și l-am desfășurat.
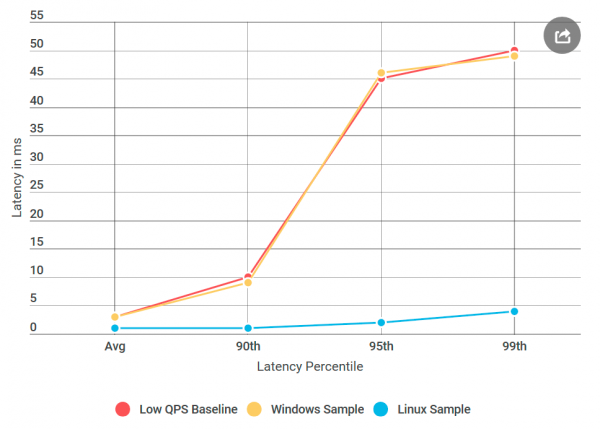
Și iată ce a ieșit: serverul ping-pong pe Linux nu avea întârzierea aceea ca nodul similar pe Windows, deși sursa de date nu s-a schimbat. Se pare că problema este în implementarea gRPC pentru Windows.
Algoritmul Nagle
Toată această vreme am crezut că îmi lipsește un flag gRPC. Acum am realizat că de fapt lipsește gRPC flagul Windows. Am găsit o bibliotecă internă RPC, despre care eram sigur că funcționează bine pentru toate flagurile instalate . Apoi am adăugat toate aceste flaguri în gRPC și am desfășurat Alvin pe Windows, în serverul ping-pong corectat pentru Windows!
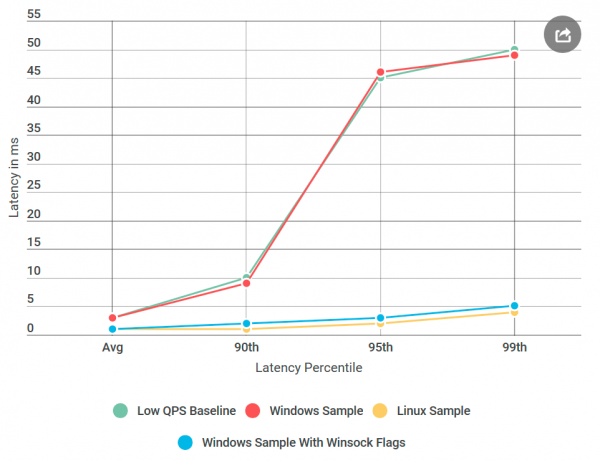
Aproape gata: am început să elimin flagurile adăugate unul câte unul, până când regresia s-a întors, astfel încât am putut determina exact cauza ei. Era tristul , comutator al algoritmului Nagle.
încearcă să reducă numărul de pachete trimise prin rețea, întârziind transmiterea mesajelor până când dimensiunea pachetului depășește un anumit număr de byte. Deși acest lucru poate fi plăcut pentru utilizatorul mediu, este devastator pentru serverele în timp real, deoarece OS va întârziat unele mesaje, provocând întârzieri la un QPS scăzut. Flagul acesta gRPC a fost setat în implementarea Linux pentru socket-uri TCP, dar nu pentru Windows. Am realizat că .
Concluzie
Întârzierea mare la un QPS scăzut a fost cauzată de optimizarea OS-ului. Privind înapoi, profilarea nu a detectat întârzierea deoarece a fost efectuată în modul kernel, nu în . Nu știu dacă algoritmul Nagle poate fi observat prin capturi ETW, dar ar fi interesant.
În ceea ce privește experimentul localhost, acesta probabil nu a fost legat de codul de rețea real, iar algoritmul Nagle nu a fost activat, așa că problemele cu întârzierile au dispărut când clientul a accesat Alvin prin localhost.
Data viitoare când observați o creștere a întârzierii cu o scădere a numărului de cereri pe secundă, algoritmul Nagle ar trebui să fie în lista dumneavoastră de suspecți!
Sursa: habr.com
