

Mă numesc Serghei, sunt de la compania ITSumma și vreau să vă vorbesc despre cum abordăm rezervările în Kubernetes. În ultima vreme, m-am dedicat mult consultanței pentru implementarea diverselor soluții devops pentru diferite echipe, și, în special, am lucrat la proiecte cu utilizarea K8s. La conferința Uptime Day 4, care a fost dedicată rezervării în arhitecturi complexe, am susținut o prezentare despre rezervarea «cubului», iar aici este o reluare liberă a acesteia. Vă avertizez din capul locului că nu este un ghid direct de acțiune, ci mai degrabă o sinteză a gândurilor pe această temă.
În principiu, monitorizarea și rezervarea sunt cele două instrumente principale de creștere a rezilienței oricărui proiect. Dar, bineînțeles, în K8s totul se echilibrează de la sine, veți spune, totul se scalează de la sine, și dacă se întâmplă ceva — se va ridica de la sine… Asta înseamnă că, la o primă cercetare superficială a subiectului, internetul mi-a răspuns la întrebarea, cine cum se apropie de rezervarea K8s, cu „de ce?” Multe persoane cred că K8s este un fel de lucru magic care scutește de toate problemele de infrastructură și face ca proiectul să nu se prăbușească niciodată. Dar… lumea nu este ceea ce pare.
Cum ne abordam procesul de rezervare înainte? Aveam site-uri identice pentru găzduire — fie erau mașini virtuale, fie erau servere fizice servere, la care aplicam trei practici de bază:
- sincronizarea codului și a statelor
- sincronizarea configurațiilor
- replicarea bazelor de date
Și voilà: în orice moment ne comutam pe site-ul de rezervă, toți sunt fericiți, ne ridicăm și ne împrăștiem.
Ce ne oferă pentru a crește disponibilitatea constantă a aplicației noastre Kubernetes? Primul lucru despre care vorbește documentația neoficială este să avem multe mașini, să avem mulți masteri - numărul lor trebuie să satisfacă cerințele pentru atingerea cvorumului în interiorul clusterului, și să avem etcd, api, MC, scheduler... pe fiecare dintre masteri. Și, părea că totul este minunat: când mai multe noduri de lucru sau masteri ies din funcțiune, clusterul nostru se reechilibrează și aplicația continuă să funcționeze. Din nou, pare magie! Dar adesea, clusterul nostru se află într-un singur centru de date și acest lucru poate ridica anumite întrebări. Ce se întâmplă dacă un excavator vine și dezgropă un cablu, dacă a lovit fulgerul, dacă a avut loc un potop universal? Totul s-a dus, clusterul nostru nu mai există. Cum ar trebui să abordăm rezervarea având în vedere această problemă?
În primul rând, ar trebui să aveți un alt cluster în rezervă, adică un cluster la care puteți comuta în orice moment. Din acest punct de vedere, infrastructura trebuie să fie complet identică. Adică dacă există pluginuri non-standard pentru lucrul cu sistemul de fișiere, soluții personalizate pentru ingress, acestea trebuie să fie complet identice pe cele două (sau trei, sau zece, depinde de cât aveți bani și forță de muncă) clustere. Trebuie să definiți clar două seturi de aplicații (deployment-uri, statefulset-uri, daemonset-uri, cronjob-uri etc.): care dintre ele pot funcționa permanent în rezervă, iar care ar fi mai bine să nu fie lansate până la comutarea efectivă.
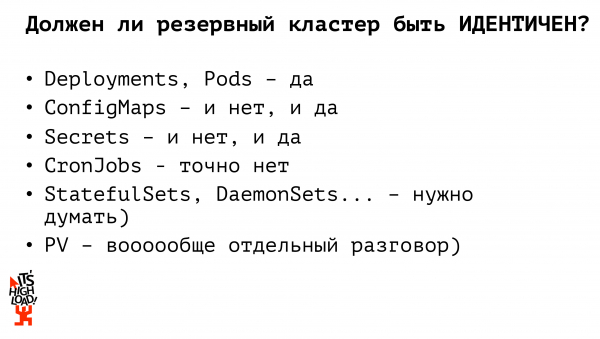
Ar trebui ca clusterul nostru de rezervă să fie complet identic cu clusterul nostru de producție? Nu. Dacă anterior, în cadrul proiectelor monolitice, am menținut o mediu aproape complet identic în cadrul infrastructurii hardware, consider că în cadrul Kubernetes nu ar trebui să fie așa. Să examinăm de ce.
De exemplu, să începem cu entitățile de bază ale Kubernetes – deployments – acestea trebuie să fie identice. Aplicațiile trebuie să fie lansate, astfel încât, în orice moment, să poată prelua procesarea traficului și să permită continuarea funcționării proiectului nostru. Dacă vorbim despre fișierele de configurare, trebuie să ne întrebăm dacă acestea trebuie să fie identice sau nu. Așadar, dacă noi, oameni raționali, nu folosim substanțe interzise și nu păstrăm baza de date în K8s, atunci în configmaps trebuie să avem setările de acces la baza de date de producție (procesul de rezervare al acesteia fiind construit separat). În consecință, pentru a asigura accesul la exemplarul de rezervă al bazei de date, trebuie să avem un fișier de configurare (configmap) separat. Exact în același mod lucrăm și cu secret-urile: parolele pentru accesul la bază, api-urile; în orice moment, poate funcționa fie secretul de producție, fie cel de rezervă. Așadar, avem deja două entități Kubernetes, versiunile de rezervă ale cărora nu trebuie să fie identice cu cele de producție. Următoarea entitate la care trebuie să ne oprim este cronjob. Cronjob-urile de rezervă nu trebuie în niciun caz să fie identice cu setul de cronjob-uri din cluster-ul de producție! Dacă ridicăm un cluster de rezervă și îl activăm complet cu toate cronjob-urile pornite – de exemplu, oamenii vor primi de la dumneavoastră două e-mailuri simultan în loc de unul singur. Sau sincronizarea datelor cu surse externe va avea loc de două ori, ceea ce înseamnă că începe să ne afecteze, să plângem, să ne strigăm și să ne certăm.
Și cum ne propun oamenii de pe internet să organizăm un cluster de rezervă? Al doilea răspuns ca popularitate, după „de ce?” – utilizarea Kubernetes Federation.
Ce este asta? Să spunem că este un mare meta-cluster. Dacă ne imaginăm arhitectura Kubernetes — unde avem un master, mai multe noduri — din perspectiva federației avem și un master și mai multe noduri, doar că fiecare nod este un cluster separat. Adică lucrăm cu aceleași entități, cu aceleași primitive, ca și cu un Kubernetes unic, doar că gestionăm nu mașinile noastre fizice, ci clustere întregi. În cadrul federației, avem o sincronizare completă a resurselor federative de la părinți la copii. De exemplu, dacă am lansat un anumit deployment prin federație — acesta se va desfășura pe fiecare dintre clusterele noastre copil. Dacă luăm un configmap, un secret, și îl desfășurăm prin federație — acesta se va răspândi în toate clusterele noastre copil; în același timp, federația permite personalizarea resurselor noastre pe copii. Adică am luat un configmap, l-am desfășurat prin federație și apoi, dacă avem nevoie să ajustăm ceva pe clusterele specifice, ne îndreptăm să modificăm pe un cluster separat, iar această modificare nu se va mai sincroniza nicăieri.
Federatia Kubernetes — un instrument care a apărut nu cu mult timp în urmă și nu suportă întregul set de resurse oferit de K8s: în momentul publicării uneia dintre primele versiuni ale documentației, se menționa că suportă doar config maps, deployment pentru replica set, ingress. Secretele nu sunt acceptate, iar lucrul cu volumele nu este nici el suportat. Este un set de resurse prea limitat. Mai ales dacă ne place să ne distrăm, — de exemplu, prin definiții de resurse personalizate, care transmit propriile noastre resurse Kubernetes-ului, — în federație nu le putem integra. Adică, într-un fel... este o soluție care pare adevărată, dar ne face să ne împușcăm periodic în picior. Pe de altă parte, federația ne permite să gestionăm flexibil replica setul nostru. De exemplu, dorim să avem 10 replici ale aplicației noastre, iar federația, implicit, va împărți acest număr proporțional între numărul de clustere. Și totul poate fi configurat! Deci putem specifica că pe clusterul de producție trebuie să menținem 6 replici ale aplicației noastre, iar pe clusterul de rezervă, pentru economisirea resurselor sau pentru distracții personale — doar 4 replici ale aplicației noastre. Ceva destul de convenabil. Dar, cu federația, trebuie să folosim anumite soluții noi, să desfășurăm ceva pe parcurs, să ne forțăm să gândim puțin mai mult...
Există o modalitate mai simplă de a aborda procesul de rezervare a Kubernetes-ului? Ce instrumente avem la dispoziție?
În primul rând, avem întotdeauna un sistem ci/cd, adică nu mergem manual, nu scriem pe servere create/aplicate. Sistemul generează yaml-uri pentru containerele noastre.
În al doilea rând, există mai multe clustere, fie avem unul, fie mai multe (dacă suntem deștepți) registre, pe care le-am rezervat și pe acestea. Și există o utilitară minunată, kubectl, care poate lucra cu mai multe clustere simultan.
Asta este: din punctul meu de vedere, cea mai simplă și eficientă soluție pentru construirea unui cluster de rezervă este un deployment paralel primitiv. Există un pipeline în sistemul ci/cd; mai întâi construim containerele noastre, le testăm și desfășurăm aplicațiile prin kubectl pe mai multe clustere independente. Putem realiza desfășurări simultane pe mai multe clustere. Prin urmare, livrarea configurațiilor o soluționăm și în această etapă. Putem defini dinainte un set de configurații pentru clusterul nostru de producție, un set de configurații pentru clusterul de rezervă și la nivelul sistemului ci/cd desfășurăm mediu de producție în clusterul de producție, mediu de rezervă - în clusterul de rezervă. Spre deosebire de federație, nu trebuie să mergem după ce am definit resursa federală pe fiecare cluster secundar și să redefinim ceva. Am făcut asta dinainte. Suntem foarte dăștepți.
Dar… există… am scris, există „rădăcina tuturor răului”, dar de fapt sunt două. În primul rând, sistemul de fișiere. Există un anumit PV, fie folosim un stoc extern. Dacă stocăm fișierele în interiorul clusterului, atunci trebuie să acționăm conform vechilor practici rămase din perioada infrastructurilor hardware: de exemplu, să sincronizăm cu lsync. Sau cu oricare altă soluție preferată de dvs. desfășurăm totul pe celelalte mașini și trăim.
În al doilea rând, și, de fapt, chiar și mai importantă, este baza de date. Dacă suntem oameni deștepți și nu păstrăm baza în kubernetes, atunci procesul de rezervare a datelor conform aceleași scheme vechi - replicare master-slave, apoi comutare, vom prinde replica și vom trăi bine. Dar dacă păstrăm baza noastră de date în interiorul clusterului, atunci există multe soluții gata pregătite pentru organizarea aceleași replici master-slave, multe soluții pentru ridicarea bazei de date în interiorul kubernetes.
Despre rezervarea bazelor de date s-au scris miliarde de prezentări, s-au scris miliarde de articole, nu este nimic nou aici, de fapt. În general, urmați-vă visul, trăiți cum doriți, inventați-vă și voi soluții complicate, dar gândiți-vă întotdeauna cum veți rezerva toate acestea.
Și acum, să discutăm despre cum va decurge procesul de comutare la un site de rezervă în caz de incendiu. În primul rând, desfășurăm aplicații stateless în paralel. Acestea nu afectează logica de afaceri a aplicațiilor noastre și a proiectului nostru; putem menține constant două seturi de aplicații rulante, iar acestea pot începe să primească trafic. Este foarte important, în cadrul procesului de comutare la site-ul de rezervă, să verificăm dacă trebuie să redefinim configurațiile. De exemplu, avem un cluster Kubernetes de producție, un cluster Kubernetes de rezervă, o bază de date externă principală și o bază de date principală de rezervă. Avem patru opțiuni pentru modul în care aceste aplicații de producție pot începe să interacționeze între ele. Poate fi comutată baza de date și se poate întâmpla să fie necesară comutarea traficului în clusterul de producție către noua bază de date. Alternativ, clusterul poate să se prăbușească — și atunci ne mutăm pe rezervă, dar continuăm să lucrăm cu baza de date de producție; și a treia opțiune este atunci când s-au prăbușit ambele — și comutăm ambele aplicații, redefinind configurația noastră astfel încât noile aplicații să lucreze cu noua bază de date.
Așadar, care sunt concluziile pe care le putem trasa din toate acestea?
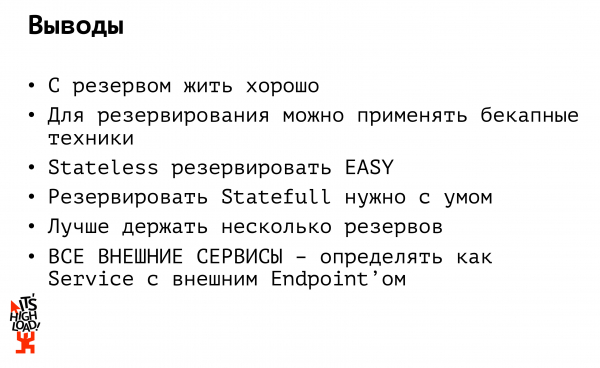
Prima concluzie: a trăi cu un rezerv este bine, dar costisitor. În ideal, nu ar trebui să avem doar un singur rezerv. Ideal ar fi să avem mai multe rezerve. În primul rând, rezervul nu trebuie să fie în același centru de date, iar în al doilea rând, ideal ar fi să fie la un alt furnizor. Am avut peste 10 asemenea cazuri în practica mea. Proiectele nu le pot numi, dar când a avut loc incendiul în centrul de date… Eu am spus: comutăm pe rezerv! Iar serverele de rezervă se aflau în același rack...
Sau imaginați-vă că Amazon a fost interzis în Rusia (așa s-a întâmplat). Și gata: ce rost are că rezerva noastră se află în alt Amazon? Este, de asemenea, inaccesibil. Așa că repet: trebuie să avem rezerve, cel puțin într-un alt centru de date, dar ideal — la un alt furnizor.
Al doilea sfat: dacă aveți o aplicație în Kubernetes care comunică cu surse externe (fie că e vorba de o bază de date sau de un API extern), asigurați-vă că o definiți ca un serviciu cu Endpoint extern, astfel încât la schimbare să nu fie nevoie să redeployați 15 aplicații care accesează aceeași bază de date. Definiți baza de date ca un serviciu separat, accesați-o ca și cum ar fi în cadrul cluster-ului: dacă baza de date se defectează, schimbați IP-ul într-un singur loc și continuați să funcționați ca și până acum.
Și, în final: îmi place «cubul», la fel cum îmi plac experimentele cu el. De asemenea, îmi place să împărtășesc rezultatele acestor experimente și, în general, experiența mea personală. De aceea, am înregistrat o serie de webinarii despre K8s, vă invit pe pentru detalii.
Sursa: habr.com
