

este un standard (ISO, ITU-T, GOST) al unui limbaj care descrie informații structurale, precum și reguli de codificare a acestor informații. Pentru mine, ca programator, acesta este pur și simplu un alt format de serializare și reprezentare a datelor, alături de JSON, XML, XDR și alte formate. Este extrem de comun în viața noastră de zi cu zi, și mulți se confruntă cu el: în comunicațiile mobile, telefonie, VoIP (UMTS, LTE, WiMAX, SS7, H.323), în protocoalele de rețea (LDAP, SNMP, Kerberos), în tot ceea ce ține de criptografie (X.509, CMS, standarde PKCS), în cardurile bancare și pașapoartele biometrice, și în multe alte domenii.
În acest articol se discută : biblioteca Python ASN.1 folosită activ în proiecte legate de criptografie în .
De fapt, nu ar trebui să recomandăm ASN.1 pentru sarcini de criptografie: ASN.1 și codecurile sale sunt complicate. Acest lucru înseamnă că codul va fi complex, iar aceasta este întotdeauna o direcție suplimentară de atac. E suficient să ne uităm vulnerabilităților din bibliotecile ASN.1. Bruce Schneier în cartea sa de asemenea, nu recomandă utilizarea acestui standard din cauza complexității sale: „Cea mai cunoscută codificare TLV este ASN.1, dar este incredibil de complex și ne abținem de la utilizarea acesteia”. Dar, din păcate, astăzi avem în care sunt folosite activ , CRL, OCSP, TSP, protocoalele CMP, , mesaje , și o mulțime de standarde . Așadar, trebuie să știm să lucrăm cu ASN.1, dacă ne ocupăm de ceva legat de criptografie.
ASN.1 poate fi codificat în multe feluri/codecuri:
- (Basic Encoding Rules)
- (Canonical Encoding Rules)
- (Distinguished Encoding Rules)
- (Generic String Encoding Rules)
- (JSON Encoding Rules)
- LWER (Light Weight Encoding Rules)
- (Octet Encoding Rules)
- (Packed Encoding Rules)
- SER (Signalling specific Encoding Rules)
- (XML Encoding Rules)
și multe altele. Dar în sarcinile de criptografie, în practică, sunt folosite două: BER și DER. Chiar și în documentele XML semnate (, ) vor fi totuși obiecte ASN.1 DER codificate în Base64, așa cum sunt în protocolul orientat pe JSON de la Let’s Encrypt. Cel mai bine este să te familiarizezi cu toate aceste codecuri și principiile de codificare BER/CER/DER în articolele și cărțile: , , .
BER este un format TLV binar orientat pe octeți (de exemplu PER, popular în comunicațiile mobile — orientat pe biți). Fiecare element este codificat sub forma: etichetei (Tag), identificând tipul elementului codificat (număr întreg, string, dată etc.), lungime (Llungimea) conținutului și a conținutului în sine (Vvaloare). BER permite opțional omisiunea specificării valorii lungimii, stabilind o valoare specială de lungime indefinită și terminând mesajul cu eticheta End-Of-Octets. Pe lângă codificarea lungimii, în BER există multe variații în modul de codificare a tipurilor de date, cum ar fi:
- INTEGER, OBJECT IDENTIFIER, BIT STRING și lungimea elementului pot fi nenormalizate (necodificate în forma minimă);
- BOOLEAN este adevărat pentru orice conținut nenul;
- BIT STRING poate conține biți nuli„de rezervă”;
- BIT STRING, OCTET STRING și toate soiurile lor de tipuri de șiruri, inclusiv data/timpul, pot fi divizate în fragmente (chunk) de lungime variabilă, lungimea cărora în timpul (de)codării nu este cunoscută anterior;
- UTCTime/GeneralizedTime pot avea diferite modalități de specificare a decalajului fusului orar și „biți de rezervă” nuli la fracțiuni de secundă;
- Valorile DEFAULT SEQUENCE pot fi codificate sau nu;
- Valorile denumite ale ultimilor biți din BIT STRING pot fi, la alegerea utilizatorului, omise din codificare;
- SEQUENCE (OF)/SET (OF) pot avea o ordine aleatorie a elementelor.
Din cauza tuturor celor de mai sus, codificarea datelor astfel încât să fie identice cu forma originală nu este întotdeauna posibilă. De aceea, a fost inventat un subset de reguli: DER — reglează strict un singur mod acceptat de codificare, ceea ce este critic pentru probleme criptografice, unde, de exemplu, modificarea unui singur bit va invalida semnătura sau suma de control. DER are un dezavantaj semnificativ: lungimile tuturor elementelor trebuie să fie cunoscute anterior în timpul codării, ceea ce nu permite serializarea datelor în flux. Codec-ul CER nu are această insuficiență, garantând de asemenea o reprezentare univocă a datelor. Din păcate (sau din fericire că nu avem încă decodoare și mai complicate?), nu a devenit popular. Prin urmare, în practică întâlnim o utilizare „mixtă” a datelor codificate în BER și DER. Deoarece atât CER, cât și DER sunt submulțimi ale BER, orice decoder BER le poate procesa.
Problemele cu pyasn1
La lucru, scriem multe programe în Python legate de criptografie. Și cu câțiva ani în urmă, opțiunile bibliotecilor libere erau aproape inexistente: fie erau biblioteci de foarte nivel scăzut care permiteau doar codificarea/decodificarea, de exemplu, a unui număr întreg și a unui antet de structură, fie era biblioteca . Am trăit pe aceasta timp de câțiva ani și, la început, am fost foarte mulțumiți, deoarece permite lucrul cu structuri ASN.1 ca și cum ar fi obiecte de nivel înalt: de exemplu, obiectul decodat al certificatului X.509 ne permite să accesăm câmpurile sale printr-un interface de tip dicționar: cert[„tbsCertificate”][„serialNumber”] ne va arăta numărul de serie al acestui certificat. În mod similar, putem „recompune” obiecte complexe, lucrând cu ele ca și cum ar fi liste sau dicționare, și apoi să apelăm pur și simplu funcția pyasn1.codec.der.encoder.encode pentru a obține o reprezentare serializată a documentului.
Cu toate acestea, au apărut defecte, probleme și limitări. În pyasn1 au existat și, din păcate, încă mai există erori: la momentul redactării articolului, în pyasn1 unul dintre tipurile de bază — GeneralizedTime, decodat și codificat.
În proiectele noastre, pentru a economisi spațiu, de multe ori stocăm doar calea către fișier, deplasarea și lungimea în bytes a obiectului la care dorim să ne referim. De exemplu, un fișier semnat arbitrar va fi cu siguranță găsit în structura ASN.1 CMS SignedData:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 AICI SE AFLĂ CONȚINUTUL FIȘIERULUI SEMNAT DE MĂSURĂ DE 751 bytes

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
și putem obține fișierul original semnat, cu un offset de 65 de bytes și o lungime de 751 de bytes. pyasn1 nu stochează aceste informații în obiectele sale decodificate. A fost creat așa-numitul TLVSeeker — o bibliotecă mică care permite decodificarea etichetelor și lungimilor obiectelor, în care am folosit comenzi precum „mergi la următoarea etichetă”, „intra în etichetă” (mergem în interiorul obiectului SEQUENCE), „mergi la următoarea etichetă”, „raportează-ți offset-ul și lungimea obiectului unde ne aflăm”. Aceasta a fost o navigare „manuală” prin datele ASN.1 codificate în DER. Însă așa nu se putea lucra cu datele codificate în BER, deoarece, de exemplu, un șir de bytes de tip OCTET STRING ar fi putut fi codificat în mai multe chunk-uri.
O altă deficiență a pyasn1 pentru nevoile noastre este imposibilitatea de a determina din obiectele decodificate dacă un câmp specific a fost prezent în SEQUENCE sau nu. De exemplu, dacă structura conține câmpul Field SEQUENCE OF Smth OPTIONAL, acesta ar fi putut lipsi complet din datele primite (OPTIONAL) sau ar fi putut fi prezent, dar cu lungimea zero (listă goală). În general, acest lucru nu putea fi determinat. Și aceasta este necesară pentru o verificare stringentă a validității datelor sosite. Imaginează-ți că un centru de certificare ar fi emis un certificat cu date „nu tocmai” valide din perspectiva schemei ASN.1! De exemplu, centrul de certificare „TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı” în certificatul său rădăcină a depășit limitele acceptabile. limita lungimii componentei subject — nu poate fi decodificat corect conform schemei. Codec-ul DER impune ca un câmp al cărui valoare este DEFAULT să nu fie codificat la transmitere — în practică, documente de acest tip apar, iar prima versiune PyDERASN chiar a permis în mod conștient un astfel de comportament invalid (din perspectiva DER) din motive de compatibilitate inversă.
O altă limitare este imposibilitatea de a ști cu ușurință în ce format (BER/DER) a fost codificat un anumit obiect în structură. De exemplu, standardul CMS spune că mesajul este codificat în BER, dar câmpul signedAttrs, peste care se formează semnătura criptografică, trebuie să fie în DER. Dacă decodificăm folosind DER, vom cădea pe procesarea CMS-ului, iar dacă decodificăm cu BER, nu vom ști în ce format a fost signedAttrs. În cele din urmă, va trebui să folosim TLVSeeker (un analog care nu există în pyasn1) pentru a căuta locația fiecărui câmp signedAttrs și să-l extragem separat din reprezentarea serializată, decodificându-l cu DER.
O caracteristică foarte dorită de noi era posibilitatea de a trata automat câmpurile DEFINED BY, care apar foarte frecvent. După decodificarea structurii ASN.1, pot rămâne multe câmpuri ANY care trebuie procesate în continuare conform schemei, alese pe baza OBJECT IDENTIFIER specificat în câmpul structurii. În codul Python, aceasta înseamnă scrierea unui if și apelarea decodorului pentru câmpul ANY.
Apariția PyDERASN
În Atlas, trimitem regulat patch-uri către părțile superioare ori de câte ori identificăm probleme sau îmbunătățim programele libere folosite. În pyasn1, am trimis de câteva ori modificări, dar codul pyasn1 nu este cel mai ușor de înțeles și uneori apăreau modificări incompatibile ale API-ului, care ne afectau. În plus, ne-am obișnuit să scriem teste cu testare generativă, ceea ce nu exista în pyasn1.
Într-o zi frumoasă, am decis că a fost suficient și era timpul să încerc să scriu propria bibliotecă cu __slot__-uri, offset-uri și blob-uri care se afișează frumos! A crea un codec ASN.1 ar fi fost insuficient — trebuie să migrez toate proiectele noastre interdependente pe ea, iar asta reprezintă sute de mii de linii de cod în care lucrăm cu structuri ASN.1. Astfel, una dintre cerințele pentru ea a fost: ușurința de a transpune codul existent în pyasn1. Într-un anume an, mi-am dedicat toate vacanțele pentru a scrie această bibliotecă și am migrat toate proiectele pe ea. Deoarece acestea au o acoperire de aproape 100% cu teste, aceasta a însemnat și funcționalitatea completă a bibliotecii.
PyDERASN, de asemenea, are o acoperire de aproape 100% cu teste. Folosește testare generativă cu o bibliotecă minunată . De asemenea, a fost efectuat și -pe pe mașini cu 32 de nuclee. Deși aproape că nu mai avem cod Python2, PyDERASN respectă în continuare compatibilitatea cu acesta și din această cauză are o singură dependență. În plus, a fost testat împotriva .
Principiul de funcționare este similar cu pyasn1 — lucrul cu obiecte de nivel înalt în Python. Descrierea schemelor ASN.1 este asemănătoare.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Cu toate acestea, PyDERASN are un fel de tipizare strictă. În pyasn1, dacă un câmp avea tipul CMSVersion(INTEGER), el putea fi atribuit un int sau INTEGER. PyDERASN impune strict ca obiectul atribuit să fie exact CMSVersion. În plus, pe lângă faptul că scriem cod Python3, folosim și , așa că în funcțiile noastre nu vor fi argumente neclare de tipul def func(serial, contents), ci def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), iar PyDERASN ajută la menținerea unui astfel de cod.
În același timp, PyDERASN oferă facilități foarte utile pentru această tipizare. pyasn1 nu permitea în SubjectKeyIdentifier().subtype(implicitTag=Tag(…)) să se atribuie un obiect SubjectKeyIdentifier() (fără tag-ul IMPLICIT necesar) și era adesea necesar să se copieze și să se recreeze obiecte doar din cauza modificărilor tag-urilor IMPLICIT/EXPLICIT. PyDERASN respectă strict doar tipul de bază — tag-urile sunt introduse automat din schema existentă ASN.1. Acest lucru simplifică semnificativ codul aplicațiilor.
Dacă apare o eroare în timpul decodării, în pyasn1 nu este ușor de înțeles exact unde s-a produs aceasta. De exemplu, în certificatul turcesc menționat anterior, vom primi o astfel de eroare: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (la 138) limite nesatisfăcute: 1 ⇐ 77 ⇐ 64. Atunci când se scriu structuri ASN.1, oamenii pot face greșeli, iar acest lucru ajută la depanarea mai ușoară a aplicațiilor sau la identificarea problemelor documentelor codificate de cealaltă parte.
În prima versiune, PyDERASN nu avea suport pentru codificarea BER. A apărut mult mai târziu și încă nu este suportată procesarea UTCTime/GeneralizedTime cu fusuri orare. Acest lucru va veni în viitor, deoarece proiectul este scris în principal în timpul liber.
De asemenea, în prima versiune nu a existat suport pentru câmpurile DEFINED BY. După câteva luni, această și a început să fie utilizată activ, reducând semnificativ codul aplicațiilor — cu o singură operație de decodare se putea obține întreaga structură analizată până la cele mai adânci niveluri. Pentru aceasta, în schemă se definesc ce câmpuri ce „definește”. De exemplu, descrierea schemei CMS:
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
indică faptul că dacă contentType va conține OID cu valoarea id_signedData, atunci câmpul content (aflat în această SEQUENCE) trebuie decodificat conform schemei SignedData. De ce atât de multe paranteze? Un câmp poate „defini” mai multe câmpuri simultan, așa cum se întâmplă în structurile EnvelopedData. Câmpurile definite sunt identificate prin așa numitul decode path — acesta stabilește locația exactă a oricărui element în toate structurile.
Nu întotdeauna dorim sau nu tot timpul avem posibilitatea de a adăuga aceste defines în schemă. Pot exista cazuri specifice aplicațiilor când OID-urile și structurile sunt cunoscute doar într-un proiect extern. PyDERASN oferă posibilitatea de a specifica aceste defines chiar în momentul decodării structurii:
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Aici spunem că în CMS SignedData, pentru toate certificatele atașate, să decodificăm toate extensiile lor (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool etc.). Indicam prin decode path, cărui element trebuie să îi „adăugăm” defines, ca și cum ar fi fost definit în schemă.
În cele din urmă, PyDERASN are capacitatea de a funcționa din pentru a decodifica fișiere ASN.1 și are un bogat . Se pot decodifica ASN.1 arbitrare sau se poate specifica o schemă fixă și se poate vedea ceva de genul:
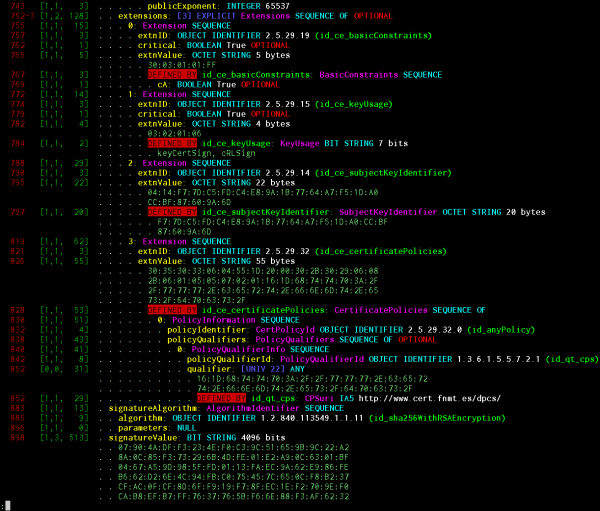
Informațiile afișate: deplasarea obiectului, lungimea etichetei, lungimea conținutului, existența EOC (end-of-octets), indicatorul codării BER, indicatorul codării indefinite-length, lungimea și deplasarea etichetei EXPLICIT (dacă există), adâncimea de imbricare a obiectului în structuri, valoarea IMPLICIT/EXPLICIT a etichetei, numele obiectului conform schemei, tipul său de bază ASN.1, numărul de ordine în cadrul SEQUENCE/SET OF, valoarea CHOICE (dacă există), denumirea ușor de înțeles pentru INTEGER/ENUMERATED/BIT STRING conform schemei, valoarea oricărui tip de bază, flagul DEFAULT/OPTIONAL din schemă, indicatorul că obiectul a fost decodat automat ca DEFINED BY și OID-ul prin care s-a realizat aceasta, OID-ul ușor de înțeles.
Sistemul de pretty printing este conceput astfel încât să genereze o secvență de obiecte PP, care sunt vizualizate deja prin instrumente separate. În captura de ecran este arătat renderer-ul în text colorat simplu. Există de asemenea renderer-e în format JSON/HTML, pentru a putea fi vizualizat cu evidențiere în browser ASN.1. proiect.
Alte biblioteci
Nu a fost un scop, dar PyDERASN s-a dovedit a fi semnificativ decât pyasn1. De exemplu, decodificarea fișierelor CRL de dimensiuni de megabyte poate dura atât de mult timp, încât trebuie să ne gândim la formate intermediare de stocare a datelor (rapide) și să schimbăm arhitectura aplicațiilor. pyasn1 decodifică CRL pe laptopul meu în mai mult de 20 de minute, în timp ce PyDERASN face aceasta în doar 28 de secunde! Există un proiect , destinat unei lucrări rapide cu structuri criptografice: decodifică (complet, nu lazy) același CRL în 29 de secunde, dar consumă aproape de două ori mai multă memorie RAM la pornirea sub Python3 (983 MiB față de 498), și de 3,5 ori mai mult sub Python2 (1677 față de 488), în timp ce pyasn1 consumă de 4,3 ori mai mult (2093 față de 488).
asn1crypto, pe care l-am menționat, nu l-am luat în considerare, deoarece proiectul era încă la început, și nu am auzit de el. Acum nu ne-am uita în direcția lui, pentru că am descoperit imediat că același GeneralizedTime nu acceptă formate arbitrare, iar în timpul serializării elimină fără avertisment fracțiunile de secundă. Acest lucru este acceptabil pentru lucrul cu certificate X.509, dar în general nu este adecvat.
În prezent, PyDERASN este cel mai strict dintre decodoarele DER gratuite Python/Go pe care le cunosc. În biblioteca encoding/asn1 a iubitului meu Go IDENTIFICATOR DE OBIECT și string-uri UTCTime/GeneralizedTime. Uneori, rigurozitatea poate interveni (în principal din cauza compatibilității inverse cu aplicațiile mai vechi, pe care nimeni nu le va actualiza), astfel încât în PyDERASN, în timpul decodificării, se pot transmite verificări relaxate.
Codul proiectului încearcă să fie cât mai simplu posibil. Întreaga bibliotecă este un singur fișier. Codul este scris cu accent pe simplitatea înțelegerii, fără optimizări de performanță excesive și fără DRY-code. Nu există, așa cum am menționat, suport complet pentru decodificarea BER a string-urilor UTCTime/GeneralizedTime, precum și pentru tipurile de date REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING. În toate celelalte cazuri, personal nu văd sensul de a utiliza alte biblioteci în Python.
Ca toate proiectele mele, tipul , , , , PyDERASN este complet , distribuit conform termenilor , și disponibil pentru descărcare gratuită. Exemple de utilizare există în și în .
, , membru , dezvoltator Python/Go, specialist principal .
Sursa: habr.com
