

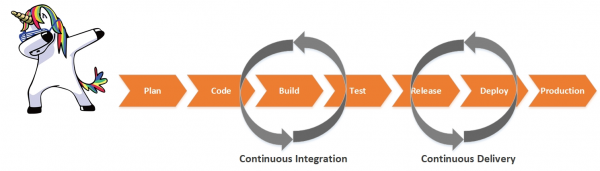
În prezent, tema DevOps este foarte populară. Conveiorul de integrare și livrare continuă este implementat de toți cei care nu sunt leneși. Dar majoritatea nu acordă întotdeauna atenție adecvată asigurării fiabilității sistemelor informaționale în diferitele etape ale Pipeline-ului CI/CD. În acest articol, aș dori să discut despre experiența mea în automatizarea verificărilor calității software-ului și realizarea unor scenarii posibile pentru «auto-reparația» acestuia.
Lucrez ca inginer în departamentul de management al serviciilor IT în compania . Direcția mea principală de specializare este implementarea diverselor sisteme de monitorizare a performanței și disponibilității aplicațiilor. Comunică frecvent cu clienții IT din diferite segmente de piață cu privire la problemele actuale legate de monitorizarea calității serviciilor lor IT. Sarcina principală este de a minimiza timpul de ciclu al lansării și de a crește frecvența acestora. Asta e bine, mai multe lansări – mai multe caracteristici noi – mai mulți utilizatori mulțumiți – mai multe profituri. Dar, în realitate, nu totul iese bine. În cazul unei viteze foarte mari de desfășurare, apare imediat întrebarea despre calitatea lansărilor noastre. Chiar și cu un conveior complet automatizat, una dintre cele mai mari probleme este transferul serviciilor din testare în producție, fără a afecta timpul de funcționare neîntreruptă și interacțiunea utilizatorilor cu aplicația.
În urma numeroaselor discuții cu clienții, pot spune că controlul calității lansărilor, problema fiabilității aplicației și capacitatea acesteia de «auto-reparație» (de exemplu, revenirea la o versiune stabilă) în diferitele etape ale conveiorului CI/CD – sunt printre cele mai îngrijorătoare și actuale teme.
Recent, am lucrat și eu din partea clientului – în serviciul de suport pentru software-ul aplicațiilor unei bănci online. În arhitectura aplicației noastre s-au utilizat un număr mare de microservicii personalizate. Cea mai tristă parte este că nu toți dezvoltatorii s-au descurcat cu ritmul rapid de dezvoltare, calitatea unor microservicii a avut de suferit, ceea ce a generat porecle amuzante pentru acestea și creatorii lor. Au apărut povești despre materialele din care sunt fabricate aceste produse.
«Formularea sarcinii»
O frecvență ridicată a lansărilor și un număr mare de microservicii complică înțelegerea funcționării aplicației în ansamblu, atât în etapa de testare, cât și în etapa de exploatare. Schimbările se produc constant și este foarte dificil să le controlezi fără instrumente de monitorizare adecvate. Adesea, după o lansare nocturnă, dimineața, dezvoltatorii stau pe un butoi de pulbere așteptând să nu se întâmple nimic grav, deși în etapa de testare toate verificările au fost de succes.
Există încă un aspect. În etapa de testare se verifică funcționarea software-ului: îndeplinirea funcțiilor de bază ale aplicației și absența erorilor. Evaluările calitative ale performanței sunt fie inexistente, fie nu iau în considerare toate aspectele funcționării aplicației și stratul de integrare. Unele metrici pot să nu fie verificate deloc. Ca urmare, atunci când apare o defecțiune în mediu de producție, departamentul de suport tehnic află despre aceasta doar când utilizatorii reali încep să se plângă. Se dorește minimizarea impactului software-ului de proastă calitate asupra utilizatorilor finali.
O soluție este implementarea proceselor de verificare a calității software-ului în diferite etape ale CI/CD Pipeline, adăugând diverse scenarii de recuperare a sistemului în caz de accidente. De asemenea, trebuie să ne amintim că avem DevOps. Afacerea așteaptă să obțină cât mai repede un produs nou. Prin urmare, toate verificările și scenariile noastre trebuie să fie automatizate.
Sarcina se împarte în două componente:
- controlul calității construcțiilor în etapa de testare (automati-zarea procesului de detectare a construcțiilor de proastă calitate);
- controlul calității software-ului în mediu de producție (mecanisme de detectare automată a problemelor și posibile scenarii de auto-reparare).
Instrument pentru monitorizarea și colectarea metricilor
Pentru a realiza sarcinile propuse, este necesară o sistemă de monitorizare capabilă să detecteze problemele și să le transfere sistemelor de automatizare în diverse etape ale conveierului CI/CD. De asemenea, ar fi un lucru pozitiv dacă această sistemă ar oferi metrici utile pentru diverse echipe: dezvoltare, testare, exploatare. Și ar fi minunat dacă ar fi utilă și pentru afaceri.
Pentru colectarea metricalor, se poate utiliza o combinație de sisteme diferite (Prometheus, ELK Stack, Zabbix etc.), dar, în opinia mea, soluțiile din clasa APM sunt cele mai potrivite pentru aceste sarcini (), care pot să vă simplifice considerabil viața.
În cadrul activității mele în serviciul de suport, am început să dezvolt un proiect similar, folosind o soluție APM de la compania Dynatrace. Acum, lucrând la un integrator, cunosc destul de bine piața sistemelor de monitorizare. Părerea mea subiectivă: Dynatrace este cea mai potrivită pentru a rezolva astfel de probleme.
Soluția Dynatrace oferă o reprezentare orizontală a fiecărei operațiuni utilizatorului, cu un grad profund de detaliere până la nivelul execuției codului. Se poate urmări întreaga lanț de interacțiune între diferitele servicii informaționale: de la nivelurile aplicațiilor web și mobile frontend, serverele aplicațiilor backend, până la o bus de integrare specific și un apel concret în Baza de Date.
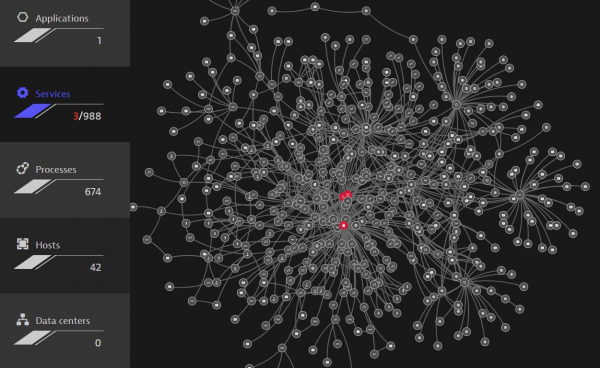 . Generarea automată a tuturor dependențelor între componentele sistemului
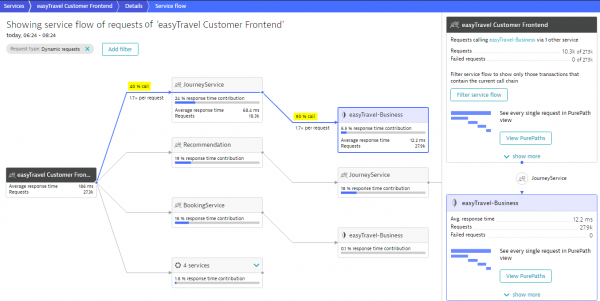 . Determinarea automată și generarea traseului de execuție a operațiunii serviciului
De asemenea, trebuie să ținem cont că trebuie să ne integrăm cu diferite instrumente de automatizare. Aici soluția are o API convenabilă, care permite trimiterea și primirea diferitelor metrici și evenimente.
Să trecem acum la o examinare mai detaliată a modului de a rezolva sarcinile propuse cu ajutorul sistemului Dynatrace.
Sarcina 1. Automatizarea controlului calității construcțiilor în etapa de testare
Prima sarcină este să găsim problemele cât mai devreme în etapele livrării aplicației. Numai construcțiile de cod 'bune' ar trebui să ajungă în mediul de producție. Pentru aceasta, în pipeline-ul dumneavoastră, în etapa de testare ar trebui incluse monitoare suplimentare pentru a verifica calitatea serviciilor dumneavoastră.
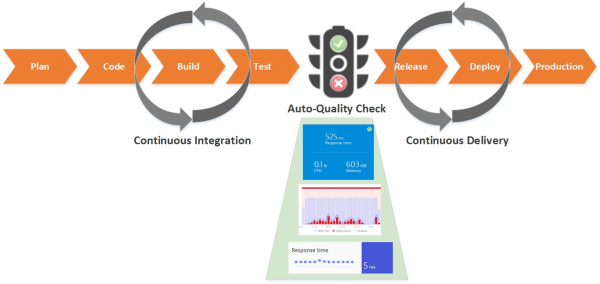
Să analizăm pas cu pas cum putem realiza și automatiza acest proces:
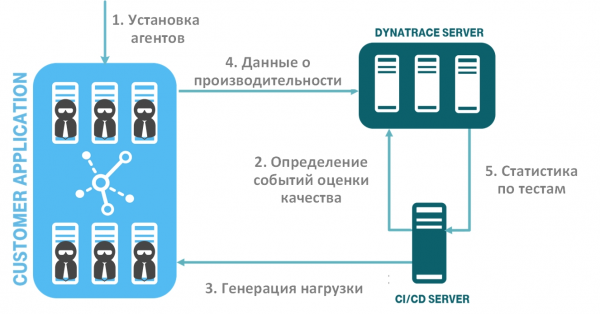
În figura este prezentat fluxul de pași automatizați pentru verificarea calității software-ului:
- implementarea sistemului de monitorizare (installarea agenților);
- definirea evenimentelor de evaluare a calității software-ului dumneavoastră (metrici și valori prag) și transmiterea acestora în sistemul de monitorizare;
- generarea de sarcini și teste de performanță;
- colectarea datelor despre performanță și disponibilitate în sistemul de monitorizare;
- transmiterea datelor despre teste bazate pe evenimente de evaluare a calității software-ului din sistemul de monitorizare în sistemul CI/CD. Analiza automată a construcțiilor.
Pasul 1. Implementarea sistemului de monitorizare
Mai întâi, trebuie să instalați agenții în mediul dvs. de testare. Soluția Dynatrace are un avantaj plăcut – folosește agentul universal OneAgent, care se instalează pe instanța OS (Windows, Linux, AIX), descoperă automat serviciile dvs. și începe să colecteze date de monitorizare pentru acestea. Nu trebuie să configurați separat agentul pentru fiecare proces. Situația este similară pentru platformele cloud și cele containerizate. De asemenea, procesul de instalare a agenților poate fi automatizat. Dynatrace se integrează perfect în conceptul de „infrastructură ca și cod” (): există deja scripturi și instrucțiuni gata făcute pentru toate platformele populare. Încorporați agentul în configurația serviciului dvs. și, la desfășurarea acestuia, veți obține instantaneu un nou serviciu cu agentul deja funcțional.
Pasul 2. Definirea evenimentelor de evaluare a calității software-ului dvs.
Acum trebuie să stabiliți lista de servicii și operațiile de afaceri. Este important să luați în considerare exact acele operații ale utilizatorilor care sunt critice pentru afacerea dvs. Aici vă recomand să consultați analiștii de afaceri și de sistem.
Apoi, trebuie să determinați ce metrici doriți să includeți în verificarea pentru fiecare dintre niveluri. De exemplu, acestea pot fi timpul de execuție (cu separare pe medie, mediană, percentili etc.), erorile (logice, de serviciu, infrastructurale etc.) și diferite metrici infrastructurale (memory heap, garbage collector, thread count etc.).
Pentru automatizare și comoditate în utilizare de către echipa DevOps, apare conceptul de „Monitorizare ca și cod”. Ce vreau să spun prin aceasta – dezvoltatorul/testerul poate scrie un simplu fișier JSON care definește indicatorii de evaluare a calității software-ului.
Să luăm în considerare un exemplu de astfel de fișier JSON. Ca pereche cheie/valoare sunt utilizate obiecte din API-ul Dynatrace (descrierea API-ului poate fi consultată aici ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
Fișierul reprezintă un array de definiții ale seriilor temporale (timeseries):
- timeseriesId – metrica verificată, de exemplu, Timp de Răspuns, Număr de Erori, Memorie Utilizată etc.;
- aggregation — nivelul de agregare al metricalor, în cazul nostru avg, dar puteți folosi orice nivel necesar (avg, min, max, sum, count, percentile);
- tags – eticheta obiectului în sistemul de monitorizare, sau puteți specifica un identificator concret al obiectului;
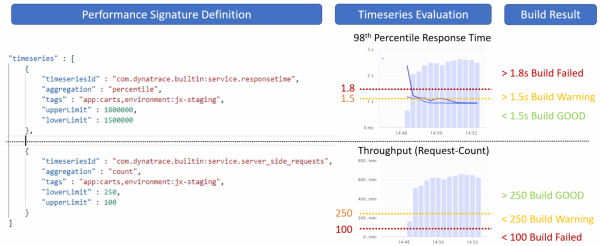
- severe și warning – aceste valori reglează pragurile metricalor noastre; dacă rezultatul testelor depășeșete pragul severe, atunci construcția noastră este marcată ca nereușită.
În figura următoare este prezentat un exemplu de utilizare a unor astfel de praguri.
Pasul 3. Generarea încărcăturii
După ce am stabilit nivelurile de calitate ale serviciului nostru, este necesar să generăm o încărcătură de test. Puteți folosi orice instrument de testare convenabil pentru dumneavoastră, cum ar fi Jmeter, Selenium, Neotys, Gatling etc.
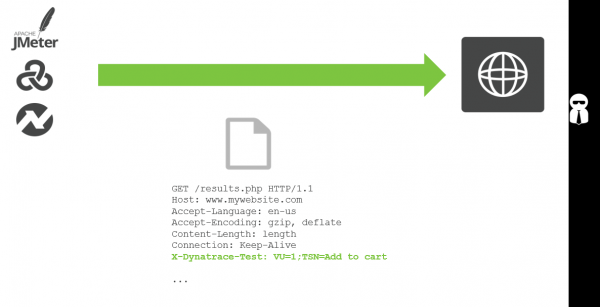
Sistemul de monitorizare Dynatrace permite capturarea diferitelor metadate din testele dumneavoastră și recunoașterea care dintre teste aparține unui anumit ciclu de lansare și la ce serviciu. Se recomandă să adăugați antete suplimentare în cererile HTTP ale testelor.
În figura următoare este prezentat un exemplu în care folosind antetul suplimentar X-Dynatrace-Test, marcăm că acest test se referă la testarea operațiunii de adăugare a unui produs în coș.
La inițierea fiecărui test de stres, trimiteți informații contextuale suplimentare în Dynatrace prin API-ul de evenimente din serverul CI/CD. Astfel, sistemul poate distinge diverse teste între ele.
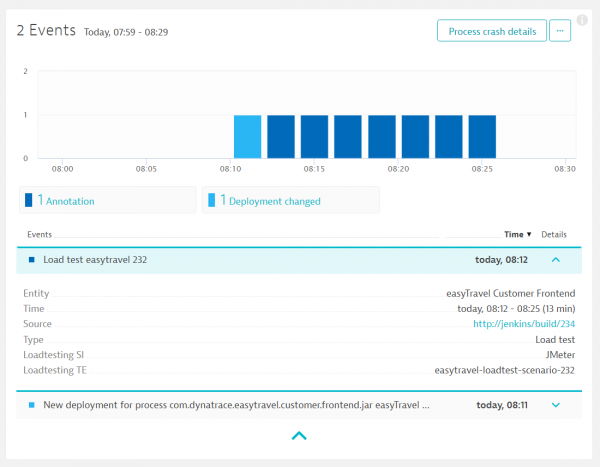 . Eveniment în sistemul de monitorizare privind inițierea testului de stres
Pasul 4-5. Colectarea datelor de performanță și transmiterea acestora în sistemul CI/CD
Împreună cu testul generat, în sistemul de monitorizare se trimite un eveniment referitor la necesitatea de a colecta date despre evaluarea indicelui de calitate al serviciului. De asemenea, se indică fișierul JSON care definește metricile cheie.
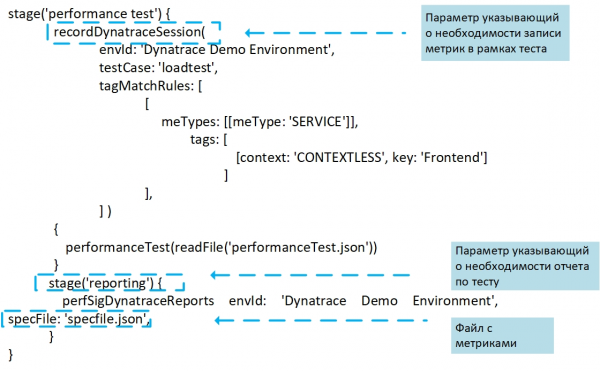 Evenimentul de necesitate a verificării calității software-ului generat pe serverul CI/CD pentru trimiterea către sistemul de monitorizare
În exemplul nostru, evenimentul de verificare a calității se numește perfSigDynatraceReport (Performance_Signature) – este un raport pregătit pentru integrarea cu Jenkins, dezvoltat de echipa de la T-Systems Multimedia Solutions. Fiecare eveniment de lansare a verificării conține informații despre serviciu, numărul versiunii, ora testării. Pluginul colectează valorile performanței în timpul construcției, le evaluează și compară rezultatul cu versiunile anterioare și cu cerințele non-funcționale.
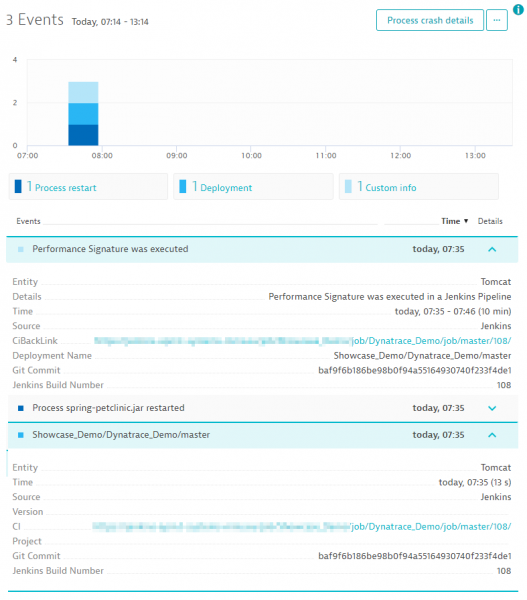 Eveniment în sistemul de monitorizare privind inițierea verificării calității construcției.
După finalizarea testului, toate metricile de evaluare a calității software-ului sunt returnate în sistemul de integrare continuă, de exemplu, Jenkins, care formează un raport cu rezultatele.
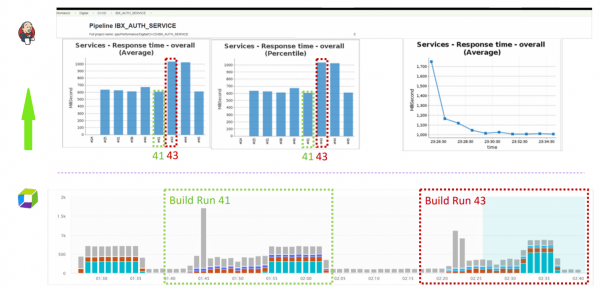 Rezultatul statisticii pe construcții pe serverul CI/CD.
Pentru fiecare construcție individuală, vedem statistica pentru fiecare metrică definită de noi pe parcursul desfășurării testului. De asemenea, putem observa dacă au fost încălcări ale anumitor valori prag (warning și severe-thresholds). Pe baza indicatorilor cumulați, întreaga construcție este marcata ca stabilă, instabilă sau eșuată. De asemenea, pentru comoditate, puteți adăuga în raport indicatori de comparație între construcția curentă și cea anterioară.
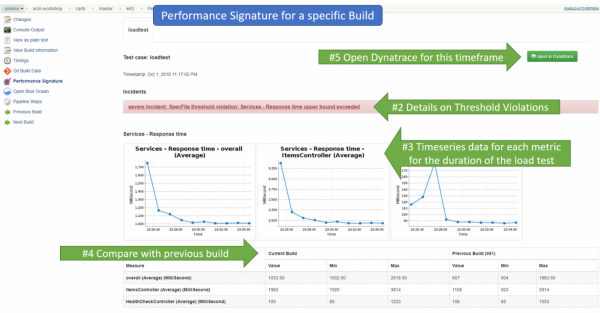 Vizualizarea statisticii detaliate pe construcții pe serverul CI/CD.
Comparație detaliată între două construcții
Dacă este necesar, se poate accesa interfața Dynatrace și acolo se poate vizualiza mai în detaliu statistica pentru fiecare construcție și compara între ele.
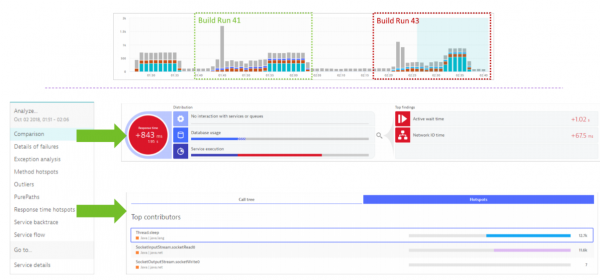 Comparația statisticii pe construcții în Dynatrace.
Conclusions
În final, obținem un serviciu de „monitorizare ca serviciu”, automatizat în cadrul pipeline-ului de integrare continuă. Dezvoltatorul sau testerul trebuie să definească doar lista de metrici în fișierul JSON, iar tot restul se întâmplă automat. Obținem un control transparent al calității versiunilor: toate notificările privind performanța, consumul de resurse sau regresiile arhitecturale.
Sarcina 2. Automatizarea controlului calității software-ului în mediul de producție
Așadar, am rezolvat sarcina de a automatiza procesul de monitorizare în etapa de testare din Pipeline. Astfel, minimizăm procentul de construcții de proastă calitate care ajung în mediul de producție.
Dar ce facem dacă software-ul defect a ajuns totuși în producție, sau dacă pur și simplu ceva se strică. Pentru utopia noastră am dori să existe mecanisme de detectare automată a problemelor și, pe cât posibil, sistemul să își refacă singur funcționalitatea, măcar noaptea.
Pentru aceasta, trebuie să prevedem, prin analogie cu secțiunea anterioară, verificări automate ale calității software-ului în mediu de producție și să elaborăm scenarii de autorefabilitate a sistemului.
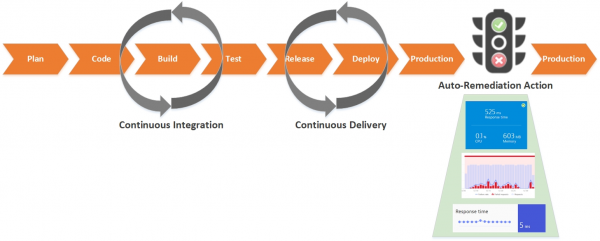
Auto-corectare ca și cod
În majoritatea companiilor există deja o bază de cunoștințe acumulată despre diferite tipuri de probleme comune și un set de acțiuni pentru rezolvarea acestora, de exemplu, repornirea proceselor, curățarea resurselor, revenirea la versiunile anterioare, restaurarea modificărilor incorecte ale configurației, creșterea sau micșorarea numărului de componente din cluster, comutarea între conturul albastru sau verde etc.
Cu toate că aceste variante de utilizare sunt cunoscute de mulți ani de multe echipe cu care discut, doar câteva s-au gândit și au investit resurse în automatizarea lor.
Dacă ne gândim, implementarea proceselor de autorefabilitate a aplicației nu este nimic complicat, trebuie doar să transformi scenariile deja cunoscute ale administratorilor tăi în cod (conceptul de „auto-corrections as code”) pe care l-ai scris anterior pentru fiecare caz specific. Scenariile de corectare automată trebuie să fie orientate spre eliminarea cauzei principale a problemei. Tu stabilești acțiunile corecte de răspuns la incident.
Ca și trigger pentru lansarea scenariului poate funcționa orice metrică din sistemul tău de monitorizare, important este ca aceste metrici să definească exact că totul este în neregulă, pentru că nu ne dorim să avem alarme false în mediu de producție.
Poți folosi orice sistem sau combinație de sisteme: Prometheus, ELK Stack, Zabbix etc. Însă voi oferi câteva exemple bazate pe soluția APM (ca exemplu, Dynatrace), care de asemenea va ajuta la simplificarea vieții tale.
În primul rând, aici găsești tot ce ține de funcționalitate din perspectiva funcționării aplicației. Soluția furnizează sute de metrici la diferite niveluri, pe care le poți folosi ca și triggeri:
- nivelul utilizatorilor (butoane, aplicații mobile, dispozitive IoT, comportamentul utilizatorilor, conversie etc.);
- nivelul serviciului și al operațiunilor (performanță, disponibilitate, erori etc.);
- nivelul infrastructurii aplicației (metrici OS ale gazdei, JMX, MQ, server web etc.);
- nivelul platformelor (virtualizare, cloud, container etc.).
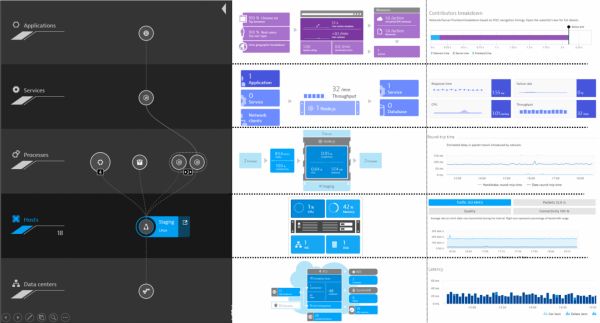 Nivelurile de monitorizare în Dynatrace.
În al doilea rând, așa cum am menționat mai devreme, Dynatrace are un API deschis care permite integrarea foarte ușoară cu diverse sisteme externe. De exemplu, trimiterea unei notificări către un sistem de automatizare atunci când se depășesc parametrii de control.
Mai jos este un exemplu pentru interacțiunea cu Ansible.
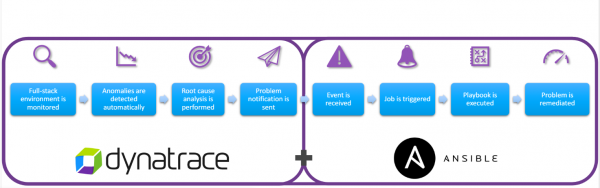
Voi oferi acum câteva exemple de automatizări care pot fi efectuate. Acestea sunt doar o parte a cazurilor, iar lista acestora în mediul dumneavoastră poate fi limitată doar de imaginația și capacitățile instrumentelor dumneavoastră de monitorizare.
1. Implementare proastă – revenire la versiunea anterioară
Chiar dacă verificăm foarte bine în mediul de testare, există totuși șansa ca noua versiune să distrugă aplicația dumneavoastră în mediu de producție. Factorul uman nu poate fi ignorat.
În următoarea diagramă vedem că există o creștere bruscă a timpului de execuție al operațiunilor pe serviciu. Începutul acestei creșteri coincide cu momentul implementării aplicației. Toate aceste informații sunt transmise ca evenimente către sistemul de automatizare. Dacă funcționalitatea serviciului nu revine la normal după timpul stabilit de noi, atunci se apelează automat un script care realizează revenirea la versiunea anterioară.
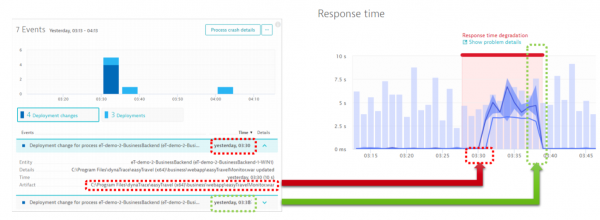 Degradarea performanței operațiunilor după implementare.
2. Utilizarea resurselor de 100% – adăugați un nod în rutare
În următorul exemplu, sistemul de monitorizare determină că unul dintre componente are o utilizare a CPU de 100%.
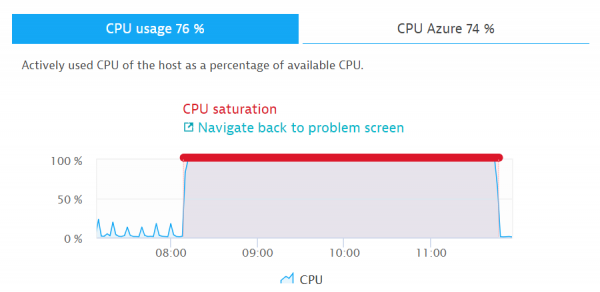 Utilizare CPU 100%
Pentru acest eveniment sunt posibile mai multe scenarii diferite. De exemplu, sistemul de monitorizare verifică suplimentar dacă lipsa resurselor este legată de creșterea sarcinii pe serviciu. Dacă da, se execută un script care adaugă automat un nod în rutare, restabilind astfel funcționalitatea sistemului în ansamblu.
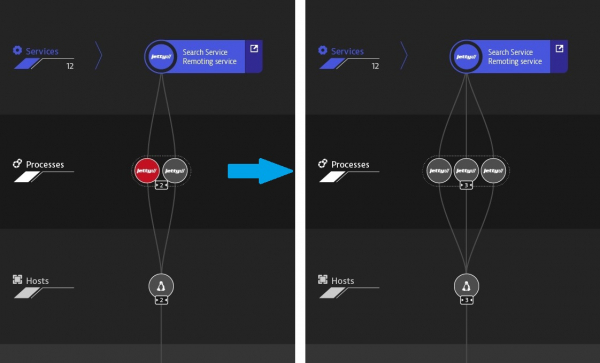 Scalarea după incident
3. Lipsa spațiului pe hard disk – curățare disk
Cred că aceste procese sunt deja automatizate pentru mulți. Cu ajutorul APM, se poate urmări și spațiul disponibil pe subsistemul de disc. În absența spațiului sau în cazul unei funcționări lente a discului, putem apela un script pentru curățare sau adăugăm spațiu.
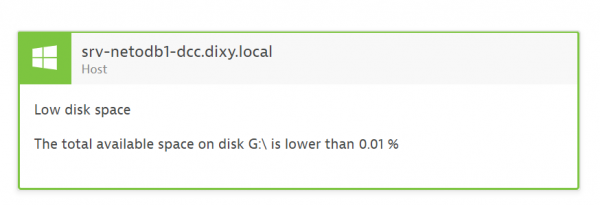
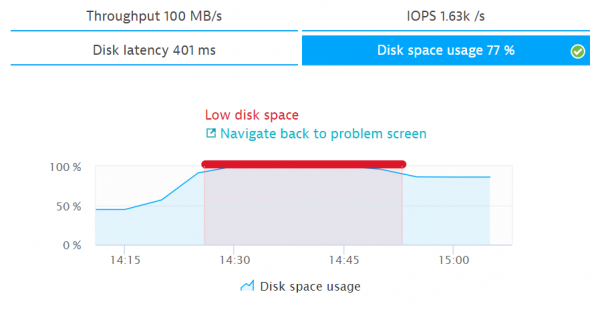 Încărcarea discului 100%
4. Activitate scăzută a utilizatorilor sau conversie scăzută – comutare între ramura albastră și cea verde
Aflat adesea în fața clienților care folosesc două contururi (blue-green deploy) pentru aplicațiile din mediu de producție. Aceasta permite comutarea rapidă între ramuri în livrarea noilor versiuni. Adesea, după un deployment, pot apărea schimbări radicale care nu sunt imediat observabile. În același timp, degradarea performanței și a disponibilității poate să nu fie observată. Pentru a răspunde rapid la aceste schimbări, este mai bine să folosim diverse metrici care reflectă comportamentele utilizatorilor (numărul de sesiuni și acțiuni ale utilizatorilor, conversie, bounce rate). În următoarea ilustrație este prezentat un exemplu, în care, atunci când conversia scade, are loc comutarea între ramurile software.
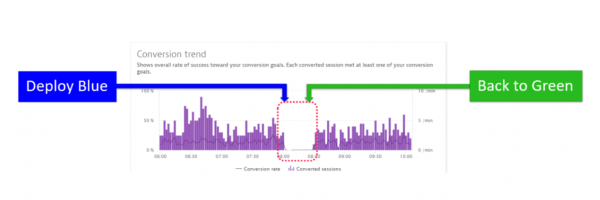 Scăderea conversiei după comutarea între ramurile software.
Mecanisme de detectare automată a problemelor
La final, voi oferi un alt exemplu pentru care îmi place cel mai mult Dynatrace.
În partea poveștii mele despre automatizarea verificării calității construcțiilor în mediu de testare, toate valorile prag au fost stabilite manual. Pentru mediu de testare, acest lucru este normal, testerul determinând indicatorii înainte de fiecare verificare în funcție de încărcare. În mediu de producție, este de dorit ca problemele să fie detectate automat, ținând cont de diverse mecanisme de baseline.
Dynatrace dispune de instrumente interesante încorporate de inteligență artificială care, pe baza mecanismelor de identificare a metricilor anormale (baselining) și a construirii unei hărți de interacțiune între toate componentele, corelează evenimentele între ele și identifică anomalii în funcționarea serviciului dumneavoastră, oferind informații detaliate pentru fiecare problemă și cauza principală.
Prin analiza automată a dependențelor dintre componente, Dynatrace nu doar că identifică serviciul problematic ca fiind cauza principală, ci și dependența acestuia de alte servicii. În exemplul de mai jos, Dynatrace monitorizează și evaluează în mod automat funcționarea fiecărui serviciu în cadrul tranzacțiilor, identificând serviciul Golang ca fiind cauza principală.
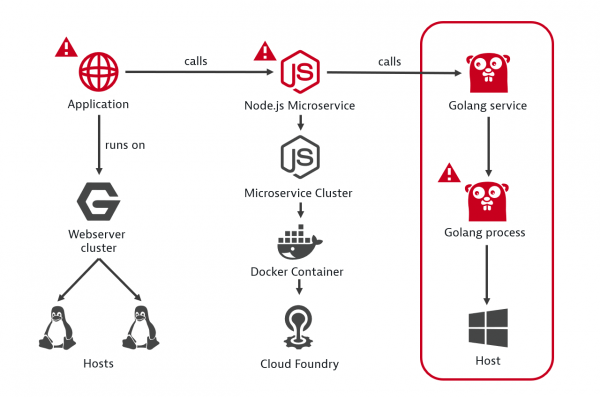 Exemplu de identificare a cauzei rădăcină a unei defecțiuni.
În imaginea următoare este reprezentat procesul de monitorizare a problemelor cu aplicația dumneavoastră de-a lungul incidentului.
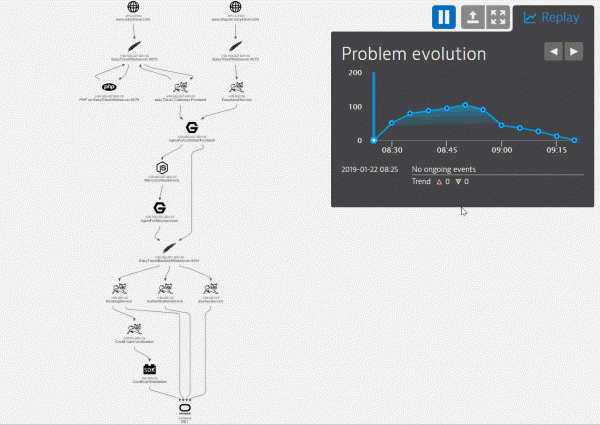 Vizualizarea problemei apărute, incluzând toate componentele și evenimentele asociate acestora.
Sistemul de monitorizare a adunat o cronologie completă a evenimentelor referitoare la problema apărută. În fereastra de sub graficele temporale, vedem toate evenimentele cheie pe fiecare dintre componente. În baza acestor evenimente, puteți stabili proceduri pentru corectarea automată prin intermediul scenariilor de cod.
De asemenea, recomand integrarea sistemului de monitorizare cu Service Desk sau un sistem de urmărire a erorilor. Atunci când apare o problemă, dezvoltatorii primesc rapid informații complete pentru analiza la nivel de cod în mediul de producție.
Concluzie
Astfel, am obținut un tensor CI/CD cu verificări automate integrate în Pipeline. Minimimizăm numărul de versiuni de calitate scăzută, îmbunătățim fiabilitatea sistemului în ansamblu și, dacă totuși funcționarea sistemului este afectată, activăm mecanismele pentru recuperarea acestuia.
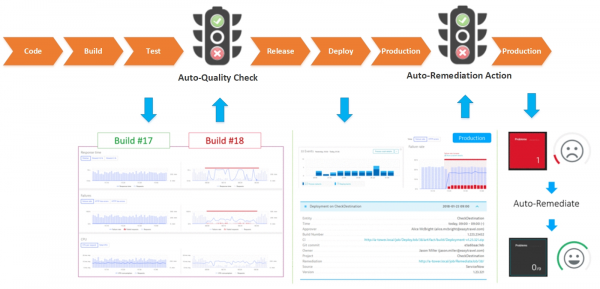
Automatizarea monitorizării calității software-ului merită cu siguranță eforturi, nu întotdeauna este un proces rapid, dar în timp va aduce beneficii. Recomand, după soluționarea unui nou incident în mediu de producție, să vă gândiți imediat la ce monitoare să adăugați pentru verificări în mediu de testare, pentru a evita introducerea unei versiuni proaste în producție, precum și să creați un script pentru corectarea automată a acestor probleme.
Sper că exemplele mele v-au fost de ajutor în demersurile dumneavoastră. De asemenea, mi-ar plăcea să văd exemplele dumneavoastră de metrici utilizate pentru implementarea auto-recustării funcționalității sistemelor.
Sursa: habr.com
