

Salut tuturor și bună ziua de vineri! Prieteni, astăzi continuăm seria de publicații dedicate cursului , deoarece cursurile din noua grupă încep deja la sfârșitul săptămânii viitoare. Așadar, să începem!
Monitorizarea este pur și simplu. Este un fapt bine cunoscut. Porniți Nagios, activați NRPE pe sistemul de la distanță, configurați Nagios pe portul TCP NRPE 5666 și aveți monitorizarea.
Este atât de ușor încât devine neinteresant. Acum aveți metricele de bază pentru timpul de procesare, subsistemul de disk, memoria RAM, care sunt disponibile implicit în Nagios și NRPE. Dar, de fapt, aceasta nu este „monitorizare” în adevăratul sens al cuvântului. Este doar începutul.
(De obicei, se instalează PNP4Nagios, RRDtool și Thruk, se configurază notificările în Slack și se intră direct pe nagiosexchange, dar deocamdată să lăsăm asta deoparte).
O monitorizare bună este de fapt destul de complicată, trebuie să înțelegeți cu adevărat inclusiv detalii tehnice ale aplicației pe care o monitorizați.
Monitorizarea este complicată?
Orice server, fie el Linux sau Windows, va servi în mod inevitabil unui anumit scop. Apache, Samba, Tomcat, stocare de fișiere, LDAP – toate aceste servicii sunt, într-o anumită măsură, unice în unul sau mai multe aspecte. Fiecare are o funcție a sa, caracteristici distincte. Există diferite moduri de a obține metricile, KPI-uri (indicatori cheie de performanță) care sunt relevante pentru dvs. atunci când serverul este sub încărcare.
Autor foto pe
(mi-aș dori ca tablourile mele de bord să fie colorate în nuanțe de albastru neon – suspinând visător –… hm…)
Orice software care furnizează servicii ar trebui să aibă un mecanism pentru a colecta metricile. Apache are modulul mod-status, care afișează pagina de stare a serverului. La Nginx există stub_status. Tomcat are JMX sau aplicații web speciale care afișează metricile cheie. În MySQL există comanda „show global status” și așa mai departe.
Atunci, de ce nu integrează dezvoltatorii astfel de mecanisme în aplicațiile pe care le creează?
Doar dezvoltatorii fac asta?
Un anumit nivel de indiferență față de integrarea metricilor nu se limitează la dezvoltatori. Am lucrat în companii care dezvoltau aplicații folosind Tomcat și nu furnizau nicio metrică proprie, niciun log de activitate al serviciului, în afară de jurnalele generale de erori Tomcat. Unii dezvoltatori generează o abundență de loguri, care nu înseamnă nimic pentru administratorul de sistem, căruia nu-i este ușor să le citească la 3:15 dimineața.
Autor foto pe
Inginerii sistemici care permit lansarea unor astfel de produse trebuie, de asemenea, să poarte o anumită responsabilitate pentru situație. Puțini ingineri sistemici au timp și se preocupă să încerce să obțină metrici semnificative din loguri, fără contextul acestor metrici și fără posibilitatea de a le interpreta în lumina activității aplicației. Unii nu înțeleg ce beneficii pot obține din asta, în afară de indicatori de tipul „ceva în prezent (sau va fi curând) nu este în regulă”.
Schimbarea mentalității în legătură cu necesitatea metricilor ar trebui să aibă loc nu doar în rândul dezvoltatorilor, ci și al inginerilor sistemici.
Pentru orice inginer sistemic care trebuie nu doar să reacționeze la evenimente critice, ci și să garanteze absența acestora, lipsa metricilor reprezintă de obicei un obstacol.
Cu toate acestea, inginerii sistemici nu se scufundă de obicei în cod, câștigând bani pentru compania lor. Au nevoie de dezvoltatori seniori care înțeleg importanța responsabilității inginerului sistemic în identificarea problemelor, sporirea conștientizării asupra problemelor de performanță și așa mai departe.
Această chestiune devops
Mentalitatea devops descrie sinergia gândirii dezvoltatorilor (dev) și a operațiunilor (ops). Orice companie care afirmă că „fac devops” ar trebui să:
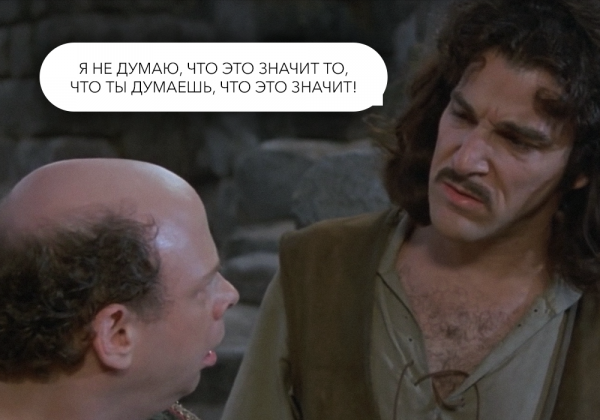
- spună ceea ce probabil că nu fac (aluzie la un meme din filmul „Prințesa-neașteptată” — „Nu cred că înseamnă ceea ce crezi că înseamnă!”)
- încurajeze o poziție de îmbunătățire continuă a produsului.
Nu poți îmbunătăți un produs și știi că a fost îmbunătățit, dacă nu știi cum funcționează în prezent. Nu vei putea înțelege cum funcționează produsul, dacă nu înțelegi cum funcționează componentele sale, serviciile de care depinde, punctele sale critice și colturile întunecate.
Dacă nu observați potențialele puncte slabe, nu veți putea aplica tehnica „Cinci de ce” în scrierea unui Postmortem. Nu veți putea aduna totul pe un singur ecran pentru a vedea cum funcționează produsul sau pentru a înțelege cum arată „normal și fericit”.
Shift la stânga, ÎN STÂNGA, AM SPUS, STÂÂÂÂÂNGAAAA—
Pentru mine, unul dintre principiile cheie ale Devops este „Shift la stânga” (shift left). În acest context, shift la stânga înseamnă mutarea capacității (nu a responsabilității, ci doar a capacității) de a face lucruri care sunt de obicei preocupările inginerilor de sistem, cum ar fi crearea metricilor de performanță, utilizarea mai eficientă a logurilor etc., în stânga ciclului de viață al livrării software-ului (Software Delivery Life Cycle).
Autor foto pe
Dezvoltatorii de software trebuie să aibă capacitatea de a folosi și de a cunoaște uneltele de monitorizare utilizate de companie, pentru a efectua monitorizarea în toate formele sale, metrici, logare, interfețe de monitorizare și, cel mai important, a observa cum funcționează produsul lor în producție. Nu puteți forța dezvoltatorii să investească energie și timp în monitorizare, atâta vreme cât nu pot vedea metricile și influența modul în care acestea arată, cum le va prezenta proprietarul produsului CTO-ului la următoarea întâlnire etc.
Pe scurt
- Puteți aduce calul la apă. Arătați dezvoltatorilor câte probleme pot evita, ajutați-i să identifice KPI-urile și metricile corecte pentru aplicațiile lor, astfel încât să fie mai puțină agitație din partea proprietarului produsului, care este certat de directorul tehnic (CTO). Scoateți-i la lumină, cu blândețe și calm. Dacă nu reușiți, atunci încercați să-i mituiți, amenințați sau convingeți fie pe ei, fie pe proprietarul produsului, pentru a implementa cât mai repede obținerea acestor metrici din aplicații, apoi să desenați diagrame. Va fi dificil, deoarece nu va fi considerat o prioritate, iar în foaia de parcurs a produsului vor exista multe proiecte în așteptare de implementare care generează venituri. Așadar, va trebui să aveți o justificare economică pentru a justifica timpul și resursele cheltuite pe implementarea monitorizării în produs.
- Ajuta inginerii sistemelor să se odihnească. Arată-le că utilizarea unui checklist pentru „lansarea unui produs” este benefică pentru orice produs care este lansat. Verificarea faptului că toate aplicațiile din producție sunt monitorizate cu metrici va ajuta la asigurarea unui somn sănătos pe timp de noapte, permițând dezvoltatorilor să observe ce nu funcționează corect. Cu toate acestea, cel mai bun mod de a irita și a stresa un dezvoltator, un proprietar de produs sau un director tehnic este să se opună constant. Un astfel de comportament va afecta data lansării oricărui produs, așa că, dacă este nevoie, apucă-te de planificarea acestora cât mai devreme. Dacă este necesar, participă la întâlnirile dedicate produsului. Poartă mustăți false și o pălărie din fetru sau ceva de genul ăsta, nu te va dezamăgi niciodată. Adu problemele tale în discuție, arată avantajele evidente și propovăduiește.
- Asigură-te că atât dezvoltatorii (dev), cât și echipa de operare (ops) înțeleg semnificația și consecințele trecerii metricilor produsului în „zona roșie”. Nu lăsa echipa de operare să fie singurul gardian al funcționării produsului, asigură-te că și dezvoltatorii sunt implicați în acest (#productsquads).
- Jurnalele sunt grozave, dar și metricile. Combină-le și nu lăsa jurnalele tale să devină gunoi într-o sferă imensă de inutilitate. Explică-le și arată-le dezvoltatorilor de ce nimeni în afară de ei nu își va da seama de jurnalele lor, arată-le cum este să privești jurnalele inutile la 3:15 dimineața.
Autor foto pe
Asta e tot. Materialul nou va fi lansat săptămâna viitoare. Dacă vrei să afli mai multe despre curs, te invităm la , care va avea loc deja luni. Și acum așteptăm, ca de obicei, comentariile tale.
Sursa: habr.com
