

Salut tuturor. Prieteni, împărtășim cu voi traducerea unui articol, pregătită special pentru studenții cursului . Să începem!
Apache Beam și DataFlow pentru conducte în timp real
Postarea de astăzi se bazează pe o provocare cu care m-am confruntat recent la muncă. Am fost cu adevărat încântat să o implementez și să descriu munca desfășurată într-un post de blog, deoarece mi-a oferit ocazia de a-mi exersa abilitățile de inginerie a datelor și, de asemenea, de a face ceva care ar fi foarte util pentru echipa mea. Nu cu mult timp în urmă, am descoperit că sistemele noastre păstrează un jurnal de utilizatori destul de mare, legat de unul dintre produsele noastre pentru gestionarea datelor. S-a dovedit că nimeni nu utiliza aceste date, așa că m-am interesat imediat de ce am putea învăța dacă am începe să le analizăm regulat. Cu toate acestea, au fost câteva probleme în calea noastră. Prima problemă a fost că datele erau stocate în multe fișiere text diferite, care nu erau accesibile pentru analiză instantanee. A doua problemă era că erau salvate într-un sistem închis, așa că nu am putut folosi niciunul dintre instrumentele mele preferate de analiză a datelor.
Trebuia să decid cum să fac accesul mai simplu pentru noi și să aduc o oarecare valoare, integrând această sursă de date în unele dintre soluțiile noastre de interacțiune cu utilizatorii. După ce am reflectat un timp, am decis să construiesc un conveier pentru a transfera aceste date într-o bază de date în cloud, astfel încât eu și echipa mea să putem accesa aceste date și să începem să generăm câteva concluzii. După ce am terminat specializarea în Data Engineering pe Coursera acum ceva vreme, eram dornic să folosesc în proiect câteva instrumente din curs.
Astfel, stocarea datelor într-o bază de date în cloud părea o soluție rațională pentru a rezolva prima mea problemă, dar ce puteam face cu problema numărul 2? Din fericire, era o modalitate de a muta aceste date într-un mediu în care putea să accesez instrumente precum Python și Google Cloud Platform (GCP). Totuși, era un proces lung, așa că trebuia să fac ceva care să îmi permită să continui dezvoltarea, în timp ce așteptam finalizarea transferului de date. Soluția la care am ajuns a fost să creez date false folosind biblioteca Faker în Python. Nu am folosit niciodată această bibliotecă înainte, dar am înțeles rapid cât de utilă este. Folosirea acestei abordări mi-a permis să încep să scriu cod și să testez fluxul fără datele reale.
Având în vedere cele spuse, în această postare voi explica cum am construit fluxul descris mai sus, folosind unele dintre tehnologiile disponibile în GCP. În special, voi folosi Apache Beam (versiunea pentru Python), Dataflow, Pub/Sub și BigQuery pentru a colecta jurnalele utilizatorilor, a transforma datele și a le trimite într-o bază de date pentru o analiză ulterioară. În cazul meu, am avut nevoie doar de funcționalitatea de procesare în loturi oferită de Beam, deoarece datele mele nu erau disponibile în timp real, deci nu am avut nevoie de Pub/Sub. Totuși, voi menționa versiunea de streaming, deoarece este ceva ce s-ar putea să întâlniți în practică.
Introducere în GCP și Apache Beam
Google Cloud Platform oferă un set de instrumente foarte utile pentru prelucrarea datelor mari. Iată câteva dintre instrumentele pe care le voi folosi:
- este un serviciu de mesagerie care folosește modelul Publisher-Subscriber, permițându-ne să primim date în timp real.
- este un serviciu care simplifică crearea fluxurilor de date și rezolvă automat sarcini precum scalarea infrastructurii, ceea ce înseamnă că ne putem concentra doar pe scrierea codului pentru fluxul nostru.
- este un depozit de date în cloud. Dacă ești familiarizat cu alte baze de date SQL, nu va fi greu să înțelegi BigQuery.
- Și în sfârșit, vom folosi Apache Beam, concentrându-ne în special pe versiunea Python pentru a crea conductele noastre. Acest instrument ne va permite să construim un conveior pentru procesare în flux sau pe loturi, care se integrează cu GCP. Este deosebit de util pentru procesarea paralelă și se potrivește pentru sarcini de tip extragere, transformare și încărcare (ETL), așa că, dacă trebuie să mutăm date dintr-un loc în altul cu transformări sau calcule, Beam este o alegere bună.
Există o varietate mare de instrumente disponibile pe GCP, așa că poate fi dificil să le urmărim pe toate și scopul lor, dar iată un rezumat al acestora pentru referință.
Pe GCP este disponibil un număr mare de instrumente, așa că poate fi dificil să le acoperim pe toate, inclusiv destinația lor, dar totuși un rezumat pentru referință.
Vizualizarea conductei noastre
Să vizualizăm componentele conductei noastre în figura 1. La un nivel înalt, dorim să colectăm datele utilizatorilor în timp real, să le procesăm și să le trimitem în BigQuery. Jurnalele sunt create atunci când utilizatorii interacționează cu produsul trimiterii de cereri către server, care sunt apoi înregistrate. Aceste date pot fi deosebit de utile pentru a înțelege cum interacționează utilizatorii cu produsul nostru și dacă acesta funcționează corect. În general, conducta va conține următoarele etape:
Beam face acest proces foarte simplu, indiferent dacă avem o sursă de date în flux sau un fișier CSV și dorim să efectuăm procesarea pe loturi. Mai târziu veți observa că în cod sunt necesare doar modificări minime pentru a comuta între ele. Acesta este unul dintre avantajele utilizării Beam.
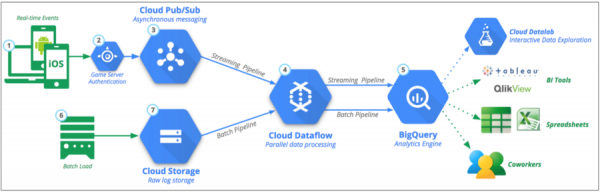
Figura 1: Conducta principală de date: Sursa:
Generarea de date false cu ajutorul Faker
Așa cum am menționat anterior, din cauza accesului limitat la date, am decis să creez date false în același format ca și cele reale. A fost un exercițiu foarte util, deoarece am putut să scriu cod și să testez conveiorul, așteptând datele. Vă propun să aruncăm o privire asupra Faker, dacă doriți să aflați ce altceva poate oferi această bibliotecă. Datele noastre de utilizator vor fi în general asemănătoare cu exemplul de mai jos. Pe baza acestui format, putem genera date pe rând pentru a simula date în timp real. Aceste jurnale ne oferă informații precum data, tipul cererii, răspunsul serverului, adresa IP etc.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Pe baza liniei de mai sus, dorim să creăm variabila noastră LINE, folosind 7 variabile în acoladele de mai jos. De asemenea, le vom folosi ca nume de variabile în schema noastră de tabele puțin mai târziu.
LINE = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Dacă am efectua procesare în loturi, codul ar fi foarte asemănător, deși ar trebui să creăm un set de eșantioane într-o anumită fereastră de timp. Pentru a folosi Faker, pur și simplu creăm un obiect și apelăm metodele de care avem nevoie. În special, Faker a fost util pentru generarea adreselor IP și a site-urilor web. Am folosit următoarele metode:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Sfârșitul primei părți.
În zilele următoare ne vom împărtăși continuarea articolului, iar acum, ca de obicei, așteptăm comentariile voastre ;-).
Sursa: habr.com
