

Salut, mă ocup cu crearea de aplicații pentru SGBD — este o platformă dezvoltată de Mail.ru Group, care combină un SGBD performant și un server de aplicații în limbajul Lua. Viteza mare de funcționare a soluțiilor bazate pe Tarantool este atinsă, în parte, datorită suportului pentru modul in-memory al SGBD-ului și posibilității de a executa logica de afaceri a aplicației în același spațiu de adresare cu datele. În același timp, se asigură persistența datelor folosind tranzacții ACID (pe disc se păstrează un jurnal WAL). Tarantool dispune de suport încorporat pentru replicare și sharding. Începând cu versiunea 2.1, sunt acceptate interogări în limbajul SQL. Tarantool are cod sursă deschis și este distribuit sub licența Simplified BSD. De asemenea, există o versiune Enterprise comercială.
Simte puterea! (…sau bucură-te de performanță)
Toate acestea fac din Tarantool o platformă atractivă pentru dezvoltarea aplicațiilor cu sarcini mari care funcționează cu baze de date. În astfel de aplicații, apare adesea nevoia de replicare a datelor.
Așa cum s-a menționat mai sus, Tarantool oferă replicare de date încorporată. Principiul său de funcționare constă în executarea secvențială pe replici a tuturor tranzacțiilor conținute în jurnalul masterului (WAL). Această replicare este denumită în continuare de nivel inferior) și este utilizată pentru a asigura reziliența aplicației și/sau pentru a distribui sarcina de citire între nodurile cluster-ului.
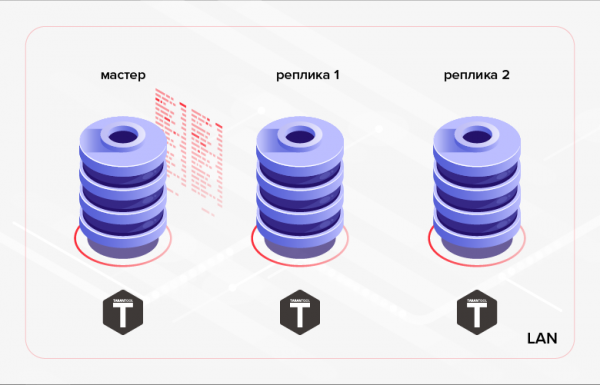
Fig. 1. Replicarea în interiorul cluster-ului
Un exemplu de scenariu alternativ poate fi transferul de date create într-o bază de date în alta pentru procesare/monitorizare. În acest din urmă caz, o soluție mai convenabilă poate fi utilizarea replicării de nivel superior — replicarea datelor la nivelul logicii de afaceri a aplicației. Asta înseamnă că nu folosim o soluție gata pregătită, încorporată în SGBD, ci implementăm replicarea în cadrul aplicației pe care o dezvoltăm. Această abordare are atât avantaje, cât și dezavantaje. Să enumerăm beneficiile.
1. Economisirea traficului:
- se pot transmite nu toate datele, ci doar o parte a acestora (de exemplu, se pot trimite doar anumite tabele, anumite coloane sau înregistrări care corespund unui anumit criteriu);
- Spre deosebire de replicarea la nivel scăzut, care se desfășoară continuu în mod asincron (implementată în versiunea curentă a Tarantool — 1.10) sau sincron (urmează a fi implementată în versiunile viitoare ale Tarantool), replicarea la nivel înalt poate fi efectuată în sesiuni (adică aplicația efectuează mai întâi sincronizarea datelor — sesiune de schimb de date, apoi urmează o pauză în replicare, după care are loc următoarea sesiune de schimb etc.);
- Dacă o înregistrare s-a schimbat de mai multe ori, se poate transmite doar ultima sa versiune (spre deosebire de replicarea la nivel scăzut, unde pe replici vor fi aplicate secvențial toate modificările făcute pe master).
2. Lipsesc complexitățile legate de implementarea schimbului prin HTTP, ceea ce permite sincronizarea bazelor de date remote.
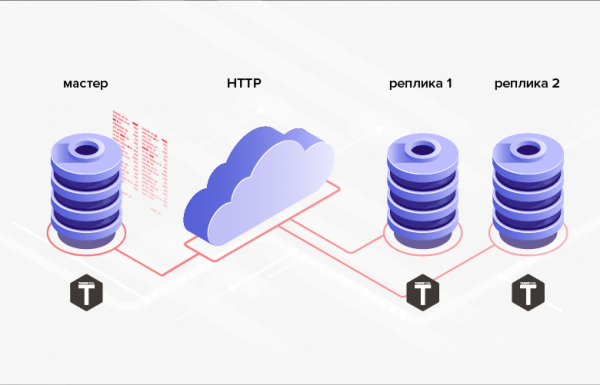
Fig. 2. Replicarea prin HTTP
3. Structurile bazelor de date între care se transferă datele nu trebuie să fie identice (mai mult decât atât, în general, este chiar posibilă utilizarea unor SGBD-uri diferite, limbaje de programare, platforme etc.).
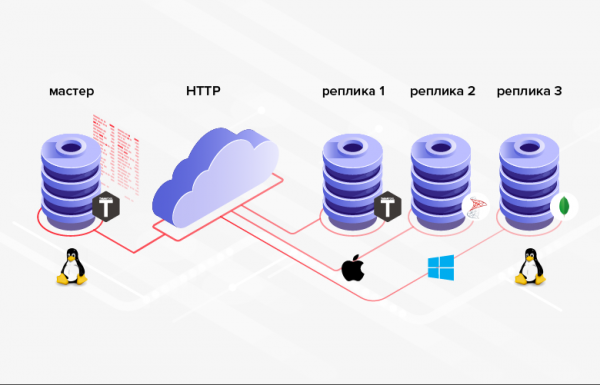
Fig. 3. Replicarea în sisteme heterogene
Dezavantajul constă în faptul că, în medie, programarea este mai complicată / costisitoare decât configurarea și, în loc să configurăm funcționalitatea încorporată, va trebui să implementăm propriul nostru sistem.
Dacă în situația dumneavoastră avantajele prezentate sunt decisive (sau sunt o condiție necesară), atunci merită să folosiți replicarea la nivel înalt. Vom analiza câteva metode de implementare a replicării la nivel înalt a datelor în SGBD-ul Tarantool.
Minimizarea traficului
Așadar, unul dintre avantajele replicării la nivel înalt este economisirea traficului. Pentru ca acest avantaj să se manifeste pe deplin, este necesar să minimizăm cantitatea de date transmise la fiecare sesiune de schimb. Desigur, nu trebuie să uităm că, la sfârșitul sesiunii, destinatarii datelor trebuie să fie sincronizați cu sursa (cel puțin pentru acea parte a datelor care participă la replicare).
Cum putem minimiza cantitatea de date transmise în timpul replicării la nivel înalt? O soluție „directă” poate fi filtrarea datelor pe baza datei și orei. Pentru aceasta, putem folosi un câmp existent în tabel cu data și ora (dacă este cazul). De exemplu, un document „comandă” poate avea un câmp „timpul necesar pentru executarea comenzii” — timp_de_livrare. Problema acestei soluții constă în faptul că valorile din acest câmp nu trebuie să fie aranjate într-o secvență care să corespundă creării comenzilor. Astfel, nu putem reține valoarea maximă a câmpului timp_de_livrare, transmisă în sesiunea de schimb anterioară, și în sesiunea de schimb următoare să selectăm toate înregistrările cu o valoare mai mare a câmpului timp_de_livrare. Între sesiunile de schimb s-ar fi putut adăuga înregistrări cu o valoare mai mică a câmpului timp_de_livrare. De asemenea, comanda ar fi putut suferi modificări care, cu toate acestea, nu au afectat câmpul timp_de_livrare. În ambele cazuri, modificările nu vor fi transmise de la sursă la receptor. Pentru a rezolva aceste probleme, va trebui să transmitem datele „suprapuse”. Adică, la fiecare sesiune de schimb, vom transmite toate datele cu o valoare a câmpului timp_de_livrare, care depășește un anumit punct în trecut (de exemplu, N ore de la momentul curent). Totuși, este evident că pentru sistemele mari, această abordare este extrem de redundantă și poate anula economiile de trafic pe care le căutăm. În plus, în tabelul transmis poate să nu existe un câmp legat de data și ora.
O altă soluție, mai complicată din punct de vedere al implementării, constă în confirmarea primirii datelor. În acest caz, la fiecare sesiune de schimb se transmit toate datele a căror primire nu a fost confirmată de receptor. Pentru implementare va fi necesar să adăugăm în tabelul sursă o coloană booleană (de exemplu, este_transferat). Dacă receptorul confirmă primirea înregistrării, câmpul corespunzător primește valoarea true, după care înregistrarea nu mai participă la schimburi. Această variantă de implementare are următoarele dezavantaje. În primul rând, pentru fiecare înregistrare transmisă este necesar să se genereze și să se trimită o confirmare. Practic, acest lucru ar putea fi comparabil cu dublarea cantității de date transmise și ar putea duce la dublarea numărului de round-trip-uri. În al doilea rând, nu există posibilitatea de a trimite aceeași înregistrare la mai mulți receptori (primul receptor care primește va confirma primirea pentru el și pentru toți ceilalți).
O metodă care nu are dezavantajele menționate mai sus constă în adăugarea unei coloane în tabela transmisă pentru urmărirea modificărilor rândurilor acesteia. Această coloană poate avea un tip datetime și ar trebui să fie setată/actualizată de aplicație la timpul curent de fiecare dată când se adaugă/se modifică înregistrări (atomic cu adăugarea/modificarea). Ca exemplu, să numim coloana update_time. Păstrând valoarea maximă a acestui câmp pentru înregistrările transmise, vom putea începe următoarea sesiune de schimb cu această valoare (selectând înregistrările cu valoarea câmpului update_time, care depășește valoarea păstrată anterior). Problema legată de ultima abordare este că modificările datelor pot avea loc în modul în vrac. Ca urmare, valorile câmpurilor din coloana update_time pot să nu fie unice. Astfel, această coloană nu poate fi utilizată pentru paginarea datelor. Pentru paginarea datelor, va trebui să inventăm mecanisme suplimentare, care, cel mai probabil, vor avea o eficiență foarte scăzută (de exemplu, extragerea din baza de date a tuturor înregistrărilor cu valoarea update_time peste o valoare dată și returnarea unui număr specific de înregistrări, începând cu o anumită deplasare de la începutul selecției).
Putem îmbunătăți eficiența transferului de date, perfecționând ușor abordarea anterioară. Pentru aceasta, ca valori ale câmpurilor coloanei pentru urmărirea modificărilor, vom folosi un tip întreg (integer long). Să numim coloana row_ver. Valoarea câmpului acestei coloane trebuie în continuare să fie setată/actualizată de fiecare dată când se creează/se modifică o înregistrare. Dar în acest caz câmpul va primi nu data-timp curent, ci valoarea unui anumit contor, crescut cu unul. Ca urmare, coloana row_ver va conține valori unice și va putea fi utilizată nu doar pentru returnarea „delta”-ului de date (date care s-au adăugat/modificat după încheierea sesiunii anterioare de schimb), ci și pentru o divizare simplă și eficientă pe pagini.
Ultima metodă propusă pentru minimizarea cantității de date transmise în cadrul replicării de înalt nivel mi se pare cea mai optimă și universală. Să ne oprim asupra ei în detaliu.
Transferul de date utilizând un contor de versiuni pentru rânduri
Implementarea părții server/master
În MS SQL Server, pentru implementarea unei abordări similare, există un tip special de coloană — rowversion. Fiecare bază de date are un contor care crește cu o unitate de fiecare dată când se adaugă/modifică o înregistrare în tabelă, având o coloană de tip rowversion. Valoarea acestui contor este atribuită automat câmpului acestei coloane în înregistrarea adăugată/modificată. SGBD-ul Tarantool nu are un mecanism încorporat analogic. Totuși, în Tarantool este ușor de implementat manual. Să vedem cum se face acest lucru.
Pentru început, puțină terminologie: tabelele în Tarantool se numesc spații (space), iar înregistrările — tuple. În Tarantool pot fi create secvențe (sequence). Secvențele reprezintă generatoare numite de valori ordonate de numere întregi. Adică, este exact ceea ce avem nevoie pentru scopurile noastre. Mai jos vom crea o astfel de secvență.
Înainte de a efectua orice operațiune cu baza de date în Tarantool, este necesar să executați următoarea comandă:
box.cfg{}Ca rezultat, Tarantool va începe să înregistreze în directorul curent instantanee ale DB (snapshot) și un jurnal de tranzacții.
Să creăm o secvență row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Opțiune if_not_exists permite executarea scriptului de creare de mai multe ori: dacă obiectul există, Tarantool nu va încerca să-l creeze din nou. Această opțiune va fi utilizată în toate comenzile DDL următoare.
Să creăm un spațiu pentru exemplu.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Aici am specificat numele spațiului (goods), numele câmpurilor și tipurile acestora.
Câmpurile auto-increment în Tarantool sunt create de asemenea cu ajutorul secvențelor. Să creăm o cheie primară auto-increment pe câmpul id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool suportă mai multe tipuri de indecși. Cele mai utilizate sunt indecșii de tip TREE și HASH, care se bazează pe structuri corespunzătoare denumirii. TREE este cel mai versatil tip de index. Acesta permite extragerea datelor într-o formă ordonată. Însă, pentru selecția bazată pe egalitate, HASH este mai potrivit. Astfel, pentru cheia primară, este recomandat să se utilizeze HASH (așa cum am făcut noi).
Pentru a folosi coloana row_ver pentru a transmite datele modificate, trebuie să legi valorile secvenței de câmpurile acestei coloane row_ver. Însă, spre deosebire de cheia primară, valoarea câmpului coloanei row_ver trebuie să crească cu unu nu doar la adăugarea de noi înregistrări, ci și la modificarea celor existente. Pentru aceasta, se pot folosi trigeri. În Tarantool există două tipuri de trigeri pentru spații: before_replace și on_replace. Trigerii se activează la fiecare modificare a datelor din spațiu (pentru fiecare tuplu afectat de modificări se activează funcția trigerului). Spre deosebire de on_replace, before_replace-trigerii permit modificarea datelor tuplului pentru care se execută trigerul. Astfel, ne potrivim cu ultimul tip de trigeri.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Trigerul prezentat înlocuiește valoarea câmpului row_ver tuplului salvat cu următoarea valoare a secvenței row_version.
Pentru a putea extrage date din spațiu goods după coloana row_ver, vom crea un index:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Tipul indexului este arbore (TREE), deoarece va trebui să extragem datele în ordinea crescătoare a valorilor din coloană. row_ver.
Să adăugăm în spațiu unele date:
box.space.goods:insert{nil, 'stylou', 123}
box.space.goods:insert{nil, 'creion', 321}
box.space.goods:insert{nil, 'pensulă', 100}
box.space.goods:insert{nil, 'acuarelă', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'caiet', 800}
box.space.goods:insert{nil, 'gomă', 531}
box.space.goods:insert{nil, 'riglă', 135}
Fiindcă primul câmp este un contor auto-increment, trimitem nil în locul lui. Tarantool va completa automat următoarea valoare. În mod similar, pentru câmpurile coloanei row_ver poți trimite nil — sau nu specifica deloc o valoare, deoarece această coloană ocupă ultima poziție în spațiu.
Să verificăm rezultatul inserării:
tarantool> box.space.goods:select()
---
- - [1, 'stilou', 123, 1]
  - [2, 'creion', 321, 2]
  - [3, 'pictor', 100, 3]
  - [4, 'acuarelă', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'caiet', 800, 6]
  - [7, 'gumă', 531, 7]
  - [8, 'riglă', 135, 8]
...
După cum vedem, primul și ultimul câmp s-au completat automat. Acum va fi simplu să scriem o funcție pentru exportul paginat al modificărilor din spațiu goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Funcția ia ca parametru valoarea row_ver, începând cu care trebuie efectuat exportul modificărilor și returnează un lot de date modificate.
Selectarea datelor în Tarantool se realizează prin intermediul indicilor. Funcția get_goods folosește un iterator pe index row_ver pentru a obține datele modificate. Tipul iteratorului este GT (Greater Than, mai mare decât). Aceasta înseamnă că iteratorul va parcurge valorile indexului începând de la cheia (valoarea câmpului) transmisă. row_ver).
Iteratorul returnează tupluri. Pentru a putea transmite ulterior datele prin HTTP, este necesară convertirea tuplurilor într-o structură potrivită pentru serializare ulterioară. În exemplu, pentru aceasta se folosește funcția standard tomap. În loc să folosești tomap poți scrie o funcție personalizată. De exemplu, putem dori să redenumim câmpul name, să nu transmitem câmpul code și să adăugăm câmpul comentariu:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'some comment'
    obj.row_ver = tuple.row_ver
    return obj
end
Dimensiunea paginii de date returnate (numărul de înregistrări într-un lot) este determinată de variabila page_size. În exemplu, valoarea page_size aproximativ 5. Într-un program real, dimensiunea paginii are de obicei o importanță mai mare. Aceasta depinde de dimensiunea medie a tuple-ului din spațiu. Dimensiunea optimă a paginii poate fi determinată experimental, prin măsurarea timpului de transfer al datelor. Cu cât dimensiunea paginii este mai mare, cu atât se reduce numărul de round-trip-uri între partea care trimite și cea care primește. Astfel, se poate reduce timpul total de descărcare a modificărilor. Totuși, dacă dimensiunea paginii este prea mare, vom ocupa serverul prea mult timp cu serializarea selecției. Ca urmare, pot apărea întârzieri în procesarea altor cereri care au ajuns pe server. Parametrul page_size poate fi încărcat din fișierul de configurare. Pentru fiecare spațiu transmis se poate stabili o valoare proprie. Totuși, pentru cele mai multe spații o valoare implicită (de exemplu, 100) poate fi adecvată.
Vom executa funcția get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: stilou
    id: 1
  - row_ver: 2
    code: 321
    name: creion
    id: 2
  - row_ver: 3
    code: 100
    name: pensulă
    id: 3
  - row_ver: 4
    code: 456
    name: acuarelă
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Să luăm valoarea câmpului row_ver din ultima linie și să apelăm din nou funcția:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: caiet
    id: 6
  - row_ver: 7
    code: 531
    name: cauciuc
    id: 7
  - row_ver: 8
    code: 135
    name: riglă
    id: 8
...
Și încă o dată:
tarantool> get_goods(8)
---
- []
...
După cum vedem, prin această utilizare, funcția returnează toate înregistrările din spațiu paginat. goodsDupă ultima pagină urmează o selecție goală.
Să facem modificări în spațiu:
box.space.goods:update(4, {{'=', 6, 'caiet'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'folder', 432}
Am schimbat valoarea câmpului name pentru o înregistrare și am adăugat două înregistrări noi.
Să repetăm ultima apelare a funcției:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: caiet
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: folder
    id: 10
...
Funcția a returnat înregistrările modificate și cele adăugate. Prin urmare, funcția get_goods permite accesarea datelor care s-au modificat de la ultima sa apelare, ceea ce stă la baza metodei de replicare discutată.
Vom lăsa exportarea rezultatelor prin HTTP sub formă de JSON în afara acestui articol. Despre aceasta se poate citi aici:
Implementarea părții client/slave
Să vedem cum arată implementarea părții care primește. Vom crea un spațiu pe partea care primește pentru a stoca datele încărcate:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Structura spațiului amintește de structura spațiului din sursă. Dar deoarece nu intenționăm să transmitem datele obținute în altă parte, coloana row_ver din spațiul destinatar lipsește. În câmpul id vor fi înregistrate identificatoarele din sursă. Așadar, nu este nevoie să fie auto-incremental pe partea destinatarului.
În plus, ne va trebui un spațiu pentru a păstra valorile row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Pentru fiecare spațiu care este încărcat (câmpul space_name) vom păstra aici ultima valoare încărcată row_ver (câmpul valoare). Ca cheie primară va fi coloana space_name.
Vom crea o funcție pentru a încărca datele spațiului goods prin HTTP. Pentru aceasta, ne va trebui o bibliotecă care să implementeze clientul HTTP. Linia următoare încarcă biblioteca și creează o instanță a clientului HTTP:
local http_client = require('http.client').new()De asemenea, ne va trebui o bibliotecă pentru deserializarea json:
local json = require('json')Aceasta este suficient pentru crearea funcției de încărcare a datelor:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Funcția efectuează o cerere HTTP la adresa url, transmite în ea row_ver în calitate de parametru și returnează rezultatul deserializat al cererii.
Funcția care salvează datele primite arată astfel:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
Bucla de salvare a datelor în spațiu goods este închisă într-o tranzacție (pentru aceasta se folosește funcția box.atomic) pentru a reduce numărul de operațiuni cu discurile.
În cele din urmă, funcția de sincronizare a spațiului local goods cu sursa poate fi implementată astfel:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Mai întâi citim valoarea salvată anterior row_ver pentru spațiul goods. Dacă aceasta lipsește (prima sesiune de schimb), atunci luăm ca row_ver zero. Then, in the loop, we perform page-by-page loading of modified data from the source via the specified url. In each iteration, we save the received data in the corresponding local space and update the value row_ver (in the space row_ver and in the variable row_ver) — we take the value row_ver from the last line of the loaded data.
To protect against accidental looping (in case of an error in the program), the loop while can be replaced with for:
for _ = 1, max_req do ... As a result of the function execution sync_goods space goods in the receiver will contain the latest versions of all records from the space goods in the source.
It is obvious that this method cannot be used to transmit data deletion. If such a necessity exists, a marking for deletion can be used. We add to the space goods a boolean field is_deleted and instead of physically deleting the record, we use logical deletion — setting the field value is_deleted to the value true. Sometimes, instead of a boolean field, is_deleted it is more convenient to use a field deleted, which stores the date-time of logical deletion of the record. After performing logical deletion, the marked record will be transferred from the source to the receiver (according to the logic discussed above).
The sequence row_ver can be used to transmit data from other spaces: there is no need to create a separate sequence for each transmitted space.
We have examined an effective method of high-level data replication in applications using the Tarantool DBMS.
Conclusions
- The Tarantool DBMS is an attractive, promising product for creating high-load applications.
- High-level data replication has several advantages over low-level replication.
- The method of high-level replication discussed in the article allows minimizing the amount of data transmitted by sending only those records that have changed since the last exchange session.
Sursa: habr.com
