

Recentemente a apărut , care arată bine tendințele în învățarea automată din ultimii ani. Pe scurt: numărul startup-urilor în domeniul învățării automate a scăzut brusc în ultimii doi ani.
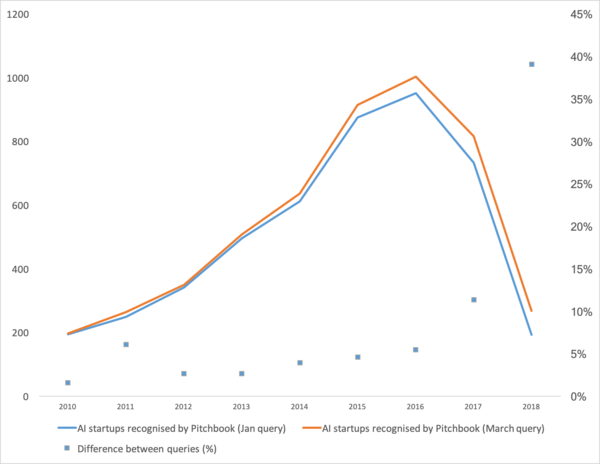
Ei bine. Să discutăm „dacă bula a explodat”, „cum să trăim mai departe” și să vorbim despre de unde a apărut această situație.
La început, să discutăm despre ce a fost booster-ul acestei curbe. De unde a apărut. Probabil că toată lumea își amintește în învățarea automată în 2012 la competiția ImageNet. Pentru că acesta a fost primul eveniment global! Dar în realitate nu este așa. De asemenea, creșterea curbei începe cu câțiva ani mai devreme. Aș împărți-o în câteva momente.
- Anul 2008 este apariția termenului „date mari”. Produsele reale au început începând cu anul 2010. Datele mari sunt strâns legate de învățarea automată. Fără date mari, nu este posibilă funcționarea stabilă a algoritmilor care existau pe atunci. Și aceasta nu sunt rețele neuronale. Până în 2012, rețelele neuronale erau domeniul unei minorități marginale. Însă atunci au început să funcționeze algoritmi complet diferiți, care existau deja de ani sau chiar decenii: (1963, 1993), (1995), (2003),… Startup-urile acelor ani se leagă în principal de procesarea automată a datelor structurate: case de marcat, utilizatori, publicitate, multe altele.
Derivata acestei prime unde este un set de cadre de lucru, cum ar fi XGBoost, CatBoost, LightGBM etc.
- Între 2011-2012 au câștigat o serie de competiții de recunoaștere a imaginilor. Utilizarea lor reală s-a întârziat puțin. Aș spune că startup-urile și soluțiile înțelese pe larg au început să apară din 2014. Au fost necesari doi ani pentru a procesa că rețelele neuronale funcționează, pentru a crea cadre de lucru convenabile care puteau fi instalate și rulate într-un timp rezonabil, pentru a dezvolta metode care să stabilizeze și să accelereze timpul de convergență.
Rețelele convoluționale au permis rezolvarea problemelor de viziune computerizată: clasificarea imaginilor și a obiectelor din imagini, detectarea obiectelor, recunoașterea obiectelor și a oamenilor, îmbunătățirea imaginilor etc.
- Anii 2015-2017. Boom-ul algoritmilor și proiectelor legate de rețelele recurente sau echivalentele lor (LSTM, GRU, TransformerNet etc.). Au apărut algoritmi bine funcționali pentru „vorbire-în-text”, sisteme de traducere automată. Parțial, acestea se bazează pe rețele convoluționale pentru extragerea caracteristicilor de bază. Parțial, pe faptul că am învățat să colectăm seturi de date real mari și de calitate bună.
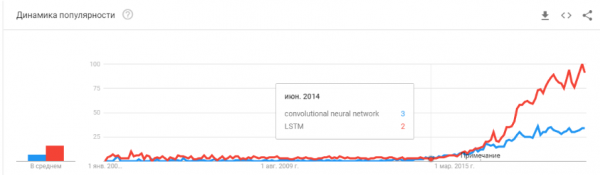
„Bula a explodat? Hype-ul este supraîncălzit? Au murit ca blockchainul?”
Asta-i sigur! Mâine, Siri va înceta să funcționeze pe telefonul vostru, iar poimâine Tesla nu va distinge o curbă de un cangur.
Rețelele neuronale deja funcționează. Ele se află în zeci de dispozitive. Ele permit cu adevărat câștiguri, schimbă piața și mediul înconjurător. Hype-ul arată un pic altfel:
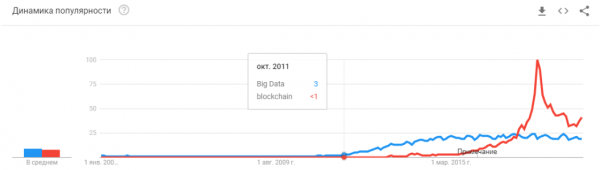
Pur și simplu, rețelele neuronale au încetat să mai fie ceva nou. Da, mulți oameni au așteptări exagerate. Dar un număr mare de companii au învățat să aplice rețele neuronale și să dezvolte produse pe baza lor. Rețelele neuronale oferă funcționalități noi, permit reducerea locurilor de muncă, scăderea prețului serviciilor:
- Companiile de producție integrează algoritmi pentru analiza defectelor pe linia de asamblare.
- Întreprinderile de creștere a animalelor cumpără sisteme pentru monitorizarea vacilor.
- Combaină automate.
- Centre de apel automatizate.
- Filtre în SnapChat. (cel puțin un lucru folositor!)
Însă, cel mai important și cel mai puțin evident: „Nu mai sunt idei noi, sau ele nu vor aduce capital instantaneu”. Rețelele neuronale au rezolvat zeci de probleme. Și vor rezolva și mai multe. Toate ideile evidente care au existat au generat o mulțime de startup-uri. Dar tot ce era la suprafață a fost deja adunat. În ultimii doi ani, nu am întâlnit nicio idee nouă pentru aplicarea rețelelor neuronale. Nici o abordare nouă (ok, sunt câteva complicații cu GAN-urile).
Și fiecare startup următor devine tot mai complex. Acesta nu mai necesită doar doi băieți care să antreneze rețeaua neuronală pe date deschise. Acesta necesită programatori, servere, o echipă de etichetați, suport complex etc.
Ca rezultat — numărul startup-urilor scade. Dar producția crește. Trebuie să adăugați recunoașterea numerelor de mașină? Pe piață sunt sute de specialiști cu experiență relevantă. Puteți angaja și, în câteva luni, angajatul dvs. va crea sistemul. Sau să cumpărați unul gata făcut. Dar să creați un nou startup?.. Nebunie!
Este nevoie să realizăm un sistem de urmărire a vizitatorilor - de ce să plătim pentru o mulțime de licențe când putem construi unul personalizat pentru afacerea noastră în 3-4 luni.
Acum, rețelele neuronale urmează același parcurs pe care l-au avut zeci de alte tehnologii.
Îți amintești cum s-a schimbat noțiunea de «dezvoltator de site-uri» din 1995 până acum? În timp ce piața nu este saturată de specialiști. Sunt foarte puțini profesioniști. Dar pot susține că, în 5-10 ani, nu va mai exista o distincție semnificativă între un programator Java și un dezvoltator de rețele neuronale. Vor fi destui specialiști în ambele domenii pe piață.
Pur și simplu va exista o clasă de sarcini pentru care se vor utiliza rețele neuronale. Dacă apare o sarcină - angajezi un specialist.
„Și ce urmează? Unde este inteligența artificială promisă?”
Aici există o mică, dar interesantă neclaritate :)
Tehnologiile de astăzi, se pare, nu ne conduc spre inteligența artificială. Ideile și noutatea lor s-au epuizat în mare parte. Hai să discutăm despre ceea ce menține actualul nivel de dezvoltare.
Limitări
Să începem cu mașinile autonome. Pare destul de clar că realizarea de automobile complet autonome cu tehnologiile actuale este posibilă. Dar în cât timp se va întâmpla asta - nu este clar. Tesla crede că se va întâmpla în câțiva ani -
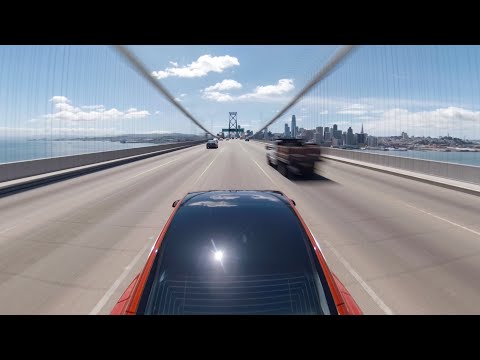
Există mulți alții , care estimează că va dura între 5 și 10 ani.
Din punctul meu de vedere, cel mai probabil, în aproximativ 15 ani infrastructura orașelor se va schimba astfel încât apariția automobilelor autonome va deveni inevitabilă, va deveni o extensie a acesteia. Dar asta nu poate fi considerat inteligență. Tesla modernă este un conveior foarte complex pentru filtrarea, căutarea și reînvățarea datelor. Acestea sunt reguli - reguli - reguli, colectare de date și filtre aplicate acestora (iată am scris mai în detaliu despre asta, sau poți viziona de la marcaj).
Prima problemă
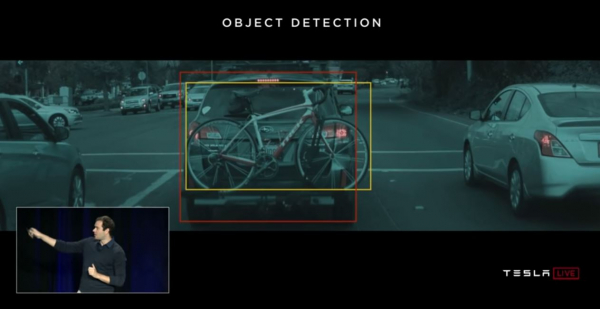
Și aici vedem prima problemă fundamentală. Big Data. This is precisely what has generated the current wave of neural networks and machine learning. Today, to accomplish something complex and automated, a vast amount of data is required. Not just a lot, but an overwhelming amount. We need automated algorithms for collection, labeling, and usage. If we want the machine to see trucks against the sun, we first need to gather a sufficient number of them. If we want the machine not to go crazy from a bicycle attached to the trunk, we need more samples.
Moreover, one example is not enough. Hundreds? Thousands?
The second problem
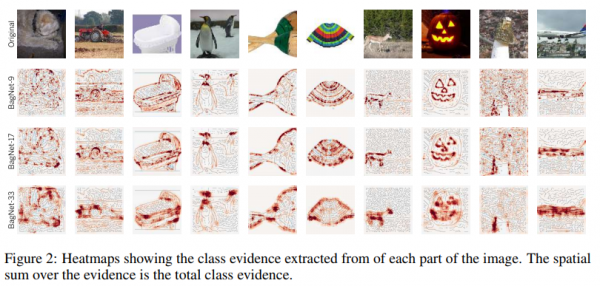
The second problem — visualizing what our neural network has understood. This is a very non-trivial task. Until now, few understand how to visualize this. These articles are quite recent, and they offer just a few examples, however distant:
the fixation on textures. It effectively shows what the neural network tends to focus on + what it perceives as initial information.
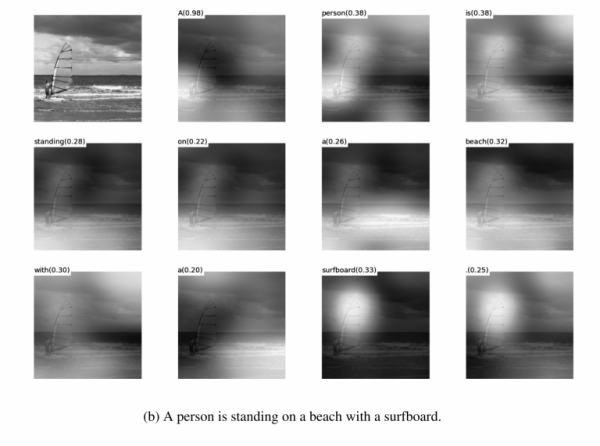
attention during . In fact, attention can often be used precisely to demonstrate what caused such a reaction from the network. I have come across such tools for debugging and for product solutions. There are many articles on this topic. However, the more complex the data, the harder it is to achieve stable visualization.
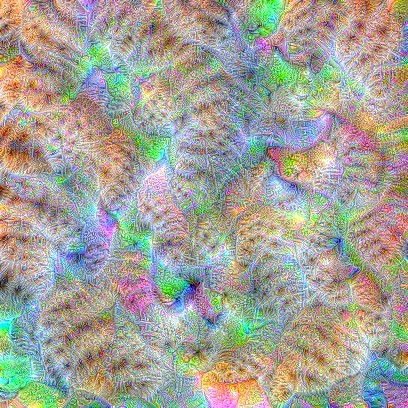
And yes, the old reliable set of 'look at what the network has inside in '. These images were popular about 3-4 years ago, but everyone quickly realized that while the images are pretty, they lack meaning.
I haven’t mentioned dozens of other gimmicks, methods, hacks, and research on how to display the internals of the network. Do these tools work? Do they help quickly understand what the problem is and debug the network? Do they extract those last few percentages? Well, it’s about the same:
You can check any competition on Kaggle. And the descriptions of how people arrive at final solutions. We stacked 100-500-800 million models, and it worked!
Of course, I’m exaggerating. But these approaches do not provide quick and direct answers.
With sufficient experience, by testing various options, one can make a verdict on why your system made such a decision. However, correcting the system's behavior will be challenging. It’s possible to implement a workaround, adjust the threshold, add a dataset, or take another backend network.
The third problem
The third fundamental problem — rețelele învață nu logica, ci statistica. Statistically this :
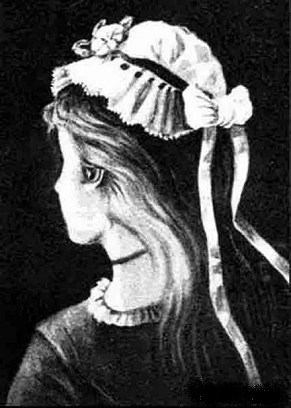
Logic nu foarte asemănătoare. Rețelele neuronale nu învață ceva complex, dacă nu sunt forțate. Ele învață întotdeauna cele mai simple caracteristici. Există ochi, nas, cap? Atunci este o față! Ori adu un exemplu în care ochii să nu însemne față. Și din nou — milioane de exemple.
Există Mult Spațiu în Jos
Aș spune că aceste trei probleme globale limitează în prezent dezvoltarea rețelelor neuronale și a învățării automate. Iar în locurile unde aceste probleme nu limitează — deja sunt utilizate activ.
Este acesta sfârșitul? Rețelele neuronale s-au oprit?
Nu se știe. Dar, desigur, toată lumea speră că nu.
Există multe abordări și direcții pentru a rezolva acele probleme fundamentale pe care le-am menționat mai sus. Dar până acum niciuna dintre aceste abordări nu a reușit să creeze ceva cu adevărat nou, să rezolve ceva ce nu a fost rezolvat până acum. Până acum toate proiectele fundamentale se realizează pe baza unor abordări stabile (Tesla), sau rămân proiecte de testare ale instituțiilor sau corporațiilor (Google Brain, OpenAI).
Dacă vorbim în termeni foarte generali, principala direcție este crearea unei reprezentări de nivel înalt a datelor de intrare. Într-un fel, „memorie”. Cel mai simplu exemplu de memorie sunt diferitele „Embedding” — reprezentări ale imaginilor. De exemplu, toate sistemele de recunoaștere facială. Rețeaua învață să obțină dintr-o față o reprezentare stabilă care nu depinde de unghi, iluminare, rezoluție. Practic, rețeaua minimizează metrica „fețe diferite — departe” și „identice — aproape”.
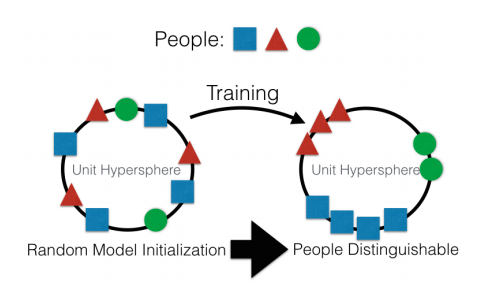
Pentru un astfel de învățământ sunt necesare zeci și sute de mii de exemple. Dar rezultatul aduce unele elemente de „One-shot Learning”. Acum nu avem nevoie de sute de fețe pentru a memoriza o persoană. Doar o față, și totul — noi !
Dar există o problemă ... Rețeaua poate învăța doar obiecte destul de simple. Când încercăm să distincem nu fețele, ci, de exemplu, „oamenii după îmbrăcăminte” (sarcină ) — calitatea scade cu mult. Și rețeaua nu mai poate învăța schimbări de unghiuri suficient de evidente.
Dar a învăța din milioane de exemple — de asemenea, nu este exact o distracție plăcută.
Există lucrări care reduc semnificativ selecția. De exemplu, una dintre primele lucrări despre OneShot Learning :
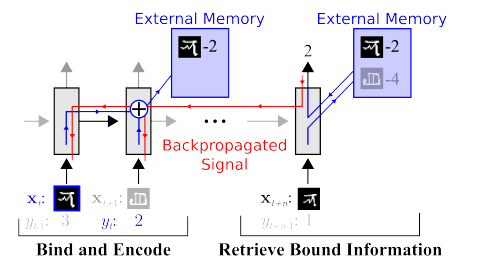
Sunt multe astfel de lucrări, de exemplu sau sau .
Un dezavantaj este că, de obicei, învățarea funcționează bine pentru exemple simple, precum cele din setul MNIST. Dar, atunci când se trece la sarcini mai complexe, este nevoie de o bază mare, un model de obiecte sau de un oarecare tip de magie.
În general, lucrările despre învățarea One-Shot sunt un subiect foarte interesant. Găsești multe idei. Dar, în mare parte, cele două probleme pe care le-am enumerat (preînvățarea pe un set de date uriaș / instabilitatea pe date complexe) îngreunează învățarea.
Pe de altă parte, la tema Embedding se potrivesc GAN-urile - rețele generative antagoniste. Cu siguranță ai citit o mulțime de articole pe această temă pe Habr., ,)
O caracteristică a GAN-urilor este formarea unui anumit spațiu intern de stări (de fapt, același Embedding), care permite generarea unei imagini. Acestea pot fi , pot fi .
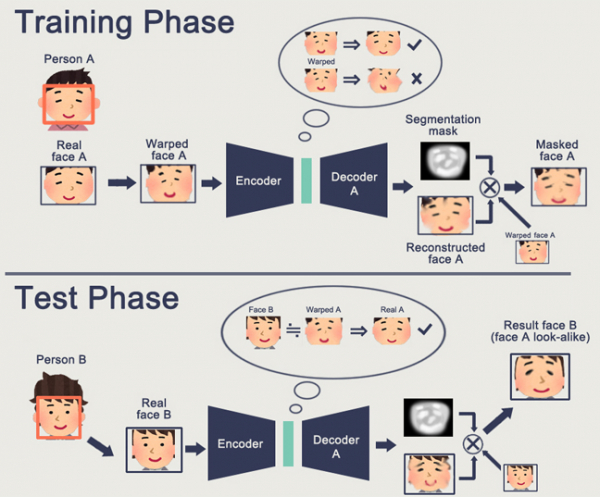
Problema GAN-urilor este că, cu cât obiectul generat este mai complex, cu atât este mai greu să fie descris în logica „generator-discriminator”. Ca urmare, din aplicațiile reale ale GAN-urilor, care sunt cunoscute, avem doar DeepFake, care manipulează din nou imaginile fețelor (pentru care există o bază uriașă).
Am întâlnit foarte puține aplicații utile. De obicei, sunt doar gadgeturi cu adăugarea de detalii imaginilor.
Și din nou, nimeni nu are o înțelegere clară a modului în care acest lucru ne va ajuta să ne îndreptăm spre un viitor luminos. Reprezentarea logicii/spațiului într-o rețea neuronală este bună. Dar avem nevoie de un număr uriaș de exemple, nu știm cum percepe rețeaua neuronală aceste aspecte, nu știm cum să facem rețeaua neuronală să rețină o reprezentare cu adevărat complexă.
Învățarea prin întărire este o abordare complet diferită. Cu siguranță îți amintești cum Google a învins pe toată lumea la Go. Victoriile recente în Starcraft și Dota. Dar aici lucrurile nu sunt deloc atât de roz sau promițătoare. Cel mai bine vorbește despre RL și dificultățile sale .
Dacă ar fi să rezumăm ce a scris autorul:
- Modelele din cutie nu sunt potrivite / funcționează prost în majoritatea cazurilor.
- Sarcinile practice sunt mai ușor de rezolvat cu alte metode. Boston Dynamics nu folosește RL din cauza dificultății / imprevizibilității / complexității calculelor.
- Pentru ca RL să funcționeze, este nevoie de o funcție complexă. Adesea, este dificil de creat / scris.
- Este greu să antrenezi modele. Trebuie să petreci o mulțime de timp pentru a le aduce în formă și a ieși din optimumele locale.
- Ca urmare, este dificil să replici modelul, instabilitatea modelului la cele mai mici modificări.
- Adesea se overfit la anumite regularități aleatoare, chiar și până la generatorul de numere aleatoare.
Punctul cheie este că RL (învățarea prin întărire) încă nu funcționează în producție. Google are unele experimente ( , ). Dar nu am văzut nicio sistem productiv.
Memorie. Dezavantajul tuturor celor descrise mai sus este lipsa de structură. Una dintre metodele prin care se încearcă să se rezolve acest aspect este de a oferi rețelei neuronale acces la o memorie separată. Astfel, ea ar putea înregistra și rescrie rezultatele pașilor săi. Atunci rețeaua neuronală poate fi definită de starea actuală a memoriei. Acest lucru semănă foarte mult cu procesoarele și computerele clasice.
Cea mai cunoscută și populară — de la DeepMind:
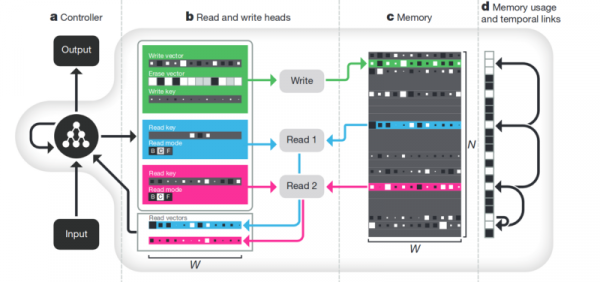
Se pare că acesta este cheia înțelegerii inteligenței? Dar mai degrabă nu. Sistemul are nevoie, oricum, de un volum uriaș de date pentru antrenament. Și funcționează în principal cu date structurate în formă de tabel. Totodată, când Facebook o problemă similară, au optat pentru „nu avem nevoie de memorie, doar să facem rețeaua neuronală mai complexă, plus mai multe exemple — și ea se va învăța singură”.
Descompunerea. O altă metodă de a crea o memorie semnificativă este de a lua aceleași embedding-uri, dar în timpul învățării să introducă criterii suplimentare care să permită separarea „sensurilor”. De exemplu, dacă dorim să învățăm rețeaua neuronală să distingă comportamentul unei persoane în magazin. Dacă am urma calea standard — ar trebui să facem o duzină de rețele. Una caută persoana, a doua determină ce face, a treia îi stabilește vârsta, a patra — sexul. O logică separată analizează partea magazinului unde învață. A treia determină traiectoria sa, etc.
Sau, dacă ar exista o cantitate infinită de date, atunci am putea antrena o singură rețea pe toate rezultatele posibile (evident, un astfel de volum de date este imposibil de adunat).
Abordarea disentanțărării ne spune că ar trebui să învățăm rețeaua astfel încât să poată distinge conceptele. Astfel, să poată genera un embedding din video, unde o zonă să definească acțiunea, alta — poziția pe podea în timp, una — înălțimea unei persoane, iar alta — sexul acesteia. În același timp, în timpul învățării, ar fi bine să evităm să oferim rețelei indicii prea clare despre concepte cheie, ci să o lăsăm să evidențieze și să grupeze zonele singură. Există destul de puține articole de acest tip (unele dintre ele , , ) și, în general, sunt destul de teoretice.
Dar această direcție, măcar teoretic, ar trebui să rezolve problemele enumerate la început.
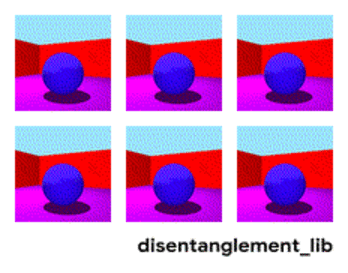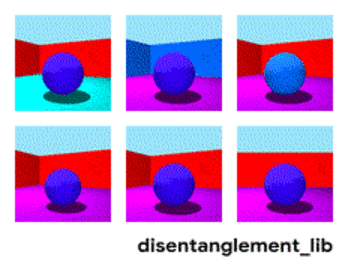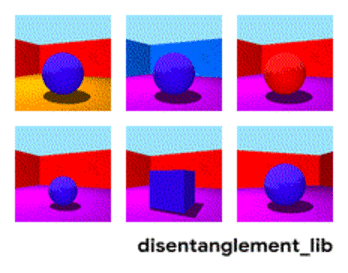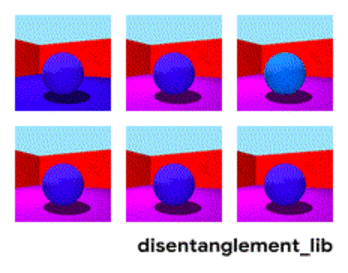
Dezintegrarea imaginii pe parametrii "culoarea pereților/culoarea podelei/forma obiectului/culoarea obiectului/etc."
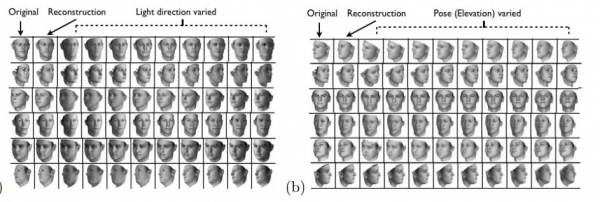
Dezintegrarea feței pe parametrii "dimensiune, sprâncene, orientare, culoarea pielii, etc."
Altele
Există multe alte direcții, nu atât de globale, care permit cumva reducerea bazelor de date, lucrând cu date mai diverse, etc.
Attention. Probabil, nu are sens să evidențiem acest lucru ca pe o metodă separată. Este pur și simplu o abordare care întărește altele. I-au fost dedicate multe articole (,,). Sensul Attention este acela de a întări reacția rețelei față de obiecte semnificative în timpul învățării. Adesea printr-o anumită direcție externă, sau printr-o mică rețea externă.
Simularea 3D. Dacă se creează un motor 3D bun, acesta poate acoperi adesea 90% dintre datele de instruire (am văzut chiar un exemplu în care aproape 99% din date erau acoperite de un motor bun). Există multe idei și hacks pentru a face rețeaua antrenată pe un motor 3D să funcționeze cu date reale (Fine tuning, transfer de stil, etc.). Dar de obicei să creezi un motor bun este cu câteva ordine de mărime mai complicat decât să aduni date. Exemple de când s-au creat motoare:
Învățarea roboților (, )
Formare produselor în magazin (dar în două proiecte pe care le-am făcut, ne-am descurcat fără aceasta).
Învățarea la Tesla (din nou, acel video pe care l-am menționat mai sus).
Conclusions
Întreaga articolă este, într-un anumit sens, concluzii. Probabil, mesajul principal pe care am vrut să-l transmit este — „bonusul s-a terminat, neuralele nu mai oferă soluții simple”. Acum trebuie să muncim din greu construind soluții complexe. Sau să muncim făcând cercetări științifice complexe.
În general, subiectul este discutabil. Poate că cititorii au exemple mai interesante?
Sursa: habr.com
