

Introducere
Sistemul informațional, din perspectiva utilizatorului, este bine definit în GOST RV 51987 — „sistem automatizat, a cărui funcționare rezultă în prezentarea informației de ieșire pentru utilizare ulterioară”. Dacă examinăm structura internă, orice SI este, în esență, un sistem de algoritmi interconectați realizat în cod. În sens larg, teza lui Turing-Church afirmă că algoritmul (și, prin urmare, SI) realizează transformarea unui set de date de intrare într-un set de date de ieșire.
Se poate spune chiar că sensul existenței unui sistem informațional constă în transformarea datelor de intrare. Prin urmare, valoarea SI și a întregului complex de SI este determinată prin valoarea datelor de intrare și de ieșire.
Pe baza aceasta, proiectarea ar trebui să înceapă și să se bazeze pe date, adaptând arhitectura și metodele la structura și importanța datelor.
Datele stocate
Un pas-cheie în pregătirea proiectării este obținerea caracteristicilor tuturor seturilor de date planificate pentru a fi procesate și stocate. Aceste caracteristici includ:
— Volumul de date;
— Informații despre ciclul de viață al datelor (creșterea datelor noi, durata de viață, procesarea datelor învechite);
— Clasificarea datelor din perspectiva influenței asupra afacerii principale a companiei (acestea fiind cele trei aspecte: confidențialitate, integritate, disponibilitate) împreună cu indicatorii financiari (de exemplu, costul pierderii de date pe ultima oră);
— Geografia procesării datelor (amplasarea fizică a sistemelor de procesare);
— Cerințele reglementatorului pentru fiecare clasă de date (de exemplu, Legea Fed. 152, PCI DSS).
Sistemele informaționale
Datele nu doar că sunt stocate, dar sunt și procesate (transformate) de sistemele informaționale. Următorul pas după obținerea caracteristicilor datelor este realizarea unei inventarizări complete a sistemelor informaționale, a caracteristicilor arhitecturale, interdependențelor și cerințelor infrastructurii în unități condiționate pentru cele patru tipuri de resurse:
— Capacitatea de calcul a procesorului;
— Volumul memoriei RAM;
— Cerințele pentru volumul și performanța sistemului de stocare a datelor;
— Cerințele pentru rețeaua de transfer de date (canale externe, canale între componentele SI).
Cerințele trebuie să fie pentru fiecare serviciu/microserviciu din cadrul IS.
Este important să menționăm că, pentru o proiectare corectă, este necesar să existe date despre impactul IS asupra afacerii principale a companiei, sub formă de costuri de nefuncționare a IS (lei pe oră).
Modelul amenințărilor
Trebuie să existe obligatoriu un model formal al amenințărilor, împotriva cărora se intendentează să se protejeze datele/serviciile. Acest model al amenințărilor include nu doar aspectele confidențialității, ci și integrității și disponibilității. Adică, de exemplu:
— Defecțiunea unui server fizic;
— Defecțiunea unui switch top-of-the-rack;
— Interuperea canalului optic de comunicare între data center-e;
— Defecțiunea completă a unui sistem de stocare a datelor operaționale.
În unele cazuri, modelele amenințărilor sunt redactate nu doar pentru componentele infrastructurii, ci și pentru anumite IS sau componentele acestora, cum ar fi eșecul SGBD-ului cu distrugerea logică a structurii datelor.
Toate soluțiile din cadrul proiectului pentru protecția împotriva amenințărilor neidentificate sunt inutile.
Cerințele reglementatorului
Dacă datele procesate sunt supuse unor reguli speciale stabilite de reglementatori, este obligatorie informația despre seturile de date și regulile de procesare/stocare.
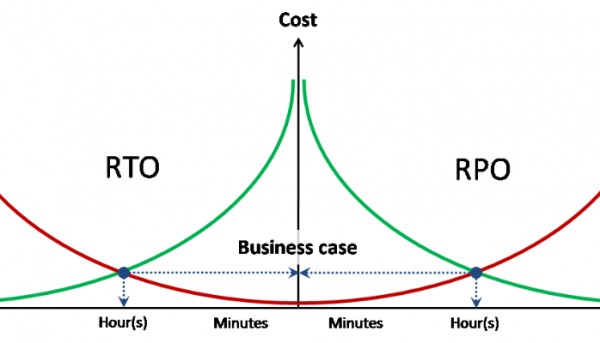
Indicatorii țintiți RPO/RTO
Proiectarea oricărui tip de protecție necesită existența indicatorilor pentru pierderile acceptabile de date și timpul dorit de recuperare a serviciului pentru fiecare dintre amenințările descrise.
În ideal, RPO și RTO ar trebui să aibă costuri asociate pentru pierderea datelor și nefuncționare pe unitatea de timp.
Împărțirea în grupuri de resurse
După colectarea tuturor informațiilor inițiale, primul pas este gruparea seturilor de date și IS în grupuri, pe baza modelului amenințărilor și cerințelor reglementatorilor. Se determină tipul de separare a diferitelor grupuri – software la nivel de software de sistem sau fizic.
Exemple:
— Conturul care prelucrează date personale este complet separat fizic de celelalte sisteme;
— Copiile de rezervă sunt păstrate pe un sistem de stocare a datelor separat.
În acest context, grupurile pot avea independență incompletă; de exemplu, sunt definite două grupuri de resurse de calcul (capacitate de procesare + memorie RAM), care utilizează un singur grup de stocare a datelor și un singur grup de resurse de transmitere a datelor.
Capacitate de procesare
Necesitatea abstractă de putere de procesare a unui centru de date virtualizat este măsurată în numărul de procesoare virtuale (vCPU) și în coeficientul de consolidare a acestora pe procesoarele fizice (pCPU). În acest caz specific, 1 pCPU = 1 nucleu fizic de procesor (fără a lua în considerare Hyper-Threading). Numărul de vCPU se acumulează pe toate pool-urile definite de resurse (fiecare dintre acestea putând avea propriul coeficient de consolidare).
Coeficientul de consolidare pentru sistemele încărcate se obține empiric, pe baza infrastructurii deja existente sau prin instalarea pilot și testarea de încărcare. Pentru sistemele neîncărcate se aplică „best practice”. În special, VMware consideră un coeficient mediu de 8:1.
Memorie RAM
Necesitatea totală de memorie operațională se obține prin simpla sumare. Utilizarea re-subscrierii memoriei operaționale nu este recomandată.
Resurse de stocare
Cerințele pentru resursele de stocare se obțin prin simpla sumare a tuturor pool-urilor în funcție de volum și performanță.
Cerințele de performanță se exprimă în IOPS, în combinație cu raportul mediu de citire/scriere și, dacă este necesar, cu întârzierea maximă a răspunsului.
Trebuie specificate separat cerințele pentru asigurarea calității serviciilor (QoS) pentru pool-uri sau sisteme specifice.
Resurse de rețea de date
Cerințele pentru rețeaua de date se obțin prin simpla sumare a tuturor pool-urilor de lățime de bandă.
Trebuie specificate separat cerințele pentru asigurarea calității serviciilor (QoS) și întârzierilor (RTT) pentru pool-uri sau sisteme specifice.
În cadrul cerințelor pentru resursele rețelei de date, se specifică de asemenea cerințele pentru izolare și/sau criptarea traficului de rețea și mecanismele preferate (802.1q, IPSec etc.).
Alegerea arhitecturii
În cadrul acestui ghid, nu se ia în considerare altă alegere decât arhitectura x86 și virtualizarea 100% a serverelor. Prin urmare, alegerea arhitecturii subsistemului de calcul se reduce la selecția platformei de virtualizare a serverului, a factorului de formă al serverelor și a cerințelor generale privind configurația serverelor.
Un aspect esențial al alegerii este claritatea în utilizarea abordării clasice cu separarea funcțiilor de procesare, stocare și transmitere a datelor sau a celei convergente.
Arhitectura clasică implică utilizarea sistemelor externe de stocare și transfer de date inteligente, în timp ce serverele contribuie la pool-ul general de resurse fizice doar cu puterea de procesare și memoria RAM. În cazul extrem, serverele devin complet anonime, fără nu doar propriile diskuri, ci chiar și un identificator de sistem. În acest caz, se utilizează boot-ul OS-ului sau al hypervisor-ului de pe unități flash încorporate sau de pe un sistem de stocare extern (boot from SAN).
În cadrul arhitecturii clasice, alegerea între blade-uri și rack-uri se face în principal pe baza următoarelor principii:
— Eficiența economică (în medie, serverele rack sunt mai ieftine);
— Densitatea de calcul (blade-urile au o densitate mai mare);
— Consumul de energie și disiparea căldurii (blade-urile au un consum specific mai mare pe unitate);
— Scalabilitatea și gestionabilitatea (blade-urile necesită în general mai puțin efort la instalări mari);
— Utilizarea plăcilor de expansiune (pentru blade-uri, opțiunile sunt foarte limitate).
Arhitectura convergentă (cunoscută și sub denumirea de hyperconvergentă) presupune combinarea funcțiilor de procesare și stocare a datelor, ceea ce duce la utilizarea diskurilor locale ale serverelor și, ca urmare, la renunțarea la factorul de formă al blade-urilor clasice. Pentru sistemele convergente sunt utilizate fie servere rack, fie sisteme cluster care combină într-o carcasă unică mai multe servere blade și diskuri locale.
CPU / Memorie
Pentru un calcul corect al configurației, trebuie să înțelegem tipul de sarcină pentru mediu sau fiecare dintre clusterele independente.
CPU bound – un mediu limitat de performanță de procesare. Adăugarea de memorie RAM nu va schimba nimic din perspectiva performanței (numărul de VM-uri pe server).
Memory bound – un mediu limitat de memorie RAM. O cantitate mai mare de memorie RAM pe server permite rularea unui număr mai mare de VM-uri pe server.
GB / MHz (GB / pCPU) – raportul mediu de consum al memoriei RAM și puterii de procesare pentru această sarcină specifică. Poate fi utilizat pentru a calcula volumul necesar de memorie pentru o anumită performanță și invers.
Calculul configurației serverului
În primul rând, trebuie să determinăm toate tipurile de sarcini și să decidem asupra combinării sau separării diferitelor pool-uri de calcul între diverse clustere.
Apoi, pentru fiecare dintre clusterele definite, se determină raportul GB / MHz în funcție de sarcina cunoscută anterior. Dacă sarcina nu este cunoscută, dar avem o idee aproximativă despre nivelul de utilizare a puterii CPU, se pot utiliza coeficientele standard vCPU:pCPU pentru a traduce cerințele pool-urilor în fizic.
Pentru fiecare cluster, suma cerințelor pool-urilor vCPU se împarte la coeficient:
vCPUsumă / vCPU:pCPU = pCPUsumă – numărul necesar de nuclee fizice
pCPUsumă / 1.25 = pCPUht – numărul de nuclee cu ajustare pentru Hyper-Threading
Să presupunem că trebuie să calculăm un cluster cu 190 de nuclee / 3.5TB RAM. În acest caz, acceptăm o încărcare țintă de 50% din puterea CPU și 75% din memoria RAM.
pCPU
190
Utilizare CPU
50%
Memorie
3500
Utilizare memorie
75%
Socket
Nucleu
Srv / CPU
Srv Memorie
Srv / Memorie
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
În acest caz, folosim întotdeauna rotunjirea la cel mai apropiat întreg în sus (=ROUNDUP(A1;0)).
Din tabel devine evident că mai multe configurații de servere sunt echilibrate în funcție de indicatorii țintiți:
— 26 servere 2*6c / 192 GB
— 19 servere 2*10c / 256 GB
— 10 servere 2*18c / 512 GB
Alegerea dintre aceste configurații trebuie să se facă în continuare pe baza unor factori suplimentari, cum ar fi pachetul termic și răcirea disponibilă, serverele deja utilizate sau costul.
Particularitățile alegerii configurației serverului
VM-uri largi. Dacă este necesară plasarea de VM-uri largi (comparabile cu 1 nod NUMA și mai mult), se recomandă, pe cât posibil, alegerea unui server cu o configurație care să permită acestor VM-uri să rămână în limitele unui nod NUMA. Atunci când există un număr mare de VM-uri largi, există riscul fragmentării resurselor clusterului, iar în acest caz se aleg servere care permit plasarea VM-urilor largi cât mai compact.
Dimensiunea domeniului de eșec unic.
Alegerea dimensiunii serverului se face de asemenea pe principiul minimalizării domeniului de eșec unic. De exemplu, la alegerea între:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Când toate celelalte sunt egale, este necesar să se aleagă a doua opțiune, deoarece la defectarea unui server (sau în timpul întreținerii) nu se pierd 33% din resursele clusterului, ci 17%. La fel, numărul de VM-uri și de IS afectate de accident se reduce la jumătate.
Calculul unui sistem clasic de stocare pe baza performanței
Sistemul clasic de stocare este întotdeauna calculat pe baza celui mai rău caz, excluzând influența cache-ului operațional și optimizării operațiunilor.
Ca indicatori de bază ai performanței, considerăm performanța mecanică de pe disc (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Mai departe, numărul de discuri din pool-ul de discuri se calculează folosind următoarea formulă: = TotalIOPS * ( RW + (1 – RW) * RAIDPen) / IOPSdisk. Unde:
— TotalIOPS – performanța totală necesară în IOPS din pool-ul de discuri
— RW – procentul de operațiuni de citire
— RAIDpen – penalizarea RAID pentru nivelul RAID ales
Informații suplimentare despre dispozitivele RAID și penalizarea RAID sunt prezentate aici — și și
Pe baza numărului de discuri obținut, se calculează opțiunile posibile care satisfac cerințele de capacitate de stocare, inclusiv opțiuni cu stocare multi-nivel.
Calculul sistemelor care utilizează SSD ca nivel de stocare este tratat separat.
Particularitățile calculului sistemelor cu Flash Cache
Flash Cache – denumire generală pentru toate tehnologiile de marcă care utilizează memorie flash ca cache de nivel secundar. Atunci când se utilizează cache-ul flash, SCSI-ul este, de obicei, calculat pentru a asigura încărcarea stabilită de pe discurile magnetice, în timp ce vârful este gestionat de cache.
În acest context, este important să înțelegem profilul sarcinii și gradul de localizare a accesărilor la blocurile volumelor de stocare. Cache flash este o tehnologie pentru sarcini cu o localizare ridicată a cererilor și este practic inaplicabilă pentru volumele cu o încărcare uniformă (cum ar fi în sistemele de analiză).
Calculul sistemelor hibride low-end / mid-range
Sistemele hibride din clasele inferioară și medie utilizează stocare stratificată cu mutarea datelor între straturi conform unui program. În acest context, dimensiunea blocului de stocare stratificată la cele mai bune modele este de 256 MB. Aceste caracteristici nu permit considerarea tehnologiei de stocare stratificată ca o tehnologie de creștere a performanței, așa cum greșit cred mulți. Stocarea stratificată în sistemele din clasele inferioară și medie reprezintă o tehnologie de optimizare a costurilor de stocare pentru sisteme cu o încărcare inegal distribuită.
Pentru stocarea multi-nivel, se calculează în primul rând performanța nivelului superior, în timp ce nivelul inferior de stocare este considerat că aduce doar capacitatea de stocare necesară. Pentru un sistem hibrid multi-nivel, utilizarea tehnologiei flash cache este esențială în pool-ul multi-nivel pentru a compensa scăderea performanței pentru datele care se încălzesc brusc de la nivelul inferior.
Utilizarea SSD-urilor în pool-ul multi-nivel de discuri
Utilizarea SSD-urilor în pool-ul multi-nivel de discuri are variații, în funcție de particularitățile implementării algoritmilor de flash cache ale acestui producător.
Practicile generale ale politicii de stocare pentru un pool de discuri cu nivel SSD sunt — SSD first.
Flash Cache doar în citire. Pentru cache-ul flash de tip read-only, nivelul de stocare pe SSD apare atunci când operațiunile de scriere sunt semnificativ localizate, indiferent de cache.
Flash Cache Citire / Scriere. În cazul cache-ului flash pentru scriere, mai întâi se stabilește volumul maxim al cache-ului, iar nivelul de stocare pe SSD apare doar în condițiile în care dimensiunea cache-ului nu este suficientă pentru a gestiona întreaga sarcină localizată.
Calculul performanței SSD-ului și a cache-ului se realizează de fiecare dată pe baza recomandărilor producătorului, dar întotdeauna pentru cel mai prost scenariu.
Sursa: habr.com
