

SDSM s-a încheiat, dar dorința necontrolată de a scrie a rămas.
Mulți ani, fratele nostru a suferit din cauza îndeplinirii muncii de rutină, încrucișând degetele înainte de commit și lipsindu-se de somn din cauza rollback-urilor nocturne.
Dar timpurile întunecate vin la sfârșit.
Prin acest articol voi începe o serie despre cum mi se pare automatizarea.
Pe parcurs, vom analiza etapele automatizării, stocarea variabilelor, formalizarea designului, RestAPI, NETCONF, YANG, YDK și vom programa foarte mult.
Pentru mine înseamnă că a) nu este o adevărată obiectivitate, b) nu este neapărat cea mai bună abordare și c) punctul meu de vedere se poate schimba chiar și pe parcursul trecerii de la primul la ultimul articol — sincer, de la stadiul de ciornă până la publicare am rescris totul complet de două ori.
Cuprins
- Obiective
- Rețeaua — ca un organism unitar
- Testarea configurației
- Versionare
- Monitorizarea și auto-repararea serviciilor
- Instrumente
- Sistem de inventariere
- Sistem de gestionare a spațiului IP
- Sistem de descriere a serviciilor de rețea
- Mecanismul de inițializare a dispozitivelor
- Modelul de configurare agnostic la furnizor
- Driver-ul specific de interfață al furnizorului
- Mecanismul de livrare a configurației pe dispozitiv
- CI/CD
- Mecanismul de backup și de căutare a abaterilor
- Sistem de monitorizare
- Concluzie
Încerc să conduc ADSCM într-un format puțin diferit de SDSM. Vor apărea în continuare articole extinse și detaliate, iar între ele voi publica note scurte din experiența zilnică. Voi încerca să lupt împotriva perfecționismului și să nu rafinez fiecare dintre ele.
Cât de amuzant este că trebuie să parcurg același drum pentru a doua oară.
La început, a trebuit să scriu singur articole despre rețele deoarece nu existau în rețeaua rusă.
Acum nu am găsit un document cuprinzător care să sistematizeze abordările de automatizare și să analizeze tehnologiile menționate anterior prin exemple practice simple.
Poate greșesc, așa că lăsați linkuri către resurse valoroase. Totuși, asta nu-mi va schimba hotărârea de a scrie, deoarece, scopul principal este într-adevăr să învăț ceva pentru mine, iar a îmbunătăți viața celor din jur este un bonus plăcut care îmbogățește experiența.
Vom încerca să luăm un centru de date de dimensiuni medii LAN DC și să lucrăm la întreaga schemă de automatizare.
Voi face unele lucruri aproape pentru prima dată împreună cu voi.
În ideile și instrumentele descrise aici nu voi fi original. Dmitri Figol are un canal excelent .
Articolele se vor suprapune în multe aspecte cu ele.
În LAN DC sunt 4 centre de date, aproximativ 250 de comutatoare, o jumătate de duzină de routere și câteva firewall-uri.
Nu este Facebook, dar este suficient pentru a reflecta profund asupra automatizării.
Există, totuși, opinia că dacă aveți mai mult de 1 dispozitiv, aveți nevoie de automatizare.
De fapt, este greu de imaginat că cineva ar putea trăi acum fără cel puțin un pachet de scripturi pe genunchi.
Deși am auzit că există companii unde contabilizarea adreselor IP se face în Excel, iar fiecare dintre sutele de dispozitive de rețea este configurat manual și are o configurație unică. Acest lucru poate fi considerat artă modernă, dar sentimentele unui inginer vor fi cu siguranță rănite.
Obiective
În acest moment, ne vom stabili obiectivele cele mai abstracte:
- Rețeaua — ca un organism unitar
- Testarea configurației
- Versionarea stării rețelei.
- Monitorizarea și auto-repararea serviciilor
Mai târziu, în acest articol, vom analiza ce instrumente vom folosi, iar în următoarele, atât obiectivele, cât și instrumentele în detalii.
Rețeaua — ca un organism unitar
Fraza definitorie a ciclului, deși la prima vedere poate părea nesemnificativă: vom configura rețeaua, nu dispozitivele individuale..
În ultimii ani, observăm o schimbare a accentelor către tratarea rețelei ca pe o entitate unică, de aici și noile concepte care ne apar în viață. Software Defined Networking, Intent Driven Networks și Autonomous Networks.
Pentru că ce au aplicațiile de la rețea din punct de vedere global: conectivitatea între punctele A și B (uneori +B-Y) și izolarea de alte aplicații și utilizatori.
Și astfel, sarcina noastră în această serie este: să construim un sistem, care să susțină configurația actuală a întregii rețele, care se decompozează deja în configurația actuală pe fiecare dispozitiv conform rolului și locației sale.
Sistem gestionarea rețelei implică faptul că pentru a efectua modificări ne adresăm rețelei, iar aceasta va calcula starea necesară pentru fiecare dispozitiv și îl va configura.
Astfel, minimizăm aproape la zero utilizarea CLI manual — orice modificări în configurarea dispozitivelor sau în designul rețelei trebuie formalizate și documentate — și abia apoi implementate pe elementele necesare ale rețelei.
Adică, de exemplu, dacă am decis că, de acum înainte, switch-urile de rack din Kazan trebuie să anunțe două rețele în loc de una, noi
- Mai întâi documentăm modificările în sisteme
- Generăm configurația țintă pentru toate dispozitivele din rețea
- Lansăm programul de actualizare a configurației rețelei, care calculează ce trebuie eliminat pe fiecare nod, ce trebuie adăugat și aduce nodurile în starea dorită.
În această etapă, intervenim manual doar la primul pas.
Testarea configurației
, că 80% din probleme apar în timpul modificării configurației — un indiciu indirect este că, în perioada sărbătorilor de iarnă, de obicei totul decurge fără probleme.
Am fost martorul a zeci de downtime-uri globale cauzate de erori umane: comenzi greșite, executate în ramuri de configurație greșite, uitate comunități, ștergerea globală a MPLS-ului pe un router, configurarea a cinci dispozitive, iar la al șaselea nu am observat eroarea, am comis modificări vechi făcute de o altă persoană. Există o mulțime de scenarii.
Automatizarea ne va permite să facem mai puține greșeli, dar la o scară mai mare. Astfel putem bloca nu un singur dispozitiv, ci întreaga rețea dintr-o dată.
Din vremuri imemoriale, strămoșii noștri verificau corectitudinea modificărilor efectuate cu un ochi ager, determinare și funcționalitatea rețelei după implementarea acestora.
Acești strămoși, ale căror lucrări duceau la inactivitate și pierderi catastrofale, lăsau mai puțini urmași și ar trebui, în timp, să dispară, dar evoluția este un proces lent, și de aceea încă nu toți verifică mai întâi modificările în laborator.
Totuși, la vârful progresului se află cei care au automatizat procesul de testare a configurației și aplicarea acesteia în rețea. Cu alte cuvinte — au împrumutat procedura CI/CD () de la dezvoltatori.
În una dintre părți, vom analiza cum să implementăm acest lucru folosind un sistem de control al versiunilor, probabil GitHub.
Odată ce te obișnuiești cu noțiunea de CI/CD în rețea, metoda de verificare a configurației prin aplicarea ei pe rețeaua de lucru ți se va părea o ignoranță medievală timpurie. Aproape ca și cum ai bătut cu un ciocan pe o warhead.
O continuare organică a ideilor despre sistemul de gestionare a rețelei și CI/CD devine un veritabil versionare a configurației.
Versionare
Vom presupune că, la orice modificare, chiar și cele mai nesemnificative, chiar pe un dispozitiv neobservat, întreaga rețea trece de la o stare la alta.
Și noi, de fiecare dată, nu executăm comanda pe dispozitiv, ci schimbăm starea rețelei.
Hai să numim aceste stări versiuni?
Să zicem că versiunea curentă este 1.0.0.
S-a schimbat adresă IP a interfeței Loopback pe unul dintre ToR-uri? Aceasta este o versiune minoră — va obține numărul 1.0.1.
Am revizuit politicile de import a rutelor în BGP — un pic mai serios — deja 1.1.0
Am decis să scăpăm de IGP și să trecem doar la BGP — aceasta este deja o schimbare radicală de design — 2.0.0.
În același timp, centrele de date diferite pot avea versiuni diferite — rețeaua se dezvoltă, se instalează echipamente noi, unde se adaugă niveluri noi de spine, unde nu, etc.
Despre vom discuta într-un articol separat.
Reiterez — orice modificare (cu excepția comenzilor de depanare) este o actualizare a versiunii. Orice abateri de la versiunea actuală trebuie să fie notificate administratorilor.
Același lucru se aplică și întoarcerii modificărilor — aceasta nu este anularea ultimelor comenzi, nu este un rollback realizat de sistemul de operare al dispozitivului — este readucerea întregii rețele la o versiune nouă (veche).
Monitorizarea și auto-repararea serviciilor
Aceasta este o sarcină evidentă în rețelele moderne care ajunge la un nou nivel.
Adesea, la marii furnizori de servicii se practică abordarea că un serviciu picat trebuie reparat foarte repede și să fie ridicat unul nou, în loc să încerce să afle ce s-a întâmplat.
«Foarte» înseamnă că din toate colțurile trebuie să te îmbraci în moduri de monitorizare, care în câteva secunde vor detecta cele mai mici abateri de la normă.
Și aici nu sunt suficiente metricile obișnuite, precum încărcarea interfeței sau disponibilitatea nodului. Nici monitorizarea manuală a observatorului nu este suficientă.
Pentru multe lucruri, ar trebui să existe — monitorizările au început să clipească roșu și au mers singure să aplice planta, unde doare.
În acest context, monitorizăm nu doar dispozitivele individuale, ci și sănătatea rețelei în ansamblu, atât în modul white box, care este relativ ușor de înțeles, cât și în modul black box, care este deja mai complex.
Ce ne va fi necesar pentru a realiza astfel de planuri ambițioase?
- Să avem o listă a tuturor dispozitivelor din rețea, locația acestora, rolurile, modelele, versiunile software.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Să avem un sistem de descriere a serviciilor de rețea.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Să putem iniția dispozitivul.
Hostname, Mgmt IP, Mgmt Route, Users, RSA-Keys, LLDP, NETCONF - Să configurăm dispozitivul și să readucem configurația la versiunea dorită (inclusiv o versiune anterioară).
- Să testăm configurația
- Să verificăm periodic starea tuturor dispozitivelor pentru a identifica eventualele abateri de la starea actuală și să informăm persoanele implicate.
Noaptea, cineva a adăugat în liniște o regulă în ACL. - Să monitorizăm funcționarea.
Instrumente
Pare destul de complicat pentru a începe să decompozăm proiectul în componente.
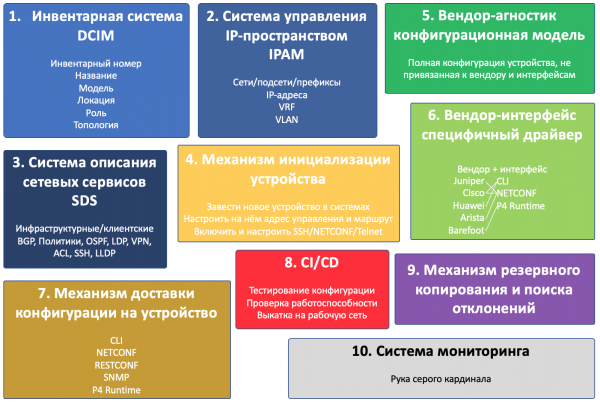
Vor fi zece dintre ele:
- Sistem de inventariere
- Sistem de gestionare a spațiului IP
- Sistem de descriere a serviciilor de rețea
- Mecanismul de inițializare a dispozitivelor
- Modelul de configurare agnostic la furnizor
- Driver-ul specific de interfață al furnizorului
- Mecanismul de livrare a configurației pe dispozitiv
- CI/CD
- Mecanismul de backup și de căutare a abaterilor
- Sistem de monitorizare
Acesta este, de altfel, un exemplu despre cum s-a schimbat perspectiva asupra obiectivelor ciclului — în schița componentelor erau patru.
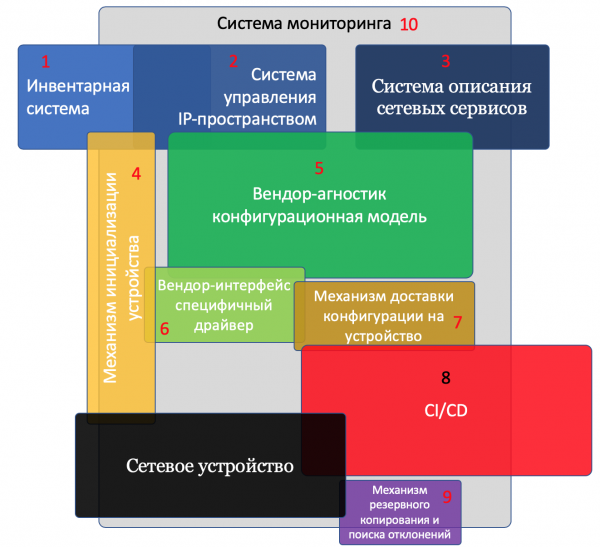
În ilustrație, am reprezentat toate componentele și dispozitivul propriu-zis.
Componentele intersectate interacționează între ele.
Cu cât este mai mare blocul, cu atât mai multă atenție trebuie acordată acestui component.
Componenta 1. Sistem de inventariere
Este evident că dorim să știm ce echipament este, unde se află și la ce este conectat.
Sistemul de inventariere este o parte integrantă a oricărei întreprinderi.
Cel mai frecvent, pentru dispozitivele de rețea, întreprinderea are un sistem de inventariere dedicat, care rezolvă sarcini mai specifice.
În cadrul acestui ciclu de articole, ne vom referi la aceasta ca DCIM — Managementul Infrastructurii Centrului de Date. Deși termenul DCIM, strict vorbind, include mult mai mult.
Pentru sarcinile noastre, vom stoca următoarele informații despre dispozitiv:
- Numărul de inventar
- Nume/descriere
- Model (Huawei CE12800, Juniper QFX5120 etc.)
- Parametrii caracteristici (plăci, interfețe etc.)
- Rol (Leaf, Spine, Border Router etc.)
- Locația (regiune, oraș, centru de date, rack, unitate)
- Interconexiunile între dispozitive
- Topologia rețelei
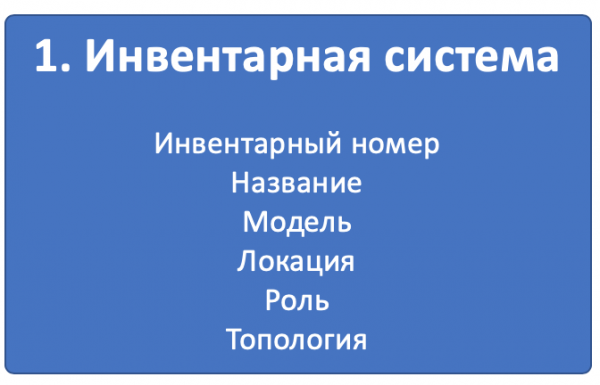
Este clar că ne dorim să cunoaștem toate acestea.
Dar va ajuta aceasta în scopurile automatizării?
Cu siguranță.
De exemplu, știm că în acest centru de date, pe comutatoarele Leaf, dacă este vorba de Huawei, ACL pentru filtrarea anumitor tipuri de trafic ar trebui aplicate pe VLAN, iar dacă este Juniper — atunci pe unitatea 0 a interfeței fizice.
Sau trebuie să implementăm un nou server Syslog pe toate granițele regiunii.
În aceasta vom stoca dispozitivele de rețea virtuale, cum ar fi ruterele virtuale sau reflectoarele de rută. Putem adăuga servere DNS, NTP, Syslog și, în general, tot ceea ce se referă la rețea.
Componenta 2. Sistemul de gestionare a spațiului IP
Da, și în zilele noastre există echipe de oameni care țin registro pentru prefixe și adrese IP în fișiere Excel. Dar abordarea modernă este, totuși, o bază de date, cu un frontend pe nginx/apache, API și funcții extinse pentru gestionarea adreselor și rețelelor IP, împărțite pe VRF.
IPAM — Gestionarea Adreselor IP.
Pentru sarcinile noastre, în ea vom stoca următoarele informații:
- VLAN
- VRF
- Rețele/Subrețele
- adrese IP
- Legătura adreselor la dispozitive, rețelile la locații și numerele VLAN
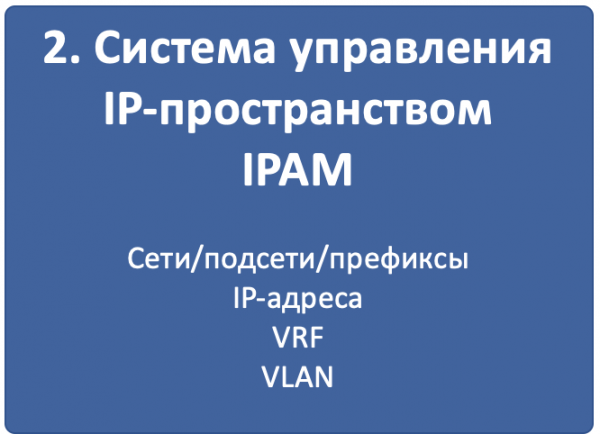
Din nou este clar că dorim să ne asigurăm că, atribuind o nouă adresă IP pentru loopback-ul ToR-ului, nu ne vom împiedica de faptul că aceasta a fost deja alocată cuiva. Sau că același prefix a fost utilizat de două ori în colțuri diferite ale rețelei.
Dar cum va ajuta asta la automatizare?
Ușor.
Cerem în sistem prefixul cu rolul Loopbacks, în care există adrese IP disponibile pentru alocare — dacă se găsește, alocăm adresa, dacă nu, cerem crearea unui nou prefix.
Sau, la crearea configurației unui dispozitiv, putem afla din acest sistem în care VRF ar trebui să se găsească interfața.
Și, la pornirea unui nou server, scriptul va consulta sistemul, va afla în care switch de server, în care port și ce subrețea este alocată pe interfață — de acolo va aloca adresa serverului.
Este o idee bună să combinăm DCIM și IPAM într-un singur sistem, pentru a nu dubla funcțiile și a nu gestiona două entități asemănătoare.
Și așa vom face.
Componenta 3. Sistemul de descriere a serviciilor de rețea
Dacă primele două sisteme stochează variabile care trebuie utilizate în continuare, atunci al treilea descrie pentru fiecare rol al dispozitivului, cum ar trebui să fie configurat.
Merită să evidențiem două tipuri diferite de servicii de rețea:
- Infrastructurale
- Clienți.
Primul tip este destinat asigurării conectivității de bază și gestionării echipamentului. Acesta include VTY, SNMP, NTP, Syslog, AAA, protocoalele de rutare, CoPP etc.
Al doilea tip organizează serviciul pentru client: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP etc.
Desigur, există și cazuri limită — unde includem MPLS LDP, BGP? De asemenea, protocoalele de rutare pot fi folosite pentru clienți. Dar asta nu este esențial.
Ambele tipuri de servicii sunt desfășurate pe primitive de configurare:
- interfețe fizice și logice (tag/untag, mtu)
- Adrese IP și VRF (IP, IPv6, VRF)
- ACL și politici de gestionare a traficului
- Protocoale (IGP, BGP, MPLS)
- Politici de rutare (liste de prefixe, comunități, filtre ASN).
- Servicii de sistem (SSH, NTP, LLDP, Syslog…)
- Și altele.
Nu știu încă exact cum vom face asta. Ne vom ocupa în cadrul unui articol separat.
Dacă ne îndepărtăm puțin de teorie, am putea descrie că
Comutatorul Leaf trebuie să aibă sesiuni BGP cu toate comutatoarele Spine conectate, să importe rețelele conectate în proces, să accepte numai rețele dintr-un anumit prefix de la comutatoarele Spine. Să limiteze CoPP IPv6 ND la 10 pps etc.
La rândul lor, spinii mențin sesiuni cu toți livratorii conectați, acționând ca reflector de rădăcină, și acceptă de la aceștia doar rutele de o anumită lungime și cu o anumită comunitate.
Componenta 4. Mecanismul de inițializare a echipamentului
Sub acest titlu, unific multe acțiuni care trebuie să aibă loc pentru ca echipamentul să fie vizibil și accesibil de la distanță.
- Introducerea echipamentului în sistemul de inventariere.
- Alocarea unei adrese IP de management.
- Configurarea accesului de bază la acesta:
Nume gazdă, adresă IP de management, rută către rețeaua de management, utilizatori, chei SSH, protocoale — telnet/SSH/NETCONF
Există trei abordări:
- Totul manual. Echipamentul este adus pe stand, unde o persoană obișnuită îl va introduce în sistem, se va conecta la consolă și îl va configura. Poate funcționa pe rețele statice mici.
- ZTP — Zero Touch Provisioning. Echipamentul a sosit, s-a aliniat, a primit o adresă prin DHCP, a mers pe un server special și s-a auto-configurat.
- Infrastructura serverelor de consolă, unde configurarea inițială se realizează prin portul de consolă în mod automat.
Despre toate trei vom discuta într-un articol separat.
Componenta 5. Modelul de configurare independent de furnizor
Până acum, toate sistemele erau niște patch-uri disparate, oferind o descriere variabilă și declarativă a ceea ce ne-ar plăcea să vedem pe rețea. Însă, mai devreme sau mai târziu, va fi necesar să ne ocupăm de concret.
În această etapă, pentru fiecare dispozitiv specific, primitivele, serviciile și variabilele sunt combinate într-un model de configurare, care descrie efectiv configurația completă a dispozitivului respectiv, doar că într-o manieră independentă de furnizor.
Ce aduce acest pas? De ce să nu formăm imediat configurația dispozitivului, pe care putem să o încărcăm direct?
De fapt, acest lucru permite rezolvarea a trei sarcini:
- Să nu ne adaptăm la o interfață specifică de interacțiune cu dispozitivul. Fie că este vorba de CLI, NETCONF, RESTCONF, SNMP - modelul va fi același.
- Să nu avem un număr de șabloane/scripturi în funcție de numărul de furnizori din rețea, și, în cazul schimbării designului, să modificăm același lucru în mai multe locuri.
- Să încărcăm configurația de pe dispozitiv (backup), să o descompunem într-un model exact și să comparăm direct configurația țintă cu cea existentă pentru a calcula delta și a pregăti un patch de configurație, care va schimba doar acele părți care sunt necesare sau pentru a identifica abaterile.
Ca urmare a acestei etape, obținem o configurație independentă de furnizor.
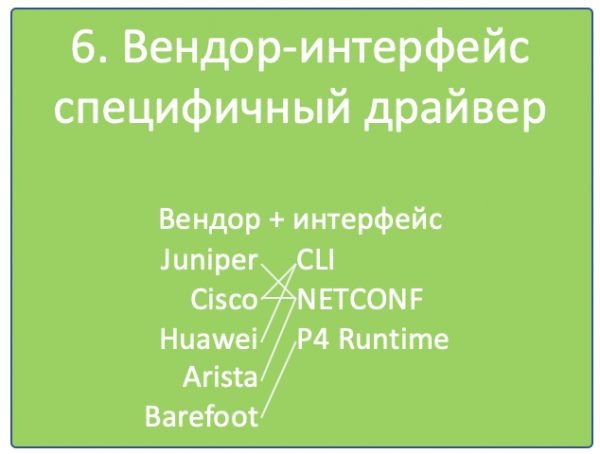
Componentele 6. Driver specific interfeței de furnizor
Nu trebuie să ne facem iluzii că, cândva, vom putea configura Cisco exact la fel ca Juniper, trimisându-le apeluri absolut identice. În ciuda popularității în creștere a whitebox-urilor și a apariției suportului pentru NETCONF, RESTCONF, OpenConfig, conținutul specific care este livrat prin aceste protocoale variază de la un furnizor la altul, iar aceasta este una dintre diferențele lor competitive, pe care nu le vor relinquisha atât de ușor.
Este aproximativ la fel ca OpenContrail și OpenStack, care au RestAPI ca interfața lor NorthBound, așteptând apeluri complet diferite.
Așadar, în pasul cinci, modelul independent de furnizor trebuie să ia forma în care va fi implementat pe hardware.
Și aici sunt acceptate toate metodele (nu): CLI, NETCONF, RESTCONF, SNMP sunt toate capabile.
Prin urmare, avem nevoie de un driver care să transforme rezultatul pasului anterior în formatul necesar pentru furnizorul specific: un set de comenzi CLI, o structură XML.
Componenta 7. Mecanismul de livrare a configurației către dispozitiv
Configuratia a fost generată, dar trebuie încă livrată pe dispozitive — și evident, nu manual.
În primul rând, în fața noastră se pune întrebarea, ce transport vom folosi? Iar alegerea de astăzi nu este o mică:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (deși acesta iese din lista noastră, deoarece este un mod de a livra FIB, nu configurații)
Hai să lămurim lucrurile. CLI este legat de trecut. SNMP… eh-eh.
RESTCONF este încă o necunoscută, iar REST API nu este suportat de aproape nimeni. Așadar, ne vom concentra pe NETCONF în acest ciclu.
De fapt, așa cum a înțeles cititorul, în ceea ce privește interfața ne-am decis deja — rezultatul pasului anterior este prezentat în formatul interfeței alese.
În al doilea rând, iar cu ce instrumente vom face asta?
Aici alegerea este de asemenea mare:
- Script personalizat sau platformă. Vom folosi ncclient și asyncIO și vom face totul noi. Ce ne oprește să construim un sistem de deploy de la zero?
- Ansible cu biblioteca sa bogată de module de rețea.
- Salt cu suport limitat pentru rețea și integrarea cu Napalm.
- Napalm, care cunoaște doar câțiva furnizori și atât, la revedere.
- Nornir — un alt animal pe care îl vom dissecta în viitor.
Aici favoritul nu a fost ales — vom continua să explorăm.
Ce este important aici? Consecințele aplicării configurației.
Fie că a fost un succes sau nu. A rămas acces la echipament sau nu.
Se pare că aici ajută commit-ul cu confirmare și validare a ceea ce a fost încărcat în dispozitiv.
Aceasta, împreună cu o implementare corectă a NETCONF, restrânge semnificativ cercul de dispozitive care se potrivesc — commit-urile normale nu sunt susținute de multe producători. Dar aceasta este doar una dintre condițiile obligatorii în . În cele din urmă, nimeni nu se îngrijorează că niciun furnizor rus nu va îndeplini condiția unui interfață de 32*100GE. Sau se îngrijorează?
Componenta 8. CI/CD
Până la acest moment avem deja configurația pregătită pentru toate dispozitivele din rețea.
Spun «pentru toate», deoarece vorbim despre versionarea stării rețelei. Chiar dacă trebuie să schimbăm setările pentru un singur switch, modificările sunt calculate pentru întreaga rețea. Evident, acestea pot fi zero pentru majoritatea nodurilor.
Dar, așa cum am spus mai sus, nu suntem niște barbară pentru a lansa totul simultan în producție.
Configurația generată trebuie să treacă întâi prin Pipeline CI/CD.
CI/CD înseamnă Integrare Continuă, Livrare Continuă. Este o metodă prin care echipa nu lansează un nou release major o dată la șase luni, înlocuind complet vechiul, ci implementează regulat și incremental (Deployment) noi funcționalități în porții mici, fiecare dintre acestea fiind testată cuprinzător pentru compatibilitate, securitate și funcționalitate (Integration).
Pentru aceasta, avem un sistem de control al versiunilor, care urmărește modificările de configurație, un laborator în care se verifică dacă serviciul client nu este afectat, un sistem de monitorizare care verifică acest lucru, iar ultimul pas este implementarea modificărilor în rețeaua operațională.
Cu excepția comenzilor de depanare, absolut toate modificările din rețea trebuie să treacă prin CI/CD Pipeline — aceasta este garanția unei vieți liniștite și a unei cariere lungi și fericite.
Componenta 9. Sistemul de backup și de detectare a abaterilor
Ei bine, nu trebuie să mai discutăm despre backup-uri încă o dată.
Le vom aduna pur și simplu pe cron sau în funcție de modificările de configurație din git.
Dar a doua parte este mai interesantă — cineva trebuie să supravegheze aceste backup-uri. Și în unele cazuri, acest cineva trebuie să revină la cele anterioare, iar în altele, să le reproșeze cuiva că există o problemă.
De exemplu, dacă apare un nou utilizator, care nu este înscris în variabile, trebuie să fie eliminat departe de hack. Iar dacă apare o nouă regulă de firewall — mai bine nu o atinge, este posibil ca cineva să fi activat doar depanarea, sau poate un nou serviciu, neîndemânatic, a fost înscris greșit, fiindcă oameni deja au început să-l folosească.
De la o anumită delta mică în cadrul rețelei, tot nu ne vom despărți, în ciuda oricăror sisteme de automatizare și a unei mâini de fier a conducerii. Pentru depanarea problemelor, oricum nimeni nu va face modificări de configurație în sisteme. Cu atât mai mult, modelul de configurare poate să nu prevadă nici măcar aceste modificări.
De exemplu, o regulă de firewall pentru a număra pachetele către un anumit IP, pentru localizarea problemei — este o configurație temporară destul de obișnuită.
Componenta 10. Sistemul de monitorizare
La început, nu intenționam să discut despre monitorizare — este totuși un subiect voluminos, controversat și complex. Dar pe parcurs s-a dovedit a fi o parte integrantă a automatizării. Și nu se poate ocoli, chiar și fără practică.
Dezvoltând ideea, aceasta este o parte organică a procesului CI/CD. După desfășurarea configurației pe rețea, trebuie să putem determina dacă totul este în regulă cu aceasta.
Și nu este vorba doar despre graficele de utilizare a interfețelor sau despre disponibilitatea nodurilor, ci și despre lucruri mai subtile - existența route-urilor necesare, atributelor acestora, numărul sesiunilor BGP, vecinilor OSPF, funcționalitatea End-to-End a serviciilor superioare.
Dar nu cumva log-urile nu s-au mai adunat pe serverul extern, nu s-a stricat agentul SFlow, nu au început să crească pachetele pierdute în cozi, nu s-a întrerupt conectivitatea între o pereche de prefixe?
Într-un articol separat ne vom gândi și la acest lucru.
Concluzie
Ca bază am ales unul dintre designurile moderne ale rețelelor de centre de date - L3 Clos Fabric cu BGP ca protocol de rutare.
Vom construi rețeaua de data aceasta pe Juniper, deoarece acum interfața JunOs este elegantă.
Ne vom complica viața folosind doar unelte Open Source și o rețea multi-vendor - astfel că, pe lângă Juniper, în timpul procesului voi alege și un alt norocos.
Planul publicațiilor viitoare este aproximativ acesta:
Întâi voi vorbi despre rețelele virtuale. În primul rând, pentru că îmi doresc, iar în al doilea rând, pentru că fără aceasta designul rețelei de infrastructură nu va fi foarte clar.
Apoi, efectiv despre designul rețelei: topologia, rutarea, politicile.
Vom aduna un laborator de testare.
Ne vom gândi și, poate, vom exersa inițializarea echipamentului în rețea.
Iar apoi despre fiecare componentă în detalii intime.
Și da, nu promit că voi încheia elegant acest ciclu cu o soluție gata. 🙂
Linkuri utile
- Înainte să ne adâncim în serie, merită citită cartea Natashaii Samoilenko . Și, poate, să urmezi .
- De asemenea, va fi util să citești despre designul fabricilor de centre de date de la Facebook, scris de Petru Lapuhov.
- Documentația despre arhitectura (fosta Open Contrail) îți va oferi o idee despre cum funcționează SDN-ul Overlay.
Mulțumesc
Roman Gorge. Pentru comentarii și corecturi.
Artiom Cernobai. Pentru KDPV.
Sursa: habr.com
