

În am descris cadrul de automatizare a rețelei. Conform feedback-ului, unii oameni au reușit să clarifice anumite întrebări legate de această primă abordare a problemei. Și acest lucru mă bucură foarte mult, deoarece scopul nostru în acest ciclu nu este să acoperim Ansible cu scripturi Python, ci să construim un sistem.
Acest cadru stabilește ordinea în care vom aborda întrebarea.
Și virtualizarea rețelei, despre care se vorbește în această ediție, nu se încadrează foarte bine în tema ADMS, unde discutăm despre automatizare.
Dar să ne uităm la ea dintr-un alt unghi.
De mult timp, multe servicii folosesc aceeași rețea. În cazul operatorului de telecomunicații, este vorba despre 2G, 3G, LTE, broadband și B2B, de exemplu. În cazul centrului de date: conectivitate pentru diferiți clienți, Internet, stocare bloc, stocare obiect.
Și toate serviciile necesită izolația unii de ceilalți. Așa au apărut rețelele overlay.
Și toate serviciile nu vor să aștepte ca cineva să le configureze manual. Așa au apărut orchestratoarele și SDN.
Prima abordare pentru automatizarea sistematică a rețelei, mai precis a unei părți a acesteia, a fost adoptată de mult timp și implementată în multe locuri: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Asta vom analiza astăzi.
Cuprins
- Cauzele
- Terminologie
- Underlay — rețea fizică
- Overlay — rețea virtuală
- Overlay cu ToR
- Overlay de pe gazdă
- Pe exemplul Tungsten Fabric
- Comunicarea în interiorul unei mașini fizice
- Comunicarea între VM-uri situate pe mașini fizice diferite
- Ieşire în lumea exterioară
- Întrebări frecvente
- Concluzie
- Linkuri utile
Cauzele
Și pentru că am menționat acest lucru, ar trebui să amintim premisele virtualizării rețelei. De fapt, acest proces nu a început de ieri.
Probabil că ați auzit de nenumărate ori că rețeaua a fost întotdeauna cea mai inertă parte a oricărui sistem. Și acest lucru este adevărat în toate sensurile. Rețeaua este baza pe care se sprijină totul, iar a face modificări în ea este destul de complicat — serviciile nu acceptă atunci când rețeaua este căzută. De multe ori, scoaterea din funcțiune a unui nod poate afecta o mare parte din aplicații și poate influența mulți clienți. Parțial din acest motiv, echipa de rețea poate rezista la orice modificări — pentru că acum funcționează cumva (poate că nici nu știm cum), iar acum trebuie să configurăm ceva nou, și nu știm cum va influența rețeaua.
Pentru a nu aștepta ca administratorii de rețea să implementeze VLAN și pentru a evita configurarea serviciilor pe fiecare nod al rețelei, au fost dezvoltate overlay-uri — rețele suprapuse, dintre care există o mare varietate: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE etc.
Atracția lor constă în două lucruri simple:
- Se configurează doar nodurile finale — nu trebuie să intervenim asupra transitului. Aceasta accelerează semnificativ procesul și, uneori, permite chiar excluderea departamentului de infrastructură de rețea din procesul de implementare a noilor servicii.
- Încărcătura este ascunsă adânc în antete — nodurile de tranzit nu trebuie să știe nimic despre aceasta, despre adresare pe gazde, rutele rețelei suprapuse. Asta înseamnă că trebuie să stocăm mai puține informații în tabele, ceea ce permite utilizarea unor dispozitive mai simple/mai ieftine.
În această emisiune nu foarte completă, nu intenționez să discut toate tehnologiile posibile, ci mai degrabă să descriu cadrul de funcționare al rețelelor overlay în data center.
Întreaga serie va descrie un data center format din rânduri de rack-uri identice, în care este instalat același echipament server.
Pe acest echipament se rulează mașini virtuale/containeri/serverless, care implementează servicii.
Terminologie
În ciclul serverul voi numi programul care realizează partea de server a comunicației client-server.
Mașinile fizice din rack-uri vor fi numite servere nu deci.
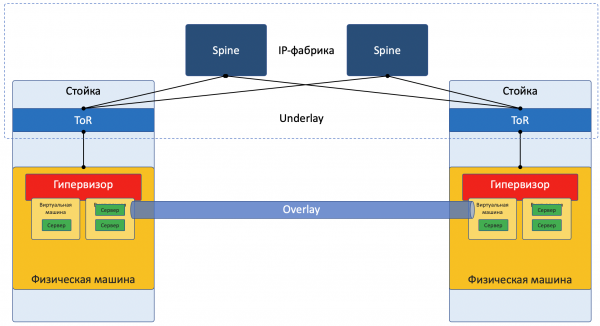
Mașina fizică — computer x86 instalat într-un rack. Cel mai frecvent folosit termen host. Așa o vom numi „mașină” sau host.
Hypervisor — aplicație care rulează pe o mașină fizică, emulând resursele fizice pe care sunt rulante Mașinile Virtuale. Uneori, în literatură și pe internet, cuvântul „hypervisor” este folosit ca sinonim pentru „host”.
Mașină virtuală — sistem de operare care rulează pe o mașină fizică deasupra hypervisorului. Pentru noi, în cadrul acestui ciclu, nu este atât de important dacă aceasta este într-adevăr o mașină virtuală sau pur și simplu un container. O vom numi „VM«
Tenant — un concept larg, pe care în acest articol îl voi defini ca un serviciu distinct sau un client distinct.
Multi-tenancy sau multi-chirie — utilizarea aceleași aplicații de către diferiți clienți/servicii. În acest caz, izolarea clienților unii de alții se realizează datorită arhitecturii aplicației, nu prin instanțe separate rulante.
ToR — Comutator de Tip Top of the Rack — un comutator instalat în rack la care sunt conectate toate mașinile fizice.
Pe lângă topologia ToR, diferiți furnizori practică End of Row (EoR) sau Middle of Row (deși acest din urmă este rar întâlnit și nu am întâlnit abrevierile MoR).
Rețea Underlay sau rețea subiacente — infrastructura fizică a rețelei: comutatoare, routere, cabluri.
Rețea Overlay sau rețea suprapusă — o rețea virtuală de tuneluri care funcționează peste fizică.
Fabrică L3 sau fabrică IP — o invenție uimitoare a umanității, care permite ca în discuții să nu se repete STP și să nu se învețe TRILL. O concept, în care întreaga rețea până la nivelul de acces este exclusiv L3, fără VLAN-uri și în consecință fără domenii de difuzare extinse. De unde provine termenul "fabrică" vom discuta în partea următoare.
SDN — Software Defined Network. Cu greu are nevoie de prezentare. O abordare de gestionare a rețelei în care modificările în rețea sunt efectuate nu de oameni, ci de programe. De obicei, înseamnă mutarea Control Plane dincolo de dispozitivele finale de rețea pe un controler.
NFV — Network Function Virtualization — virtualizarea dispozitivelor de rețea, presupunând că o parte din funcțiile rețelei pot fi rulate sub formă de mașini virtuale sau containere pentru a accelera desfășurarea de noi servicii, organizarea Service Chaining și o scalabilitate orizontală mai simplă.
VNF — Funcție de Rețea Virtuală. Un dispozitiv virtual specific: router, comutator, firewall, NAT, IPS/IDS etc.
În prezent, simplific descrierea la o realizare specifică, pentru a nu confunda prea mult cititorul. Pentru o lectură mai aprofundată, îl îndemn să consulte secțiunea . În plus, Roma Gorge, care critică acest articol pentru inexactități, promite să scrie o ediție separată despre tehnologiile de virtualizare a serverelor și rețelelor, mai detaliată și atentă la detalii.
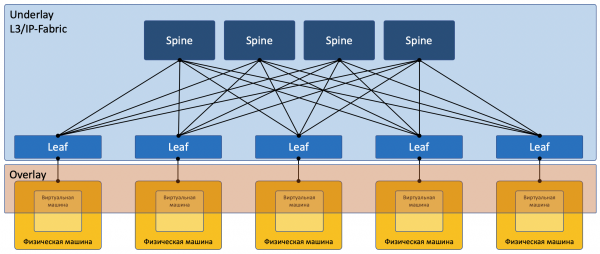
Majoritatea rețelelor de astăzi pot fi împărțite clar în două părți:
Underlay — rețeaua fizică cu o configurație stabilă.
Overlay — o abstrație deasupra Underlay pentru izolarea chiriașilor.
Aceasta este valabil atât pentru cazul DC (pe care îl vom discuta în acest articol), cât și pentru ISP (pe care nu-l vom discuta, deoarece a fost deja în ). Situația cu rețelele enterprise este, desigur, puțin diferită.
Imaginea focalizată pe rețea:
Underlay
Underlay este rețeaua fizică: comutatoare hardware și cabluri. Dispozitivele din underlay știu cum să ajungă la mașinile fizice.
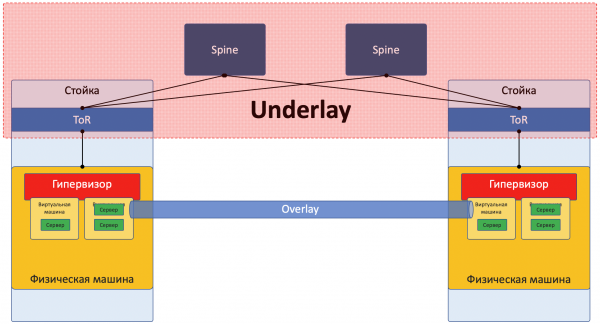
Se bazează pe protocoale și tehnologii standard. Nu în ultimul rând pentru că dispozitivele hardware de astăzi funcționează pe software proprietar care nu permite nici programarea chip-ului, nici implementarea propriilor protocoale, prin urmare, este necesară compatibilitatea cu alți furnizori și standardizarea.
Dar cineva ca Google își poate permite să dezvolte comutatoare proprii și să renunțe la protocoalele acceptate pe scară largă. Dar LAN_DC nu este Google.
Underlay se schimbă relativ rar, deoarece sarcina sa este - conectivitatea IP de bază între mașinile fizice. Underlay nu știe nimic despre serviciile, clienții, tenantii care rulează deasupra sa - trebuie doar să livreze un pachet de la o mașină la alta.
Underlay poate fi, de exemplu, astfel:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Rețeaua Underlay se configurează într-un mod clasic: CLI/GUID/NETCONF.
Manual, prin scripturi, utilitare proprietare.
În detaliu, underlay-ul va fi dedicat următorului articol din ciclu.
Overlay
Overlay este o rețea virtuală de tuneluri întinse deasupra Underlay, care permite VM-urilor unui client să comunice între ele, asigurând totodată izolația de alți clienți.
Datele clientului sunt encapsulate în antete de tunelare pentru a fi transmise prin rețeaua comună.
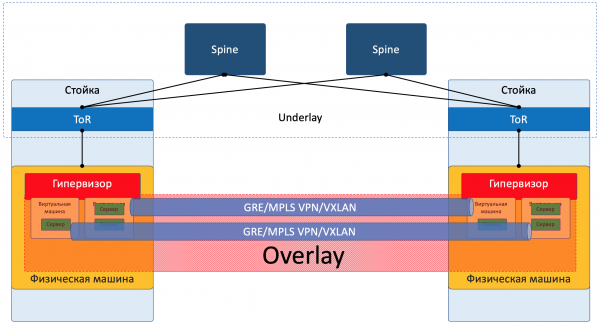
Astfel, VM-urile unui client (unui serviciu) pot comunica între ele prin Overlay, fără a fi conștiente de adevăratul traseu parcurs de pachet.
Overlay poate fi, de exemplu, așa cum am menționat mai sus:
- tunel GRE
- VXLAN
- EVPN
- L3VPN
- GENEVE
Rețeaua Overlay este de obicei configurată și întreținută printr-un controller centralizat. De acolo, configurația, Control Plane și Data Plane sunt livrate pe dispozitivele care se ocupă cu rutarea și encapsularea traficului clientului. Un pic vom analiza aceasta prin exemple.
Da, acesta este SDN în forma sa pură.
Există două abordări fundamental diferite pentru organizarea unei rețele Overlay:
- Overlay cu ToR
- Overlay de pe gazdă
Overlay cu ToR
Overlay poate începe pe un comutator de acces (ToR) situat în rack, așa cum se întâmplă, de exemplu, în cazul unei fabrici VXLAN.
Este un mecanism dovedit de timp pe rețelele ISP și toți furnizorii de echipamente de rețea îl susțin.
Cu toate acestea, în acest caz, switch-ul ToR trebuie să fie capabil să separa diferitele servicii, iar administratorul de rețea trebuie să colaboreze într-o anumită măsură cu administratorii mașinilor virtuale și să facă modificări (chiar și automat) în configurația dispozitivelor.
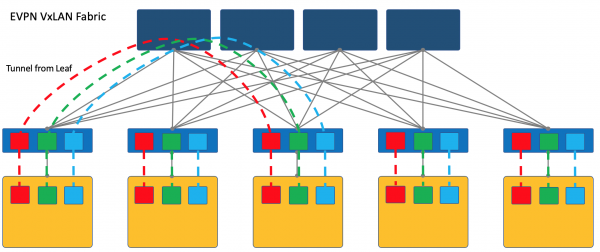
Aici voi trimite cititorul la articolul despre al nostru vechi prieten .
În această sunt descrise în detaliu abordările pentru construirea unei rețele de DC cu o fabrică EVPN VXLAN.
Și pentru a avea o înțelegere mai completă a realităților, se poate citi cartea Cisco .
Observ că VXLAN este doar o metodă de encapsulare și terminarea tunelurilor poate avea loc nu pe ToR, ci pe gazdă, așa cum se întâmplă în cazul OpenStack, de exemplu.
Cu toate acestea, fabrica VXLAN, unde overlay-ul începe pe ToR, este unul dintre designurile consacrate ale rețelei overlay.
Overlay de pe gazdă
O altă abordare este de a începe și de a termina tunelurile pe gazdele finale.
În acest caz, rețeaua (Underlay) rămâne cât mai simplă și statică.
Iar gazda face toate encapsulările necesare.
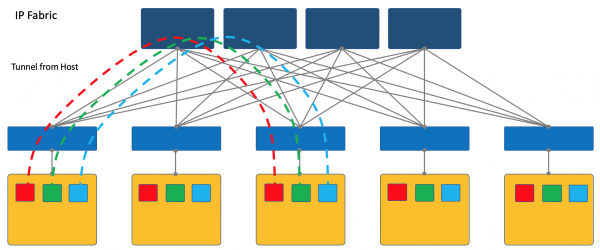
Pentru aceasta, va trebui, fără îndoială, să ruleze o aplicație specială pe gazde, dar merită.
În primul rând, este mai simplu să lansezi un client pe o mașină Linux sau, să spunem, — este chiar posibil — în timp ce pe switch, cel mai probabil, va trebui să recurgi la soluții SDN proprietare, ceea ce distruge ideea de multivendor.
În al doilea rând, switch-ul ToR poate fi lăsat cât mai simplu, atât din perspectiva Control Plane-ului, cât și a Data Plane-ului. Într-adevăr — cu un controler SDN, nu este necesar să comunice cu acesta, iar stocarea rețelelor / ARP-urilor tuturor clienților conectați nu este de asemenea necesară — este suficient să cunoști adresa IP a mașinii fizice, ceea ce facilitează semnificativ tabelele de comutare / rutare.
În seria ADSM aleg abordarea overlay-ului de pe gazdă — în continuare discutăm doar despre aceasta și nu ne vom mai întoarce la fabrica VXLAN.
Cel mai simplu este să luăm exemple. Iar ca subiect de test, vom lua platforma SDN OpenSource OpenContrail, acum cunoscută sub numele de .
La sfârșitul articolului, voi aduce câteva reflecții pe tema analogiei cu OpenFlow și OpenvSwitch.
Pe exemplul Tungsten Fabric
Pe fiecare mașină fizică există vRouter — un router virtual care cunoaște rețelele conectate la el și clienții căror le aparțin — este, în esență — un router PE. Pentru fiecare client, acesta menține un tabel de rutare izolat (citim VRF). Iar vRouter-ul se ocupă de tunelarea Overlay.
Câteva detalii despre vRouter — la finalul articolului.
Fiecare VM situată pe hipervizor se conectează la vRouter-ul acestei mașini prin .
TAP — Terminal Access Point — o interfață virtuală în nucleul Linux, care permite interacțiunea de rețea.
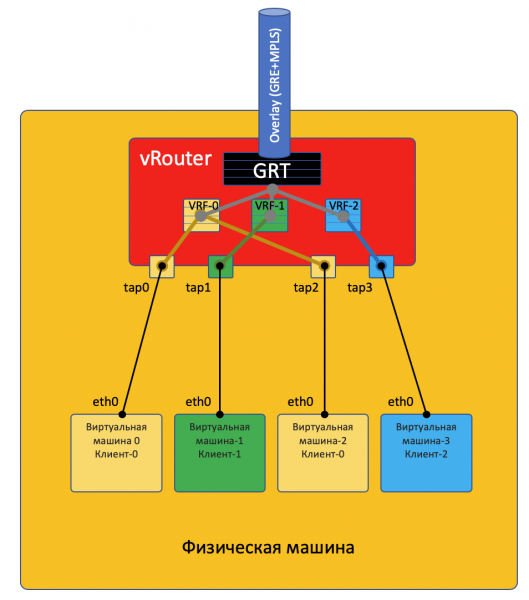
Dacă în spatele vRouter-ului se află mai multe rețele, pentru fiecare dintre ele se creează o interfață virtuală, la care i se alocă o adresă IP — aceasta va fi adresa gateway-ului predeterminat.
Toate rețelele unui client sunt plasate într-un VRF (un singur tabel), iar cele diferite — în tabele diferite.
Fac aici o observație, că nu totul este atât de simplu, și trimit cititorul curios la finalul articolului..
Pentru ca vRouter-urile să poată comunica între ele, iar, prin urmare, și VM-urile aflate în spatele lor, acestea schimbă informații de rutare prin controlerul SDN.
Pentru a ieși în lumea externă, există un punct de ieșire din matrice — gateway-ul rețelei virtuale VNGW — Virtual Network GateWay (termenul este al meu).
Acum să examinăm exemplele de comunicare — și va fi clar.
Comunicarea în interiorul unei mașini fizice
VM0 dorește să trimită un pachet către VM2. Să presupunem deocamdată că acestea sunt VM-uri ale aceluiași client.
Data Plane
- VM-0 are un rutare predeterminată în interfața sa eth0. Pachetul este trimis acolo.
Această interfață eth0 este, de fapt, conectată virtual la routerul virtual vRouter prin interfața TAP tap0. - vRouter analizează ce interfață a primit pachetul, adică cui client (VRF) îi aparține, compară adresa destinatarului cu tabelul de rutare al acestui client.
- Constatând că destinatarul se află pe aceeași mașină, dar pe un alt port, vRouter trimite pur și simplu pachetul către el fără nici un fel de anteturi suplimentare — în acest caz, vRouter-ul are deja o înregistrare ARP.
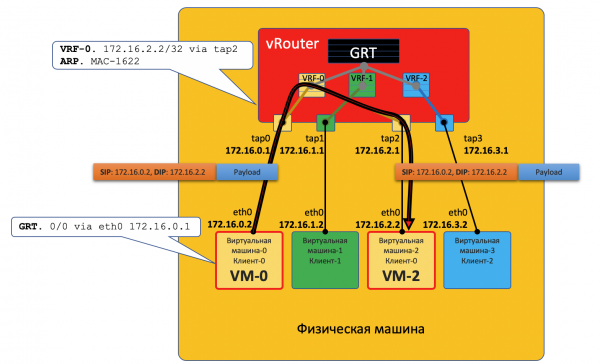
Pachetul în acest caz nu intră în rețeaua fizică — a fost rutat în interiorul vRouter-ului.
Control Plane
Hipervizorul, la pornirea mașinii virtuale, îi comunică:
- Adresa sa IP proprie.
- Rutarea predeterminată — prin adresa IP a vRouter-ului din această rețea.
vRouter-ului, printr-un API special, hipervizorul îi comunică:
- Că trebuie să creeze o interfață virtuală.
- Ce Virtual Network (VN) trebuie să creeze (VM).
- La ce VRF să conecteze acest VN.
- Înregistrarea ARP statică pentru această VM — care interfață are adresa sa IP și la ce adresă MAC este atașată.
Și din nou, procedura reală de interacțiune este simplificată în favoarea înțelegerii conceptului.
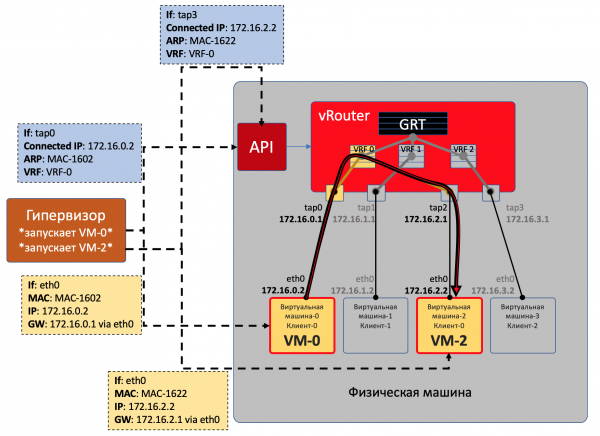
Astfel, toate VM-urile unui client pe această mașină vRouter le vede ca rețele direct conectate și poate ruteze între ele.
Însă VM0 și VM1 aparțin diferitelor clienți, prin urmare, se află în tabele diferite ale vRouter-ului.
Dacă pot comunica direct, depinde de setările vRouter-ului și de designul rețelei.
De exemplu, dacă VM-urile ambilor clienți folosesc adrese publice, sau NAT-ul se efectuează pe vRouter, se poate realiza rutare directă pe vRouter.
În contrară, este posibil să existe suprapuneri în spațiile de adrese — trebuie să treacă printr-un server NAT pentru a obține o adresă publică — asta seamănă cu ieșirea în rețelele externe de care vorbim mai jos.
Comunicarea între VM-uri situate pe mașini fizice diferite
Data Plane
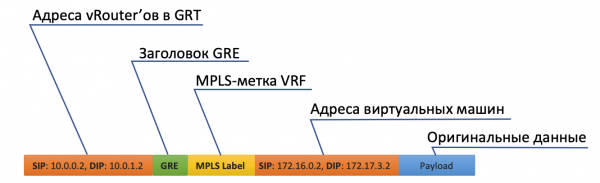
- Începutul este exact același: VM-0 trimite un pachet cu destinatarul VM-7 (172.17.3.2) prin intermediul predeterminat.
- vRouter-ul îl primește și de data aceasta vede că destinatarul se află pe o mașină diferită și este accesibil prin tunelul Tunnel0.
- Mai întâi, el adaugă o etichetă MPLS, care identifică interfața de distanță, astfel încât, pe partea opusă, vRouter-ul să poată determina unde să plaseze acel pachet fără adăugiri suplimentare de linii de cod.
- Pentru Tunnel0, sursa este 10.0.0.2, iar receptori: 10.0.1.2.
vRouter-ul adaugă antete GRE (sau UDP) și un nou IP la pachetul inițial. - În tabela de rutare a vRouter-ului există o rută implicită prin adresa ToR1 10.0.0.1. Acolo trimite.

- ToR1, ca participant în rețeaua Underlay, știe (de exemplu, prin OSPF), cum să ajungă la 10.0.1.2 și trimite pachetul pe ruta stabilită. Observați că aici se activează ECMP. În ilustrație sunt două next-hop-uri, iar diferitele fluxuri vor fi distribuite în ele prin hashing. În cazul unei fabrici adevărate, ar exista mai degrabă 4 next-hop-uri.
În acest timp, el nu are nevoie să știe ce se află sub antetul IP extern. Asta înseamnă că, de fapt, sub IP ar putea fi un sandwich din IPv6 peste MPLS peste Ethernet peste MPLS peste GRE.
- Astfel, pe partea receptorului, vRouter-ul îndepărtează GRE și, pe baza etichetei MPLS, înțelege în ce interfață trebuie să transmită acel pachet, îl descompune și îl trimite în forma sa inițială destinatarului.
Control Plane
Când se pornește mașina, se petrece tot ceea ce a fost descris mai sus.
Și în plus, următoarele:
- Fiecare client are o etichetă MPLS alocată de vRouter. Aceasta este o etichetă de servicii L3VPN, pe baza căreia clienții vor fi separați în cadrul aceleași mașini fizice.
În realitate, eticheta MPLS este alocată întotdeauna de vRouter — deoarece nu se știe dinainte că mașina va interacționa doar cu alte mașini care sunt în aceeași rețea vRouter, și cel mai probabil, chiar nu este așa.
- vRouter stabilește o conexiune cu controllerul SDN prin protocolul BGP (sau similar — în cazul TF, acesta este XMPP 0_o).
- Prin această sesiune, vRouter informează controllerul SDN despre rutele către rețelele conectate:
- Adresa rețelei
- Metoda de incapsulare (MPLSoGRE, MPLSoUDP, VXLAN)
- Eticheta MPLS a clientului
- Adresa sa IP ca nexthop
- Controllerul SDN primește aceste rute de la toate vRouterele conectate și le reflectă altora. Așadar, el funcționează ca un Route Reflector.
Același lucru se întâmplă și în sens invers.
Overlay-ul se poate schimba chiar la fiecare minut. Cam așa se întâmplă în serviciile cloud publice, când clienții pornesc și opresc frecvent mașinile lor virtuale.
Controllerul central preia toate complexitățile legate de menținerea configurației și de controlul tabelelor de comutare/rutare pe vRouter.
Pe scurt, controllerul se conectează cu toate vRouterele prin BGP (sau un protocol similar) și pur și simplu transmite informațiile de rutare. BGP, de exemplu, are deja Address-Family pentru a transmite metoda de incapsulare. sau .
În acest context, configurația rețelei Underlay nu se schimbă în niciun fel, care, de altfel, este mult mai dificil de automatizat, și se poate strica mai ușor cu un gest neglijent.
Ieşire în lumea exterioară
Undeva, simularea trebuie să se încheie, iar din lumea virtuală trebuie să ieșim în cea reală. Este nevoie de un gateway de tip taxofon.
Se practică două abordări:
- Se instalează un router hardware.
- Se lansează un appliance care îndeplinește funcțiile unui router (da, da, după SDN ne-am confruntat și cu VNF). Să-l numim gateway virtual.
Avantajul celei de-a doua abordări constă în scalabilitatea horizontală ieftină — dacă nu este suficientă puterea — se lansează încă o mașină virtuală cu gateway. Pe orice mașină fizică, fără a fi necesară căutarea unui rack liber, unități, surse de alimentare, cumpărarea hardware-ului, transportul acestuia, instalarea, conectarea, configurarea și apoi schimbarea componentelor defecte.
Dezavantajele unui gateway virtual sunt că unitatea fizică a routerului este, totuși, cu mult mai puternică decât o mașină virtuală multi-core, iar software-ul său, adaptat la suportul hardware, funcționează semnificativ mai stabil (nu). Este greu de negat că complexul software-hardware funcționează pur și simplu, necesitând doar configurare, în timp ce lansarea și întreținerea unui gateway virtual reprezintă o provocare pentru ingineri puternici.
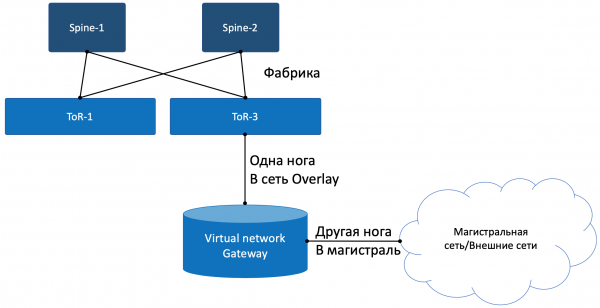
Cu o parte a sa, gateway-ul se conectează la rețeaua virtuală Overlay, ca o Mașină Virtuală obișnuită, și poate interacționa cu toate celelalte VM-uri. În același timp, aceasta poate termina rețelele tuturor clienților și, în consecință, poate efectua rutare între acestea.
Cu cealaltă parte, gateway-ul se conectează la rețeaua principală și știe cum să iasă pe Internet.
Data Plane
Așadar, procesul arată astfel:
- VM-0, având setările implicite în același vRouter, trimite un pachet cu destinația în lumea externă (185.147.83.177) către interfața eth0.
- vRouter primește acest pachet și caută adresa de destinație în tabela de rutare – găsește ruta implicită prin gateway-ul VNGW1 prin Tunnel 1.
De asemenea, el observă că acest tunel este un GRE cu SIP 10.0.0.2 și DIP 10.0.255.2, iar mai întâi trebuie să atașeze eticheta MPLS a acestui client, așteptată de VNGW1. - vRouter împachetează pachetul inițial în antete MPLS, GRE și un nou IP și îl trimite către adresa ToR1 10.0.0.1 conform setărilor implicite.
- Rețeaua de subteran livrează pachetul către gateway-ul VNGW1.
- Gateway-ul VNGW1 elimină antetele de tunelare GRE și MPLS, vede adresa de destinație, consultă tabela sa de rutare și înțelege că aceasta este destinată pe Internet — adică prin Full View sau Default. Dacă este necesar, efectuează o traducere NAT.
- Între VNGW și border poate fi o rețea IP obișnuită, ceea ce este puțin probabil.
Ar putea fi o rețea MPLS clasică (IGP+LDP/RSVP TE), sau ar putea fi o fabrică inversată cu BGP LU sau un tunel GRE de la VNGW la border prin rețeaua IP.
În orice caz, VNGW1 efectuează incapsulările necesare și trimite pachetul inițial în direcția border.
Traficul în direcția opusă parcurge aceleași etape în ordine inversă.
- Border-ul trimite pachetul către VNGW1
- Acesta îl analizează, se uită la adresa destinatarului și vede că acesta este accesibil prin tunelul Tunnel1 (MPLSoGRE sau MPLSoUDP).
- Prin urmare, atașează eticheta MPLS, antetul GRE/UDP și noul IP, și îl trimite către ToR3 10.0.255.1.
Adresa destinației tunelului — adresa IP a vRouter-ului, unde se află VM-ul țintă — 10.0.0.2. - Rețeaua de subordonare livrează pachetul la vRouter-ul necesar.
- vRouter-ul țintă desface GRE/UDP, determină interfața prin eticheta MPLS și trimite pachetul IP pur în interfața sa TAP, conectată la eth0 a VM-ului.
Control Plane
VNGW1 stabilește vecinătatea BGP cu SDN-controllerul, de la care primește întreaga informație de rutare despre clienți: sub ce adresă IP (vRouter) se află fiecare client și ce etichetă MPLS îl identifică.
Similar, informează SDN-controllerul despre ruta implicită cu eticheta acestui client, indicându-se ca nexthop. Apoi, acea rută implicită ajunge la vRoutere.
Pe VNGW se face, de obicei, agregarea rutelor sau traducerea NAT.
Și în cealaltă direcție, în sesiunea cu bordere sau Route Reflector-i, exactly acest traseu agregat este livrat. De la ei, primește ruta implicită sau Full-View, sau altceva.
În ceea ce privește încapsularea și schimbul de trafic, VNGW nu se deosebește de vRouter.
Dacă extindem puțin domeniul, la VNGW și vRoutere putem adăuga și alte dispozitive de rețea, cum ar fi firewall-uri, ferme de curățare sau îmbogățire a traficului, IPS, și așa mai departe.
Și prin crearea secvențială a VRF-urilor și anunțarea corectă a rutinelor, putem determina traficul să circule în modul dorit, ceea ce se numește Service Chaining.
Astfel, SDN-controllerul joacă rolul de Route-Reflector între VNGW, vRoutere și alte dispozitive de rețea.
Dar, de fapt, controllerul transmite și informații despre ACL și PBR (Policy Based Routing), forțând fluxuri separate de trafic să nu se deplaseze conform rutei dictate.
Întrebări frecvente
De ce tot timpul faci remarci despre GRE/UDP?
Ei bine, în general, aceasta este, să spunem, specifică pentru Tungsten Fabric — se poate ignora complet.
Dar, dacă vorbim, TF, fiind încă OpenContrail, suporta ambele încapsulări: MPLS in GRE și MPLS in UDP.
UDP este bun prin faptul că în Source Port-ul din antetul său este foarte ușor să codifici o funcție hash din IP+Proto+Port-urile originale, ceea ce va permite realizarea echilibrării.
În cazul GRE, din păcate, există doar anteturile externe IP și GRE, care sunt identice pentru tot traficul încapsulat și nu se discută despre echilibrare — puțini pot privi atât de adânc în interiorul pachetului.
Până nu demult, routerele, chiar dacă aveau capabilități pentru tuneluri dinamice, știau doar de MPLSoGRE și, abia recent, au învățat să utilizeze MPLSoUDP. De aceea, este necesar să menționăm întotdeauna posibilitatea a două tipuri diferite de encapsulare.
Ca să fim corecți, merită să menționăm că TF suportă și conectivitate L2 prin VXLAN.
Ai promis să faci paralele cu OpenFlow.
Aceste paralele sunt într-adevăr evidente. vSwitch în același OpenStack face lucruri destul de asemănătoare, folosind VXLAN, care, de altfel, are și el un antet UDP.
În Data Plane, ele funcționează aproximativ la fel, însă Control Plane-ul diferă considerabil. Tungsten Fabric folosește XMPP pentru a livra informațiile despre rute către vRouter, în timp ce OpenStack folosește Openflow.
Dar poți să ne spui mai multe despre vRouter?
Acesta se împarte în două părți: vRouter Agent și vRouter Forwarder.
Primul rulează în User Space al sistemului de operare gazdă și comunică cu controlerul SDN, schimbând informații despre rute, VRF și ACL.
Al doilea implementează Data Plane — de obicei în Kernel Space, dar poate fi rulat și pe SmartNIC-uri — plăci de rețea cu CPU și un cip de comutare programabil separat, ceea ce permite reducerea încărcării pe CPU-ul mașinii gazdă, făcând rețeaua mai rapidă și mai previzibilă.
De asemenea, este posibil un scenariu în care vRouter este o aplicație DPDK în User Space.
vRouter Agent transmite configurațiile către vRouter Forwarder.
Ce este rețeaua virtuală?
Am menționat la începutul articolului despre VRF, cum că fiecare chiriaș este legat de propriul VRF. Și dacă pentru o înțelegere superficială a funcționării rețelei overlay acest lucru a fost suficient, deja la următoarea iterație trebuie să facem clarificări.
De obicei, în mecanismele de virtualizare, entitatea Rețea Virtuală (poate fi considerată un nume propriu) este introdusă separat de clienți/ chiriași/ mașini virtuale — este o entitate complet independentă. Iar această Rețea Virtuală poate fi conectată prin intermediul interfețelor la un chiriaș, la altul, la doi... oriunde dorești. Astfel, se realizează, de exemplu, Service Chaining, când traficul trebuie să treacă prin anumite noduri într-o anumită ordine, pur și simplu creând și legând Rețele Virtuale în ordinea corectă.
Prin urmare, nu există o corespondență directă între Rețeaua Virtuală și chiriaș.
Concluzie
Aceasta este o descriere destul de superficială a funcționării unei rețele virtuale cu overlay de pe host și a controlerului SDN. Dar indiferent de platforma de virtualizare pe care o alegeți astăzi, aceasta va funcționa într-un mod similar, fie că este vorba de VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric sau Juniper Contrail. Vor exista diferențe în tipurile de încapsulări și capete, protocoalele de livrare a informației către dispozitivele de rețea finale, dar principiul rețelei overlay programabil configurabil, care funcționează pe o rețea underlay relativ simplă și statică, va rămâne același.
Se poate spune că domeniile de creare a unui cloud privat, în zilele noastre, SDN pe bază de rețea overlay a câștigat. Cu toate acestea, aceasta nu înseamnă că Openflow nu are loc în lumea modernă — este folosit în OpenStack și în același VMWare NSX, îl folosește, din câte știu, Google pentru configurarea rețelei underlay.
Mai jos am inclus linkuri către materiale mai detaliate, dacă doriți să explorați subiectul mai în profunzime.
Dar ce se întâmplă cu Underlay-ul nostru?
În general, nimic. El nu s-a schimbat deloc. Tot ce trebuie să facă în cazul overlay-ului de pe host este să actualizeze rutele și ARP-urile pe măsură ce apar și dispar vRouter/VNGW și să deplaseze pachetele între ele.
Hai să formulăm o listă de cerințe pentru rețeaua Underlay.
- Trebuie să suporte un protocol de rutare, în situația noastră — BGP.
- Să aibă lățime de bandă mare, preferabil fără rescriere, pentru a nu pierde pachete din cauza suprasarcinilor.
- Suport pentru ECMP — o parte esențială a fabricii.
- Să fie capabil să asigure QoS, inclusiv lucruri sofisticate, precum ECN.
- Suport pentru NETCONF — pregătire pentru viitor.
Am dedicat foarte puțin timp funcționării rețelei Underlay aici. Acest lucru se datorează faptului că în continuare în serie mă voi concentra tocmai pe ea, iar Overlay-ul îl vom aborda doar în trecere.
Este evident că mă restricționez foarte mult pe noi toți, folosind ca exemplu rețeaua DC construită pe fabrica Closa cu rutare IP pură și overlay de pe host.
Cu toate acestea, sunt încrezător că orice rețea cu un design poate fi descrisă în termeni formali și automatizată. Scopul meu aici este pur și simplu să înțeleg abordările de automatizare, nu să îi complic pe toți, rezolvând problema în mod general.
În cadrul ADMSM, eu și Roman Gorge plănuim să publicăm un număr separat despre virtualizarea resurselor computaționale și interacțiunea acesteia cu virtualizarea rețelei. Rămâneți alături.
Linkuri utile
- .
- . 6 ore despre Yandex.Cloud, care abordează în special rețeaua virtuală pe TF.
- .
- . Aici se discută despre întreaga rețea a centrului de date, inclusiv Underlay, Overlay, abordări pentru multi-homing și management.
Mulțumesc
- — fostul gazdă al podcastului linkmeup, acum expert în platforme de cloud. Mulțumiri pentru comentarii și corecturi. Așteptăm în curând articolul său mai detaliat despre virtualizare.
- — colegul meu și expert în dezvoltarea rețelelor virtuale. Mulțumiri pentru comentarii și corecturi.
- — colegul meu și expert în Tungsten Fabric. Mulțumiri pentru comentarii și corecturi.
- — ilustrator linkmeup. Mulțumiri pentru KDPV.
- Alexandru Limonov. Mulțumiri pentru meme-ul „automato”.
Sursa: habr.com
