

În timpul verii, tradițional, atât activitatea de cumpărare, cât și intensitatea schimbării infrastructurii proiectelor web scad, ne spune Căpitanul Evident. Pur și simplu pentru că chiar și IT-iștii, se întâmplă, merg în vacanță. Și CTO-ul de asemenea. Mai greu le este celor care rămân la post, dar acum nu despre asta este vorba: poate tocmai de aceea vara este cea mai bună perioadă pentru a réfléchii cu calm la schema existentă de rezervare și a elabora un plan pentru îmbunătățirea acesteia. Iar în acest sens, experiența lui Egor Andreev de la , despre care a vorbit la conferință .
Atunci când construim site-uri de rezervă, există câteva capcane în care putem cădea. Iar căderea în ele este complet inacceptabilă. Și ne distruge în tot acest proces, ca, de altfel, în multe alte situații, perfecționismul și… lenea. Încercăm să facem totul perfect, dar nu este necesar să facem totul perfect! Trebuie să facem doar anumite lucruri, dar să le facem corect, să le ducem până la capăt, astfel încât să funcționeze bine.
Failover — nu este un lucru amuzant de genul „să fie acolo”; este un lucru care trebuie să facă exact un singur lucru — să reducă timpul de nefuncționare, astfel încât serviciul, compania, să piardă mai puțini bani. Și în toate metodele de rezervare propun să gândim în următorul context: unde sunt banii?
Prima capcană: atunci când construim sisteme mari și fiabile și ne ocupăm de rezervare — reducem numărul de avarii. Aceasta este o înțelegere greșită teribilă. Când ne ocupăm de rezervare, numărul de avarii, probabil, crește. Și dacă facem totul bine, atunci în total vom reduce timpul de nefuncționare. Vor fi mai multe avarii, dar acestea se vor produce cu costuri mai mici. Ce este rezervarea? — este complicarea sistemului. Orice complicare este un lucru rău: ne apar mai multe șuruburi, mai multe roți dințate, pe scurt, mai multe elemente — și, prin urmare, șansa de defectare crește. Și ele se vor defecta cu adevărat. Și se vor defecta mai des. Un exemplu simplu: să spunem că avem un anumit site, cu PHP, MySQL. Și trebuie să fie rezervat urgent.
Ei bine (c) Luăm a doua platformă, construim un sistem identic... Complexitatea devine de două ori mai mare - avem două entități. Și deasupra aplicăm o anumită logică de transfer de date de pe o platformă pe alta - adică replicarea datelor, copierea staticei și așa mai departe. Așadar, logica replicării - de obicei, este foarte complicată, și, prin urmare, complexitatea cumulată a sistemului poate fi nu de 2, ci de 3, 5, 10 ori mai mare.
A doua capcană: când construim sisteme cu adevărat mari și complexe, ne imaginăm ce vrem să obținem la final. Voilà: vrem să obținem un sistem superfiabil, care funcționează complet fără întreruperi, se comută în jumătate de secundă (sau, mai bine, instantaneu), și începem să transformăm visele în realitate. Dar aici există și un detaliu: cu cât timpul de comutare dorit este mai mic, cu atât logica sistemului devine mai complicată. Cu cât trebuie să facem această logică mai complexă, cu atât mai des se va strica sistemul. Și putem ajunge într-o situație foarte neplăcută: ne străduim din toate puterile să reducem timpul de nefuncționare, iar în realitate complicăm totul, iar când ceva nu merge bine, timpul de nefuncționare va fi, în cele din urmă, mai mare. Adesea, îți dai seama: mai bine nu am fi rezervat. Mai bine să funcționeze unul singur și cu un timp de nefuncționare clar.
Cum ne putem lupta cu asta? Trebuie să încetăm să ne mințim, să încetăm să ne flattăm, că acum vom construi o navă spațială, dar să înțelegem rațional cât de mult va putea rămâne proiectul. Și pentru acest timp maxim vom alege ce metode vom folosi pentru a spori fiabilitatea sistemului nostru.
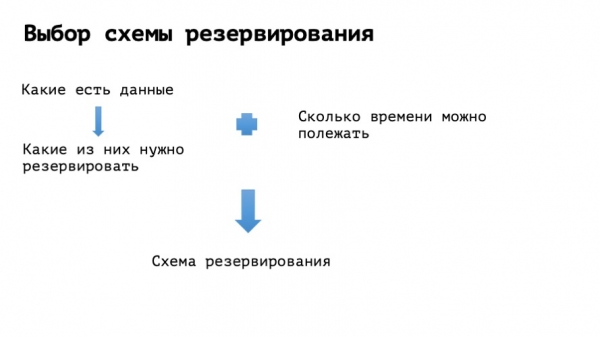
Este momentul pentru „povești din viață”... bineînțeles, din viață.
Exemplul numărul unu
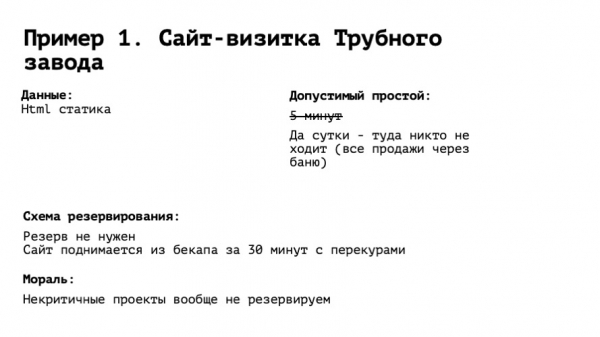
Imaginați-vă un site de prezentare pentru fabrica de țevi numărul 1 din orașul N. Pe el este scris cu litere mari — FABRICA DE ȚEVI NR. 1. Puțin mai jos — sloganul: „Țevile noastre sunt cele mai rotunde din N”. Iar mai jos este numărul de telefon al directorului general și numele său. Înțelegem că trebuie să rezervăm — este o chestiune foarte importantă! Începem să analizăm din ce este compus. Html-static — adică o pereche de poze, unde directorul, de fapt, stă la masă în saună cu partenerul său discutând despre o afacere recentă. Începem să ne gândim la timpul de nefuncționare. Îmi vine în minte: trebuie să rămână acolo cinci minute, nu mai mult. Și acum întrebarea: câte vânzări au fost de pe acest site? Câte? Ce înseamnă „zero”? Adică: pentru că toate cele patru tranzacții de anul trecut le-a realizat la aceeași masă, cu aceiași oameni, cu care merg la saună și stau la masă. Și înțelegem că, chiar dacă site-ul stă o zi, nu va fi nimic grav.
Având în vedere informațiile, avem o zi întregă pentru a ridica această poveste. Începem să ne gândim la schema de rezervare. Și alegem cea mai ideală schemă de rezervare pentru acest exemplu: nu folosin rezervarea. Toată această activitate poate fi inițiată de oricine administrator în treizeci de minute, cu pauze. Să instalezi un server web, să așezi fișierele — gata. Totul va funcționa. Nu trebuie să monitorizăm nimic, nu trebuie să acordăm o atenție deosebită. Așadar, concluzia din exemplul numărul unu este destul de evidentă: serviciile care nu necesită rezervare — nu trebuie rezervate.
Exemplul numărul doi
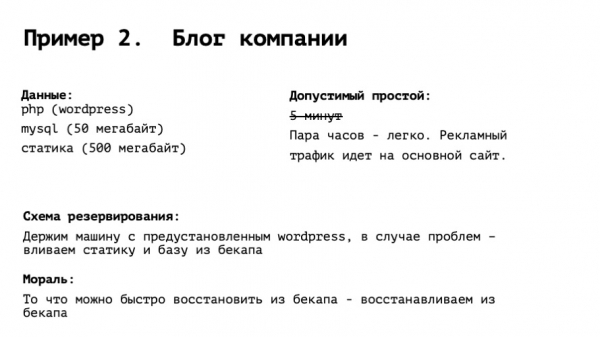
Blogul companiei: cei special instruiți publică aici știri, am participat la o expoziție, iar acum am lansat un nou produs și așa mai departe. Să presupunem că acesta este un PHP standard cu WordPress, o bază de date mică și puțin conținut static. În mod evident, ne vine în minte că nu trebuie să stăm inactiv — „nu mai mult de cinci minute!”, asta e tot. Dar să ne gândim mai departe. Ce face acest blog? Atrag vizitatori din Yandex și Google prin diverse căutări, organic. Grozav. Dar cum îi afectează în vreun fel vânzările? Revelație: nu prea. Traficul publicitar duce pe site-ul principal, care se află pe un alt server. Începem să ne gândim la un plan de rezervare pentru blog. Ideal ar fi să-l facem activ în câteva ore, așa că ar fi bine să ne pregătim. O idee înțeleaptă ar fi să luăm un server din alt centru de date, să instalăm pe el un mediu, adică un web server, PHP, WordPress, MySQL, și să-l lăsăm în stare de repaus. Când ne dăm seama că totul s-a stricat, trebuie să facem două lucruri — să restaurăm un dump MySQL de 50 de megabyte, care va rula în doar un minut, și să restaurăm un anumit număr de imagini din backup. Nici asta nu va dura foarte mult. Astfel, în treizeci de minute, întreaga configurație revine online. Fără replicări sau, Doamne ferește, failover automat. Concluzia: ceea ce putem restaura rapid din backup — nu trebuie rezervat.
Exemplul numărul trei, mai complicat
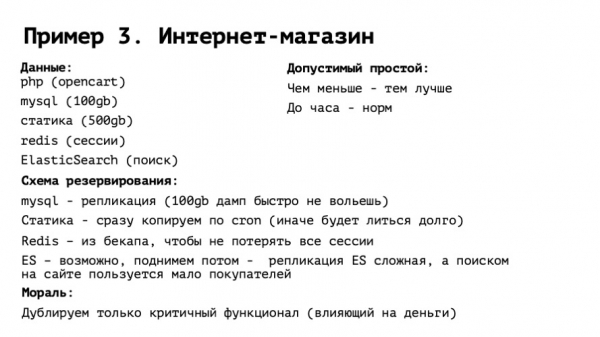
Magazin online. PHP cu open heart puțin modificat, MySQL cu o bază de date solidă. Destul de mult conținut static (deoarece într-un magazin online sunt imagini HD frumoase și tot felul de alte lucruri), Redis pentru sesiuni și Elasticsearch pentru căutare. Începem să ne gândim la timpul de nefuncționare. Aici, desigur, e clar că un magazin online nu poate să fie offline o zi fără consecințe. Cu cât stă mai mult offline, cu atât pierdem mai mult. Trebuie să ne grăbim. Și cât de mult? Cred că dacă stăm o oră offline, nimeni nu va înnebuni. Da, vom pierde ceva, dar dacă ne aglomerăm, va fi doar mai rău. Stabilim un plan pentru timpul de nefuncționare tolerabil într-o oră.
Cum putem rezerva totul? O maşină este absolut necesară: o oră de timp este destul de puţin. Mysql: aici deja avem nevoie de replicare, replicare live, deoarece într-o oră 100 GB în dump, cel mai probabil, nu se va încărca. Statica, pozele: din nou, într-o oră 500 GB poate să nu reuşească să fie preluată. Aşadar, ar fi mai bine să copiem imediat imaginile. Redis: aici devine mai interesant. În Redis se află sesiunile — nu putem pur și simplu să-l ignorăm. Pentru că nu ar fi foarte bine: toţi utilizatorii s-ar deconecta, coşurile ar fi goale şi aşa mai departe. Oamenii ar fi nevoiţi să introducă din nou login-ul şi parola, iar mulţi ar putea părăsi procesul fără a finaliza achiziţia. Din nou, conversia ar scădea. Pe de altă parte, Redis este exact la zi, cu ultimii utilizatori conectaţi, probabil că nu este necesar. Şi un bun compromis ar fi să luăm Redis şi să-l restaurăm din backup, cel de ieri, sau, dacă îl aveţi creat în fiecare oră, din backup-ul de acum o oră. Din fericire, restaurarea lui din backup este doar copierea unui fişier. Iar cea mai interesantă poveste este Elasticsearch. Cine a ridicat vreodată replicarea MySQL? Cine a ridicat vreodată replicarea Elasticsearch? Şi la cine a funcţionat bine după aceea? La ce mă refer: vedem în sistemul nostru o anumită entitate. Ea pare a fi utilă — dar este complexă.
Complicat în sensul că colegii noștri ingineri nu au experiență în utilizarea acestuia. Fie că au avut o experiență negativă, fie că ne dăm seama că tehnologia este încă destul de nouă, cu nuanțe sau imperfectă. Ne gândim... Uf, elastic este de asemenea masiv, restaurarea lui din backup durează mult, ce facem? Realizăm că elastic este folosit în acest caz pentru căutare. Dar cum vinde magazinul nostru online? Ne îndreptăm către marketeri, întrebăm de unde vin oamenii. Răspunsul este: „90% din Yandex.Market vin direct pe pagina produsului”. Și fie cumpără, fie nu. Așadar, căutarea este necesară doar pentru 10% dintre utilizatori. Și a menține replicarea elastic-ului, mai ales între diferite centre de date în zone diferite, are cu adevărat multe nuanțe. Care este soluția? Luăm elastic pe o platformă rezervată și nu facem nimic cu el. Dacă lucrurile se vor întinde în timp, îl vom activa cândva în viitor, dar nu este sigur. De fapt, concluzia este aproximativ aceeași: serviciile care nu influențează veniturile nu le rezervăm. Pentru ca schema să rămână mai simplă.
Exemplul numărul patru, chiar mai complicat
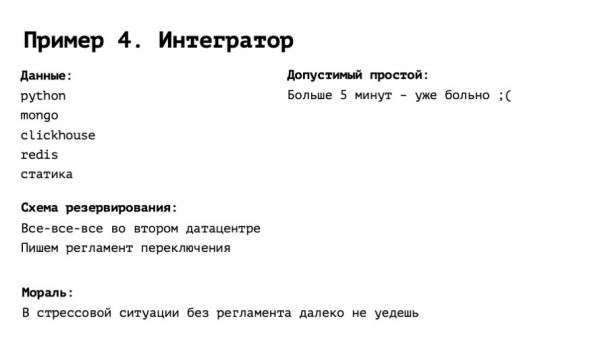
Integrator: vânzări de flori, chemarea de taxiuri, vânzarea de bunuri, în general, orice. O afacere serioasă care funcționează 24/7 pentru un număr mare de utilizatori. Cu un stivă interesantă, unde există baze interesante, soluții, o sarcină mare și, cel mai important, dacă rămâne nefuncțională mai mult de 5 minute, este o problemă. Nu doar din cauza că oamenii nu vor cumpăra, ci pentru că vor observa că acest lucru nu funcționează, se vor dezamăgi și s-ar putea să nu mai revină deloc.
Bine. Cinci minute. Ce facem cu asta? În acest caz, ne comportăm ca niște adulți, investim bani pentru a construi o platformă de rezervă adevărată, cu replicarea tuturor și a tuturor, și poate chiar automatizăm la maxim comutarea pe această platformă. Și, pe lângă aceasta, nu trebuie să uităm să facem un lucru important: să redactăm un regulament de comutare. Regulamentul, chiar dacă aveți totul automatizat, poate fi foarte simplu. De tipul „lansați acest scenariu ansible”, „bifați această opțiune în Route 53” și așa mai departe - dar trebuie să existe o listă exactă de acțiuni.
Și totul pare clar. Comutarea replicării este o sarcină trivială, fie se va comuta singură. Rescrierea numelui de domeniu în DNS face parte din aceeași categorie. Problema este că, atunci când un astfel de proiect eșuează, panică începe să domnească, și chiar cei mai experimentați administratori pot fi afectați. Fără o instrucțiune clară „deschide terminalul, intră aici, adresa serverului nostru este în continuare aceasta”, este greu de respectat termenul de 5 minute alocat pentru recuperare. Mai mult, atunci când folosim acest regulament, este ușor să înregistrăm anumite modificări în infrastructură, de exemplu, și să ajustăm regulamentul corespunzător.
Dar, dacă sistemul de rezervare este foarte complex și, la un moment dat, am făcut o greșeală, putem afecta și platforma noastră de rezervă, iar datele se pot transforma într-o dovleacă pe ambele platforme — aceasta ar fi o situație cu adevărat tristă.
Exemplul numărul cinci, hardcore complet.
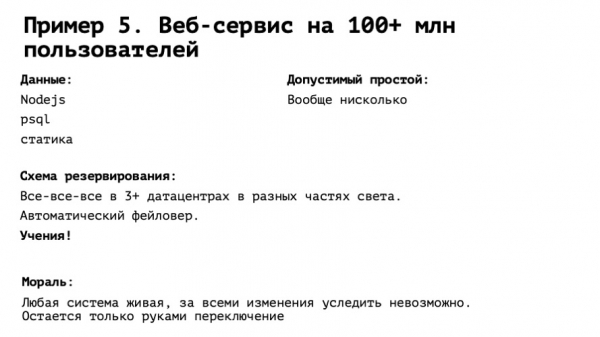
Un serviciu internațional cu sute de milioane de utilizatori din întreaga lume. Toate fusurile orare, de care există, highload la maximum, nu se poate permite să fie indisponibil. O minută — și va fi trist. Ce să facem? Să rezervăm, din nou, la maximum. Am realizat tot ce am spus în exemplul anterior și chiar mai mult. O lume ideală, iar infrastructura noastră — este conform tuturor conceptelor de DevOps IaaC. Adică totul este în git, iar tu doar apesi butonul.
Ce lipsește? Un lucru — exercițiile. Fără ele, nu se poate. Pare că totul este perfect, totul este sub control. Apasă butonul și totul se întâmplă. Chiar dacă ar fi așa — și știm că așa nu se întâmplă — sistemul nostru interacționează cu anumite alte sisteme. De exemplu, este DNS-ul de la Route 53, S3 storage, integrarea cu anumite API-uri. Nu putem prevedea totul în acest experiment teoretic. Și până nu tragem efectiv întrerupătorul — nu vom ști dacă va funcționa sau nu.
Cam atât. Nu fiți leneși și nu exagerați. Și să fie cu voi uptime-ul!
Sursa: habr.com
