

Bună, Habr! În acest articol vreau să vă vorbesc despre un instrument minunat pentru dezvoltarea proceselor batch de prelucrare a datelor, de exemplu, în infrastructura DWH corporate sau în DataLake-ul dumneavoastră. Este vorba despre Apache Airflow (în continuare Airflow). Este, în mod nedrept, ignorat pe Habr și, în partea principală, voi încerca să vă conving că merită să luați în considerare Airflow atunci când alegeți un planificator pentru procesele dumneavoastră ETL/ELT.
Anterior, am scris o serie de articole pe tema DWH, când lucram la Tinkoff Bank. Acum fac parte din echipa Mail.Ru Group și mă ocup de dezvoltarea platformei pentru analiza datelor în direcția jocurilor. Prin urmare, pe măsură ce apar știri și soluții interesante, echipa mea va povesti aici despre platforma noastră de analiză a datelor.
Prolog
Deci, să începem. Ce este Airflow? Este o bibliotecă (sau ) pentru dezvoltarea, planificarea și monitorizarea fluxurilor de lucru. Principalul avantaj al Airflow este că pentru descrierea (dezvoltarea) proceselor se folosește cod în limbajul Python. De aici decurg numeroase avantaje pentru organizarea proiectului și dezvoltare: practic, proiectul dumneavoastră ETL (de exemplu) este doar un proiect Python și îl puteți organiza cum doriți, având în vedere caracteristicile infrastructurii, dimensiunea echipei și alte cerințe. Instrumente sunt simple. Folosiți, de exemplu, PyCharm + Git. Este minunat și foarte convenabil!
Acum să luăm în considerare principalele entități Airflow. Înțelegând esența și scopul lor, veți organiza optim arhitectura proceselor. Cea mai importantă entitate este Directed Acyclic Graph (în continuare DAG).
DAG
DAG este o anumită unire semnificativă a sarcinilor pe care doriți să le executați într-o anumită ordine, conform unei cronologii stabilite. Airflow oferă o interfață web convenabilă pentru lucrul cu DAG-uri și alte entități:
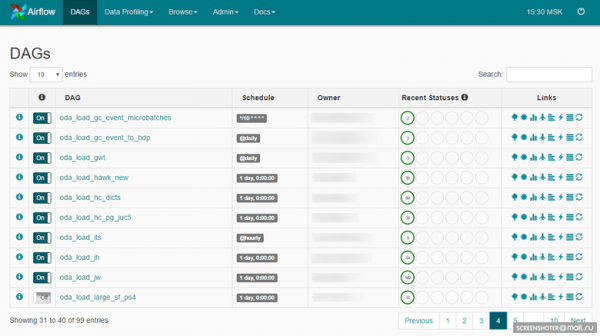
Un DAG poate arăta astfel:
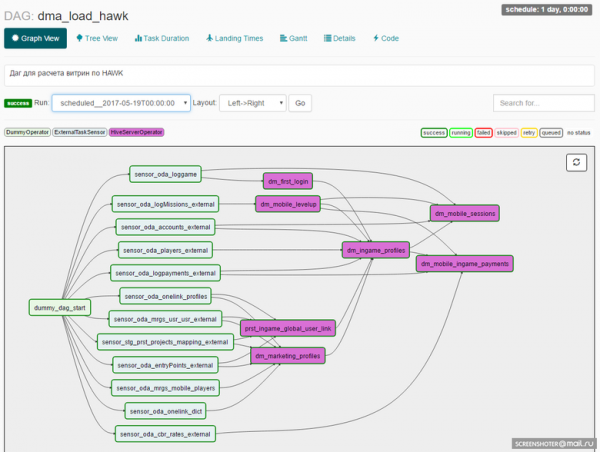
Când dezvoltatorul proiectează un DAG, acesta definește un set de operatori pe care vor fi construite sarcinile din interiorul DAG-ului. Aici ajungem la o altă entitate importantă: Airflow Operator.
Operatori
Un operator este o entitate pe baza căreia se creează instanțe de sarcini, care descriu ce va avea loc în timpul execuției instanței sarcinii. deja conțin un set de operativi gata de utilizare. Exemple:
- BashOperator — operatorul pentru executarea comenzilor bash.
- PythonOperator — operatorul pentru apelarea codului Python.
- EmailOperator — operatorul pentru trimiterea e-mail-urilor.
- HTTPOperator — operatorul pentru lucrul cu cererile http.
- SqlOperator — operatorul pentru executarea codului SQL.
- Sensor — operatorul care așteaptă un eveniment (de exemplu, sosirea unui moment dorit, apariția unui fișier necesar, o linie în baza de date, un răspuns din API etc.).
Există operatori mai specifici: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
De asemenea, puteți dezvolta operatori, axați pe particularitățile dumneavoastră, și îi puteți folosi în proiect. De exemplu, am creat MongoDBToHiveViaHdfsTransfer, un operator pentru exportarea documentelor din MongoDB în Hive, și câțiva operatori pentru lucrul cu : CHLoadFromHiveOperator și CHTableLoaderOperator. Practic, de îndată ce un proiect folosește un cod frecvent utilizat, bazat pe operatorii de bază, puteți lua în considerare agregarea acestuia într-un nou operator. Acest lucru va simplifica dezvoltarea ulterioară și veți îmbogăți biblioteca de operatori din proiect. Apoi, toate aceste instanțe de sarcini trebuie să fie executate, iar acum urmează să discutăm despre planificator.
Planificator
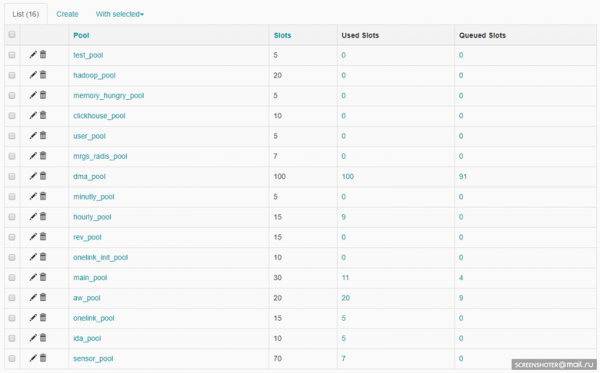
Planificatorul de sarcini din Airflow este construit pe
Celery. Fiecare pool are o limitare a numărului de sloturi. Atunci când creați un DAG, acesta primește un pool:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh") DAG_NAME = 'dma_load' OWNER = 'Vasya Pupkin' DEPENDS_ON_PAST = True EMAIL_ON_FAILURE = True EMAIL_ON_RETRY = True RETRIES = int(Variable.get('gv_dag_retries')) POOL = 'dma_pool' PRIORITY_WEIGHT = 10start_dt = datetime.today() - timedelta(1) start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)default_args = { 'owner': OWNER, 'depends_on_past': DEPENDS_ON_PAST, 'start_date': start_dt, 'email': ALERT_MAILS, 'email_on_failure': EMAIL_ON_FAILURE, 'email_on_retry': EMAIL_ON_RETRY, 'retries': RETRIES, 'pool': POOL, 'priority_weight': PRIORITY_WEIGHT } dag = DAG(DAG_NAME, default_args=default_args) dag.doc_md = __doc__
Pool-ul definit la nivelul DAG-ului poate fi suprascris la nivelul sarcinii.Planificarea tuturor sarcinilor în Airflow este responsabilitatea unui proces separat — Scheduler. Practic, Scheduler se ocupă de întreaga mecanică a programării sarcinilor pentru execuție. O sarcină, înainte de a fi executată, trece prin mai multe etape:
За планировку всех задач в Airflow отвечает отдельный процесс — Scheduler. Собственно, Scheduler занимается всей механикой постановки задачек на исполнение. Задача, прежде чем попасть на исполнение, проходит несколько этапов:
- În DAG, sarcinile anterioare sunt finalizate, iar una nouă poate fi pusă în așteptare.
- Coadă este sortată în funcție de prioritatea sarcinilor (prioritățile pot fi gestionate și acestea), iar dacă există un slot liber în pool, sarcina poate fi preluată pentru lucru.
- Dacă există un worker celery liber, sarcina este direcționată către acesta; începe lucrul pe care l-ați programat în sarcină, folosind un anumit operator.
Este suficient de simplu.
Scheduler-ul funcționează pe toate DAG-urile și toate sarcinile din cadrul DAG-urilor.
Pentru ca Scheduler-ul să înceapă să lucreze cu DAG-ul, DAG-ului trebuie să-i fie stabilit un program:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Există un set de preset-uri gata făcute: @once, @hourly, @daily, @weekly, @monthly, @yearly.
De asemenea, se pot utiliza expresii cron:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Data execuției
Pentru a înțelege cum funcționează Airflow, este important să înțelegem ce este Data execuției pentru un DAG. În Airflow, un DAG are o dimensiune a Datei execuției, adică, în funcție de programul de lucru al DAG-ului, se creează instanțe de sarcini pentru fiecare Dată de execuție. Și pentru fiecare Dată de execuție sarcinile pot fi executate din nou — sau, de exemplu, DAG-ul poate funcționa simultan în mai multe Date de execuție. Acest lucru este reprezentat vizibil aici:
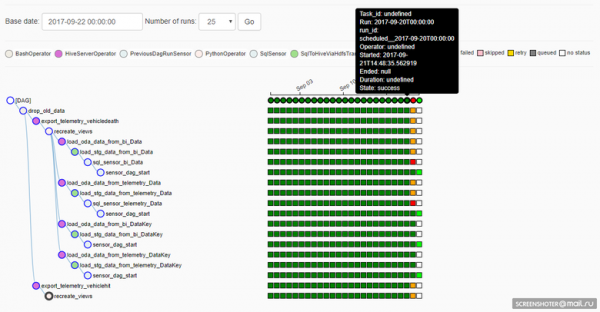
Din păcate (sau poate că nu, depinde de situație), dacă se modifică implementarea sarcinii în DAG, atunci execuția în Datele anterioare de execuție va avea în vedere deja corecturile. Acest lucru este bine, dacă trebuie să recalculați datele în perioadele anterioare cu un nou algoritm, dar este rău deoarece pierdem reproducibilitatea rezultatului (bineînțeles, nimic nu împiedică să reveniți la versiunea dorită a sursei din Git și să recalculați o dată ceea ce este necesar, așa cum trebuie).
Generarea sarcinilor
Implementarea DAG-ului este cod pe Python, așa că avem un mod foarte confortabil de a reduce volumul de cod atunci când lucrăm, de exemplu, cu surse shard-uite. Să presupunem că aveți trei shard-uri MySQL ca sursă, trebuie să accesați fiecare și să obțineți anumite date. Și asta trebuie să fie făcut independent și paralel. Codul pe Python în DAG poate arăta așa:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG arată astfel:
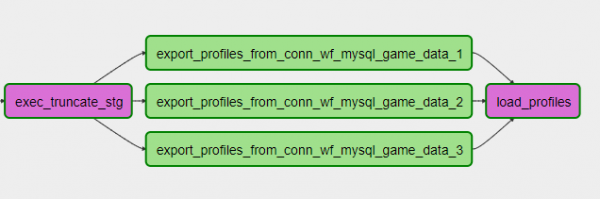
Între timp, poți adăuga sau elimina un shard, ajustând doar setările și actualizând DAG-ul. Foarte convenabil!
Poți folosi și o generare de cod mai complexă, de exemplu, lucrând cu surse sub formă de Bază de Date sau descriind structura tabelară, algoritmul de operare cu tabelul și, ținând cont de particularitățile infrastructurii DWH, generând procesul de încărcare a N tabelelor în stocarea ta. Sau, de exemplu, lucrând cu API-ul care nu acceptă lucrul cu un parametru sub formă de listă, poți genera o listă de N sarcini în DAG, limitând concurența cererilor API la un pool și extrăgând datele necesare din API. Flexibil!
Repository-ul
În Airflow există un repository backend, o Bază de Date (poate fi MySQL sau Postgres, noi folosim Postgres), în care sunt stocate stările sarcinilor, DAG-urilor, setările de conectare, variabile globale etc. Aici ar trebui să menționăm că repository-ul în Airflow este foarte simplu (aproximativ 20 de tabele) și convenabil dacă dorești să construiești un anumit proces pe el. Îmi aduc aminte de 100500 de tabele în repository-ul Informatica, pe care a fost nevoie să le studiez mult înainte de a înțelege cum să construiesc o interogare.
Monitorizare
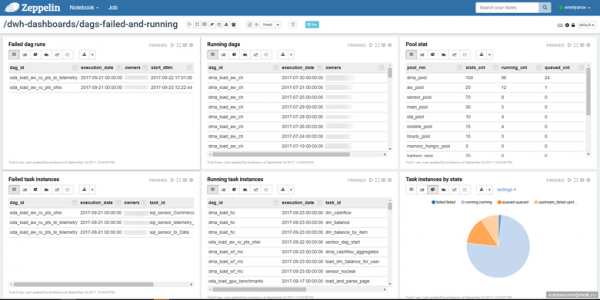
Având în vedere simplitatea repository-ului, poți construi singur un proces convenabil de monitorizare a sarcinilor. Noi folosim un notebook în Zeppelin, unde verificăm starea sarcinilor:
Aceasta poate fi și interfața web a Airflow-ului:
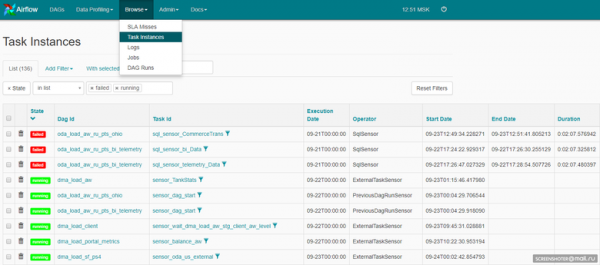
Codul Airflow este deschis, așa că am adăugat un sistem de alertare în Telegram. Fiecare instanță de sarcină care rulează, dacă apare o eroare, trimite mesaje în grupul din Telegram, unde se află întreaga echipă de dezvoltare și suport.
Obținem prin Telegram reacții rapide (dacă este necesar), iar prin Zeppelin — o imagine de ansamblu asupra sarcinilor în Airflow.
În concluzie
Airflow este în primul rând open source, iar nu trebuie să aștepți miracole de la el. Fii pregătit să investești timp și efort pentru a construi o soluție funcțională. Obiectivul este realizabil, crede-mă, merită. Viteza de dezvoltare, flexibilitatea, ușurința de adăugare a noilor procese — îți va plăcea. Desigur, trebuie acordată multă atenție organizării proiectului, stabilității funcționării Airflow-ului: miracolele nu există.
Acum, în Airflow, se execută zilnic aproximativ 6500 de sarcini. Sunt destul de diferite ca natura. Există sarcini de încărcare a datelor în DWH principal din multe surse diferite și foarte specifice, există sarcini de calcul a vitrinelor în cadrul DWH principal, există sarcini de publicare a datelor în DWH rapid, există multe, multe sarcini diferite - și Airflow le gestionează toate zi de zi. Dacă vorbim în cifre, atunci asta 2,3 mii sarcini ELT de complexitate variată în cadrul DWH (Hadoop), aproximativ 2,5 sute de baze de date surse, este o echipă de 4 dezvoltatori ETL, care se specializează în procesarea ETL a datelor în DWH și în procesarea ELT a datelor în cadrul DWH și, desigur, încă un administrator, care se ocupă de infrastructura serviciului.
Planuri de viitor
Numărul de procese crește inevitabil, iar principalul lucru la care ne vom concentra în ceea ce privește infrastructura Airflow este scalarea. Vrem să construim un cluster Airflow, să alocăm câteva resurse pentru workerii Celery și să facem o componentă redundantă cu procese de programare a sarcinilor și un depozit.
Epilog
Acestea, desigur, nu sunt toate aspectele despre Airflow pe care aș dori să le discut, dar am încercat să acopăr principalele puncte. Pofta vine mâncând, încercați - și vă va plăcea 🙂
Sursa: habr.com
