

Atunci când se vorbește despre monitorizarea securității rețelei interne a unei corporații sau instituții, mulți fac asocierea cu controlul scurgerilor de informații și implementarea soluțiilor DLP. Însă, dacă încercăm să clarificăm întrebarea și să întrebăm cum identificați atacurile din rețeaua internă, răspunsul va fi, de obicei, menționarea sistemelor de detectare a intruziunilor (intrusion detection systems, IDS). Ceea ce era singura variantă acum 10-20 de ani, astăzi devine un anacronism. Există o variantă mai eficientă, și în multe cazuri, singura posibilitate de monitorizare a rețelei interne - utilizarea protocoalelor flow, care inițial au fost concepute pentru identificarea problemelor de rețea (troubleshooting), dar care s-au transformat în timp într-un instrument de securitate foarte interesant. În această articol, vom discuta despre ce tipuri de protocoale flow există, care sunt cele mai eficiente în detectarea atacurilor de rețea, unde este mai bine să implementăm monitorizarea flow, la ce să fim atenți în timpul desfășurării unei astfel de scheme și cum să realizăm tot acest proces pe echipamente locale.
Nu voi insista asupra întrebării „De ce este necesară monitorizarea securității infrastructurii interne?” Răspunsul pare a fi evident. Dar, dacă doriți să vă asigurați din nou că astăzi nu se poate face fără aceasta, un scurt videoclip care ilustrează cele 17 metode prin care se poate accesa o rețea corporativă protejată de un firewall. Așadar, să presupunem că înțelegem că monitorizarea internă este necesară și rămâne doar să aflăm cum poate fi organizată.
Aș sublinia trei surse cheie de date pentru monitorizarea infrastructurii la nivel de rețea:
- traficul „brut”, pe care îl capturăm și îl analizăm cu ajutorul anumitor sisteme de analiză,
- evenimentele provenite de la dispozitivele de rețea prin care trece traficul,
- informațiile despre trafic obținute prin unul dintre protocoalele flow.
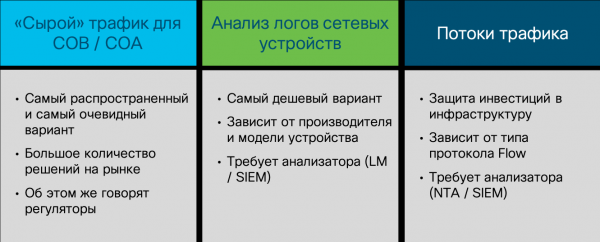
Captarea traficului brut este cea mai populară opțiune pentru specialiștii în securitate, deoarece a apărut istoric ca fiind prima. Sistemele de detecție a atacurilor în rețea (primul sistem comercial de detecție a atacurilor a fost NetRanger de la compania Wheel Group, achiziționat în 1998 de Cisco) s-au ocupat în mod special cu captarea pachetelor (iar mai târziu a sesiunilor), în care căutau anumite semnături („reguli hotărâtoare” în terminologia FSTEC), semnalizând atacurile. Desigur, analiza traficului brut nu se poate face doar prin intermediul IDS, ci și cu alte instrumente (de exemplu, Wireshark, tcpdump sau funcționalitatea NBAR2 în Cisco IOS), dar de obicei le lipsește baza de cunoștințe care distinge un instrument de securitate cibernetică de un instrument IT obișnuit.
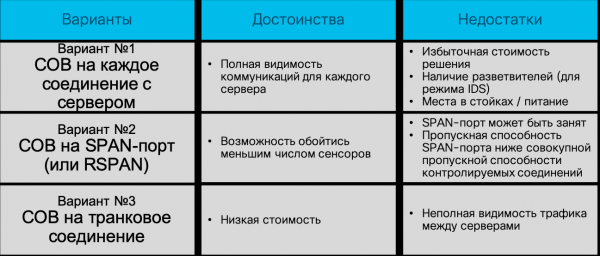
Așadar, sistemele de detecție a atacurilor. Cea mai veche și cea mai populară metodă de detectare a atacurilor în rețea, care își îndeplinește bine sarcina la perimetru (fie el corporativ, de centru de date, segment etc.), dar eșuează în rețelele moderne comutate și definite prin software. În cazul unei rețele construite pe baza comutatoarelor obișnuite, infrastructura senzorilor de detecție a atacurilor devine prea mare — va trebui să instalați un senzor pentru fiecare conexiune cu nodul pe care doriți să-l monitorizați pentru atacuri. Orice producător, desigur, va fi bucuros să vă vândă sute și mii de senzori, dar cred că bugetul dumneavoastră nu va susține astfel de cheltuieli. Pot spune că chiar și la Cisco (unde suntem dezvoltatorii NGIPS) nu am reușit să facem asta, deși, aparent, problema prețului nu ar trebui să existe — este soluția noastră proprie. În plus, se ridică întrebarea, cum să conectați senzorul în această variantă? În întrerupere? Și dacă senzorul însuși va fi defect? Ar trebui să cerem un modul bypass în senzor? Să folosim divizoare (tap)? Toate acestea cresc costul soluției și o fac inaccesibilă pentru companiile de orice dimensiune.
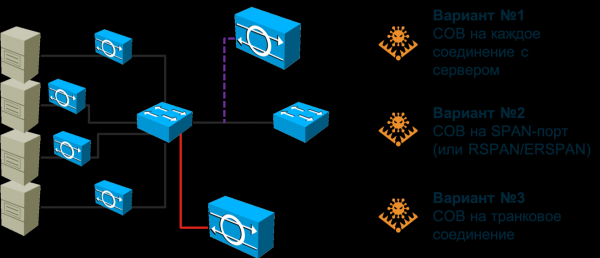
Puteți încerca să „atașați” un senzor la portul SPAN/RSPAN/ERSPAN și să direcționați traficul necesar de la porturile comutatorului. Această opțiune reduce parțial problema descrisă în paragraful anterior, dar ridică alta — portul SPAN nu poate accepta absolut tot traficul care îi este direcționat — nu va avea suficientă capacitate. Va trebui să faceți anumite compromisuri. Fie lăsați o parte din noduri fără monitorizare (atunci va trebui să le prioritizați în prealabil), fie să direcționați nu tot traficul de la nod, ci doar un anumit tip. În orice caz, putem rata anumite atacuri. În plus, portul SPAN poate fi ocupat pentru alte necesități. Ca urmare, va trebui să revizuim topologia existentă a rețelei și, posibil, să facem modificări pentru a acoperi cât mai mult din rețeaua dumneavoastră cu numărul de senzori pe care îl aveți (și să ne coordonăm asta cu IT-ul).
Și dacă rețeaua dumneavoastră folosește rute asimetrice? Și dacă ați implementat sau plănuiți să implementați SDN? Și dacă trebuie să monitorizați mașini virtualizate sau containere, al căror trafic nu ajunge deloc la comutatorul fizic? Aceste întrebări nu sunt foarte binevenite pentru producătorii de IDS tradiționali, deoarece nu știu cum să răspundă. Este posibil să vă încurajeze că toate aceste tehnologii trendy sunt doar un hype și că nu aveți nevoie de ele. Este posibil să spună că trebuie să începeți cu pași mici. Sau poate că vă vor spune să instalați un echipament puternic în centrul rețelei și să direcționați tot traficul către el prin intermediul echilibrarelor de sarcină. Indiferent de opțiunea pe care vi-o propun, trebuie să înțelegeți clar cât de bine vi se potrivește. Și abia după aceea să luați o decizie cu privire la abordarea monitorizării securității infrastructurii rețelei. Revenind la captura pachetelor, vreau să spun că această metodă rămâne foarte populară și importantă, dar scopul ei principal este controlul frontierelor; frontierelor dintre organizația dumneavoastră și Internet, frontierelor dintre centrul de date și restul rețelei, frontierelor dintre sistemele de automatizare și segmentul corporativ. În aceste locuri, IDS/IPS-urile tradiționale continuă să aibă dreptul la existență și se descurcă bine în sarcinile desemnate.
Să trecem la a doua opțiune. Analiza evenimentelor provenite de la dispozitivele de rețea poate fi folosită și pentru scopuri de detectare a atacurilor, dar nu ca mecanism principal, deoarece permite detectarea doar a unei clase restrânse de intruziuni. În plus, prezintă o anumită reacție — atacul trebuie să aibă loc mai întâi, apoi trebuie să fie înregistrat de dispozitivul de rețea, care într-un fel sau altul va semnaliza problema de securitate. Există mai multe modalități de a face acest lucru. Acest lucru poate fi realizat prin syslog, RMON sau SNMP. Ultimele două protocoale pentru monitorizarea rețelei în contextul securității sunt utilizate doar dacă trebuie să detectăm un atac DoS asupra echipamentului de rețea, deoarece prin RMON și SNMP putem, de exemplu, monitoriza utilizarea procesorului central al dispozitivului sau a interfețelor sale. Aceasta este una dintre cele mai „ieftine” metode (syslog sau SNMP sunt disponibile pentru toată lumea), dar și cea mai ineficientă dintre toate metodele de monitorizare a securității infrastructurii interne — multe atacuri rămân pur și simplu ascunse. Desigur, nu trebuie ignorate și analiza syslog ajută la identificarea în timp util a modificărilor în configurația dispozitivului, compromiterea acestuia, dar detectarea atacurilor asupra întregii rețele nu este foarte potrivită.
A treia opțiune este analiza informațiilor despre traficul care trece printr-un dispozitiv care suportă unul dintre cele mai multe protocoale de tip flow. În acest caz, indiferent de protocol, infrastructura de lucru cu fluxuri constă în mod obligatoriu din trei componente:
- Generarea sau exportul de flow. Această sarcină este de obicei atribuită unui router, switch sau alt dispozitiv de rețea care, permitând trecerea traficului de rețea, extrage din acesta parametrii cheie care sunt apoi transmiși modulului de colectare. De exemplu, la Cisco, protocolul Netflow este suportat nu doar pe routere și switch-uri, incluzând și cele virtuale și industriale, ci și pe controlere wireless, firewall-uri și chiar servere.
- Colectarea flow-ului. Având în vedere că într-o rețea modernă există de obicei mai mult de un dispozitiv de rețea, apare provocarea colectării și consolidării fluxurilor, care este rezolvată prin intermediul așa-numitelor colectoare, care procesează fluxurile primite și apoi le transmit pentru analiză.
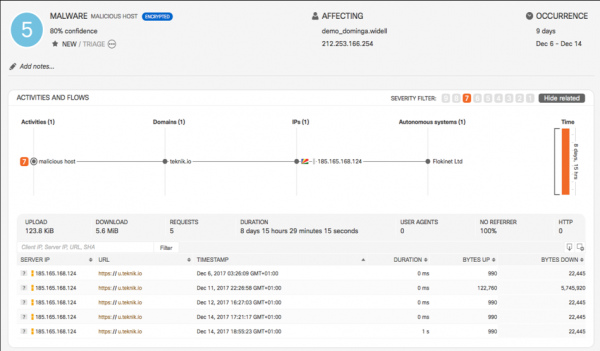
- Analiza fluxului. Analizatorul își asumă sarcina intelectuală principală și, aplicând diverse algoritmi asupra fluxurilor, face anumite concluzii. De exemplu, în cadrul funcției IT, un astfel de analizator poate identifica punctele slabe ale rețelei sau analiza profilul de încărcare a traficului pentru o optimizare ulterioară a rețelei. Iar pentru securitatea informațională, un astfel de analizator poate detecta scurgerile de date, răspândirea codului malițios sau atacurile DoS.
Nu trebuie să credem că o astfel de arhitectură tristrat din trei niveluri este prea complexă — toate celelalte variante (cu excepția, poate, a sistemelor de monitorizare a rețelei care funcționează cu SNMP și RMON) funcționează conform acelei arhitecturi. Avem un generator de date pentru analiză, care poate fi un dispozitiv de rețea sau un senzor stand-alone. Avem un sistem de colectare a semnalelor de alarmă și avem un sistem pentru gestionarea întregii infrastructuri de monitorizare. Aceste două componente finale pot fi integrate într-un singur nod, dar în rețelele de dimensiuni mai mari, ele sunt de obicei distribuite pe cel puțin două dispozitive pentru a asigura scalabilitatea și fiabilitatea.
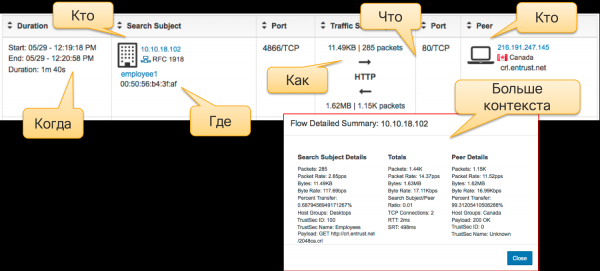
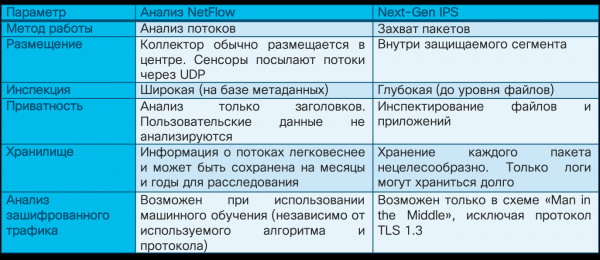
Spre deosebire de analiza pachetelor, care se bazează pe studiul antetului și corpului fiecărui pachet și a sesiunilor formate din acestea, analiza fluxurilor se bazează pe colectarea metadatelor despre traficul de rețea. Când, cât, de unde și unde, cum... acestea sunt întrebările la care răspunde analiza telemetriei de rețea prin diferite protocoale de flux. Inițial, ele au fost folosite pentru a analiza statisticile și pentru a identifica problemele IT din rețea, dar apoi, pe măsură ce mecanismele analitice s-au dezvoltat, au devenit aplicabile acelorasi telemetrii și în scopuri de securitate. Aici trebuie menționat încă o dată că analiza fluxurilor nu înlocuiește și nu anulează captarea pachetelor. Fiecare dintre aceste metode are domeniul său specific de aplicare. Dar în contextul acestui articol, analiza fluxurilor este cea mai potrivită pentru monitorizarea infrastructurii interne. Aveți dispozitive de rețea (indiferent dacă funcționează într-o paradigmă software-definită sau conform unor reguli statice) pe care atacurile nu le pot ocoli. Un senzor IDS clasic poate fi evitat, dar un dispozitiv de rețea care suportă protocolul de flux nu poate fi. Acesta este avantajul acestei metode.
Pe de altă parte, dacă aveți nevoie de dovezi pentru autoritățile de aplicare a legii sau pentru propria echipă de investigare a incidentelor, nu puteți evita captura pachetelor - telemetria de rețea nu este o copie a traficului care poate fi utilizată pentru colectarea probelor; este necesară pentru detectarea rapidă și luarea deciziilor în domeniul securității informației. Pe de altă parte, utilizând analiza telemetriei, puteți "scrie" nu tot traficul de rețea (pentru că, de fapt, Cisco se ocupă cu centrele de date :-), ci doar cel implicat în atac. Instrumentele de analiză a telemetriei completează bine mecanismele tradiționale de captură a pachetelor, oferind echipei un semnal pentru captura și stocarea selectivă. În caz contrar, va trebui să aveți o infrastructură de stocare colosală.
Să presupunem o rețea care funcționează la o viteză de 250 Mbit/s. Dacă doriți să salvați toată această cantitate, veți avea nevoie de 31 MB de stocare pentru o secundă de transfer de trafic, 1,8 GB pentru un minut, 108 GB pentru o oră și 2,6 TB pentru o zi. Pentru a stoca datele zilnice de la o rețea cu o lățime de bandă de 10 Gbit/s, veți avea nevoie de 108 TB de stocare. Și, de fapt, unele reglementări impun păstrarea datelor de securitate ani de zile... Înregistrarea „la cerere”, pe care o ajută să o realizeze analiza fluxurilor, ajută la reducerea acestor valori cu ordine. Apropo, dacă ne gândim la raportul dintre volumul de date înregistrate de telemetria de rețea și captura completă a datelor, acesta este de aproximativ 1 la 500. Pentru valorile menționate anterior, stocarea decodificării complete a întregului trafic zilnic va fi de 5 și 216 GB, respectiv (poate fi chiar scris pe un obisnuit stick USB).
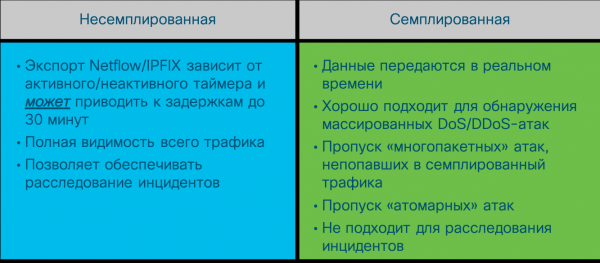
Dacă metoda de captare a datelor brute de rețea este aproape identică de la un vendor la altul pentru instrumentele de analiză, în cazul analizei fluxurilor lucrurile stau diferit. Există mai multe variante de protocoale de flux, despre care este important să cunoaștem diferențele, mai ales în contextul securității. Cel mai popular este protocolul Netflow, dezvoltat de Cisco. Există mai multe versiuni ale acestui protocol, care se diferențiază prin capacitățile și volumul de informații despre trafic pe care le înregistrează. Versiunea curentă este a noua (Netflow v9), pe baza căreia a fost dezvoltat standardul industrial Netflow v10, cunoscut și sub numele de IPFIX. Astăzi, majoritatea vendorilor de rețea suportă exact Netflow sau IPFIX în echipamentele lor. Dar există și alte variante de protocoale de flux — sFlow, jFlow, cFlow, rFlow, NetStream etc., dintre care sFlow este cel mai popular. Acesta este adesea susținut de producătorii locali de echipamente de rețea datorită simplității implementării. Care sunt principalele diferențe între Netflow, care a devenit un standard de facto, și sFlow? Aș evidenția câteva. În primul rând, Netflow are câmpuri configurabile de utilizator, spre deosebire de câmpurile fixe din sFlow. În al doilea rând, și acesta este cel mai important aspect în cazul nostru, sFlow colectează așa-numita telemetrie eșantionată; spre deosebire de telemetria ne-eșantionată a lui Netflow și IPFIX. Care este diferența dintre ele?
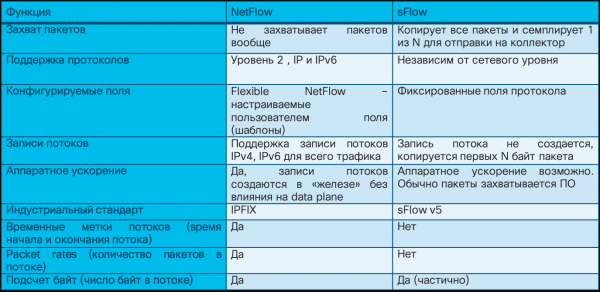
Imaginați-vă că ați decis să citiți cartea “” a colegilor mei — Gary McIntyre, Joseph Muniz și Nadeem AlFardan (la link puteți descărca o parte din carte). Aveți trei opțiuni pentru a atinge acest obiectiv — să citiți cartea în întregime, să o răsfoiți, oprindu-vă la fiecare a 10-a sau 20-a pagină, sau să încercați să găsiți un rezumat al conceptelor cheie pe un blog sau un serviciu de tip SmartReading. Telemetria ne-eșantionată este ca și cum ați citi fiecare “pagină” a traficului de rețea, adică analiza metadatelor pentru fiecare pachet. Telemetria eșantionată este o examinare selectivă a traficului în speranța că în eșantioanele alese veți găsi ceea ce aveți nevoie. În funcție de viteza canalului, telemetria eșantionată va oferi pentru analiză fiecare al 64-lea, 200-lea, 500-lea, 1000-lea, 2000-lea sau chiar 10000-lea pachet.
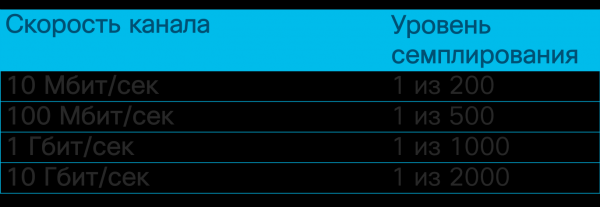
În contextul monitorizării Securității Informațiilor, aceasta înseamnă că telemetria eșantionată este bine adaptată pentru a detecta atacuri DDoS, scanări, răspândirea codului malițios, dar poate rata atacuri atomice sau pe mai multe pachete, care nu au fost incluse în eșantionul trimis pentru analiză. Telemetria nesampled nu are aceste dezavantaje și, cu ajutorul ei, spectrul atacurilor detectabile este mult mai larg. Iată o mică listă de evenimente care pot fi detectate cu ajutorul instrumentelor de analiză a telemetriei de rețea.
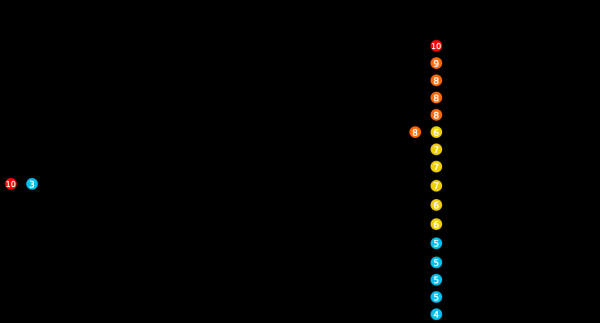
Desigur, un analizator Netflow open source nu vă va permite aceasta, deoarece principala sa sarcină este de a colecta telemetria și de a efectua o analiză de bază din perspectiva IT. Pentru a identifica amenințările Securității Informațiilor pe baza fluxului, este necesar să dotați analizatorul cu diverse motoare și algoritmi, care vor identifica problemele de securitate cibernetică pe baza câmpurilor Netflow standard sau personalizate, îmbogățind datele standard cu date externe din diverse surse de Threat Intelligence etc.
Prin urmare, dacă aveți de ales, optați pentru Netflow sau IPFIX. Dar chiar dacă echipamentele dumneavoastră lucrează doar cu sFlow, așa cum se întâmplă cu mulți producători autohtoni, chiar și în acest caz puteți extrage beneficii din el în contextul securității.
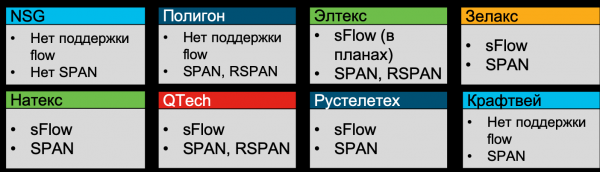
În vara anului 2019, am efectuat o analiză a posibilităților oferite de producătorii ruși de echipamente de rețea, iar toți, cu excepția NSG, Poligon și Kraftway, au declarat suport pentru sFlow (cel puțin, Zelax, Natex, Eltex, QTech, Rusteletech).
Întrebarea următoare care se va pune este unde să implementați suportul flow pentru obiective de securitate? De fapt, întrebarea este formulată incorect. Pe echipamentele moderne, suportul pentru protocoalele flow este aproape întotdeauna disponibil. Așadar, aș reformula întrebarea astfel: unde este cel mai eficient să colectați telemetria din perspectiva securității? Răspunsul va fi destul de evident: la nivelul accesului, unde puteți vedea 100% din tot traficul, unde aveți informații detaliate despre gazde (MAC, VLAN, ID de interfață), unde puteți urmări chiar și traficul P2P între gazde, ceea ce este critic pentru detectarea scanării și răspândirea malware-ului. La nivel de nucleu, o parte din trafic poate pur și simplu să nu fie vizibil, iar la nivelul perimetrului, veți vedea, cu bine, dacă o pătrime din întreg traficul vostru de rețea. Dar, dacă din diverse motive, în rețea au apărut dispozitive străine, permițând atacatorilor să „intru și să ies” ocolind perimetrul, analizarea telemetriei de la acestea nu va aduce nimic. De aceea, pentru o acoperire maximă, se recomandă activarea colectării telemetriei tocmai la nivelul accesului. În acest context, trebuie menționat că, chiar dacă vorbim despre virtualizare sau containere, în comutatoarele virtuale moderne se întâlnește adesea suport pentru flow, ceea ce permite controlarea traficului și acolo.
Dar, având în vedere că am adus în discuție acest subiect, trebuie să răspund la întrebarea: ce se întâmplă dacă echipamentul, fie el fizic sau virtual, nu suportă protocoalele flow? Sau activarea acestora este interzisă (de exemplu, în segmente industriale pentru a asigura fiabilitatea)? Sau activarea conduce la o încărcare mare a procesorului central (ceea ce se întâmplă pe echipamentele învechite)? Pentru a rezolva această problemă, există senzori virtuali specializați (flow sensor), care sunt, în esență, simple distribuitoare ce permit traficul să treacă prin ele și transgresează acest trafic sub formă de flow către modul de colectare. Totuși, în acest caz, ne confruntăm cu toate problemele de care am vorbit mai sus în legătură cu instrumentele de captură a pachetelor. Așadar, trebuie să înțelegem nu doar avantajele tehnologiei de analiză a fluxurilor, ci și limitările acesteia.
Un alt aspect important de reținut când vorbim despre instrumentele de analiză a fluxurilor. Dacă în cazul instrumentelor de generare a evenimentelor de securitate folosim metrici EPS (evenimente pe secundă), în analiza telemetriei această metrică nu se aplică; ea este înlocuită de FPS (fluxuri pe secundă). La fel ca în cazul EPS, nu putem calcula dinainte acest indicator, dar putem estima numărul aproximativ de fluxuri generate de un anumit dispozitiv în funcție de sarcina sa. Pe internet, puteți găsi tabele cu valori aproximative pentru diferite tipuri de dispozitive corporative, ceea ce vă va permite să estimați ce licențe aveți nevoie pentru instrumentele de analiză și ce arhitectură va avea această configurație. Problema este că senzorul IDS are o capacitate de transmisie maximă, pe care o poate „extrage”, iar colectorul de fluxuri are propriile sale limitări, pe care trebuie să le înțelegem. Prin urmare, în rețele mari și distribuite teritorial, există de obicei mai mulți colectori. Când descriam, , am menționat deja numărul colectorilor noștri — 21. Și aceasta este pentru o rețea dispersată pe cinci continente, cu aproximativ o jumătate de milion de dispozitive active).
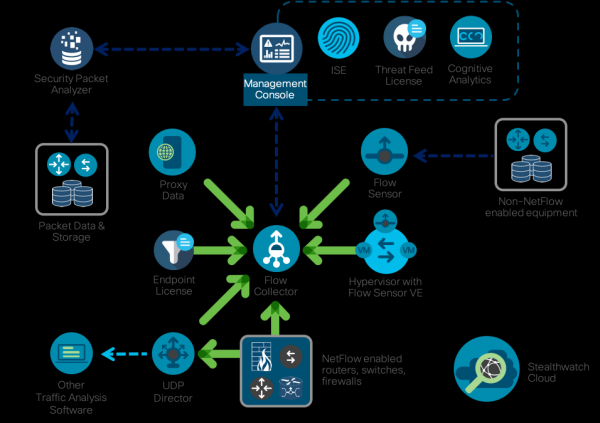
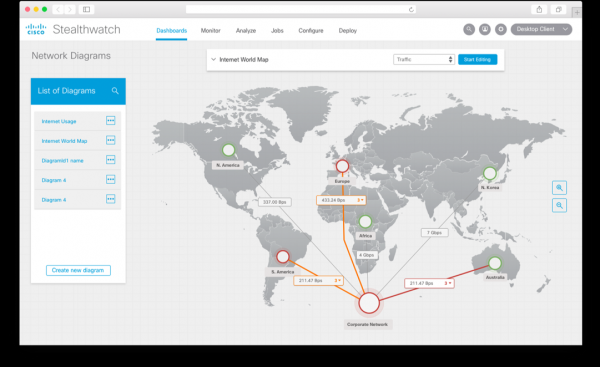
Ca sistem de monitorizare Netflow, folosim propria noastră soluție , care este special orientat spre soluționarea problemelor de securitate. Dispune de numeroase motoare integrate pentru detectarea activității anormale, suspecte și evident malițioase, permițând identificarea unei game largi de amenințări — de la criptomining la scurgeri de informații, de la răspândirea codului malițios la fraude. Ca și majoritatea analizatorilor de fluxuri, Stealthwatch este construit pe o schemă în trei niveluri (generator — colector — analizator), dar este completat cu o serie de caracteristici interesante, care sunt importante în contextul materialului discutat. În primul rând, se integrează cu soluții de captură a pachetelor (de exemplu, Cisco Security Packet Analyzer), permițând înregistrarea sesiunilor de rețea selectate pentru investigații și analize profunde ulterioare. În al doilea rând, special pentru extinderea sarcinilor de securitate, am dezvoltat un protocol special nvzFlow, care permite
Este evident că, atunci când vorbim despre sistemele de analiză Netflow din perspectiva securității, piața nu se limitează la o singură soluție de la Cisco. Puteți folosi atât soluții comerciale, cât și soluții gratuite sau semi-gratuite. Este destul de ciudat dacă în blogul Cisco aș da exemple cu soluții ale concurenților, așa că voi menționa câteva cuvinte despre cum telemetria de rețea poate fi analizată folosind două instrumente populare, asemănătoare ca nume, dar totuși diferite — SiLK și ELK.
SiLK este un set de instrumente (Sistemul pentru Cunoașterea la Nivel de Internet) pentru analiza traficului, dezvoltat de CERT/CC din SUA. Acesta suportă, în contextul acestui articol, Netflow (versiunile 5 și 9, cele mai populare), IPFIX și sFlow, și, cu ajutorul diferitelor utilitare (rwfilter, rwcount, rwflowpack etc.), efectuează diverse operațiuni pe telemetria de rețea cu scopul de a detecta semne de activități neautorizate. Totuși, trebuie să menționăm câteva aspecte importante. SiLK este un instrument de linie de comandă, iar pentru analiza operațională, tot timpul se introduce comenzi de tipul (detectarea pachetelor ICMP mai mari de 200 de biți):
rwfilter --flowtypes=all/all --proto=1 --bytes-per-packet=200- --pass=stdout | rwrwcut --fields=sIP,dIP,iType,iCode --num-recs=15
nu este foarte convenabil. Puteți folosi interfața grafică iSiLK, dar aceasta nu vă va ușura semnificativ viața, îndeplinind doar funcția de vizualizare, nu de înlocuire a analistului. Și acesta este al doilea aspect. Spre deosebire de soluțiile comerciale, care deja dispun de o bază analitică solidă, algoritmi de detectare a anomaliilor și fluxuri de lucru adecvate etc., în cazul SiLK, toate acestea trebuie să le faceți singuri, ceea ce va necesita competențe oarecum diferite de cele necesare pentru utilizarea unui instrumentar deja pregătit. Acest lucru nu este neapărat rău sau bun — este o caracteristică aproape a oricărui instrument gratuit, care pleacă de la premisa că știți ce trebuie să faceți, iar el doar vă va ajuta în acest sens (instrumentarul comercial depinde mai puțin de competențele utilizatorilor săi, deși de asemenea presupune că analistii înțeleg cel puțin noțiunile de bază ale investigării și monitorizării rețelelor). Dar să ne întoarcem la SiLK. Ciclu de lucru al analistului cu acest instrument arată astfel:
- Formularea ipotezei. Trebuie să înțelegem ce vom căuta în telemetria de rețea, să cunoaștem atributele unice după care vom identifica diverse anomalii sau amenințări.
- Construirea modelului. După ce am formulat ipoteza, o programăm folosind același Python, shell sau alte instrumente care nu sunt incluse în SiLK.
- Testarea. Se ajunge la verificarea corectitudinii ipotezei noastre, care este confirmată sau infirmată cu ajutorul utilitarelor SiLK, începând cu „rw”, „set”, „bag”.
- Analiza datelor reale. În utilizarea industrială, SiLK ne ajută să identificăm diferite aspecte, iar analistul trebuie să răspundă la întrebările „Am găsit ceea ce ne-am propus?”, „Se potrivește cu ipoteza noastră?”, „Cum putem reduce numărul falselor alarme?”, „Cum putem îmbunătăți rata de recunoaștere?” etc.
- Îmbunătățirea. În etapa finală, ne îmbunătățim lucrările anterioare — creăm șabloane, optimizăm și îmbunătățim codul, reformulăm și clarificăm ipoteza etc.
Acest ciclu va fi aplicabil și pentru Cisco Stealthwatch, doar că acesta din urmă își automatizează maxim cei cinci pași, reducând numărul de erori ale analistului și sporind rapiditatea detectării incidentelor. De exemplu, în SiLK, statistica de rețea poate fi îmbogățită cu date externe despre IP-uri malițioase prin scripturi scrise manual, în timp ce în Cisco Stealthwatch — această funcție este integrată, arătându-vă imediat un semnal de alarmă dacă în traficul de rețea se întâlnește interacțiunea cu adrese IP din lista neagră.
Dacă urcăm mai sus în piramida „plății” software-ului de analiză a fluxului, atunci după SiLK, care este complet gratuit, se află ELK, care este condiționat gratuit, formându-se din trei componente cheie — Elasticsearch (indexare, căutare și analiză a datelor), Logstash (input/output de date) și Kibana (vizualizare). Spre deosebire de SiLK, unde totul trebuie scris manual, ELK dispune deja de multe biblioteci/module gata făcute (unele plătite, altele nu), care automatizează analiza telemetriei de rețea. De exemplu, filtrul GeoIP din Logstash permite corelarea adrese IP observate cu locația lor geografică (aceasta fiind o funcție integrată în Stealthwatch).
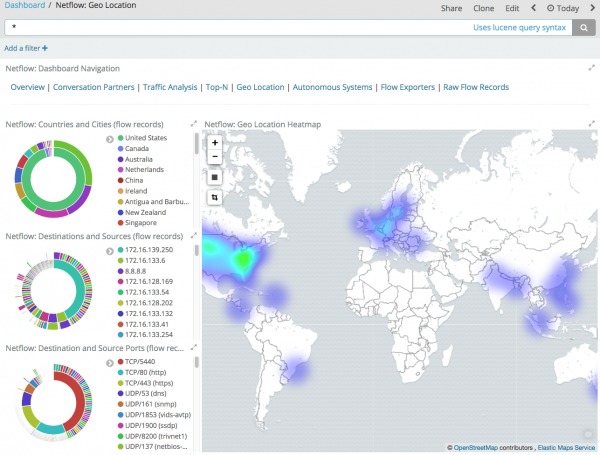
ELK are de asemenea o comunitate destul de mare, care dezvoltă componentele lipsă pentru această soluție de monitorizare. De exemplu, pentru a lucra cu Netflow, IPFIX și sFlow, puteți utiliza modulul , dacă modulul Logstash Netflow nu vă satisface, acesta susținând doar Netflow.
Oferind mai multă rapiditate în colectarea fluxului și în căutarea acestuia, ELK nu beneficiază în prezent de o analiză integrată bogată pentru detectarea anomaliilor și amenințărilor în telemetria de rețea. Asta înseamnă că, urmând ciclul de viață descris mai sus, va trebui să descrieți modelele de încălcare singuri și apoi să le utilizați în sistemul operațional (nu există modele integrate).
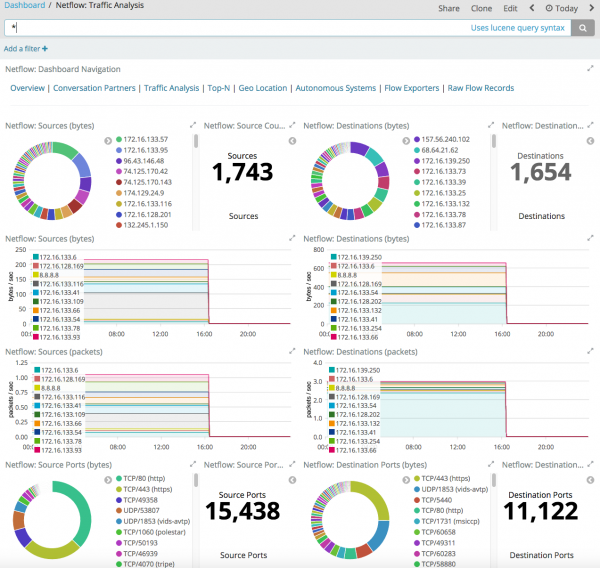
Există, desigur, extensii mai sofisticate pentru ELK, care au deja integrate anumite modele de detectare a anomaliilor în telemetria de rețea, dar aceste extensii costă bani și aici intervine întrebarea: merită efortul - să scrii un model similar singur, să cumperi implementarea acesteia pentru instrumentul tău de monitorizare sau să achiziționezi o soluție gata făcută din clasa Analiza Traficului de Rețea.
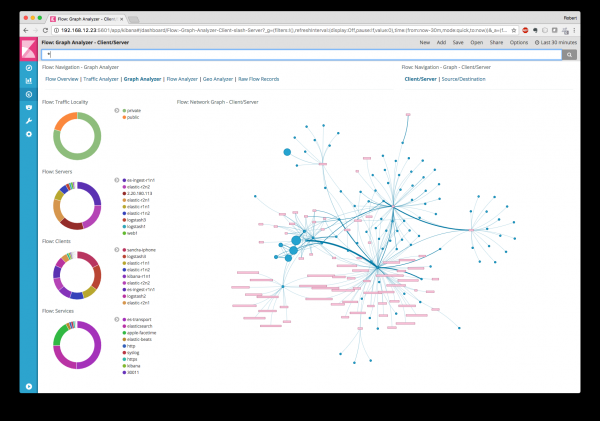
De fapt, nu vreau să intru în polemică despre ce este mai bine, să cheltuiești bani și să cumperi o soluție gata făcută pentru monitorizarea anomaliilor și amenințărilor în telemetria de rețea (de exemplu, Cisco Stealthwatch) sau să te descurci singur și să adaptezi pentru fiecare nouă amenințare, același SiLK, ELK sau nfdump sau OSU Flow Tools (mă refer la ultimele două), în ultima dată)? Fiecare alege pentru el și fiecare are propriile motive pentru a alege oricare dintre cele două opțiuni. Eu am vrut doar să arăt că telemetria de rețea este un instrument foarte important în asigurarea securității rețelei pentru infrastructura internă și nu ar trebui ignorată, pentru a nu adăuga numele companiei tale pe lista celor menționate în mass-media împreună cu epitetele „sparte”, „nerespectând cerințele de securitate a informației”, „negândindu-se la securitatea datelor sale și a clienților”.
În concluzie, aș dori să enumăr principalele sfaturi pe care ar trebui să le urmezi atunci când îți construiești monitorizarea securității informației pentru infrastructura internă:
- Nu te limita doar la perimetru! Folosește (și alege) infrastructura rețelei nu doar pentru a transmite traficul din punctul A în punctul B, ci și pentru a aborda problemele de securitate cibernetică.
- Studiază mecanismele existente de monitorizare a securității informației din echipamentele tale de rețea și profită de acestea.
- Pentru monitorizarea internă, dă preferință analizei telemetriei - aceasta permite detectarea până la 80-90% din toate incidentele de securitate a informației, realizând în același timp ceea ce este imposibil în cazul captării pachetelor de rețea și economisind spațiu pentru stocarea tuturor evenimentelor de securitate a informației.
- Pentru monitorizarea fluxurilor, folosește Netflow v9 sau IPFIX – acestea oferă mai multe informații în contextul securității și permit monitorizarea nu doar a IPv4, ci și a IPv6, MPLS etc.
- Folosește un protocol de flux nesamplat – acesta oferă mai multe informații pentru detectarea amenințărilor. De exemplu, Netflow sau IPFIX.
- Verificați încărcătura echipamentului dumneavoastră de rețea – este posibil să nu facă față procesării și protocolului flow. Atunci gândiți-vă la utilizarea senzorilor virtuali sau a unui Netflow Generation Appliance.
- Implementați controlul mai întâi la nivelul accesului – acest lucru vă va permite să vedeți 100% din tot traficul.
- Dacă nu aveți altă opțiune și utilizați echipamente de rețea rusești, alegeți-le pe cele care suportă protocoalele flow sau au porturi SPAN/RSPAN.
- Combinați sistemele de detectare/prevenire a intruziunilor/atacurilor la margini cu sistemele de analiză a fluxurilor în rețeaua internă (inclusiv în cloud-uri).
În ceea ce privește ultimul sfat, aș vrea să aduc o ilustrație pe care am mai menționat-o anterior. Observați că, dacă anterior serviciul de securitate Cisco își construia aproape în întregime sistemul de monitorizare a securității pe baza sistemelor de detectare a intruziunilor și a metodelor bazate pe semnături, acum acestea reprezintă doar 20% din incidente. Alte 20% provin din sistemele de analiză a fluxurilor, ceea ce arată că aceste soluții nu sunt o fantezie, ci un instrument real în activitatea serviciilor de securitate ale întreprinderilor moderne. Mai ales că aveți pentru implementarea lor cel mai important lucru – infrastructura de rețea, cu care investițiile pot fi protejate suplimentar prin asumarea funcțiilor de monitorizare a securității.
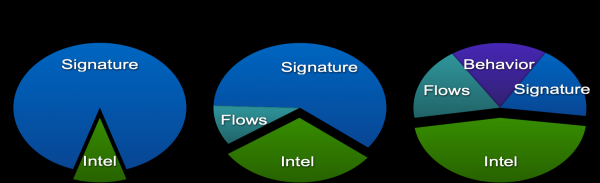
Am ales în mod special să nu discut despre reacția la anomaliile sau amenințările identificate în fluxurile de rețea, dar cred că este deja clar că monitorizarea nu ar trebui să se încheie doar cu descoperirea amenințării. Aceasta ar trebui să fie urmată de reacție, de preferat într-un mod automat sau automatizat. Dar acesta este deja un subiect pentru un material separat.
Informații suplimentare:
P.S. Dacă vă este mai ușor să percepeți auditiv tot ce a fost scris mai sus, puteți viziona o prezentare de o oră, care a stat la baza acestei note.

Sursa: habr.com
