

În 2017, am câștigat un concurs pentru dezvoltarea nucleului tranzacțional al afacerii de investiții a Alpha Bank și am început lucrările (la HighLoad++ 2018 cu o prezentare despre nucleul afacerii de investiții). Vladimir Drynkin, șeful departamentului nucleului tranzacțional al afacerii de investiții a Alpha Bank). Acest sistem trebuia să agregheze date despre tranzacții din diverse surse, în formate diferite, să uniformizeze datele, să le stocheze și să ofere acces la ele.
Pe parcursul dezvoltării, sistemul a evoluat și a acumulat funcționalități, iar într-un anumit moment ne-am dat seama că se cristalizase ceva mult mai mare decât un simplu software aplicație destinat unei serii restrânse de sarcini: am creat un sistem pentru construirea aplicațiilor distribuite cu stocare persistentă.Experiența acumulată a stat la baza unui nou produs — (TDG).
Vreau să vorbesc despre arhitectura TDG și despre soluțiile la care am ajuns în procesul de dezvoltare, să vă familiarizez cu funcționalitatea principală și să arăt cum produsul nostru poate deveni baza pentru construirea unor soluții complete.
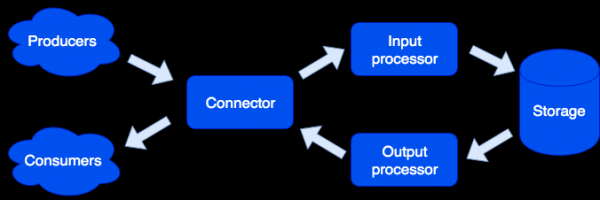
Arhitectural, am împărțit sistemul în module distincte, fiecare responsabil pentru rezolvarea unui anumit set de sarcini. O instanță a aplicației rulează unul sau mai multe tipuri de roluri. În cluster pot exista mai multe roluri de același tip: roluriConnector
Connector
Connectorul este responsabil pentru conectarea la lumea externă; sarcina sa este să primească o cerere, să o analizeze, iar dacă acest lucru a reușit, să trimită datele pentru prelucrare la procesorul de intrare. Susținem formatele HTTP, SOAP, Kafka, FIX. Arhitectura permite adăugarea facilă a suportului pentru noi formate, în curând va apărea suportul pentru IBM MQ. Dacă analiza cererii s-a încheiat cu o eroare, connectorul va returna un mesaj de eroare; în caz contrar, va răspunde că cererea a fost procesată cu succes, chiar și în cazul în care a avut loc o eroare în procesarea ulterioară. Acest lucru a fost făcut special pentru a colabora cu sistemele care nu pot repeta cererile — sau, dimpotrivă, le repetă excesiv. Pentru a nu pierde datele, se utilizează o coadă de reparare: obiectul este mai întâi plasat în aceasta și abia după prelucrarea reușită este șters. Administratorul poate primi notificări despre obiectele rămase în coada de reparare și, după remedierea erorii software sau a defecțiunii hardware, poate încerca din nou.
Procesor de intrare
Procesorul de intrare clasifică datele primite pe baza caracteristicilor acestora și apelează gestionarii potriviți. Gestionarii sunt coduri scrise în limbajul Lua, care sunt rulate într-un sandbox, astfel încât să nu poată influența funcționarea sistemului. În această etapă, datele pot fi transformate în formatul necesar și, dacă este necesar, pot fi lansate un număr arbitrar de sarcini care pot implementa logica necesară. De exemplu, în produsul MDM (Master Data Management), construit pe Tarantool Data Grid, atunci când adăugăm un utilizator nou, pentru a nu încetini procesarea cererii, crearea înregistrării de bază se desfășoară ca o sarcină separată. Sandbox-ul suportă cereri de citire, modificare și adăugare a datelor, permițând executarea unei funcții pe toate rolurile de tip storage și agregarea rezultatelor (map/reduce).
Gestionarii pot fi descriși în fișiere:
sum.lua

local x, y = unpack(...)
return x + y
Și apoi declarați în configurație:
functions:
  sum: { __file: sum.lua }
De ce Lua? Lua este un limbaj foarte simplu. Din experiența noastră, după câteva ore de la prima întâlnire cu acesta, oamenii încep să scrie cod care le rezolvă problema. Și nu doar dezvoltatori profesioniști, ci și, de exemplu, analiști. În plus, datorită compilatorului JIT, Lua funcționează foarte rapid.
Stocare
Stocarea păstrează datele persistente. Înainte de salvare, datele sunt validate pentru a se conforma schemei de date. Pentru a descrie schema, folosim un format extins. . Exemplu:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Din această descriere se generează automat DDL (Data Definition Language) pentru SGBD Tarantool și schema pentru accesarea datelor.
Se suportă replicarea datelor asincronă (în planuri se preconizează adăugarea celei sincrone).
Procesor de output
Uneori, este necesar să informăm consumatorii externi despre sosirea unor date noi, pentru asta există rolul de Procesor de output. După salvarea datelor, acestea pot fi transmise către procesatorul corespunzător (de exemplu, pentru a le adapta în modul cerut de consumator) — și după aceea trimisesc la connector pentru expediere. Aici se folosește și o coadă de reparare: dacă nimeni nu a acceptat obiectul, administratorul poate încerca din nou mai târziu.
Scalare
Rolurile connector, input processor și output processor nu au stare, ceea ce ne permite să scalăm sistemul orizontal, adăugând pur și simplu noi instanțe ale aplicației cu rol de tipul dorit. Pentru scalarea orizontală, storage-ul folosește pentru organizarea clusterului utilizând baloane virtuale. După adăugarea unui nou server, o parte din baloanele de pe serverele vechi se mută în fundal pe noul server; acest lucru se întâmplă transparent pentru utilizatori și nu afectează funcționarea întregului sistem.
Proprietățile datelor
Obiectele pot fi foarte mari și pot conține alte obiecte. Asigurăm atomicitatea adăugării și actualizării datelor, păstrând obiectul cu toate dependențele pe un singur balon virtual. Astfel se exclude „împrăștierea” obiectului pe mai multe servere fizice.
Se suportă versiunea: fiecare actualizare a obiectului creează o nouă versiune, iar noi putem oricând să facem o captură temporară și să vedem cum arăta lumea atunci. Pentru datele care nu necesită o istorie lungă, putem limita numărul de versiuni sau chiar să păstrăm doar una — cea mai recentă, adică, practic, să dezactivăm versiunea pentru un anumit tip. De asemenea, putem limita istoria în funcție de timp: de exemplu, putem șterge toate obiectele unui anumit tip mai vechi de 1 an. Suportul pentru arhivare este de asemenea disponibil: putem exporta obiecte mai vechi decât timpul specificat, eliberând astfel spațiu în cluster.
Sarcini
Printre funcțiile interesante se numără posibilitatea de a lansa sarcini conform unui program, la cererea utilizatorului sau programatic din sandbox:
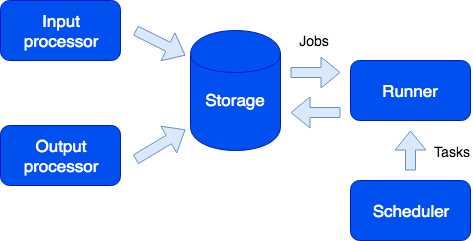
Aici vedem o altă rol — runner. Acest rol nu are stare, iar dacă este necesar, pot fi adăugate instanțe suplimentare ale aplicației cu acest rol în cluster. Responsabilitatea runner-ului este de a executa sarcinile. Așa cum s-a menționat, din sandbox este posibilă generarea de sarcini noi; acestea sunt salvate în coada de stocare și apoi executate pe runner. Acest tip de sarcini se numește Job. Avem și un tip de sarcini numit Task — acestea sunt sarcini definite de utilizator și lansate conform unui program (folosind sintaxa cron) sau la cerere. Pentru a lansa și a monitoriza astfel de sarcini, avem un manager de sarcini convenabil. Pentru ca această funcționalitate să fie disponibilă, este necesar să activăm rolul scheduler; acest rol are stare, așadar nu este scalabil, lucru care oricum nu este necesar; totuși, ca toate celelalte roluri, poate avea o replică, care începe să funcționeze în cazul în care masterul cedează.
Logger
Un alt rol se numește logger. Acesta colectează log-uri de la toți membrii clusterului și oferă o interfață pentru exportul și vizualizarea acestora prin intermediul interfeței web.
Servicii
Merită menționat că sistemul permite crearea ușoară de servicii. În fișierul de configurare, se pot specifica ce cereri să fie direcționate către un handler scris de utilizator, care este executat în sandbox. În acest handler, de exemplu, se poate efectua o cerere analitică și se poate returna rezultatul.
Serviciul este descris în fișierul de configurare:
services:
   sum:
      doc: "adună două numere"
      function: sum
      return_type: int
      args:
         x: int
         y: int
API-ul GraphQL este generat automat și serviciul devine disponibil pentru apeluri:
query {
   sum(x: 1, y: 2)
}
Aceasta va duce la apelarea handler-ului sum, care va returna rezultatul:
3
Profilarea cererilor și metricele
Pentru a înțelege funcționarea sistemului și pentru profilarea cererilor, am implementat suport pentru protocolul OpenTracing. Sistemul poate trimite informații către uneltele care suportă acest protocol, cum ar fi Zipkin, permițându-vă să înțelegeți cum a fost executată cererea:
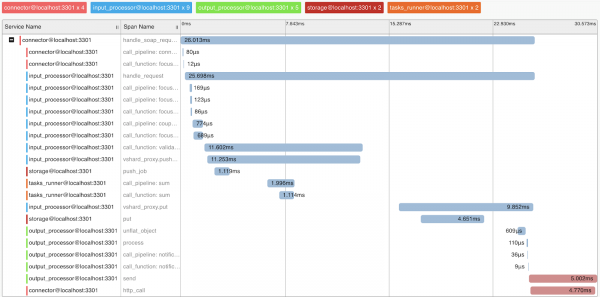
Desigur, sistemul oferă metrice interne care pot fi colectate cu ajutorul Prometheus și vizualizate cu Grafana.
Deploy
Tarantool Data Grid poate fi implementat din pachete RPM sau arhive, folosind utilitarul livrat sau Ansible, există de asemenea suport pentru Kubernetes ().
Aplicația care implementează logica de afaceri (configurare, handler-e) este încărcată în clusterul Tarantool Data Grid implementat sub formă de arhivă prin UI sau cu ajutorul unui script, prin API-ul pe care îl oferim.
Exemple de aplicații
Ce aplicații pot fi create cu ajutorul Tarantool Data Grid? De fapt, majoritatea sarcinilor de afaceri sunt cumva legate de procesarea fluxurilor de date, stocarea și accesul la acestea. Așadar, dacă aveți fluxuri mari de date care trebuie stocate în siguranță și la care să aveți acces, produsul nostru vă poate economisi mult timp de dezvoltare, permițându-vă să vă concentrați asupra logicii voastre de afaceri.
De exemplu, dorim să colectăm informații despre piața imobiliară pentru a avea ulterior informații despre cele mai avantajoase oferte. În acest caz, putem identifica următoarele sarcini:
- Roboții care colectează informații din surse deschise vor fi sursele noastre de date. Această sarcină o puteți rezolva folosind soluții gata făcute sau scriind cod în orice limbaj.
- Apoi, Tarantool Data Grid va primi și salva datele. Dacă formatul datelor din diferite surse diferă, puteți scrie cod în limbajul Lua, care va efectua conversia la un format comun. În etapa de preprocessare, veți putea, de asemenea, să filtrați ofertele duplicate sau să actualizați informațiile despre agenții care activează pe piață în baza de date.
- Acum aveți o soluție scalabilă în cluster, pe care o puteți îmbogăți cu date și face interogări. Mai departe, puteți implementa noi funcționalități, de exemplu, puteți scrie un serviciu care să facă o interogare la date și să ofere cea mai avantajoasă ofertă în decurs de o zi — acest lucru va necesita câteva rânduri în fișierul de configurare și puțin cod în Lua.
Ce urmează?
Prioritatea noastră este creșterea confortului dezvoltării prin . De exemplu, aceasta este o IDE care suportă profilarea și depanarea handler-elor care funcționează în sandbox.
De asemenea, acordăm o mare atenție problemelor de securitate. Chiar acum, suntem în proces de certificare FSTEC Rusia pentru a confirma un nivel înalt de securitate și a respecta cerințele de certificare a produselor software utilizate în sisteme informaționale de date personale și sisteme informaționale guvernamentale.
Sursa: habr.com
