

În cadrul unui proiect de cercetare a început implementarea unei funcționalități în GCC care permite împărțirea procesului de compilare în mai multe fire de execuție care rulează în paralel. În prezent, pentru a spori viteza de compilare pe sisteme multicore, la nivelul utilitarului make se lansează procese separate ale compilatorului, fiecare dintre ele compilând un fișier de cod separatat. Noua inițiativă experimentează cu asigurarea paralelismului la nivelul compilatorului, ceea ce ar putea permite creșterea eficienței pe sisteme multicore.
Pentru testare a fost creată o ramură separată de paralelism în GCC, pentru a stabili numărul de fire de execuție în care a fost propus un nou parametrul „—param=num-threads=N”. În etapa inițială, optimizările interprocedurale au fost scoase în fire separate, fiind apelate ciclic pentru fiecare funcție și putându-se descompune eficient în paralel. Operațiile GIMPLE, care se ocupă de optimizările independente de hardware, au fost de asemenea scoase în fire separate, evaluând interacțiunea dintre funcții.
În etapa următoare, se planifică scoaterea optimizărilor interprocedurale RTL în fire separate, având în vedere caracteristicile platformei hardware. Ulterior, se dorește implementarea paralelismului optimizărilor intraprocedurale (IPA) aplicate codului din interiorul funcției, indiferent de particularitățile apelurilor. Punctul limitativ rămâne momentan colectorul de gunoi, în care a fost adăugată o blocare globală care dezactivează operațiile de colectare a gunoiului în timpul execuției în modul multithreading (în viitor, colectorul de gunoi va fi adaptat pentru execuție multithreading în GCC).
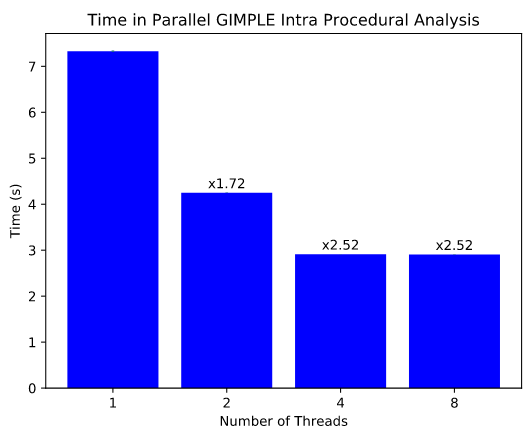
Pentru a evalua modificările de performanță, a fost pregătit un set de teste care compilează fișierul gimple-match.c, conținând peste 100.000 de linii de cod și 1.700 de funcții. Testele efectuate pe un sistem cu CPU Intel Core i5-8250U cu 4 nuclee fizice și 8 nucleu virtuale (Hyperthreading) au arătat o reducere a timpului de execuție pentru optimizările Intra Procedural GIMPLE de la 7 la 4 secunde când se rulează 2 fire și până la 3 secunde când se rulează 4 fire, deci s-a obținut o creștere a vitezei pentru etapa de compilare analizată de 1.72 și 2.52 ori, respectiv. Testele au arătat de asemenea că utilizarea nucleelor virtuale în mod Hyperthreading nu duce la o creștere a performanței.
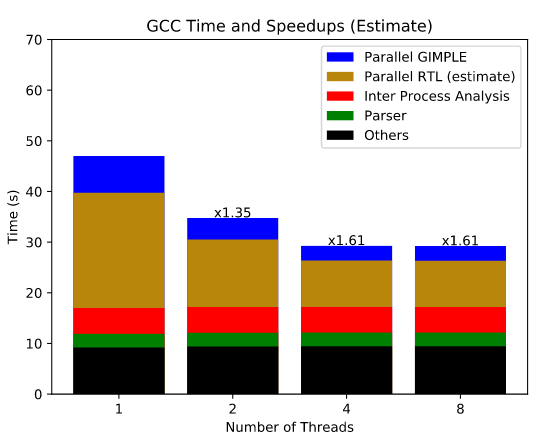
Timpul total de compilare a fost redus cu aproximativ 10%, însă previziunile arată că paralelizarea optimizărilor RTL va permite obținerea unor rezultate și mai semnificative, deoarece această etapă durează semnificativ mai mult la compilare. Estimativ, după paralelizarea RTL, timpul total de compilare se va reduce de 1.61 ori. După aceasta, timpul de compilare poate fi redus cu încă 5-10% prin paralelizarea optimizărilor IPA.
Sursa: opennet.ro
