

Astăzi, miercuri, avem o nouă versiune de Kubernetes — 1.16. Conform tradiției pentru blogul nostru, iată că, pentru a zecea oară, discutăm despre cele mai semnificative schimbări din noua versiune.
Informațiile folosite pentru redactarea acestui material provin din , și problemele, cererile de extragere și Proiectele de Îmbunătățire Kubernetes (KEP) corespunzătoare. Așadar, să începem!..
Noduri
Un număr cu adevărat mare de noutăți notabile (în stadiul de versiune alpha) sunt introduse pe partea nodurilor din clusterele K8s (Kubelet).
În primul rând, sunt prezentate așa-numitele «» (Ephemeral Containers), menite să simplifice procesele de depanare în poduri. Noua mecanism permite lansarea unor containere speciale, care pornesc în spațiul de nume al podurilor existente și trăiesc o perioadă scurtă de timp. Scopul lor este de a interacționa cu alte poduri și containere pentru a rezolva problemele și a efectua depanări. Pentru această funcționalitate a fost implementat un nou comandă kubectl debug, similară ca esență cu kubectl exec: doar că în loc să pornească un proces în container (ca în cazul exec) lansează un container în pod. De exemplu, această comandă va conecta un nou container la pod:
kubectl debug -c debug-shell --image=debian target-pod -- bashDetalii despre containerele efemere (și exemple de utilizare) pot fi găsite în . Implementarea curentă (în K8s 1.16) este o versiune alpha, iar printre criteriile pentru trecerea în versiune beta se numără «testarea API-ului Ephemeral Containers pe parcursul a cel puțin 2 versiuni [Kubernetes]».
NB: Ca esență și chiar denumire, caracteristica amintește de plugin-ul existent , despre care noi . Se presupune că, odată cu apariția containerelor efemere, dezvoltarea unui plugin extern separat va înceta.
O altă noutate — — are rolul de a oferi un mecanism pentru calcularea costurilor suplimentare pentru poduri, care pot varia semnificativ în funcție de mediul de execuție utilizat. Ca exemplu, autorii vorbesc despre Kata Containers, care necesită pornirea unui nucleu de oaspeți, a agentului kata, a sistemului de inițializare etc. Atunci când costurile suplimentare devin atât de mari, ele nu pot fi ignorate, ceea ce înseamnă că este necesar un mod de a le considera pentru alocarea ulterioară, planificare etc. Pentru a le implementa în PodSpec a fost adăugat un câmp Overhead *ResourceList (corespunzător datelor din RuntimeClass, dacă este utilizat).
O altă noutate notabilă — managerul topologiei nodului (Node Topology Manager), menit să unifice abordarea pentru ajustarea fină a distribuției resurselor hardware pentru diferitele componente în Kubernetes. Această inițiativă este determinată de nevoia în expansiune a diverselor sisteme moderne (din domeniul telecomunicațiilor, învățării automate, serviciilor financiare etc.) pentru calculatoare paralele de înaltă performanță și minimizarea întârzierilor în execuția operațiunilor, utilizând astfel capabilitățile avansate ale CPU-ului și accelerarea hardware. Astfel de optimizări în Kubernetes au fost realizate până acum prin componente disparate (CPU manager, Device manager, CNI), iar acum li se va adăuga o interfață internă unificată, care va standardiza abordarea și va simplifica conectarea de noi componente similare — așa-numitele componente intuitive de topologie — pe partea de Kubelet. Detalii — în .
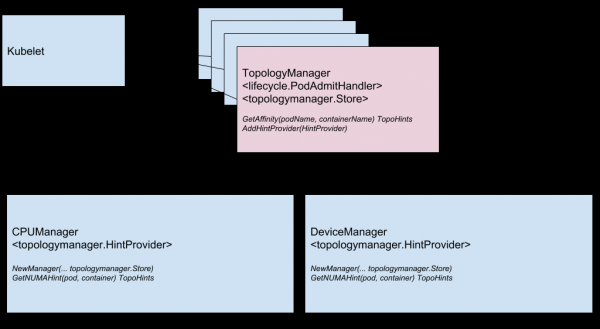
Schema componentelor Managerului de Topologie
Următoarea caracteristică — verificarea containerelor în timpul pornirii acestora (). După cum se știe, pentru containere care se pornesc lent, este dificil să obții un statut actual: fie sunt "ucise" înainte de a începe cu adevărat funcționarea, fie intră într-un deadlock îndelungat. Noua verificare (activată printr-o poartă de caracteristică numită StartupProbeEnabled) anulează — mai exact, amână — efectul altor verificări până în momentul în care pod-ul a încheiat pornirea. De aceea, caracteristica a fost inițial denumită . Pentru pod-urile care pornesc lent, se pot efectua sondaje de stare în intervale de timp relativ scurte.
În plus, imediat în stadiul de beta a fost prezentată o îmbunătățire pentru RuntimeClass, adăugând suport pentru „clustere heterogene”. C nu este acum absolut necesar ca fiecare nod să aibă suport pentru fiecare RuntimeClass: pentru pod-uri se poate alege RuntimeClass fără a se gândi la topologia clusterului. Anterior, pentru a atinge acest lucru — pentru a asigura că pod-urile erau pe noduri cu suport pentru tot ceea ce aveau nevoie — era necesar să se stabilească reguli corespunzătoare pentru NodeSelector și tolerări. În se discută despre exemple de utilizare și, desigur, detaliile implementării.
Rețea
Două caracteristici de rețea semnificative, care au apărut pentru prima dată (în versiunea alfa) în Kubernetes 1.16 — sunt:
- stiva de rețea duală — IPv4/IPv6 — și înțelegerea sa corespunzătoare la nivel de pod-uri, noduri, servicii. Aceasta include interacțiunea IPv4-to-IPv4 și IPv6-to-IPv6 între pod-uri, de la pod-uri la servicii externe, implementări de referință (în cadrul plugin-urilor Bridge CNI, PTP CNI și Host-Local IPAM), precum și compatibilitate cu clustere Kubernetes care funcționează doar pe IPv4 sau IPv6. Detalii despre implementare se află în .
Exemplu de afișare a adreselor IP de două tipuri (IPv4 și IPv6) în lista pod-urilor:
kube-master# kubectl get pods -o wide NUME GATA STATUS RESTARTURI VÂRSTĂ IP NOD nginx-controller 1/1 Funcționare 0 20m fd00:db8:1::2,192.168.1.3 kube-minion-1 kube-master# - Noul API pentru Endpoint — . Acesta rezolvă problemele de performanță/scalabilitate ale existentului Endpoint API, care afectează diverse componente din control-plane (apiserver, etcd, endpoints-controller, kube-proxy). Noul API va fi adăugat în grupul API Discovery și va putea gestiona zeci de mii de endpoint-uri backend pentru fiecare serviciu din cluster, format din mii de noduri. Pentru aceasta, fiecare Serviciu se va traduce în N obiecte
EndpointSlice, fiecare având în mod implicit nu mai mult de 100 de endpoint-uri (valoarea este configurabilă). În API-ul EndpointSlice, se vor prevedea și posibilități pentru dezvoltarea sa viitoare: suport pentru mai multe adrese IP pentru fiecare pod, stări noi pentru endpoint-uri (nu doarGatașiNotReady), subsetare dinamică pentru endpoint-uri.
Până la versiunea beta, a avansat prezentarea din ultima lansare , denumit service.kubernetes.io/load-balancer-cleanup și atașat fiecărui serviciu de tip LoadBalancer. La momentul ștergerii unui astfel de serviciu, acesta împiedică ștergerea efectivă a resursei până ce "curățarea" tuturor resurselor corespunzătoare nu este finalizată.
API Machinery
O adevărată "etapă de stabilizare" a fost înregistrată în domeniul API-serverului Kubernetes și interacțiunii cu acesta. În mare măsură, acest lucru s-a întâmplat datorită transformării în statut stabil a ceea ce nu necesita o prezentare specială (CRD), care aveau statut beta din vremurile îndepărtate ale Kubernetes 1.7 (adică iunie 2017!). Aceeași stabilizare a venit și pentru caracteristicile asociate:
- cu
/statusși/scalepentru CustomResources; - versiuni pentru CRD, bazate pe un webhook extern;
- (în K8s 1.15) valori prestabilite (defaulting) și eliminarea automată a câmpurilor (pruning) pentru CustomResources;
- aplicarea schemei OpenAPI v3 pentru crearea și publicarea documentației OpenAPI utilizate pentru validarea resurselor CRD pe partea serverului.
O alt mecanism, care a devenit familiar pentru administratorii Kubernetes: — a fost de asemenea o perioadă lungă timp în statut de beta (începând cu K8s 1.9) și acum este declarat stabil.
Celelalte două caracteristici au atins versiunea beta: și .
Iar singura noutate semnificativă în versiunea alpha a fost de la SelfLink — un URI special, care reprezintă obiectul specificat și face parte din ObjectMeta și ListMeta (adică parte din orice obiect în Kubernetes). De ce se renunță la el? Motivația "pe scurt" ca lipsa unor motive reale (insurmontabile) pentru ca acest câmp să continue să existe. Motivele mai formale sunt: optimizarea performanței (prin eliminarea câmpului inutil) și simplificarea muncii generic-apiserver, care trebuie să gestioneze un astfel de câmp într-un mod special (ceea ce este singurul câmp care este setat direct înainte de serializarea obiectului). Adevăratul „deprecere” (în cadrul versiunii beta) SelfLink va avea loc în versiunea Kubernetes 1.20, iar finalizarea — 1.21.
Stocarea datelor
Centrala muncă în domeniul storage, ca și în versiuni anterioare, este observată în domeniul . Cele mai importante modificări aici sunt:
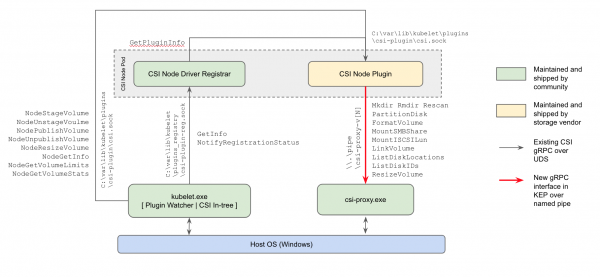
- pentru prima dată (în versiunea alpha) suportul pluginurilor CSI pentru nodurile de lucru cu Windows: metoda actuală de lucru cu stocarea va lua locul pluginurilor in-tree din nucleul Kubernetes și pluginurilor FlexVolume de la Microsoft bazate pe Powershell;

Schema de implementare a pluginurilor CSI în Kubernetes pentru Windows - posibilitatea , introdusă încă în K8s 1.12, a ajuns la versiunea beta;
- o "îmbunătățire" similară (de la alpha la beta) a atins capacitatea de a utiliza CSI pentru a crea volume efemere locale ().
Funcția de clonare a volumelor, apărută în versiunea anterioară a Kubernetes DataSource pentru a crea noi PVC-uri) a obținut acum și statutul de versiune beta. Două modificări notabile în programare (ambele în versiunea alpha):
Planificatorul de sarcini din Airflow este construit pe
EvenPodsSpreading
- folosi pod-uri pentru „distribuția echitabilă” a sarcinilor în loc de unități logice ale aplicației (cum ar fi Deployment și ReplicaSet) și reglementarea acestei distribuții (ca cerință strictă sau ca o condiție moale, adică prioritate). Caracteristica va extinde capacitățile existente de distribuție a pod-urilor planificate, care sunt în prezent limitate de opțiunile PodAffinity
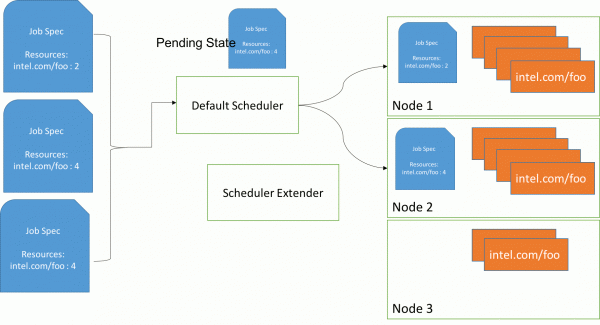
PodAntiAffinityșiPodAntiAffinity, oferind administratorilor un control mai detaliat asupra acestui aspect, ceea ce semnifică o disponibilitate mai bună și un consum de resurse optimizat. Detalii — în . - Utilizare Politica BestFit în Funcția de Prioritate RequestedToCapacityRatio în timpul planificării pod-urilor, ceea ce va permite aplicarea („ambalarea în containere”) atât pentru resursele de bază (procesor, memorie), cât și pentru cele extinse (cum ar fi GPU). Mai multe detalii se găsesc în .

Planificarea pod-urilor: înainte de utilizarea politicii best fit (direct prin default scheduler) și cu utilizarea acesteia (prin scheduler extender)
În plus, posibilitatea de a crea plugin-uri proprii pentru scheduler în afara arborilor principale de dezvoltare Kubernetes (out-of-tree).
Alte modificări
De asemenea, în lansarea Kubernetes 1.16 se remarcă inițiativa de a metricilor existente la un standard complet, iar dacă suntem mai specifici — în conformitate cu privind instrumentarea K8s. Ele se bazează în mare parte pe documentația corespunzătoare Inconsistențele au apărut din diverse motive (de exemplu, unele metrici au fost create înainte ca instrucțiunile actuale să fie disponibile), iar dezvoltatorii au decis că a venit momentul să le uniformizeze, „în conformitate cu restul ecosistemului Prometheus”. Implementarea actuală a acestei inițiative este în stadiul de alfa, care va fi ulterior îmbunătățit în versiunile viitoare de Kubernetes până la beta (1.17) și stabil (1.18).
În plus, merită menționate următoarele modificări:
- Dezvoltarea suportului Windows de utilitarului Kubeadm pentru acest OS (alfa),
RunAsUserNamepentru containere Windows (alfa), suportul pentru Group Managed Service Account (gMSA) până la versiunea beta, mount/attach pentru volumele vSphere. - mecanismului de comprimare a datelor în răspunsurile API. Anterior, pentru aceste scopuri se utiliza un filtru HTTP, care impunea anumite restricții ce împiedicau includerea acestuia în mod implicit. Acum funcționează „comprimarea transparentă a cererilor”: clienții care trimit
Accept-Encoding: gzipîn antet primesc un răspuns comprimat în GZIP, dacă acesta depășea 128 Kb. Clienții pe Go suportă automat comprimarea (trimit antetul necesar), astfel încât vor observa imediat scăderea traficului. (Pentru alte limbi, pot fi necesare mici modificări.) - scalarea HPA de la/spre zero pod-uri pe baza metricilor externe. Dacă scalarea se face pe baza obiectelor/metricelor externe, atunci când sarcinile de lucru sunt inacte, se poate scala automat la 0 replici pentru a economisi resurse. Această funcționalitate ar trebui să fie deosebit de utilă în cazurile în care workerii solicită resurse GPU, iar numărul diferitelor tipuri de workeri inactivi depășește numărul GPU-urilor disponibile.
- Client nou — — pentru acces "generalizat" la obiecte. Este destinat pentru a obține cu ușurință metadate (adică subdiviziuni
metadata) din resursele clusterului și a efectua operațiuni legate de colectarea resturilor și stabilirea de cote. - Colectarea Kubernetes fără cloud provideri învechiți ("încapsulați" în in-tree) (versiune alfa).
- În utilitarul kubeadm a fost adăugată o funcționalitate experimentală (versiune alfa) pentru a aplica patch-uri kustomize în timpul operațiunilor
init,joinșiupgrade. Mai multe informații despre cum să folosești opțiunea--experimental-kustomize, vezi în . - Un nou endpoint pentru apiserver — , — care permite exportul informațiilor despre starea sa de pregătire (readiness). De asemenea, apiserverul a primit o opțiune
--maximum-startup-sequence-duration, care reglează repornirile sale. - Două funcționalități pentru Azure au fost declarate stabile: suport pentru (Availability Zones) și (RG). În plus, în Azure au fost adăugate:
- AAD și ADFS;
-
service.beta.kubernetes.io/azure-pip-namepentru a specifica IP-ul public al echilibratorului de sarcină; - configurare
LoadBalancerNameșiLoadBalancerResourceGroup.
- AWS a introdus suport pentru EBS în Windows și DescribeInstances
Kubeadm acum migrează automat. - configurația CoreDNS la actualizarea versiunii CoreDNS. în imaginea Docker corespunzătoare
- sunt executabile la nivel de lume, ceea ce permite rularea acestei imagini fără a necesita drepturi root. În plus, imaginea de migrare etcd etcd a încetat suportul pentru versiunea etcd2. a trecut la utilizarea distroless ca imagine de bază, îmbunătățind performanța, adăugând noi furnizori de cloud (DigitalOcean, Magnum, Packet).
- În Introducere scurtă în Kustomize
- 🥇Kubernetes 1.16: revizuirea caracteristicilor cheie | ProHoster
P.S.
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
