

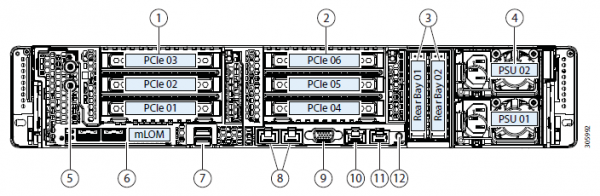
Acesta este un mit destul de răspândit în domeniul echipamentului server. În practică, soluțiile hiperconvergente (când totul este integrat) sunt necesare din multe puncte de vedere. Istoric, primele arhitecturi au fost dezvoltate de Amazon și Google pentru serviciile lor. Atunci ideea era să se creeze o fermă de calcul din noduri identice, fiecare având propriile discuri. Totul era integrat printr-un software sistemic (hypervisor) și fragmentat în mașini virtuale. Principala sarcină era minimizarea eforturilor pentru întreținerea unui nod și minimizarea problemelor la scalare: pur și simplu se mai adăugau încă o mie-două de servere asemănătoare și se conectau alături. În practică, acestea sunt cazuri rare, iar mai des se vorbește despre un număr mai mic de noduri și o arhitectură puțin diferită.
Dar avantajul rămâne același – o scalare și o gestionare incredibil de simplă. Dezavantajul – diferitele sarcini consumă resurse în mod diferit și, în unele locuri, pot fi multe discuri locale, în altele, puțină memorie RAM și așa mai departe, deci, în funcție de tipul sarcinii, utilizarea resurselor va scădea.
Se dovedea că plătiți cu 10–15% mai mult pentru confortul configurării. Aceasta a generat mitul din titlu. Am căutat mult timp unde ar putea fi utilizată tehnologia optim, și am găsit. Problema era că Cisco nu avea propriile soluții de stocare, dar vroiau să acopere întreaga piață a serverelor. Și au creat Cisco Hyperflex – o soluție cu stocare locală pe noduri.
Și din aceasta a rezultat o soluție foarte bună pentru centrele de date de rezervă (Disaster Recovery). De ce și cum – voi explica acum. Și voi arăta teste ale clusterului.
Acolo unde este nevoie
Hiperconvergența este:
- Transferul discurilor în nodurile de calcul.
- Integrarea completă a subsistemului de stocare cu subsistemul de virtualizare.
- Transferul/integrarea cu subsistemul de rețea.
Această legătură permite implementarea multor funcții ale soluțiilor de stocare la nivelul virtualizării, totul dintr-o singură interfață de gestionare.
În compania noastră, proiectele de proiectare a centrelor de date de rezervă sunt foarte solicitate, iar soluțiile hiperconvergente sunt adesea alese datorită numeroaselor opțiuni de replicare (până la metrokluster) din cutie.
În cazul centrelor de date de rezervă, de obicei, ne referim la o locație îndepărtată situată la marginea orașului sau chiar într-un alt oraș. Aceasta permite restaurarea sistemelor critice în cazul unei defecțiuni parțiale sau complete a centrului de date principal. Datele sunt repliocate constant de la vânzare, iar această replicare poate fi efectuată la nivel de aplicație sau la nivel de dispozitiv de stocare (SDS).
Prin urmare, voi discuta acum despre structura sistemului și teste, iar apoi — despre câteva scenarii reale de aplicare cu date despre economii.
Teste
Instanța noastră constă din patru servere, fiecare având 10 SSD-uri de 960 GB. Există un disc dedicat pentru cache-ul operațiunilor de scriere și stocarea unei mașini virtuale de servicii. Soluția în sine este a patra versiune. Prima a fost evident nefinisată (conform recenziilor), a doua era încă puțin lipsită de rafinament, a treia este deja suficient de stabilă, iar aceasta poate fi considerată o versiune de lansare după încheierea testării beta pe scară largă. În timpul testării, nu am întâmpinat probleme, totul funcționează ca un ceas.
Modificări în v4O mulțime de erori au fost corectate.
Inițial, platforma putea lucra doar cu hypervisorul VMware ESXi și susținea un număr mic de noduri. De asemenea, procesul de implementare nu se încheia întotdeauna cu succes, trebuia să repornesc anumite etape, erau probleme cu actualizarea de la versiuni mai vechi, datele din GUI nu se afișau întotdeauna corect (deși nici acum nu sunt pe deplin mulțumit de afișarea graficelor de performanță), uneori apăreau probleme la interfața cu virtualizarea.
Acum toate problemele inițiale au fost corectate, HyperFlex suportă atât ESXi, cât și Hyper-V, plus că este posibil:
- Crearea unui cluster extins.
- Crearea unui cluster pentru birouri fără utilizarea Fabric Interconnect, de la două la patru noduri (cumpărăm doar serverele).
- Posibilitatea de a lucra cu SDS externe.
- Suport pentru containere și Kubernetes.
- Crearea zonelor de disponibilitate.
- Integrarea cu VMware SRM, dacă funcționalitatea încorporată nu este satisfăcătoare.
Arhitectura nu se deosebește mult de soluțiile principalelor competitori, nu s-a reinventat roata. Toate acestea funcționează pe platforma de virtualizare VMware sau Hyper-V. Tehnologia este implementată pe servere dezvoltate intern de Cisco UCS. Există persoane care urăsc platforma din cauza complexității inițiale a configurării, a numeroaselor butoane, a sistemului de șabloane și dependențe neintuitive, dar există și cei care au învățat să o aprecieze, s-au atașat de idee și nu mai doresc să lucreze cu alte servere.
Vom examina exact soluția pentru VMware, deoarece aceasta a fost dezvoltată inițial pentru acesta și oferă un funcționalitate mai mare, în timp ce Hyper-V a fost adaptat pe parcurs pentru a nu rămâne în urmă față de competitori și pentru a răspunde așteptărilor pieței.
Există un cluster de servere echipate cu discuri. Există discuri pentru stocarea datelor (SSD sau HDD — alegerea este a dumneavoastră, în funcție de necesități), plus un disc SSD pentru caching. Atunci când se scriu date pe datastore, acestea sunt salvate pe stratul de caching (disc SSD dedicat și RAM-ul mașinii virtuale de serviciu). În paralel, un bloc de date este trimis către nodurile din cluster (numărul de noduri depinde de factorul de replicare al clusterului). După confirmarea scrierii reușite de către toate nodurile, confirmarea este trimisă hiper-vizorului și mai departe către mașina virtuală. Datele scrise sunt deduplicat, compresate și stocate pe discurile de stocare în fundal. În acest mod, pe discurile de stocare se scrie întotdeauna un bloc mare de date, consecutiv, ceea ce reduce sarcina pe discurile de stocare.
Deduplicarea și compresia sunt activate constant și nu pot fi dezactivate. Citirea datelor se face direct de pe discurile de stocare sau din cache-ul RAM. Dacă se folosește o configurație hibridă, citirea este, de asemenea, stocată în cache pe discul SSD.
Datele nu sunt legate de locația actuală a mașinii virtuale și sunt distribuite uniform între noduri. Această abordare permite o încărcare uniformă a tuturor discurilor și interfețelor de rețea. Un dezavantaj evident este că nu putem minimiza la maxim întârzierea citirii, deoarece nu există nicio garanție că datele sunt disponibile local. Dar consider că este o renunțare nesemnificativă în comparație cu avantajele obținute. Mai ales că întârzierea în rețea a atins valori astfel încât să nu influențeze semnificativ rezultatul total.
Toată logica de funcționare a subsistemului de stocare este gestionată de o mașină virtuală de serviciu specială, Cisco HyperFlex Data Platform controller, care este creată pe fiecare nod de stocare. În configurația noastră, mașinii virtuale de serviciu i-au fost alocate opt vCPU și 72 GB RAM, ceea ce nu este deloc puțin. Amintesc că hostul are disponibili 28 de nuclee fizice și 512 GB RAM.
Mașina virtuală de serviciu are acces direct la discurile fizice prin intermediul controller-ului SAS. Comunicația cu hypervisorul se realizează printr-un modul special, IOVisor, care intercepta operațiile de intrare-ieșire, și printr-un agent care permite transmiterea comenzilor către API-ul hypervisorului. Agentul se ocupă de gestionarea snapshot-urilor și clonelor HyperFlex.
În hypervisor, resursele de disc sunt montate ca share-uri NFS sau SMB (în funcție de tipul hypervisorului, ghiciți care este care). Sub capotă, aceasta este un sistem de fișiere distribuit care permite adăugarea de funcționalități pentru sisteme de stocare complete: rezervarea fină a volumelor, comprimare și deduplicare, snapshot-uri prin tehnologia Redirect-on-Write, replicare sincronă/asincronă.
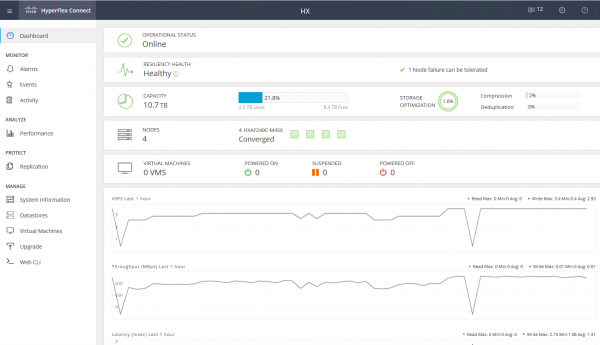
Mașina virtuală de serviciu oferă acces la interfața WEB de gestionare a subsistemului HyperFlex. Există integrare cu vCenter, iar cea mai mare parte a sarcinilor de zi cu zi pot fi realizate din acesta, dar datastor-urile, de exemplu, sunt mai ușor de gestionat dintr-o interfață web separată, dacă ați trecut deja la interfața rapidă HTML5, sau puteți folosi clientul Flash complet integrat. În interfața web de serviciu puteți verifica performanța și starea detaliată a sistemului.
Există și un alt tip de noduri în cluster — noduri de calcul. Acestea pot fi servere rack sau blade fără discuri încorporate. Pe aceste servere pot fi rulate mașini virtuale ale căror date sunt stocate pe serverele cu discuri. Din punct de vedere al accesului la date, nu există nicio diferență între tipurile de noduri, deoarece arhitectura presupune abstractizarea de la locația fizică a datelor. Raportul maxim între nodurile de calcul și nodurile de stocare este 2:1.
Utilizarea nodurilor de calcul crește flexibilitatea la scalarea resurselor cluster-ului: nu trebuie neapărat să achiziționăm noduri cu discuri dacă avem nevoie doar de CPU/RAM. În plus, putem adăuga un chassis blade și obține economii la amplasarea serverelor în rack.
Ca rezultat, avem o platformă hiperconvergentă cu următoarele caracteristici:
- Până la 64 de noduri în cluster (până la 32 de noduri de stocare).
- Numărul minim de noduri în cluster este de trei (două pentru clusterul Edge).
- Mecanism de redundanță a datelor: mirroring cu factor de replicare 2 și 3.
- Cluster Metro.
- Replicare asincronă a VM-urilor pe un alt cluster HyperFlex.
- Orchestrarea comutării VM-urilor în centrul de date remote.
- Instantanee native pe tehnologia Redirect-on-Write.
- Până la 1 PB de spațiu util cu factor de replicare 3 și fără a ține cont de deduplicare. Factorul de replicare 2 nu este luat în considerare, deoarece nu este o opțiune viabilă pentru vânzări serioase.
Un alt avantaj major este ușurința de gestionare și implementare. Toată complexitatea configurării serverelor UCS este preluată de o VM specializată, pregătită de inginerii Cisco.
Configurația bancului de testare:
- 2 x Cisco UCS Fabric Interconnect 6248UP ca cluster de control și componente de rețea (48 porturi, funcționând în mod Ethernet 10G/FC 16G).
- Patru servere Cisco UCS HXAF240 M4.
Specificațiile serverelor:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/rang dublu/x4/1.2v
Rețea
UCSC-MLOM-CSC-02 (VIC 1227). 2 porturi Ethernet 10G
HBA de stocare
Cisco 12G Modular SAS Pass through Controller
Discuri de stocare
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Mai multe opțiuni de configurațieÎn afară de hardware-ul ales, în prezent sunt disponibile următoarele opțiuni:
- HXAF240c M5.
- Unul sau două CPU începând de la Intel Silver 4110 până la Intel Platinum I8260Y. Este disponibilă a doua generație.
- 24 sloturi de memorie, module de la 16 GB RDIMM 2600 până la 128 GB LRDIMM 2933.
- De la 6 la 23 de discuri pentru date, un disc de cache, un disc sistem și un disc de boot.
Discuri de capacitate
- HX-SD960G61X-EV 960GB 2.5 inch Enterprise Value 6G SATA SSD (1X endurance) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X endurance) SAS 3.8 TB.
- Discuri de cache
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Perf. NVMe SSD (3X endurance) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Perf. 12G SAS SSD (10X endurance) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Perf. 12G SAS SED SSD (10X endurance) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise performance 12G SAS SSD (3X endurance).
Discuri de sistem / jurnal
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (Necesită actualizare).
Discuri de boot
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Conectare la rețea prin porturi Ethernet de 40G, 25G sau 10G.
Ca FI, pot fi utilizate HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Testul în sine
Pentru testarea subsistemului de discuri, am folosit HCIBench 2.2.1. Este o unealtă gratuită care permite automatizarea generării de sarcini din mai multe mașini virtuale. Sarcina este generată de fio obișnuit.
Clusterul nostru constă din patru noduri, factor de replicare 3, toate discurile Flash.
Pentru testare, am creat patru datastore-uri și opt mașini virtuale. Pentru teste de scriere, se consideră un scenariu în care discul de cache nu este supraîncărcat.
Rezultatele testelor sunt următoarele:
100 % Citire 100 % Aleatorie
0 % Citire 100% Aleatorie
Blocați / adâncimea cozii
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Valorile evidențiate cu caractere aldine sunt cele după care nu există creșteri de performanță, uneori existând chiar o degradare. Acest lucru se datorează faptului că suntem limitați de performanța rețelei / controlerelor / discurilor.
- Citire secvențială 4432 MB/s.
- Scriere secvențială 804 MB/s.
- În cazul defectării unui controler (defectarea unei mașini virtuale sau a gazdei), scăderea performanței este de două ori.
- În cazul defectării discului de stocare, scăderea este de 1/3. Rebuild-ul discului ocupă 5% din resursele fiecărui controler.
Pe un bloc mic, ne confruntăm cu performanța controlerului (mașina virtuală), CPU-ul său este încărcat la 100%, iar la creșterea blocului ne atingem de lățimea de bandă a porturilor. 10 Gbps nu sunt suficiente pentru a descoperi potențialul unui sistem AllFlash. Din păcate, nu ne permit parametrii demo-stand-ului să verificăm funcționarea la 40 Gbps.
Din impresiile mele din teste și studiul arhitecturii, datorită algoritmului care distribuie datele între toate gazdele, obținem performanță previzibilă și scalabilă, dar aceasta este și o limitare în citire, deoarece de pe discurile locale s-ar putea extrage mai mult; aici ar putea ajuta o rețea mai performantă, de exemplu, FI disponibile la 40 Gbps.
De asemenea, un singur disc pentru caching și deduplicare poate reprezenta o limitare; practic, în acest stand putem scrie pe patru SSD-uri. Ar fi excelent să avem posibilitatea de a crește numărul de discuri de cache și de a observa diferența.
Utilizare reală
Pentru organizarea unui centru de date de rezervă, se pot folosi două abordări (nu luăm în considerare plasarea backup-ului într-o locație externă):
- Active-Passive. Toate aplicațiile sunt găzduite în principalul data center. Replicarea este sincronă sau asincronă. În caz de cădere a principalului data center, trebuie să activăm backup-ul. Acest lucru se poate face manual, prin scripturi sau aplicații de orchestrare. Aici vom obține un RPO comparabil cu frecvența de replicare, iar RTO depinde de reacția și abilitățile administratorului, precum și de calitatea planului de failover.
- Active-Active. În acest caz există doar replicare sincronă, disponibilitatea data center-elor este determinată de quorum/arbitru, situat strict pe o a treia locație. RPO = 0, iar RTO poate ajunge la 0 (dacă aplicația permite) sau este egal cu timpul necesar pentru gestionarea eșecului nodului într-un cluster de virtualizare. La nivel de virtualizare, se creează un cluster extins (Metro), care necesită stocare Active-Active.
De obicei, vedem la clienți o arhitectură deja implementată cu stocare clasică în principalul data center, așa că proiectăm încă unul pentru replicare. Așa cum am menționat, Cisco HyperFlex oferă replicare asincronă și crearea unui cluster de virtualizare extins. În acest caz, nu avem nevoie de un sistem de stocare de tip Midrange sau superior, cu funcții costisitoare de replicare și acces Active-Active la date în două sisteme de stocare.
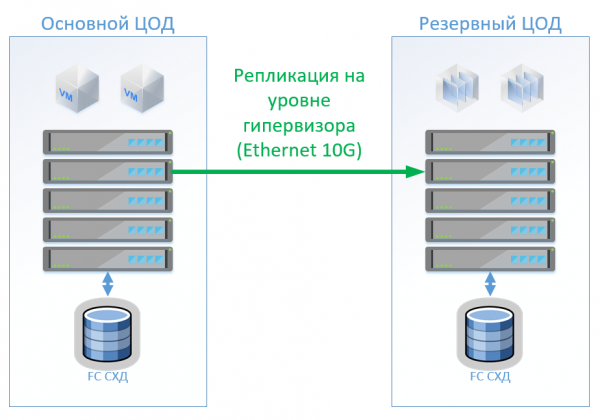
Scenariul 1: Avem un data center principal și unul de rezervă, platforma de virtualizare fiind bazată pe VMware vSphere. Toate sistemele productive se află în principalul data center, iar replicarea mașinilor virtuale se face la nivelul hypervisor-ului, ceea ce va permite ca VM-urile să nu fie menținute active în data center-ul de rezervă. Bazele de date și aplicațiile speciale sunt replicate prin instrumente integrate și menținem VM-urile active. În cazul unei căderi a principalului data center, activăm sistemele în data center-ul de rezervă. Considerăm că avem aproximativ 100 de mașini virtuale. Atâta timp cât principalul data center funcționează, în data center-ul de rezervă pot fi pornite medii de testare și alte sisteme, care pot fi oprite în cazul unei comutări a principalului data center. De asemenea, există varianta în care utilizăm replicare bidirecțională. Din punct de vedere hardware, nu se va schimba nimic.
În cazul arhitecturii clasice, vom instala în fiecare centru de date un sistem de stocare hibrid cu acces prin FibreChannel, tiering, deduplicare și compresie (dar nu online), 8 servere pentru fiecare locație, câte 2 switch-uri FibreChannel și Ethernet 10G. Pentru replicare și gestionarea comutării în arhitectura clasică putem folosi soluții VMware (Replication + SRM) sau soluții terțe care vor fi puțin mai ieftine și uneori mai convenabile.
Schema este prezentată în ilustratie.
În cazul utilizării Cisco HyperFlex, obținem următoarea arhitectură:
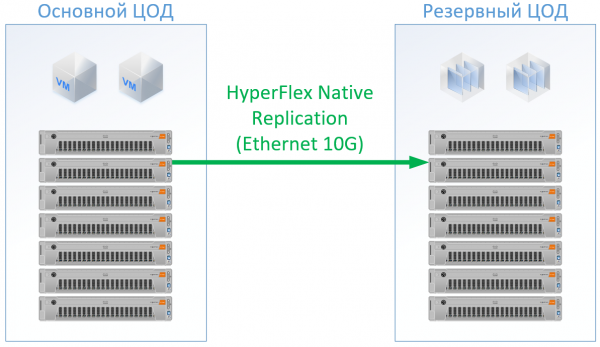
Pentru HyperFlex am folosit servere cu resurse mari CPU/RAM, deoarece o parte din resurse va fi utilizată pentru VM-ul controller-ului HyperFlex; pentru CPU și memorie am avut chiar și o rezervă în configurația HyperFlex, pentru a nu favoriza Cisco și a garanta resursele pentru celelalte VM-uri. Astfel, putem renunța la switch-urile FibreChannel, iar porturile Ethernet nu vor fi necesare pentru fiecare server, traficul local fiind comutat în interiorul FI.
În final, a rezultat următoarea configurație pentru fiecare centru de date:
Servere
8 x Server 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Sisteme de stocare
Sistem de stocare hibrid cu FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x switch Ethernet 10G cu 12 porturi
—
SAN
2 x switch FC 32/16Gb cu 24 porturi
2 x Cisco UCS FI 6332
Licențe
VMware Ent Plus
Replicare și/sau orchestrare a comutării VM
VMware Ent Plus
Pentru HyperFlex nu am inclus licențele pentru software de replicare, deoarece este disponibil din start.
Pentru arhitectura clasică am ales un furnizor care s-a dovedit a fi un producător de calitate și accesibil. Pentru ambele opțiuni am aplicat discountul standard pentru soluția specifică, la final am obținut prețurile reale.
Soluția pe Cisco HyperFlex a rezultat cu 13% mai ieftină.
Scenariul 2: crearea a două centre de date active. În acest scenariu, proiectăm un cluster extins pe VMware.
Arhitectura clasică constă din servere de virtualizare, SAN (protocol FC) și două sisteme de stocare, care pot citi și scrie date într-un mod extins între ele. Pe fiecare sistem de stocare alocăm capacitate utilă pentru locație.
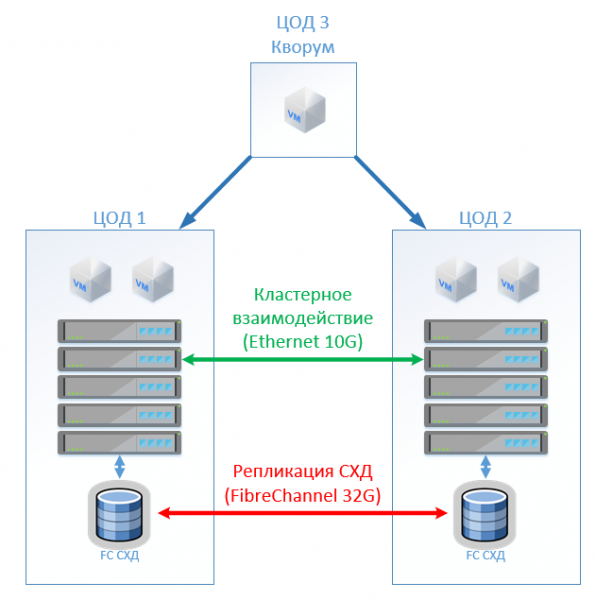
Pentru HyperFlex pur și simplu creăm un Stretch Cluster cu același număr de noduri pe ambele locații. În acest caz, se utilizează un factor de replicare de 2+2.
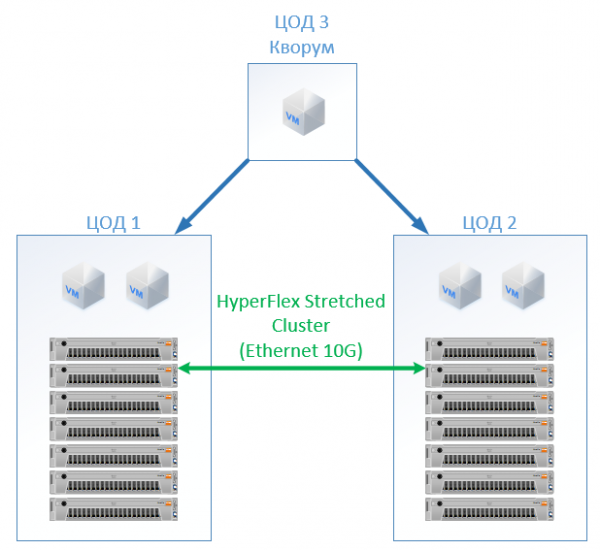
Rezultatul este următoarea configurație:
Arhitectura clasică
HyperFlex
Servere
16 x Server 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Sisteme de stocare
2 x Sisteme de stocare AllFlash (150 TB SSD)
—
LAN
4 x switch Ethernet 10G cu 24 porturi
—
SAN
4 x switch FC 32/16Gb cu 24 porturi
4 x Cisco UCS FI 6332
Licențe
VMware Ent Plus
VMware Ent Plus
În toate calculele, nu am luat în considerare infrastructura de rețea, costurile pentru centru de date etc.: acestea vor fi aceleași atât pentru arhitectura clasică, cât și pentru soluția HyperFlex.
Soluția HyperFlex a fost cu 5% mai scumpă. Merită menționat că, în ceea ce privește resursele CPU/RAM, la Cisco am avut o disproporție, deoarece în configurație am umplut canalele controlerelor de memorie uniform. Costul este puțin mai mare, dar nu cu mult, ceea ce indică clar că hiperconvergența nu este neapărat o «jucărie pentru bogați», ci poate concura cu abordarea standard de construire a datacentrelor. De asemenea, aceasta poate fi interesantă celor care au deja servere Cisco UCS și infrastructura corespunzătoare pentru acestea.
Printre avantajele pe care le obținem se numără absența costurilor administrative pentru SAN și stocare, compresie online și deduplicare, un punct unic de contact pentru suport (virtualizare, servere, acestea sunt și soluția de stocare), economisirea de spațiu (dar nu în toate scenariile), simplificarea exploatării.
În ceea ce privește suportul, îl primiți de la un singur furnizor — Cisco. Dacă judecăm după experiența avută cu serverele Cisco UCS, îmi place, la HyperFlex nu a fost nevoie să deschid, totul a funcționat bine. Inginerii răspund rapid și pot rezolva nu doar problemele standard, ci și cazuri complexe. Uneori, îi întreb: «Se poate face așa, să se conecteze asta?» sau «Am configurat ceva și nu vrea să funcționeze. Ajutați-mă!» — ei găsesc cu răbdare ghidul necesar și indică acțiunile corecte, nu vor răspunde: «Noi rezolvăm doar problemele hardware».
Linkuri
- Emailul meu — StGeneralov@croc.ru
Sursa: habr.com
