

Pavel Selivanov, arhitect de soluții Southbridge și profesor la Slyorm, a susținut o prezentare la DevOpsConf 2019. Această prezentare face parte dintr-unul dintre temele cursului aprofundat despre Kubernetes „Slyorm Mega”.
se desfășoară la Moscova între 18-20 noiembrie.
— Moscova, 22-24 noiembrie.
sunt disponibile în permanență.
Sub acest articol — transcrierea prezentării.
Bună ziua, colegi și susținători. Astăzi voi vorbi despre securitate.
Văd că în sală sunt mulți specialiști în securitate. Îmi cer scuze anticipat dacă termenii din domeniul securității nu-i voi folosi exact cum este uzual.
Așa s-a întâmplat, că acum aproximativ jumătate de an am avut în mână un cluster Kubernetes public. Public înseamnă că are un anumit număr de namespaces, în aceste namespaces sunt utilizatori, izolați în propriul lor namespace. Toți acești utilizatori aparțin unor companii diferite. Şi se presupunea că acest cluster ar trebui folosit ca CDN. Adică vă este oferit un cluster, se crează un utilizator pentru el, veniți în namespace-ul vostru și desfășurați frontend-urile voastre.
Compania mea anterioară a încercat să vândă un astfel de serviciu. Și am fost rugat să verific cluster-ul pentru a vedea dacă o astfel de soluție se potrivește.
Am ajuns în acest cluster. Mi s-au oferit drepturi limitate, un namespace limitat. Acolo oamenii înțelegeau ce înseamnă securitate. Au citit despre controlul accesului bazat pe roluri (RBAC) din Kubernetes — și l-au implementat așa, încât nu puteam lansa pod-uri separat de deployment-uri. Nu-mi amintesc ce problemă încercam să rezolv lancând un pod fără deployment, dar mi-a plăcut foarte mult să lansez pur și simplu un pod. Am decis să verific ce drepturi am în cluster, ce pot și ce nu pot, ce au configurat acolo. De asemenea, voi spune ce au configurat greșit în RBAC.
Așa s-a întâmplat că în două minute am devenit admin al cluster-ului lor, am verificat toate namespaces-urile vecine și am observat frontend-uri de producție ale companiilor care au cumpărat deja serviciul și s-au desfășurat. M-am oprit cu greu să nu merg la cineva în frontend și să plasez un cuvânt obscen pe pagina principală.
Voi ilustra prin exemple cum am făcut asta și cum ar trebui să ne apărăm de astfel de situații.
Dar mai întâi, permiteți-mi să mă prezint. Numele meu este Pavel Selivanov. Sunt arhitect la compania Southbridge. Mă pricep la Kubernetes, DevOps și la tot felul de tehnologii moderne. Împreună cu inginerii Southbridge, construit tot acest sistem, iar eu ofer consultanță.
În afară de activitatea principală, recent am lansat proiecte numite Slerme. Încercăm să aducem abilitățile noastre în lucrul cu Kubernetes în rândul publicului larg, învățând și pe alții să folosească K8s.
Despre ce voi vorbi astăzi. Tema prezentării este evidentă – despre securitatea clusterului Kubernetes. Dar trebuie să spun de la bun început că acest subiect este foarte amplu – și din acest motiv trebuie să clarific despre ce nu voi vorbi. Nu voi aborda termeni uzitați, care au fost deja răscoliti de o sută de ori pe internet. Tot felul de RBAC și certificate.
Voi vorbi despre problemele de securitate pe care le observ eu și colegii mei în clusterul Kubernetes. Vedem aceste probleme atât la furnizorii care oferă clustere Kubernetes, cât și la clienții care ne vizitează. Și chiar și la clienți care vin la noi de la alte companii de consultanță administrative. Deci, amploarea tragediei este, de fapt, foarte mare.
În mod concret, voi discuta despre trei puncte astăzi:
- Drepturile utilizatorilor vs drepturile pod-urilor. Drepturile utilizatorilor și drepturile pod-urilor nu sunt același lucru.
- Colectarea informațiilor despre cluster. Voi arăta că, din cluster, putem colecta toate informațiile necesare fără a avea drepturi speciale în acel cluster.
- Atac DoS asupra cluster-ului. Dacă nu putem colecta informații, putem totuși provoca prăbușirea cluster-ului. Voi vorbi despre atacurile DoS asupra elementelor de control ale cluster-ului.
Încă un aspect general despre care voi menționa – pe ce am testat toate acestea și pe ce pot spune cu certitudine că funcționează.
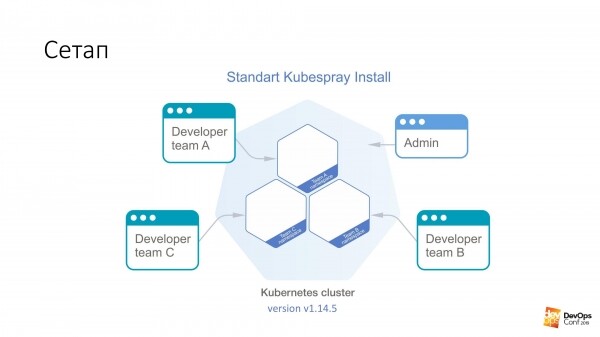
Ne bazăm pe instalarea cluster-ului Kubernetes folosind Kubespray. Dacă cineva nu știe, aceasta este practic o colecție de roluri pentru Ansible. O folosim constant în muncă. Este bună deoarece poate fi aplicată oriunde – atât pe echipamente fizice, cât și în cloud. O singură metodă de instalare este, în principiu, potrivită pentru toate.
În acest cluster, voi avea Kubernetes v1.14.5. Întregul cluster Kubernetes, despre care vom vorbi, este împărțit în namespace-uri, fiecare namespace aparține unei echipe separate, iar membrii acestei echipe au acces în fiecare namespace. Nu au voie să acceseze namespace-uri diferite, doar pe al lor. Dar există un cont de administrator, care are drepturi asupra întregului cluster.
Am promis că primul lucru pe care îl vom face va fi obținerea drepturilor de administrator asupra cluster-ului. Avem nevoie de un pod special pregătit, care va compromite cluster-ul Kubernetes. Tot ce trebuie să facem este să-l aplicăm în cluster-ul Kubernetes.
kubectl apply -f pod.yamlAcest pod va ajunge pe unul dintre masterele cluster-ului Kubernetes. Iar cluster-ul ne va returna după aceea un fișier numit admin.conf. În acest fișier se află toate certificatele administratorului și, în plus, este configurat API-ul cluster-ului. Așa de simplu putem obține acces de administrator, cred că la 98% din cluster-urile Kubernetes.
Reiterez, acest pod a fost creat de un dezvoltator din cluster-ul vostru, care are acces să implementeze propunerile sale într-un mic namespace, fiind complet restricționat de RBAC. Nu avea niciun drept. Dar, cu toate acestea, certificatul a fost returnat.
Acum despre podul special pregătit. Îl lansăm pe o imagine oricare. Ca exemplu, să luăm debian:jessie.
Avem așa ceva:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Ce este tolerația? Masterele din cluster-ul Kubernetes sunt de obicei marcate cu ceva numit taint. Și esența acestei „zgarieturi” este că nu se pot aloca poduri pe nodurile master. Dar nimeni nu împiedică un pod să declare că este tolerant la „zgarieturi”. Secțiunea Tolerations arată exact că, dacă pe un nod este setat NoSchedule, atunci podul nostru este tolerant la această „zgarietură” — și nu sunt probleme.
Mai departe, spunem că podul nostru nu este doar tolerant, ci și că vrea să ajungă în mod special pe master. Deoarece pe mastere se află cele mai importante lucruri de care avem nevoie — toate certificatele. De aceea, spunem nodeSelector — și avem un label standard pe mastere, care permite selectarea nodurilor care sunt mastere din toate nodurile cluster-ului.
Cu aceste două secțiuni, podul va ajunge cu siguranță pe master. Și i se va permite să rămână acolo.
Dar a ajunge pe master nu este suficient. Nu ne va ajuta cu nimic. De aceea, avem două lucruri de ansamblu:
hostNetwork: true
hostPID: true
Specificăm că pod-ul nostru, pe care îl vom rula, va trăi în namespace-ul kernel, în network namespace și în PID namespace. Odată ce pod-ul pornește pe master, acesta va putea vedea toate interfețele reale, active ale acestei noduri, va asculta tot traficul și va vedea PID-urile tuturor proceselor.
Apoi, este simplu. Luați etcd și citiți ce doriți.
Cea mai interesantă este această capacitate Kubernetes, care este implicită acolo.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Și esența sa este că putem în pod-ul pe care îl rulăm, chiar și fără drepturi pe acest cluster, să spunem că vrem să creăm un volum de tip hostPath. Adică să luăm calea de pe gazdă, pe care ne vom rula — și să o folosim ca volum. Și ulterior îl numim name: host. Întreg acest hostPath îl montăm în interiorul pod-ului. În acest exemplu în directorul /host.
Reiterăm. Am spus pod-ului să vină pe master, să obțină acolo hostNetwork și hostPID — și să monteze întregul root al master-ului în acest pod.
Înțelegi că în Debian avem bash-ul pornit, și acest bash funcționează sub root. Asta înseamnă că tocmai am obținut root pe master, fără a avea vreo autoritate în cluster-ul Kubernetes.
Apoi, toată sarcina este să intri în pod în directorul /host /etc/kubernetes/pki, dacă nu mă înșel, și să iei toate certificatele master-ului din cluster și, prin urmare, să devii administratorul cluster-ului.
Dacă stăm să ne uităm, acestea sunt unele dintre cele mai periculoase drepturi în pod-uri — indiferent de drepturile utilizatorului:
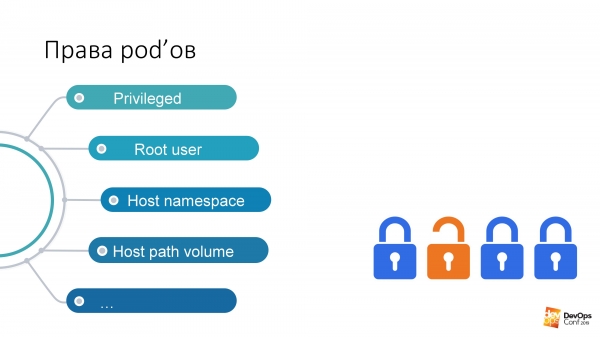
Dacă am dreptul să pornesc un pod într-un anumit namespace al cluster-ului, atunci acest pod are acele drepturi implicit. Pot rula pod-uri privilegiate, ceea ce înseamnă practic toate drepturile, aproape root pe nod.
Favoritul meu — utilizatorul Root. Și Kubernetes are această opțiune Run As Non-Root. Este o formă de protecție împotriva hackerului. Știți ce este un "virus moldovenesc"? Dacă ești hacker și ai intrat în cluster-ul meu Kubernetes, atunci noi, săracii administratori, cerem: „Vă rugăm, specificați în pod-urile dvs. cu care veți hack-ui cluster-ul meu, să rulați ca non-root. Altfel, ar putea să se întâmple că veți porni un proces în pod-ul dvs. sub root, iar astfel va fi foarte simplu să mă hack-uiți. Protejați-vă, vă rugăm, singuri.”
Host path volume — din punctul meu de vedere, este cea mai rapidă modalitate de a obține rezultatul dorit de la cluster-ul Kubernetes.
Dar ce să facem cu toate acestea?
Gânduri care ar trebui să vină oricărui administrator normal care se confruntă cu Kubernetes: „Aha, am spus eu, Kubernetes nu funcționează. Are slăbiciuni. Tot Kubernetesul e o prostie”. De fapt, există un lucru numit documentație, iar dacă privești acolo, există o secțiune .
Acesta este un obiect yaml - pe care îl putem crea în clusterul Kubernetes - care controlează aspectele de securitate în descrierea pod-urilor. Practic, el controlează drepturile de utilizare a diferitelor hostNetwork, hostPID, anumite tipuri de volume care există în pod-uri la lansare. Cu ajutorul Politicii de Securitate a Pod-urilor, toate acestea pot fi descrise.
Cel mai interesant în Politica de Securitate a Pod-urilor este că în clusterul Kubernetes, toate instanțele PSP nu sunt descrise în niciun fel și sunt dezactivate din start. Politica de Securitate a Pod-urilor se activează printr-un plugin de admitere.
Ok, să implementăm Politica de Securitate a Pod-urilor în cluster, să spunem că avem anumite pod-uri de serviciu în namespace, la care au acces doar administratorii. Să spunem că în rest, pod-urile au drepturi limitate. Probabil că dezvoltatorilor nu le-ar trebui să ruleze pod-uri privilegiate în clusterul vostru.
Și părea că totul este în regulă. Și clusterul nostru Kubernetes nu poate fi spart în două minute.
Există o problemă. Probabil că, dacă aveți un cluster Kubernetes, atunci în clusterul vostru este instalat un sistem de monitorizare. Mă aventurez să prevăd că, dacă în clusterul voastre există monitorizare, acesta se numește Prometheus.
Ceea ce voi povesti acum va fi valabil atât pentru operatorul Prometheus, cât și pentru Prometheus instalat în mod curat. Problema este că, dacă nu pot obține rapid un administrator în cluster, atunci asta înseamnă că trebuie să caut mai mult. Și pot căuta cu ajutorul monitorizării voastre.
Probabil că toată lumea a citit aceleași articole pe Habr și monitorizarea se află în namespace-ul monitoring. Helm chart-urile tuturor se numesc aproximativ la fel. Mă aștept ca, dacă faceți helm install stable/prometheus, veți obține nume aproximativ identice. Și cel mai probabil, nu va trebui să ghicesc numele DNS în clusterul vostru. Pentru că este standard.
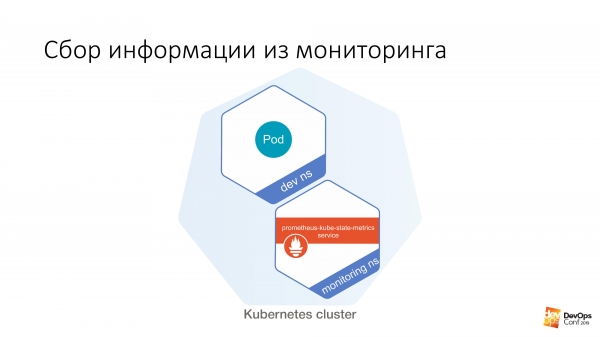
Mai departe, avem un anumit namespace de dev, în care putem lansa un anumit pod. Și apoi, din acest pod, este foarte ușor să facem așa:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics este unul dintre exportatorii Prometheus, care colectează metrici din API-ul Kubernetes-ului. Există multe date despre ceea ce este activ în clusterul dvs., ce este și ce probleme aveți cu acesta.
Ca un exemplu simplu:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Făcând o solicitare curl simplă dintr-un pod neprivilegiat, puteți obține astfel de informații. Dacă nu știți ce versiune de Kubernetes aveți, acesta vă va spune cu ușurință.
Și cel mai interesant este că, pe lângă faptul că vă adresați kube-state-metrics, puteți să vă adresați, la fel de bine, și direct lui Prometheus. Puteți aduna metrici de acolo. Chiar puteți construi metrici de acolo. Teoretic, chiar puteți construi o astfel de solicitare din cluster către Prometheus, care pur și simplu îl va opri. Și monitorizarea dvs. va înceta complet să funcționeze în cluster.
Și aici se pune întrebarea dacă un anumit monitor extern vă monitorizează monitorizarea. Tocmai am obținut posibilitatea de a acționa în clusterul Kubernetes fără consecințe pentru mine. Chiar nu veți afla că eu acționez acolo, deoarece monitorizarea nu mai există.
La fel ca și cu PSP, există senzația că problema este că toate aceste tehnologii moderne — Kubernetes, Prometheus — pur și simplu nu funcționează și sunt pline de breșe. De fapt, nu este așa.
Există ceva numit — .
Dacă sunteți un administrator obișnuit, probabil știți despre Network Policy, că este un alt yaml, care în cluster există într-un număr mare. Și Network Policies nu sunt cu siguranță necesare. Chiar dacă ați citit ceea ce este Network Policy, că este un firewall yaml al Kubernetes-ului, care permite restricționarea accesului între namespace-uri, între pod-uri, cu siguranță ați decis că un firewall în format yaml în Kubernetes este doar o altă abstracție… Nu, nu este deloc necesar.
Chiar dacă experții dvs. în securitate nu au fost informați că cu ajutorul Kubernetes-ului se poate construi foarte ușor un firewall, și anume unul foarte granular. Dacă încă nu știu acest lucru și nu vă trag de mânecă: „Hai, dă-ne...”. Totuși, în orice caz, aveți nevoie de Network Policy pentru a restricționa accesul la anumite locații de serviciu, care pot fi accesate din clusterul dvs., fără a avea vreo autorizare.
Așa cum am menționat în exemplul meu, se poate accesa kube state metrics din orice namespace din clusterul Kubernetes, fără a avea nimic de spus. Politicile de rețea au restricționat accesul din toate celelalte namespace-uri către namespace-ul de monitorizare și cam asta e: fără acces, fără probleme. În toate diagrama pe care le avem, atât pentru Prometheus standard, cât și pentru cel care se află în operator, există pur și simplu în values de helm o opțiune de a activa politicile de rețea pentru ele. Trebuie doar să le activați, iar ele vor funcționa.
Aici există, totuși, o problemă. Fiind un administrator competent, probabil că ați decis că politicile de rețea nu sunt necesare. Și citind diverse articole pe resurse precum Habr, ați ajuns la concluzia că flannel, în special în modul host-gateway — este cea mai bună alegere pe care o puteți face.
Ce să fac?
Puteți încerca să redeployați soluția de rețea care se află în clusterul dvs. Kubernetes, să încercați să o înlocuiți cu ceva mai funcțional. De exemplu, cu Calico. Dar vreau să spun imediat, sarcina de a schimba soluția de rețea într-un cluster Kubernetes activ — este destul de complicată. Eu am rezolvat-o de două ori (ambele ori, de altfel, teoretic), dar chiar și la Slyrms am arătat cum să facem acest lucru. Le-am arătat celor care se învață cum să schimbe soluția de rețea în clusterul Kubernetes. În principiu, puteți încerca să faceți astfel încât să nu existe timp de nefuncționare în clusterul de producție. Dar probabil că nu veți reuși.
Și problema, de fapt, se rezolvă foarte simplu. În cluster există certificate, și știți că aceste certificate vor expira în decurs de un an. Ei bine, de obicei, soluția normală pentru certificate în cluster este — de ce ne-am stresa, ridicăm un nou cluster lângă cel vechi, iar în cel vechi să expire, și apoi redeployăm totul. Dar, când va expira, va fi o zi în care totul va sta, dar măcar avem un nou cluster.
Când veți ridica un nou cluster, nu uitați să includeți Calico în loc de flannel.
Ce să faci dacă ai certificate emise pe o sută de ani și nu intenționezi să redeploiezi clusterul? Există un instrument numit Kube-RBAC-Proxy. Este o dezvoltare foarte interesantă, care permite să te integrezi ca un container sidecar în orice pod din clusterul Kubernetes. Aceasta adaugă, de fapt, autorizare prin RBAC-ul propriu al Kubernetes acestui pod.
Există o problemă. Anterior, acest instrument Kube-RBAC-Proxy era integrat în operatorul Prometheus. Dar nu mai există. Acum, versiunile moderne se bazează pe faptul că ai o politică de rețea și le închizi prin intermediul acestora. Așadar, va trebui să rescrii puțin chart-ul. De fapt, dacă intri în , acolo sunt exemple despre cum să-l folosești ca sidecars, și chart-urile vor trebui rescrise minim.
Există și o altă problemă mică. Nu doar Prometheus își oferă metricile oricui. Toate componentele clusterului Kubernetes știu de asemenea să-și ofere metricile.
Dar, așa cum am spus, dacă nu poți accesa clusterul și aduna informații, cel puțin poți provoca daune.
Așa că vă voi arăta rapid două moduri în care poți afecta sănătatea unui cluster Kubernetes.
Veți râde când o voi povesti, sunt două cazuri din viața reală.
Primul mod. Epuizarea resurselor.
Lansăm încă un pod special. Acesta va avea următoarea secțiune.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Așa cum știți, requests reprezintă cantitatea de CPU și memorie rezervată pe host pentru anumite poduri cu cereri. Dacă avem un host cu patru nuclee în clusterul Kubernetes și un pod cu cereri de patru CPU îi vine, atunci nu va mai putea veni alt pod cu cereri pe acest host.
Dacă voi lansa un astfel de pod, apoi voi da comanda:
$ kubectl scale special-pod --replicas=...Atunci nimeni altcineva nu va putea să se deploy-eze în clusterul Kubernetes. Deoarece pe toate nodurile vor termina cererile. Astfel, eu voi opri clusterul vostru Kubernetes. Dacă fac asta seara, atunci deploy-urile pot fi oprite destul de mult timp.
Dacă privim din nou documentația Kubernetes, vom observa un element denumit Limit Range. Acesta stabilește resursele pentru obiectele din cluster. Puteți scrie un obiect Limit Range în yaml, să-l aplicați în anumite spații de nume — și mai departe în acest spațiu de nume puteți spune că aveți resurse pentru module care sunt implicite, maxime și minime.
Folosind un astfel de mecanism, putem restricționa utilizatorii în anumite spații de nume de produse în ceea ce privește posibilitatea de a specifica resurse inadecvate pentru modulele lor. Dar, din păcate, chiar dacă îi spuneți utilizatorului că nu poate rula module cu cereri mai mari de un CPU, există o comandă minunată numită scale, sau pot face scaling prin dashboard.
Și de aici decurge metoda numărul doi. Rulăm 11 111 111 111 111 module. Aceasta reprezintă unsprezece miliarde. Nu este deoarece am inventat eu un astfel de număr, ci pentru că am văzut cu ochii mei.
O poveste reală. Seara târziu, mă pregăteam să plec din birou. Am observat în colț o grupă de dezvoltatori care făceau ceva frenetic cu laptopurile. M-am apropiat de ei și i-am întrebat: „Ce s-a întâmplat?”
Cu puțin timp înainte, în jurul orei nouă seara, unul dintre dezvoltatori se pregătea să plece acasă. Și a decis: „Voi scala acum aplicația mea la un singur modul.” A apăsat pe „1”, iar internetul s-a încetinit puțin. A mai apăsat o dată pe „1”, a apăsat din nou pe „1”, a dat clic pe Enter. A încercat tot ce a putut. Apoi internetul și-a revenit — și totul a început să se scaleze la acel număr.
Adevărul este că această poveste nu se desfășura pe Kubernetes, ci pe Nomad în acel moment. S-a finalizat cu faptul că după o oră de încercări de a opri Nomad de la insistențele sale de scalare, Nomad a răspuns că nu se va opri din scalare și nu va face nimic altceva. „Sunt obosit, plec.” și s-a retras.
Desigur, am încercat să fac același lucru pe Kubernetes. Unsprezece miliarde de module nu l-au încântat pe Kubernetes, care a spus: „Nu pot. Depășește capele interne.” Însă 1 000 000 000 de module a reușit.
În răspuns la un miliard de poduri, Kubernetes nu a fost afectat. A început cu adevărat să scaleze. Cu cât procesul avansa, cu atât mai mult timp era necesar pentru a crea noi poduri. Totuși, procesul continua. Problema unică este că, dacă pot rula poduri nelimitat în spațiul meu de nume, chiar și fără limite de solicitare și limitări, pot să lansez atât de multe poduri cu sarcini, încât nodurile vor începe să sufere din cauza memoriei și a CPU-ului. Atunci când lansez atât de multe poduri, informația din acestea trebuie să ajungă în stocare, adică etcd. Iar când prea multe informații ajung acolo, stocarea începe să răspundă mult mai încet – și Kubernetes începe să aibă probleme de performanță.
Și mai există o problemă... Așa cum știți, componentele de control ale Kubernetes nu sunt un singur element central, ci mai multe componente. Printre acestea se află managerul de control, scheduler-ul și așa mai departe. Toate aceste componente vor începe să execute simultan o muncă inutilă și confuză, care, în timp, va începe să ocupe din ce în ce mai mult timp. Managerul de control va crea noi poduri. Scheduler-ul va încerca să găsească o nouă nodă pentru acestea. Noile noduri din clusterul dvs. se vor epuiza foarte curând. Clusterul Kubernetes va începe să funcționeze din ce în ce mai lent.
Dar am decis să merg și mai departe. Așa cum știți, în Kubernetes există ceva numit serviciu. De obicei, în cluster-urile dvs., serviciul funcționează prin intermediul ip tables.
Dacă lansezi un miliard de poduri, de exemplu, și apoi, cu ajutorul unui script, forțezi Kubernetes să creeze noi servicii:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Pe toate nodurile din cluster, aproximativ simultan, vor fi generate din ce în ce mai multe reguli iptables. În plus, pentru fiecare serviciu vor fi generate un miliard de reguli iptables.
Am testat totul pe câteva mii, până la o zecime. Și problema este că, deja la acest prag, conectarea SSH la nod devine destul de problematică. Deoarece pachetele, trecând printr-un astfel de număr de lanțuri, încep să aibă dificultăți.
Și asta se rezolvă tot cu ajutorul Kubernetes. Este unul dintre obiectele Resource quota. Acesta stabilește cantitatea de resurse și obiecte disponibile pentru namespace-ul din cluster. Putem crea un obiect yaml în fiecare namespace al cluster-ului Kubernetes. Cu ajutorul acestui obiect, putem specifica că pentru acest namespace sunt alocate un anumit număr de cereri, limite și apoi putem spune că în acest namespace pot fi create 10 servicii și 10 pod-uri. Iar dezvoltatorul nu poate depăși aceste limite. Kubernetes îi va spune: „Nu poți scala pod-urile tale până la acest număr, deoarece depășește cota de resurse”. Asta e, problema s-a rezolvat. .
O problemă problematică legată de acest lucru apare. Simțiți cât de greu devine să creați un namespace în Kubernetes. Pentru a-l crea, trebuie să ținem cont de o mulțime de lucruri.
Resource quota + Limit Range + RBAC
• Creăm un namespace
• Creăm în interior limitrange
• Creăm în interior resourcequota
• Creăm un serviceaccount pentru CI
• Creăm rolebinding pentru CI și utilizatori
• Opțional, lansăm pod-urile de servicii necesare
Așa că, profitând de ocazie, aș dori să împărtășesc dezvoltările mele. Există o unealtă numită operator SDK. Este un mod de a scrie operatori în cluster-ul Kubernetes. Puteți scrie operatori folosind Ansible.
Inițial a fost scris în Ansible, iar apoi am observat că există operator SDK și am rescris rolul Ansible în operator. Acest operator permite crearea într-un cluster Kubernetes a unui obiect numit comandă. În interiorul comenzii permite descrierea mediului în format yaml pentru această comandă. Și în interiorul mediului comenzii permite descrierea resurselor alocate.
Mic .
Și în concluzie, ce să facem cu toate acestea?
În primul rând. Pod Security Policy - este o idee bună. Și deși niciunul dintre instalatorii Kubernetes nu le folosește până în prezent, totuși trebuie să le folosiți în clusterele voastre.
Network Policy - aceasta nu este o altă caracteristică inutilă. Este ceva ce este cu adevărat necesar în cluster.
LimitRange/ResourceQuota - ar fi timpul să le folosiți. Noi am început să le folosim de mult timp și am crezut mult timp că toți le aplică. Se pare că este o raritate.
În afară de ceea ce am menționat în prezentare, există caracteristici nedocumentate care permit atacarea clusterului. Recent a fost publicată .
Unele lucruri sunt atât de triste și frustrante. De exemplu, în anumite condiții, kubeletele din clusterul Kubernetes pot expune conținutul directorului warlocks, chiar și utilizatorilor neautorizati.
există instrucțiuni despre cum să reproduceți tot ce am discutat. Sunt fișiere cu exemple din producție, cum ar fi cum arată ResourceQuota și Pod Security Policy. Și toate acestea pot fi testate.
Mulțumesc tuturor.
Sursa: habr.com
