

Salut, Habr!
După sărbătorile de Anul Nou, am relansat serviciul de cloud cu reziliență la dezastre pe baza a două locații. Astăzi vă vom arăta cum este organizat și ce se întâmplă cu mașinile virtuale ale clienților în cazul eșecului unor elemente ale clusterului și al căderii întregii locații (spoiler - totul este în regulă cu ele).
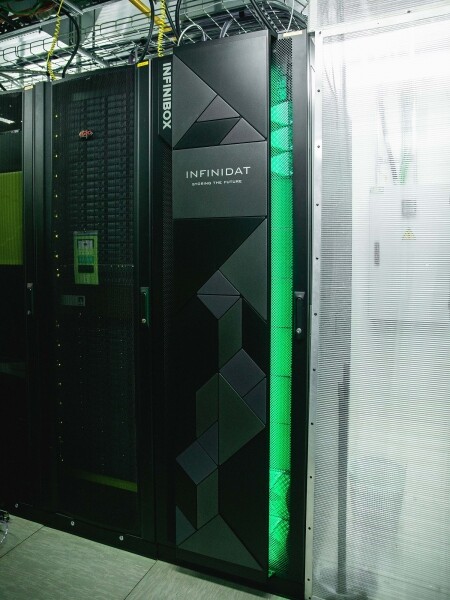
Sistemul de stocare a datelor pentru cloudul cu reziliență la dezastre pe locația OST.
Ce este în interior
Sub capotă se află servere Cisco UCS cu hipervizor VMware ESXi, două sisteme de stocare INFINIDAT InfiniBox F2240, echipament de rețea Cisco Nexus, dar și switch-uri SAN Brocade. Clusterul este distribuit pe două locații - OST și NORD, adică, în fiecare centru de date se află un set identic de echipamente. Acest lucru îi conferă reziliența la dezastre.
În cadrul unei locații, elementele principale sunt, de asemenea, duplicate (gazde, switch-uri SAN, rețea).
Cele două locații sunt conectate prin trasee de fibră optică dedicate, care sunt, de asemenea, rezervate.
Câteva cuvinte despre sistemele de stocare. Prima variantă a cloudului cu reziliență la dezastre a fost construită pe NetApp. Aici am ales INFINIDAT, și iată de ce:
- Opțiunea de replicare Active-Active. Aceasta permite mașinii virtuale să rămână funcțională chiar și în cazul unei căderi totale a uneia dintre sistemele de stocare. Voi detalia replicarea mai târziu.
- Trei controlere de discuri pentru creșterea rezilienței sistemului. De obicei, au fost două.
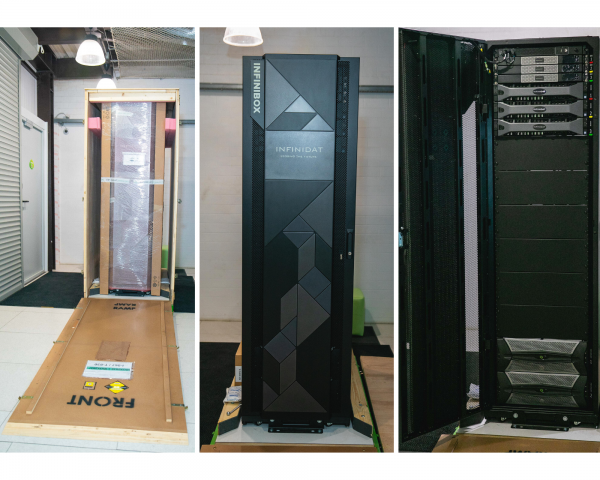
- O soluție completă. O rack deja asamblată a sosit la noi, care trebuie doar să fie conectată la rețea și configurată.
- Asistență tehnică atentă. Inginerii INFINIDAT analizează constant jurnalele și evenimentele sistemelor de stocare, instalează noi versiuni de firmware, ajută cu configurarea.
Iată câteva fotografii de la unpacking:
Cum funcționează
Cloudul deja este rezilient în interiorul său. Acesta protejează clientul de defecțiuni hardware și software individuale. Cloudul cu reziliență la dezastre va ajuta la protejarea împotriva unor defecțiuni masive într-o singură locație: de exemplu, eșecul unui sistem de stocare (sau al clusterului SDS, lucru care se întâmplă frecvent 🙂), erori masive în rețeaua de stocare și altele. Și cel mai important: un astfel de cloud salvează atunci când întreaga locație devine indisponibilă din cauza unui incendiu, blackout, atac de tip raider, invazie extraterestră.
În toate aceste cazuri, mașinile virtuale ale clienților continuă să funcționeze, și iată de ce.
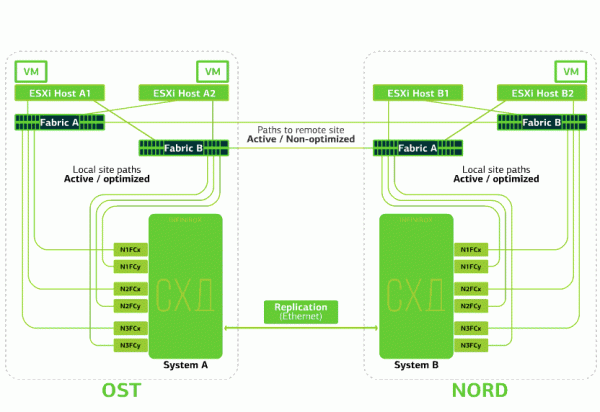
Schema clusterului este organizată astfel încât orice gazdă ESXi cu mașini virtuale client poate accesa oricare dintre cele două stocări SĂD. Dacă SĂD-ul de pe locația OST se defectează, mașinile virtuale vor continua să funcționeze: gazdele pe care acestea rulează vor accesa datele de pe SĂD-ul de la NORD.
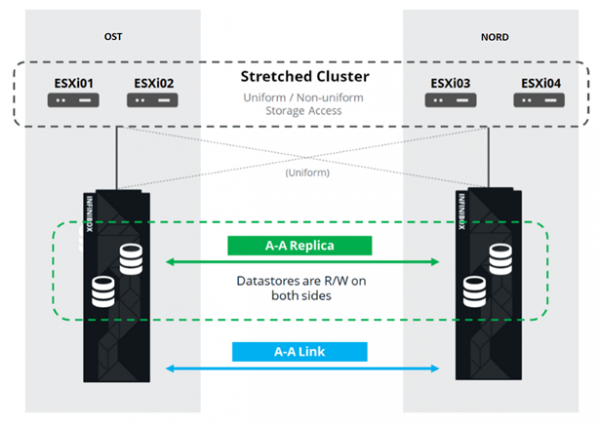
Iată cum arată schema de conectare în cluster.
Acest lucru este posibil datorită faptului că între fabricile SAN ale celor două locații este configurat Inter-Switch Link: switch-ul SAN Fabric A OST este conectat cu switch-ul SAN Fabric A NORD, similar și pentru switch-urile SAN Fabric B.
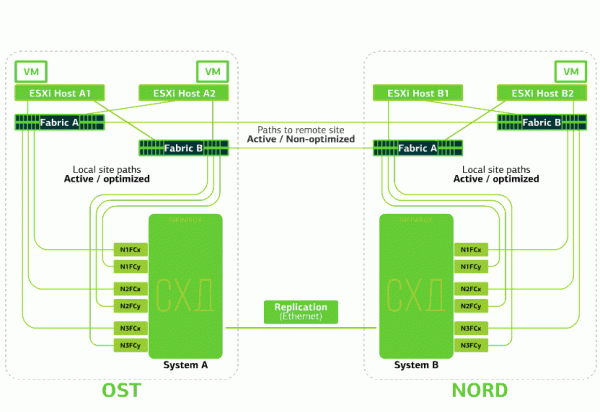
Și, pentru ca toate aceste complexități ale fabricilor SAN să aibă sens, între cele două SĂD-uri este configurată replicarea Active-Active: informația este practic scrisă simultan pe SĂD-ul local și pe cel remote, RPO=0. Așadar, pe un SĂD este stocată originalul datelor, iar pe celălalt – replica acestora. Datele sunt replicate la nivelul volumelor SĂD-urilor, iar pe acestea sunt stocate datele VM (discurile acesteia, fișierul de configurare, fișierul de swap etc.).
Gazda ESXi vede volumul principal și replica sa ca un singur dispozitiv de stocare (Storage Device). De la gazda ESXi la fiecare dispozitiv de stocare există 24 de căi:
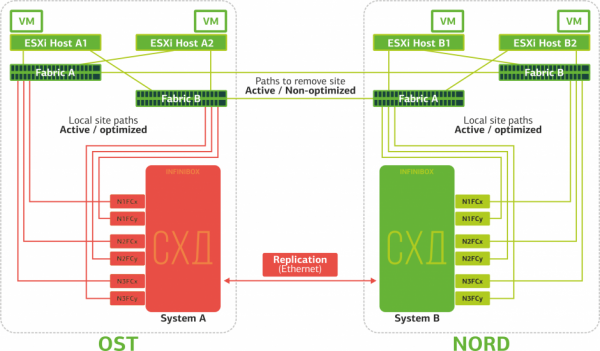
12 căi le conectează cu SĂD-ul local (căi optime), iar celelalte 12 – cu cel remote (căi neoptime). În situația standard, ESXi accesează datele de pe SĂD-ul local, folosind căile „optime”. În caz de defectare a acestui SĂD, ESXi pierde căile optime și comută pe cele „neoptime”. Așa arată acest lucru în schematică.
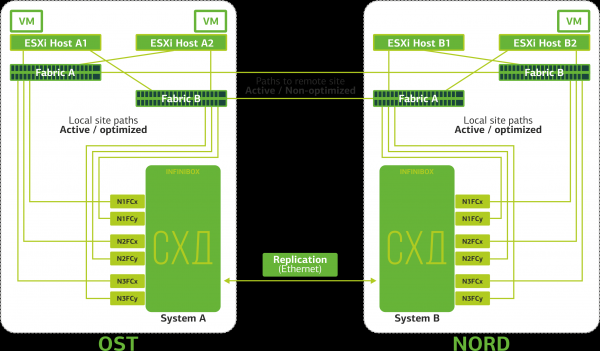
Schema clusterului de recuperare în caz de dezastru.
Toate rețelele clienților sunt conectate la ambele locații printr-o fabrică de rețea comună. La fiecare locație funcționează Provider Edge (PE), unde sunt terminate rețelele clientului. PE-urile sunt grupate într-un cluster comun. În cazul defectării PE-ului de pe o locație, tot traficul este redirecționat către a doua locație. Datorită acestui lucru, mașinile virtuale de pe locația care nu mai are PE rămân accesibile prin rețea pentru client.
Acum să vedem ce se va întâmpla cu mașinile virtuale ale clientului în cazul diferitelor defectări. Vom începe cu cele mai ușoare scenarii și vom termina cu cel mai grav – defectarea întregii locații. În exemple, locația principală va fi OST, iar cea de rezervă, cu replici de date, – NORD.
Ce se întâmplă cu mașina virtuală a clientului dacă…
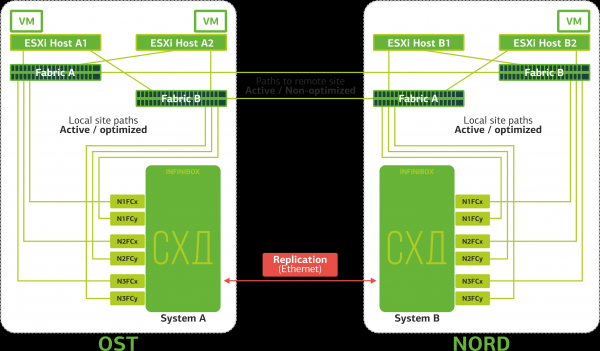
Se defectează Replication Link. Replicarea între SĂD-urile celor două locații se oprește.
ESXi va funcționa doar cu dispozitive de stocare locale (pe căi optime).
Mașinile virtuale continuă să funcționeze.
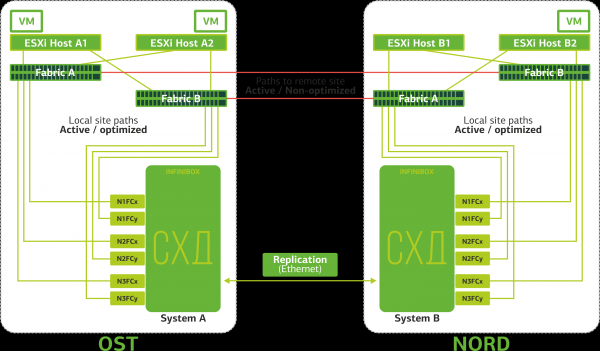
Se întrerupe ISL (Inter-Switch Link). Cazul este puțin probabil. Doar dacă un excavator nebun săpă ciudat de multe trasee optice care trec pe rute independente și sunt conectate la site-uri prin intrări diferite. Dar totuși. În acest caz, gazdele ESXi vor pierde jumătate din căi și vor putea accesa doar propriile lor stocări locale. Replicațiile sunt create, dar gazdele nu vor putea accesa.
Mașinile virtuale funcționează normal.
Switch-ul SAN de pe unul dintre site-uri dă greș. Gazdele ESXi pierd parte din căile către stocările locale. În acest caz, gazdele de la site-ul unde a căzut switch-ul vor funcționa doar printr-un singur HBA.
Mașinile virtuale continuă să funcționeze normal în acest caz.
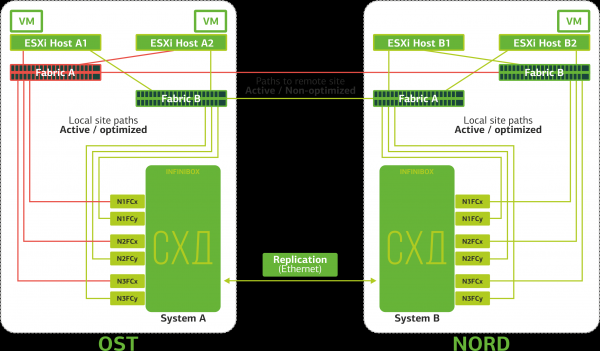
Toate switch-urile SAN de pe unul dintre site-uri dau greș. Să presupunem că o astfel de problemă a avut loc la site-ul OST. În acest caz, gazdele ESXi de la acest site vor pierde toate căile către dispozitivele lor de stocare. Mecanismul standard VMware vSphere HA intervine: va reporni toate mașinile virtuale de pe site-ul OST în NORD, maximum în 140 de secunde.
Mașinile virtuale care rulează pe gazdele de pe site-ul NORD funcționează normal.
Gazda ESXi de pe un site dă greș. Aici mecanismul vSphere HA funcționează din nou: mașinile virtuale de pe gazda defectă sunt repornite pe alte gazde - fie pe același site, fie pe un site îndepărtat. Timpul de repornire pentru o mașină virtuală este de până la 1 minut.
Dacă toate gazdele ESXi de la site-ul OST dau greș, aici nu mai sunt opțiuni: VM-urile se repornesc pe altul. Timpul de repornire este același.
Stocarea dă greș într-un site. Să presupunem că stocarea a dat greș la site-ul OST. Atunci gazdele ESXi de la site-ul OST se vor comuta la lucrul cu replicile stocării din NORD. După readucerea stocării defecte în funcțiune, va avea loc o replicare forțată, iar gazdele ESXi OST vor începe din nou să acceseze stocarea locală.
Mașinile virtuale au funcționat normal în toată această perioadă.
Unul dintre site-uri dă greș. În acest caz, toate mașinile virtuale vor fi repornite pe site-ul de rezervă prin mecanismul vSphere HA. Timpul de repornire al VM-ului este de 140 de secunde. Toate setările de rețea ale mașinii virtuale vor fi păstrate, iar aceasta va rămâne accesibilă clientului prin rețea.
Pentru ca repornirea mașinilor de pe site-ul de rezervă să se desfășoare fără probleme, fiecare site este umplut doar pe jumătate. Cealaltă jumătate este rezervă în cazul mutării tuturor mașinilor virtuale de pe al doilea site afectat.
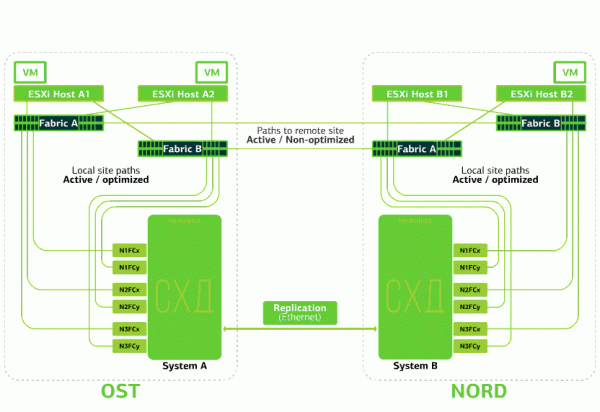
Asta protejează împotriva unor astfel de defecțiuni un nor de continuare a activității bazat pe două centre de date.
Aceasta nu este o plăcere ieftină, deoarece, pe lângă resursele principale, este necesară o rezervă pe al doilea site. Prin urmare, serviciile critice pentru afaceri sunt plasate în astfel de nor, a căror oprire prelungită generează pierderi financiare și de reputație semnificative sau în cazul în care sunt impuse cerințe de continuitate a activității de către reglementatori sau reglementările interne ale companiei.
Surse:
Sursa: habr.com
