

Bună, Habr.
Mă numesc Misha Butrimov și aș dori să vă povestesc puțin despre Cassandra. Povestea mea va fi utilă celor care nu au avut niciodată de-a face cu bazele de date NoSQL — are foarte multe particularități de implementare și capcane ascunse, despre care trebuie să știți. Și, dacă nu ați văzut nimic în afară de Oracle sau de orice altă bază de date relațională, aceste lucruri vă vor salva viața.
Ce este bun la Cassandra? Este o bază de date NoSQL, proiectată fără un singur punct de eșec, care se scalabilizează bine. Dacă aveți nevoie să adăugați câteva terabytes la o bază de date, pur și simplu adăugați noduri în ring. Doriți să o extindeți către un alt centru de date? Adăugați noduri în cluster. Doriți să creșteți RPS-ul procesat? Adăugați noduri în cluster. Funcționează și în direcția opusă.
În ce altceva este bună? În a procesa multe cereri. Dar multe — câte? 10, 20, 30, 40 de mii de cereri pe secundă — asta este puțin. 100 de mii de cereri pe secundă pentru scriere — de asemenea. Există companii care au spus că mențin 2 milioane de cereri pe secundă. Poate că va trebui să le credem.
Și, în principiu, Cassandra are o mare diferență față de datele relaționale — nu seamănă deloc cu ele. Și este foarte important să rețineți acest lucru.
Nu tot ce pare identic funcționează identic
Odată, un coleg a venit la mine și a întrebat: „Iată SQL-ul Cassandra, și are o instrucțiune select, are un where, are un and. Eu scriu litere, dar nu funcționează. De ce?”. Dacă te raportezi la Cassandra ca la o bază de date relațională, acesta este cel mai bun mod de a-ți încheia viața într-un mod brutal. Și nu promovez asta, este interzis în Rusia. Pur și simplu vei proiecta ceva greșit.
De exemplu, vine un client și spune: „Să construim o bază de date pentru seriale sau o bază de date pentru un repertoriu de rețete. Vom avea feluri de mâncare cu ingrediente sau o listă de seriale și actori în acestea”. Răspundem cu bucurie: „Sigur!”. Aceasta este doar o chestiune de a trimite două byte, câteva tabele și totul este gata, totul va funcționa foarte repede și fiabil. Și totul merge perfect, până când clienții vin și spun că gospodinele vor să rezolve și problema inversă: au o listă de ingrediente și vor să afle ce fel de mâncare vor să prepare. Ești terminat.
Totul este pentru că Cassandra este o bază de date hibridă: este atât key value, cât și stochează date în coloane largi. Dacă am vorbi în termeni de Java sau Kotlin, s-ar putea descrie astfel:
Map<RowKey, SortedMap<ColumnKey, ColumnValue>>
Adică o hartă, în interiorul căreia se află și o hartă sortată. Prima cheie la această hartă este Row key sau Partition key — cheia de partiționare. A doua cheie, care este cheia pentru harta deja sortată, este Clustering key.
Pentru a ilustra distribuția bazei de date, să desenăm trei noduri. Acum trebuie să înțelegem cum să distribuim datele pe noduri. Pentru că dacă vom pune totul într-un singur nod (de altfel, pot fi o mie, două mii, cinci — câte vrem), aceasta nu este deloc despre distribuție. De aceea, avem nevoie de o funcție matematică care va returna un număr. Pur și simplu un număr, un int lung, care va cădea într-un anumit interval. Și un nod va răspunde pentru un interval, al doilea — pentru al doilea, al n-lea — pentru al n-lea.
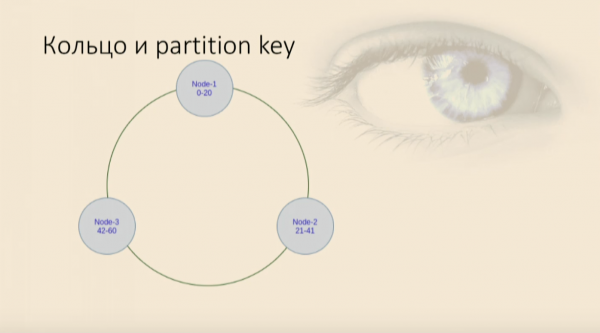
Acest număr este obținut printr-o funcție de hash, care se aplică tocmai la ceea ce numim Partition key. Aceasta este coloana care este specificată în directiva Primary key, și este coloana care va fi prima și cea mai importantă cheie a hărții. Ea determină către ce noduri vor ajunge datele. Tabelul se creează în Cassandra aproape cu același sintaxă ca în SQL:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
Cheia principală în acest caz constă dintr-o singură coloană, iar aceasta este și cheia de partiționare.
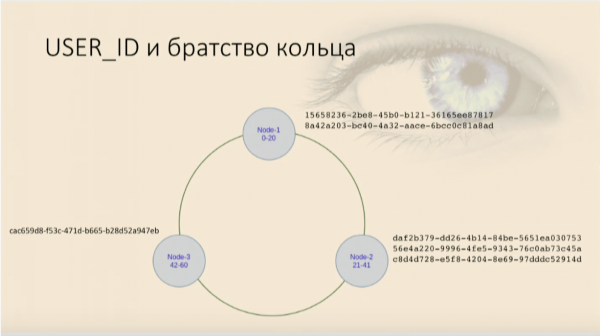
Cum se vor distribui utilizatorii? O parte vor ajunge pe un nod, o parte pe altul, iar o parte pe al treilea. Rezultatul este o tabelă de hash obișnuită, adică o hartă, care în Python se numește dicționar, adică o simplă structură Key value, din care putem citi toate valorile, citind și scriind după cheie.
Select: când allow filtering se transformă într-un full scan, sau cum nu ar trebui să facem
Hai să scriem o declarație select: select * from users where userid = . Aparent trebuie să funcționeze ca în Oracle: scriem select, specificăm condițiile și totul merge, utilizatorii sunt extrasi. Dar, dacă alegem, de exemplu, un utilizator cu o anumită dată de naștere, Cassandra se plânge că nu poate executa interogarea. Pentru că nu știe nimic despre cum sunt distribuite datele despre anul nașterii — are ca și cheie doar o singură coloană. Atunci spune: „Bine, pot să execut în continuare această interogare. Adăugați allow filtering”. Adăugăm această directivă, totul funcționează. Și în acel moment se întâmplă ceva teribil.
Când rulăm pe date de testare, totul decurge perfect. Dar când executați o interogare în producție, unde avem, de exemplu, 4 milioane de înregistrări, atunci lucrurile nu merg prea bine. Pentru că allow filtering — această directivă permite Cassandrei să adune toate datele din tabloul acesta de pe toate nodurile, toate a centrelor de date (dacă sunt multe în acest cluster), și doar apoi să filtreze. Este similar cu un Full Scan, și cu greu ar putea să-l placă cuiva.
Dacă am fi avut nevoie de utilizatori doar după identificatori, ne-ar fi convenit. Dar uneori trebuie să scriem alte interogări și să aplicăm alte restricții asupra selecției. Prin urmare, ne amintim: este o hartă, care are o cheie de partitionare, dar în interiorul ei — o hartă sortată.
Și are și o cheie, pe care o numim Clustering Key. Această cheie, care, la rândul ei, constă din coloanele pe care le alegem, permite Cassandrei să înțeleagă cum sunt datele fizic sortate și vor fi stocate pe fiecare nod. Adică, pentru un anumit Partition key, Clustering key ne va spune cum să introducem exact datele în acest arbore, ce loc vor ocupa acolo.
Este într-adevăr un arbore, se apelează un comparator, în care transmitem un set de coloane sub formă de obiect, iar acesta este, de asemenea, definit sub formă de enumerare de coloane.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Atenție la directivele Primary key; primul argument (în cazul nostru, anul) este întotdeauna Partition key. Acesta poate consta din una sau mai multe coloane, nu contează. Dacă sunt mai multe coloane, trebuie să le punem din nou între paranteze, astfel încât preprocesorul limbajului să înțeleagă că acesta este de fapt Primary key, iar celelalte coloane sunt Clustering key. Acestea vor fi transmise în comparator în ordinea în care apar. Așadar, prima coloană este mai semnificativă, a doua este mai puțin semnificativă și așa mai departe. Așa cum facem pentru clasele de date, de exemplu, pentru câmpurile equals: enumerăm câmpurile și specificăm care sunt mai mari și care sunt mai mici. În Cassandra, acestea sunt, într-un fel, câmpurile clasei de date la care se va aplica equals scris pentru aceasta.
Stabilim ordinea, impunem restricții
Trebuie să ținem cont că ordinea de sortare (descrescătoare, crescătoare, nu contează) este stabilită în momentul în care se creează cheia și nu va putea fi modificată ulterior. Aceasta definește fizic cum vor fi sortate datele și cum vor fi stocate. Dacă va fi necesară modificarea Clustering key sau a ordinii de sortare, va trebui să creăm un nou tabel și să transferăm datele în acesta. Cu cel existent nu va fi posibil.
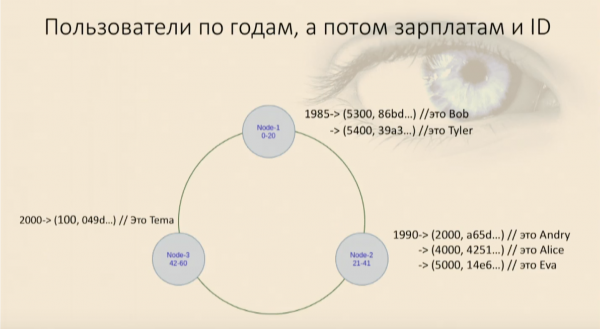
Am umplut tabela noastră cu utilizatori și am observat că aceștia s-au aranjat într-un cerc inițial pe baza anului nașterii și apoi, în cadrul fiecărei noduri, pe baza salariului și a ID-ului utilizatorului. Acum putem face selecții, impunând restricții.
Se reaprinde iarăși activitatea noastră unde, și, iar utilizatorii ne vin, și totul este din nou bine. Dar dacă vom încerca să folosim doar o parte a Clustering key, și anume cea mai puțin semnificativă, Cassandra va semnala imediat că nu poate găsi locația în mapa noastră unde acest obiect, al cărui câmp pentru comparator este null, iar acesta, pe care tocmai l-am specificat, — unde este păstrat. Va trebui să refac întreaga dată de la această nodă și să le filtrez. Acesta este echivalentul unui Full Scan în cadrul nodului, ceea ce este negativ.
În orice situație neclară, creează un nou tabel
Dacă dorim să accesăm utilizatorii după ID sau după vârstă, sau după salariu, ce trebuie să facem? Nimic. Pur și simplu folosim două tabele. Dacă va fi necesar să accesăm utilizatorii în trei moduri diferite, vor fi trei tabele. Timpurile în care economiseam spațiu pe hard disk au trecut. Acesta este cel mai ieftin resursă. Este mult mai ieftin decât timpul de răspuns, care poate fi distructiv pentru utilizator. Utilizatorului îi este mult mai plăcut să primească ceva în secundă decât în 10 minute.
Schimbăm spațiul ocupat în exces, datele denormalizate pentru capacitatea de a scalabiliza corect și de a funcționa fiabil. De fapt, un cluster format din trei centre de date, fiecare având câte cinci noduri, la un nivel acceptabil de retenție a datelor (când nu se pierd deloc date), este capabil să supraviețuiească distrugerii complet a unui centru de date. Și încă două noduri în cele două centre rămase. Și abia după aceasta vor începe problemele. Acesta este un sistem de rezervare destul de bun, costă câțiva SSD-uri și procesoare suplimentare. Prin urmare, pentru a utiliza Cassandra, care nu este SQL, care nu are relații și chei externe, trebuie să cunoaștem reguli simple.
Proiectăm totul din cerere. Ceea ce devine principal nu sunt datele, ci modul în care aplicația va lucra cu ele. Dacă trebuie să obțină date diferite în moduri diferite sau aceleași date în moduri diferite, trebuie să le stocăm în modul în care va fi convenabil pentru aplicație. Altfel, vom cădea în Full Scan și niciun avantaj al Cassandra nu ne va ajuta.
Denormalizarea datelor este norma. Să uităm de formele normale, nu mai avem baze de date relaționale. Dacă stocăm ceva de 100 de ori, va fi stocat de 100 de ori. Este totuși mai ieftin decât a încetini.
Alegem cheile pentru partiționare astfel încât să fie distribuite uniform. Nu avem nevoie ca hash-ul cheilor noastre să cadă într-un interval restrictiv. Asta înseamnă că anul nașterii în exemplul de mai sus este un exemplu slab. Adică, este bun dacă utilizatorii sunt distribuiți uniform pe anul nașterii, și slab dacă ne referim la elevii din clasa a cincea - acolo nu se va partiționa bine.
Sortarea se alege o singură dată în etapa de creare a Cheii de Clustrare. Dacă trebuie să o schimbăm, va trebui să reîncărcăm tabela noastră cu o altă cheie.
Și cel mai important: dacă trebuie să extragem aceleași date în 100 de moduri diferite, va trebui să avem 100 de tabele diferite.
Sursa: habr.com
