

Salut tuturor! În cadrul meu am scris despre organizarea unui sistem modular de monitorizare pentru arhitectura microserviciilor. Nimic nu stă pe loc, proiectul nostru crește constant, iar numărul metricilor stocate – de asemenea. Cum am organizat tranziția de la Graphite+Whisper la Graphite+ClickHouse în condiții de încărcare ridicată, așteptările de la acesta și rezultatele migrației le puteți citi mai jos.
Înainte de a povesti cum am organizat tranziția de la stocarea metricilor în Graphite+Whisper la Graphite+ClickHouse, aș vrea să ofer informații despre motivele luării unei astfel de decizii și despre dezavantajele Whisper cu care am trăit o perioadă îndelungată.
Problemele Graphite+Whisper
1. Încărcare ridicată pe subsistemul de stocare
La momentul tranziției, primeam aproximativ 1,5 milioane de metrici pe minut. Cu un astfel de flux, utilizarea discului pe servere era de ~30%. În general, acest lucru era destul de acceptabil – totul funcționa stabil, se scria rapid, se citea rapid... Până în momentul în care una dintre echipele de dezvoltare a lansat o nouă funcționalitate și a început să ne trimită 10 milioane de metrici pe minut. Atunci subsistemul de stocare a început să se supraîncălzească, iar utilizarea ajungea la 100%. Problema a fost rezolvată rapid, dar a rămas o amprentă.
2. Lipsa replicării și a consistenței
Probabil că, la fel ca toți cei care folosesc/s-au folosit de Graphite+Whisper, am trimis un flux uniform de metrici simultan pe mai multe servere Graphite cu scopul de a crea redundanță. Și cu asta nu am avut probleme speciale – până în momentul în care unul dintre servere a căzut din orice motiv. Uneori reușeam să ridicăm serverul căzut destul de repede, iar carbon-c-relay reușea să încarce metricile din cache-ul său, iar alteori nu. Și atunci în metrici apărea o lacună, pe care o acoperam cu rsync. Procedura era destul de lungă. Ce ne salva era că astfel de lucruri se întâmplau foarte rar. De asemenea, periodic luam un set aleatoriu de metrici și le comparăm cu altele similare de pe nodurile vecine ale clusterului. În aproximativ 5% din cazuri, unele valori diferă, ceea ce nu ne încânta foarte mult.
3. Spațiu de stocare mare utilizat
Deoarece scriem în Graphite nu doar metrici de infrastructură, ci și metrici de business (iar acum și metrici din Kubernetes), ne confruntăm destul de des cu situația în care în metrică apar doar câteva valori, iar fișierul .wsp este creat având în vedere toată perioada de retenție și ocupă volumul de spațiu predefinit, care era de aproximativ 2 MB. Problema se agravează și mai mult deoarece acest tip de fișiere devine din ce în ce mai multe în timp, iar la generarea rapoartelor pe baza lor se pierde mult timp și resurse citind punctele goale.
Aș dori să subliniez imediat că problemele descrise mai sus pot fi combătute prin diverse metode și cu diferite grade de eficiență, dar cu cât mai multe date încep să sosească, cu atât mai acut devin acestea.
Având în vedere toate cele menționate anterior (ținând cont de precedentele ), precum și creșterea constantă a numărului de metrici primite, dorința de a transfomra toate metricile într-un interval de stocare de 30 de secunde (dacă este necesar — până la 10 secunde), am decis să încercăm Graphite+ClickHouse ca alternativă promițătoare la Whisper.
Graphite+ClickHouse. Așteptări
După ce am participat la câteva întâlniri ale echipei de la Yandex, am citit , am parcurs documentația și am găsit componentele adecvate pentru a integra ClickHouse cu Graphite, am decis să acționăm!
Ne-am dorit să obținem următoarele:
- să reducem utilizarea sistemului de stocare de la 30% la 5%;
- să reducem volumul ocupat de la 1TB la 100GB;
- să avem capacitatea de a primi 100 milioane de metrici pe minute pe server;
- replicarea datelor și reziliența la erori din fabrică;
- să nu stăm la acest proiect timp de un an și să realizăm tranziția într-un termen rezonabil;
- să facem comutarea fără downtime.
Destul de ambițios, nu-i așa?
Graphite+ClickHouse. Componente
Pentru a obține date prin protocolul Graphite și a le scrie ulterior în ClickHouse, a fost ales (golang).
Ca bază de date pentru stocarea seriilor temporale a fost ales cea mai recentă versiune stabilă a ClickHouse, 1.1.54253. Pe parcursul utilizării acesteia, au apărut probleme: logurile erau pline de erori și nu era foarte clar ce să facem cu acestea. În discuția cu (autor al carbon-clickhouse, graphite-clickhouse și multe altele) a fost ales un release mai vechi, . Erorile au dispărut — totul a început să funcționeze perfect.
Pentru a citi date din ClickHouse, a fost ales (golang). Ca API pentru Graphite — (golang). Pentru organizarea replicării între tabelele ClickHouse a fost utilizat . Pentru rutarea metricilor am păstrat cu drag (C) .
Graphite+ClickHouse. Structura tabelelor
“graphite” — baza de date creată de noi pentru tabelele de monitorizare.
“graphite.metrics” — tabel cu motorul ReplicatedReplacingMergeTree (replicat ). În acest tabel se păstrează numele metricilor și căile către acestea.
CREATE TABLE graphite.metrics ( Date Date, Level UInt32, Path String, Deleted UInt8, Version UInt32 ) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.metrics', 'r1', Date, (Level, Path), 8192, Version);“graphite.data” — tabel cu motorul ReplicatedGraphiteMergeTree (replicat ). În acest tabel se păstrează valorile metricilor.
CREATE TABLE graphite.data ( Path String, Value Float64, Time UInt32, Date Date, Timestamp UInt32 ) ENGINE = ReplicatedGraphiteMergeTree('\/clickhouse\/tables\/replicator\/graphite.data', 'r1', Date, (Path, Time), 8192, 'graphite_rollup')“graphite.date_metrics” — tabel umplut condiționat, cu motorul ReplicatedReplacingMergeTree. În acest tabel se înregistrează numelile tuturor metricilor întâlnite într-o zi. Motivele creării sunt descrise în secțiunea de la sfârșitul acestui articol.
CREATE MATERIALIZED VIEW graphite.date_metrics ( Path String, Level UInt32, Date Date) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.date_metrics', 'r1', Date, (Level, Path, Date), 8192) AS SELECT toUInt32(length(splitByChar('.', Path))) AS Level, Date, Path FROM graphite.data“graphite.data_stat” — tabel umplut condiționat, cu motorul ReplicatedAggregatingMergeTree (replicat ). În acest tabel se înregistrează numărul de metrici primite, cu detaliere până la 4 niveluri de adâncime.
CREATE MATERIALIZED VIEW graphite.data_stat ( Date Date, Prefix String, Timestamp UInt32, Count AggregateFunction(count)) ENGINE = ReplicatedAggregatingMergeTree('\/clickhouse\/tables\/replicator\/graphite.data_stat', 'r1', Date, (Timestamp, Prefix), 8192) AS SELECT toStartOfMonth(now()) AS Date, replaceRegexpOne(Path, '^([^.]+.[^.]+.[^.]+).*$', '1') AS Prefix, toUInt32(toStartOfMinute(toDateTime(Timestamp))) AS Timestamp, countState() AS Count FROM graphite.data GROUP BY Timestamp, PrefixGraphite+ClickHouse. Schema de interacțiune a componentelor
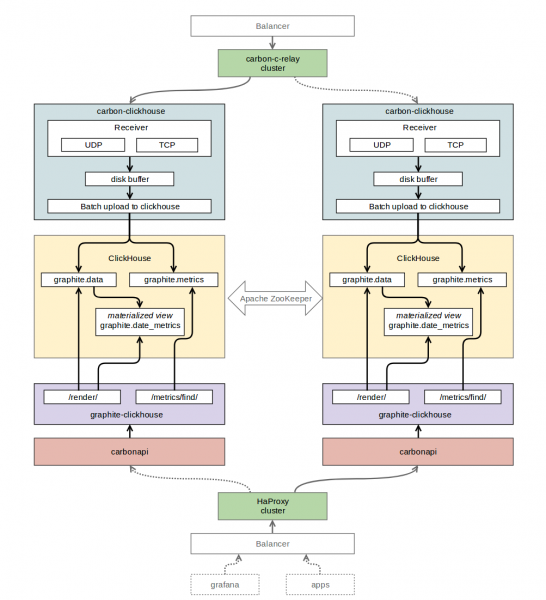
Graphite+ClickHouse. Migrarea datelor
Așa cum ne amintim din așteptările acestui proiect, trecerea la ClickHouse ar trebui să fie fără timpi de nefuncționare, prin urmare, am trebuit să translatăm întreaga noastră sistemă de monitorizare către noul depozit cât mai transparent pentru utilizatorii noștri.
Am realizat acest lucru în felul următor.
În carbon-c-relay am adăugat o regulă pentru a trimite un flux suplimentar de metrici către carbon-clickhouse de pe unul din serverele implicate în replicarea tabelelor ClickHouse.
Am scris un mic script în Python care, folosind biblioteca whisper-dump, a citit toate fișierele .wsp din stocarea noastră și a trimis aceste date în carbon-clickhouse în 24 de fire. Numărul valorilor metrice primite în carbon-clickhouse a ajuns la 125 milioane/min, iar ClickHouse nu a avut probleme.
Am creat o sursă de date separată în Grafana cu scopul de a debuga funcțiile utilizate în tablourile de bord existente. Am identificat o listă de funcții pe care le-am folosit, dar care nu erau implementate în carbonapi. Le-am completat și am trimis PR-uri autorilor carbonapi (un mulțumesc special pentru ei).
- Pentru a schimba sarcina de citire, în setările echilibrarelor de sarcină am modificat endpoint-urile de la graphite-api (interfața API pentru Graphite+Whisper) la carbonapi.
Graphite+ClickHouse. Rezultate
am redus utilizarea subsistemului de stocare de la 30% la 1%;

- am redus spațiul ocupat de la 1 TB la 300 GB;
- avem capacitatea de a primi 125 milioane de metrici pe minut în server (vârfuri în timpul migrației);
- am transferat toate metricile pe un interval de stocare de treizeci de secunde;
- am obținut replicarea datelor și toleranța la erori;
- ne-am schimbat fără downtime;
- am investit aproximativ 7 săptămâni în total.
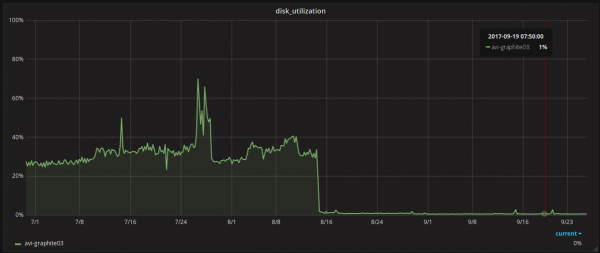
Graphite+ClickHouse. Probleme
În cazul nostru, nu au lipsit capcanele. Iată cu ce ne-am confruntat după tranziție.
- ClickHouse nu reîncărcă întotdeauna configurațiile în timp real, uneori trebuie să fie repornit. De exemplu, în cazul descrierii cluster-ului zookeeper în configurația ClickHouse - acesta nu a fost aplicat până la repornirea clickhouse-server.
- Nu am putut efectua interogări mari în ClickHouse, de aceea în graphite-clickhouse, șirul de conectare la ClickHouse arată astfel:
url = "http://localhost:8123/?max_query_size=268435456&max_ast_elements=1000000" - În ClickHouse apar destul de des versiuni noi de lansare stabilă, care pot aduce surprize: fiți atenți.
- Containerele create dinamic în Kubernetes trimit un mare număr de metrici cu o durată scurtă și aleatorie de viață. Numărul de puncte pentru aceste metrici este mic, iar problemele de spațiu nu sunt o problemă. Dar în timpul construirii interogărilor, ClickHouse ridică o cantitate uriașă din aceste metrici din tabelul ‘metrics’. În 90% din cazuri, datele pentru acestea lipsesc în fereastra de timp (24 de ore). Timpul petrecut pentru a căuta aceste date în tabelul ‘data’ se acumulează și, în cele din urmă, ajunge la timeout. Pentru a rezolva această problemă, am început să păstrăm o vedere separată cu informațiile despre metricile întâlnite în ultimele 24 de ore. Astfel, când construim rapoarte (grafice) pentru containerele create dinamic, interogăm doar metricile care au fost întâlnite în fereastra de timp specificată, nu pentru întreaga perioadă, ceea ce a accelerat exponențial construirea rapoartelor pentru acestea. Pentru soluția descrisă mai sus, a fost construit , incluzând implementarea lucrului cu tabelul date_metrics.
Graphite+ClickHouse. Etichete
Din versiunea 1.1.0, Graphite a devenit oficial . Și ne gândim activ la ce și cum trebuie să facem pentru a susține această inițiativă în stiva graphite+clickhouse.
Graphite+ClickHouse. Detector de anomalii
Pe baza infrastructurii descrise mai sus, am realizat un prototip de detector de anomalii, iar acesta funcționează! Dar despre el — în următorul articol.
Abonați-vă, apăsați săgeata în sus și fiți fericiți!
Sursa: habr.com
