

Astăzi, pe proiectul nostru, pe lângă codul monolitic, funcționează zeci de microservicii. Fiecare dintre acestea necesită monitorizare. E dificil pentru inginerii DevOps să facă acest lucru la astfel de volume. Am dezvoltat un sistem de monitorizare care funcționează ca un serviciu pentru dezvoltatori. Aceștia își pot scrie singuri metricele în sistemul de monitorizare, le pot utiliza, construi tablouri de bord pe baza acestora și adăuga alerte care se vor activa la atingerea valorilor limită. Din partea inginerilor DevOps, doar infrastructura și documentația sunt necesare.
Acest post este transcrierea prezentării mele de la de la RIT++. Mulți ne-au cerut să facem versiuni textuale ale prezentărilor de acolo. Dacă ai fost la conferință sau ai vizionat videoclipul, nu vei găsi nimic nou. Iar celorlalți — bun venit sub cat. Voi povesti cum am ajuns la acest sistem, cum funcționează și cum plănuim să-l actualizăm.
Trecut: scheme și planuri
Cum am ajuns la sistemul de monitorizare existent? Pentru a răspunde acestei întrebări, trebuie să ne întoarcem în 2015. Iată cum arăta atunci:
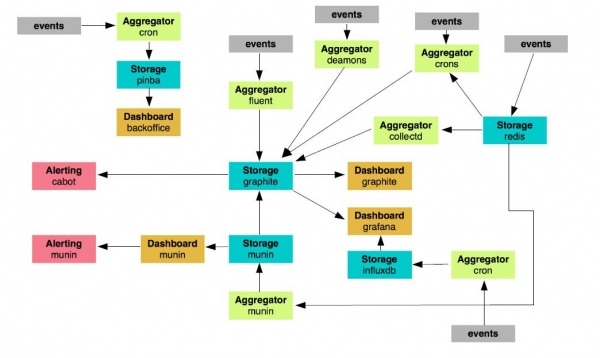
Aveam aproximativ 24 de noduri care se ocupau de monitorizare. Aici există o mulțime de cronuri, scripturi, demoni care monitorizează ceva, trimit mesaje, îndeplinesc funcții. Ne-am gândit că, pe măsură ce timpul trece, un astfel de sistem va deveni din ce în ce mai puțin viabil. Nu are sens să-l dezvoltăm mai departe: este prea greoi.
Am decis să alegem elementele de monitorizare pe care le vom păstra și dezvolta și cele de care ne vom despărți. Am ajuns la un număr de 19. Au rămas doar Graphite, agregatori și Grafana ca tablouri de bord. Dar cum va arăta noul sistem? Iată cum:
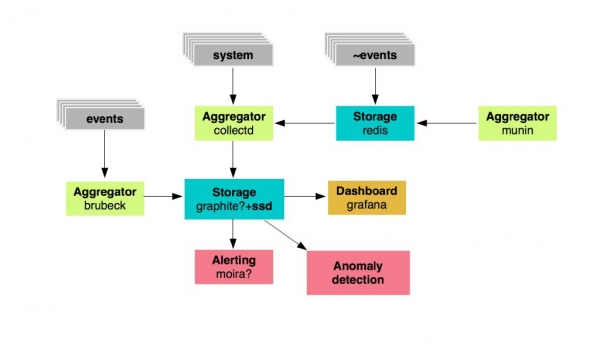
Avem un depozit de metrice: acestea sunt Graphite, care vor fi bazate pe SSD-uri rapide, și anumite agregatoare pentru metrice. Apoi — Grafana pentru generarea tablourilor de bord și Moira ca sistem de alerte. De asemenea, am dorit să dezvoltăm un sistem pentru detectarea anomaliilor.
Standard: Monitorizare 2.0
Așa arătau planurile în 2015. Dar trebuia să pregătim nu doar infrastructura și serviciul în sine, ci și documentația pentru acesta. Am dezvoltat un standard corporativ pe care l-am numit Monitorizare 2.0. Care erau cerințele pentru sistem?
- disponibilitate continuă;
- interval de stocare a metricelor = 10 secunde;
- stocarea structurată a metricilor și tablourilor de bord;
- SLA > 99,99%
- colectarea metricilor evenimentelor prin UDP (!).
Am avut nevoie de UDP, deoarece avem un volum mare de trafic și evenimente care generează metrici. Dacă le-am scrie pe toate simultan în Graphite, stocarea s-ar prăbuși. De asemenea, am ales prefixe de prim nivel pentru toate metricile.
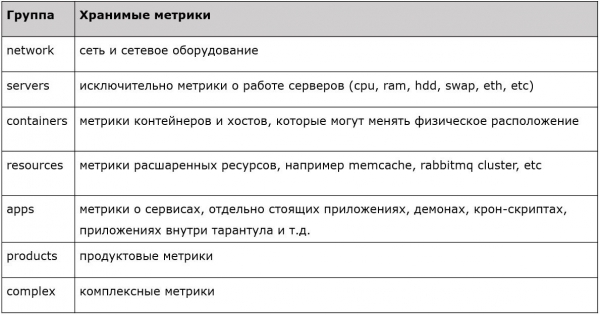
Fiecare dintre prefixe are o proprietate anume. Există metrici pentru servere, rețele, containere, resurse, aplicații și așa mai departe. S-a realizat o filtrare clară, strictă și tipizată, unde acceptăm metrici de prim nivel, iar celelalte sunt pur și simplu eliminate. Asta este cum am planificat acest sistem în 2015. Dar ce avem în prezent?
Prezent: schema de interacțiune a componentelor de monitorizare
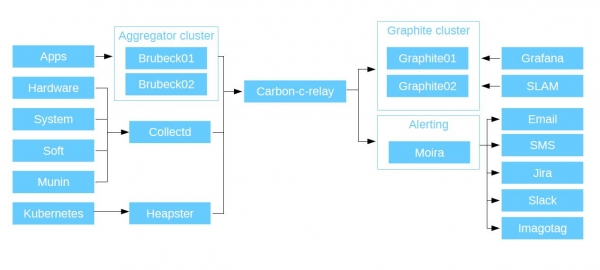
În primul rând, monitorizăm aplicațiile: codul nostru PHP, aplicațiile și microserviciile — în cuvinte simple, tot ce scriu dezvoltatorii noștri. Toate aplicațiile trimit metrici prin UDP către aggregatorul Brubeck (statsd, rescris în C). S-a dovedit a fi cel mai rapid în urma testelor sintetice. Și el trimite deja metricile agregate către Graphite prin TCP.
Acesta are un tip de metrici, numit temporizatoare. Este o chestiune foarte convenabilă. De exemplu, pentru fiecare conexiune a utilizatorului cu serviciul, trimiteți în Brubeck o metrică cu timpul de răspuns. Au sosit un milion de răspunsuri, iar aggregatorul a generat doar 10 metrici. Aveți numărul de utilizatori veniti, maximul, minima și timpul mediu de răspuns, mediana și 4 percentiles. Apoi datele sunt transmise în Graphite și le vedem pe toate live.
De asemenea, avem agregare pentru metricile hardware, software, metricile sistemului și vechea noastră sistem de monitorizare Munin (care a funcționat la noi până în 2015). Toate acestea le colectăm prin demonul CollectD scris în C (în care este încorporată o întreagă gamă de pluginuri diferite, acesta poate interoga toate resursele sistemului gazdă pe care este instalat, doar specificați în configurație unde să scrie datele) și scriem datele în Graphite prin intermediul acestuia. De asemenea, suportă pluginuri Python și scripturi shell, astfel încât puteți scrie propriile soluții personalizate: CollectD va colecta aceste date de pe un gazdă locală sau la distanță (să presupunem că există Curl) și le va trimite în Graphite.
Apoi, toate metricile pe care le-am colectat sunt trimise către Carbon-c-relay. Aceasta este o soluție Carbon Relay de la Graphite, recompilată în C. Este un router care centralizează toate metricile pe care le trimitem de la agregatoarele noastre și le rutează către noduri. De asemenea, în timpul rutării, verifică validitatea metricilor. Acestea, pe de o parte, trebuie să corespundă schemei cu prefixe pe care am arătat-o anterior și, pe de altă parte, să fie valide pentru Graphite. Altfel, sunt abandonate.
Apoi, Carbon-c-relay trimite metricile către clusterul Graphite. Folosim Carbon-cache ca principală soluție de stocare a metricilor, recompilat în Go. Go-carbon depășește semnificativ Carbon-cache în ceea ce privește performanța, datorită suportului său pentru multithreading. Acesta primește datele și le scrie pe discuri folosind pachetul whisper (standard, scris în Python). Pentru a citi datele din soluțiile noastre de stocare, utilizăm API-ul Graphite. Acesta funcționează mult mai repede decât standardul Graphite WEB. Ce se întâmplă mai departe cu datele?
Ele merg către Grafana. Ca sursă principală de date, folosim clusterele noastre de Graphite, plus avem Grafana ca interfață web pentru a afișa metricile și a construi dashboard-uri. Fiecare serviciu își creează propriul dashboard. Apoi, ei construiesc grafice pe care sunt reprezentate metricile pe care le transmit din aplicațiile lor. Pe lângă Grafana, avem și SLAM. Acesta este un demon în Python care calculează SLA pe baza datelor din Graphite. După cum am menționat, avem mai multe zeci de microservicii, fiecare având cerințe specifice. Cu ajutorul SLAM, verificăm documentația și o comparăm cu ceea ce avem în Graphite, evaluând cât de bine corespund cerințele disponibilității serviciilor noastre.
Să continuăm: alerting. Acesta este organizat printr-un sistem puternic - Moira. Este independentă, deoarece sub capotă are propriul său Graphite. A fost dezvoltată de echipa de la SKB „Kontur”, scrisă în Python și Go, complet open source. Moira primește același flux de date care se duce către Graphite. Dacă dintr-un anumit motiv stocarea dumneavoastră se prăbușește, alertingul dumneavoastră va continua să funcționeze.
Am implementat Moira în Kubernetes, și ca bază de date principală folosește un cluster de servere Redis. Rezultatul este un sistem rezistent la erori. Compară fluxul de metrici cu lista de declanșatoare: dacă nu există mențiuni, atunci elimină metrica. Astfel, este capabilă să proceseze gigabytes de metrici pe minut.
De asemenea, am integrat un LDAP corporativ, prin care fiecare utilizator al sistemului corporativ poate crea notificări pentru declanșatoarele existente (sau recente). Fiindcă Moira conține Graphite, susține toate funcțiile acestuia. Așadar, mai întâi iei o linie și o copiezi în Grafana. Te uiți cum sunt afișate datele pe grafice. Apoi iei aceeași linie și o copiezi în Moira. O încarci cu limite și obții alerte. Pentru a face tot acest lucru, nu ai nevoie de cunoștințe speciale. Moira poate alerta prin SMS, email, în Jira, Slack… De asemenea, suportă execuția de scripturi personalizate. Când are loc un declanșator și este abonată la un script personalizat sau un binar, îl executează și trimite JSON-ul la stdin acestui binar. Prin urmare, programul tău trebuie să-l parseze. Ce vei face cu acest JSON depinde de tine. Vrei să-l trimiți în Telegram, vrei să deschizi sarcini în Jira, fă orice dorești.
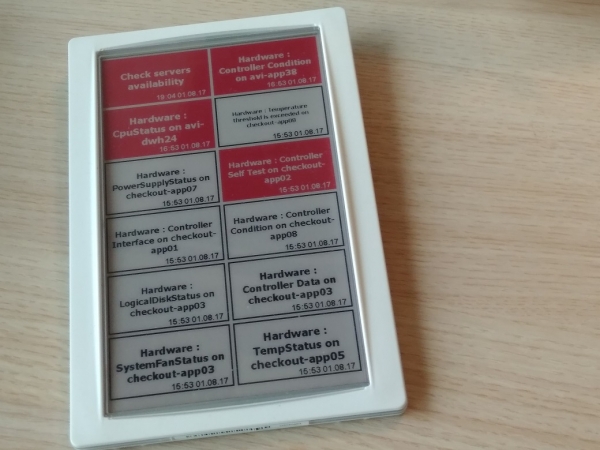
Pentru alerte folosim și o dezvoltare proprie — Imagotag. Am adaptat un panou utilizat în mod normal pentru etichetele de preț electronice în magazine, pentru sarcinile noastre. Am afișat declanșatoarele din Moira pe el. Acolo este indicat în ce stare se află și când au avut loc. O parte din echipa de dezvoltare a renunțat la notificările în Slack și email în favoarea acestui panou.
Deoarece suntem o companie progresistă, am monitorizat în acest sistem și Kubernetes. L-am integrat în sistem folosind Heapster, pe care l-am instalat în cluster; acesta colectează date și le trimite în Graphite. Drept rezultat, schema arată astfel:
Componentele monitorizării
Iată o listă de linkuri către componentele pe care le-am folosit pentru această sarcină. Toate sunt open-source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistică
Iată câteva cifre despre cum funcționează sistemul nostru.
Aggregator (brubeck)
Numărul de metrici: ~ 300 000 / sec
Intervalul de trimitere a metricelor în Graphite: 30 sec
Utilizarea resurselor serverului: ~ 6% CPU (ne referim la servere complete); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Numărul de metrici: ~ 1 600 000 / min
Intervalul de actualizare a metricelor: 30 sec
Schema de stocare a metricelor: 30sec 35d, 5min 90d, 10min 365d (oferă o înțelegere a ceea ce se întâmplă cu serviciul pe termen lung)
Utilizarea resurselor serverului: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibilitate
La Avito, prețuim foarte mult flexibilitatea în serviciul nostru de monitorizare. De ce a ajuns să fie așa? În primul rând, componentele sale sunt interschimbabile: atât componentele în sine, cât și versiunile lor. În al doilea rând — întreținerea. Deoarece întregul proiect este construit pe open-source, poți să modifici codul, să aduci schimbări și să implementezi funcții care nu sunt disponibile din fabrică. Se folosesc stive destul de răspândite, în principal, Go și Python, astfel că acest lucru se realizează destul de simplu.
Iată un exemplu de problemă reală. Ometrică în Graphite este un fișier. Are un nume. Numele fișierului = numele metricii. Și există un drum până la el. Numele fișierelor în Linux sunt limitate la 255 de caractere. Iar noi avem (ca „comenzi interne”) oameni din departamentul de baze de date. Ne spun: „Vrem să monitorizăm interogările noastre SQL. Iar acestea — nu 255 de caractere, ci 8 MB fiecare. Vrem să le vizualizăm în Grafana, să vedem parametrii pentru această interogare, iar și mai bine, vrem să vedem topul acestor interogări. Ar fi grozav dacă ar apărea în timp real. Și ar fi fantastic să le integrăm în sistemul de alerte”.
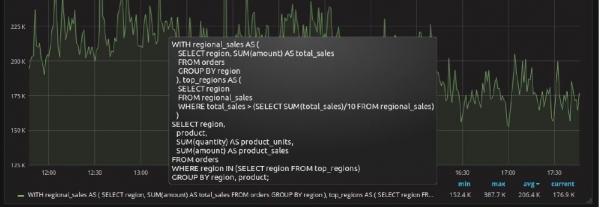
Exemplul interogării SQL a fost preluat ca exemplu de pe
Ridicăm un server Redis și folosim pluginurile noastre Collectd, care accesează Postgres pentru a prelua toate datele, trimitem metricile în Graphite. Dar schimbăm numele metricii cu hash-urile. Acest hash este trimis simultan în Redis ca și cheie, iar întreaga interogare SQL ca valoare. Ne rămâne de făcut astfel încât Grafana să poată accesa Redis și să preia această informație. Deschidem API-ul Graphite, deoarece acesta este principalul interfață de interacțiune între toate componentele de monitorizare și Graphite, și introducem o nouă funcție numită aliasByHash() — primim numele metricii de la Grafana și-l folosim în interogarea Redis ca și cheie, în răspuns primim valoarea cheii care este interogarea noastră SQL. Astfel, am reușit să afișăm în Grafana interogarea SQL, care teoretic nu putea fi afișată acolo, împreună cu statistica pentru aceasta (apeluri, rânduri, timp_total, ...).
Concluzii
Disponibilitate. Serviciul nostru de monitorizare este disponibil 24/7 din orice aplicație și orice cod. Dacă ai acces la depozite, poți scrie date în serviciu. Limbajul nu este important, soluțiile nu sunt importante. Trebuie doar să știi cum să deschizi un socket, să trimiti acolo metrica și să închizi socketul.
Fiabilitate. Toate componentele sunt rezistente la defectiuni și fac față sarcinilor noastre foarte bine.
Pragul de intrare scăzut. Pentru a utiliza acest sistem, nu trebuie să înveți limbaje de programare și interogări în Grafana. Pur și simplu deschizi aplicația ta, introduci socketul care va trimite metricile în Graphite, îl închizi, deschizi Grafana, creezi dashboard-uri acolo și examinezi comportamentul metricilor tale, primind notificări prin Moira.
Autonomie. Totul poate fi realizat de unul singur, fără ajutorul inginerilor DevOps. Și aceasta este o caracteristică de supraîncărcare, deoarece poți monitoriza proiectul tău chiar acum, fără a cere ajutor - nici pentru a începe lucrul, nici pentru modificări.
Ce ne propunem?
Toate cele enumerate mai jos nu sunt doar gânduri abstracte, ci dorința pentru care s-au făcut deja măcar primii pași.
- Detector de anomalii. Vrem să implementăm un serviciu care va accesa rețelele noastre Graphite și va verifica fiecare metrică conform diferitelor algoritmi. Există deja algoritmi pe care dorim să-i examinăm, avem date, știm să lucrăm cu ele.
- Metadatele. Avem multe servicii, care se schimbă în timp, la fel ca și persoanele care lucrează cu ele. Să ținem documentația manual nu este o opțiune. Din acest motiv, acum metadatele sunt integrate în microserviciile noastre. Acolo este specificat cine l-a dezvoltat, limbile cu care interacționează, cerințele SLA, unde și cui trebuie trimise notificările. La dezvoltarea serviciului, toate datele entității sunt create automat. În cele din urmă, obțineți două linkuri - unul pentru triggeri, altul pentru dashboard-uri în Grafana.
- Monitorizare în fiecare casă. Considerăm că un astfel de sistem trebuie utilizat de către toți dezvoltatorii. În acest fel, știți mereu unde se află traficul dvs., ce se întâmplă cu acesta, unde se întrerupe și care sunt punctele sale slabe. Dacă, de exemplu, apare ceva care va prăbuși serviciul dvs., veți afla despre asta nu chiar în timpul unui apel de la manager, ci dintr-un alert, și imediat puteți deschide logurile recente și vedea ce s-a întâmplat.
- Performanță înaltă. Proiectul nostru crește constant, iar astăzi procesează aproximativ 2.000.000 de valori de metrici pe minut. Acum un an, acest indicator era de 500.000. Iar creșterea continuă, ceea ce înseamnă că, într-un viitor apropiat, Graphite (whisper) va începe să suprasolicite foarte mult subsistemul de stocare. Așa cum am menționat, acest sistem de monitorizare este destul de versatil datorită interschimbabilității componentelor. Cineva se ocupă special de Graphite și își extinde constant infrastructura, dar noi am decis să urmăm o altă cale: să folosim ca spațiu de stocare pentru metricile noastre. Această tranziție este practic finalizată și în curând voi povesti mai în detaliu cum a fost realizată: ce dificultăți au apărut și cum au fost depășite, cum a decurs procesul de migrare, voi descrie componentele alese ca interfață și configurațiile acestora.
Mulțumesc pentru atenție! Întrebați-vă întrebările pe subiect, voi încerca să răspund aici sau în postările următoare. Poate că cineva are experiență în construirea unui astfel de sistem de monitorizare sau în tranziția către Clickhouse în situații similare - împărtășiți-o în comentarii.
Sursa: habr.com
