

Am dat peste un material interesant despre inteligența artificială în jocuri. Acesta explică conceptele de bază despre AI prin exemple simple, iar în interior sunt multe instrumente și metode utile pentru dezvoltarea și proiectarea sa convenabilă. Cum, unde și când să le folosești - sunt de asemenea incluse.
Majoritatea exemplelor sunt scrise în pseudocod, așa că nu sunt necesare cunoștințe profunde de programare. Sub articol sunt 35 de pagini de text cu imagini și GIF-uri, așa că pregătește-te.
UPD. Îmi pare rău, dar am mai realizat un traducere a acestui articol pe Habr. . Poți citi varianta lui , dar dintr-un anumit motiv articolul mi-a scăpat (am folosit căutarea, dar ceva nu a mers bine). Așa că, deoarece scriu pe un blog dedicat dezvoltării jocurilor, am decis să las varianta mea de traducere pentru abonați (unele puncte sunt formulate diferit, iar altele sunt intenționat omise la sfatul dezvoltatorilor).
Ce este AI?
AI-ul de jocuri se concentrează pe acțiunile pe care un obiect trebuie să le execute, în funcție de condițiile în care se află. De obicei, acest lucru este numit gestionarea „agenților inteligenți”, unde agentul este un personaj din joc, un vehicul, un bot și, uneori, chiar ceva mai abstract: un grup întreg de entități sau chiar o civilizație. În fiecare caz, acesta este un lucru care trebuie să observe mediul său, să ia decizii bazate pe acesta și să acționeze în consecință. Acest lucru se numește ciclul Sense/Think/Act (Simte/Strategizează/Acționează):
- Sense: agentul găsește sau primește informații despre lucruri din mediul său, care pot influența comportamentul său (amenințări apropiate, obiecte de colectat, locuri interesante de explorat).
- Think: agentul decide cum să reacționeze (evaluează dacă este suficient de sigur să colecteze obiecte sau dacă mai întâi trebuie să se lupte/ascundă).
- Act: agentul îndeplinește acțiuni pentru punerea în aplicare a deciziei anterioare (începe să se îndrepte spre inamic sau obiect).
- …acum situația s-a schimbat din cauza acțiunilor personajelor, astfel că ciclul se repetă cu date noi.
În general, IA se concentrează pe partea de Sense a ciclului. De exemplu, automobilele autonome fac fotografii ale drumului, le combină cu datele de radar și lidar, și le interpretează. De obicei, acest lucru este realizat de învățarea automată, care procesează datele de intrare și le dă sens, extrăgând informații semantice precum „există o altă mașină la 20 de metri în fața ta”. Acestea sunt așa-numitele probleme de clasificare.
Jocurile nu necesită un sistem complicat pentru extragerea informațiilor, deoarece cea mai mare parte a datelor este deja o parte integrantă a acestora. Nu este nevoie să rulezi algoritmi de recunoaștere a imaginilor pentru a determina dacă există un inamic în față — jocul știe deja și transmite informațiile în procesul de luare a deciziilor. Prin urmare, partea de Sense a ciclului este adeseori mult mai simplă decât Think și Act.
Limitările IA-ului din jocuri
IA are o serie de limitări care trebuie respectate:
- IA nu trebuie antrenată în avans, ca un algoritm de învățare automată. Este inutil să scrii o rețea neurală în timpul dezvoltării, pentru a observa zeci de mii de jucători și a învăța cea mai bună modalitate de a juca împotriva lor. De ce? Pentru că jocul nu a fost lansat încă, iar jucătorii nu există.
- Jocul trebuie să fie distractiv și provocator, astfel că agenții nu ar trebui să găsească cea mai bună abordare împotriva oamenilor.
- Agenții trebuie să pară realiști, astfel încât jucătorii să simtă că joacă împotriva unor oameni adevărați. Programul AlphaGo a depășit oamenii, dar pașii aleși au fost foarte diferiți de înțelegerea tradițională a jocului. Dacă jocul imită un adversar uman, acest sentiment nu ar trebui să existe. Algoritmul trebuie modificat pentru a lua decizii plauzibile, nu perfecte.
- IA trebuie să funcționeze în timp real. Asta înseamnă că algoritmul nu poate monopoliza utilizarea procesorului pentru o perioadă lungă de timp pentru a lua decizii. Chiar și 10 milisecunde pentru asta — este prea mult, deoarece majoritatea jocurilor necesită între 16 și 33 milisecunde pentru a efectua toată procesarea și a trece la următorul cadru grafic.
- Ideal ar fi ca măcar o parte din sistem să fie gestionată de date, astfel încât „neprogramatorii” să poată face modificări și să corectările să aibă loc mai repede.
Să luăm în considerare abordările IA care acoperă întregul ciclu Sense/Think/Act.
Luarea deciziilor de bază
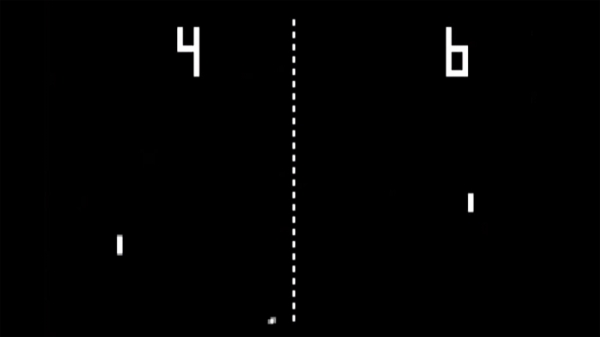
Să începem cu cel mai simplu joc - Pong. Scopul: mutați platforma (paddle) astfel încât mingea să ricoșeze de pe ea, nu să treacă pe lângă. Este ca tenisul, în care pierdeți dacă nu lovești mingea. Aici, AI-ul are o sarcină relativ ușoară - să decidă în ce direcție să miște platforma.
Operatori condiționali
Pentru AI în Pong, există o soluție evidentă - să încerce întotdeauna să poziționeze platforma sub minge.
Un algoritm simplu pentru aceasta, scris în pseudocod:
în fiecare cadru/update atâta timp cât jocul este în desfășurare:
dacă mingea este la stânga platformei:
mișcă platforma la stânga
alt dacă mingea este la dreapta platformei:
mișcă platforma la dreapta
Dacă platforma se mișcă cu viteza mingii, atunci acesta este algoritmul ideal pentru AI în Pong. Nu este necesar să complicăm lucrurile, dacă datele și posibilele acțiuni pentru agent nu sunt atât de multe.
Această abordare este atât de simplă, încât întregul ciclu Sense/Think/Act este barely noticeable. Dar există:
- Partea Sense se află în cele două operatori if. Jocul știe unde este mingea și unde este platforma, deci AI-ul îi cere aceste informații.
- Partea Think se încadrează, de asemenea, în cele două operatori if. Ele întruchipează cele două soluții, care în acest caz sunt exclusiv active. Ca rezultat, se alege una dintre cele trei acțiuni - mutați platforma la stânga, mutați la dreapta sau nu faceți nimic dacă aceasta este deja poziționată corect.
- Partea Act se află în operatorii Move Paddle Left și Move Paddle Right. În funcție de designul jocului, acestea pot mișca platforma instantaneu sau cu o anumită viteză.
Astfel de abordări sunt denumite reactive - există un set simplu de reguli (în acest caz, operatorii if în cod), care reacționează la starea curentă a lumii și acționează.
Arbore decizional
Exemplul cu jocul Pong este, de fapt, echivalent cu conceptul formal de AI, numit arbore decizional. Algoritmul îl parcurge pentru a ajunge la „frunza” - decizia cu privire la ce acțiune să întreprindă.
Să facem un diagramă a arborelui decizional pentru algoritmul platformei noastre:
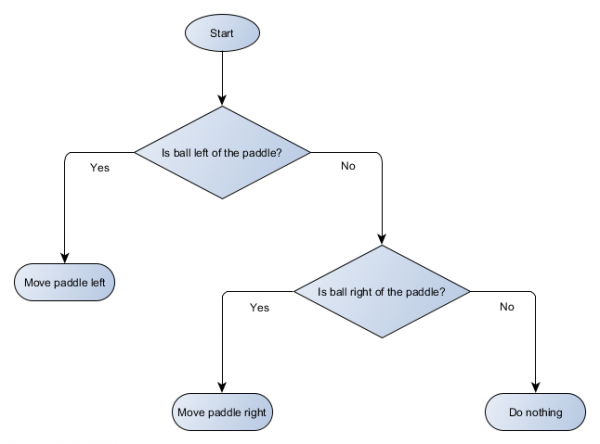
Fiecare parte a arborelui se numește node (nod) - AI-ul folosește teoria grafurilor pentru a descrie structuri similare. Există două tipuri de noduri:
- Noduri de decizie: alegerea între două alternative pe baza verificării unei anumite condiții, unde fiecare alternativă este reprezentată sub formă de nod separat.
- Noduri terminale: acțiunea de realizat, care reprezintă decizia finală.
Algoritmul începe cu primul nod („rădăcina” arborelui). Acesta decide fie la ce nod copil să treacă, fie execută o acțiune stocată în nod și se finalizează.
Care este avantajul, dacă arborele decizional realizează aceeași muncă ca operatorii if din secțiunea anterioară? Există un sistem comun, în care fiecare decizie are o singură condiție și două rezultate posibile. Acest lucru permite dezvoltatorului să construiască AI din date care reprezintă decizii în arbore, evitând hardcodarea acestora. Să ne imaginăm sub formă de tabel:
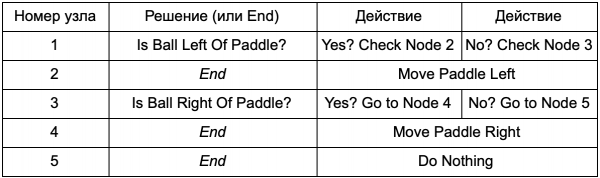
Pe partea de cod, veți obține un sistem pentru citirea liniilor. Creați un nod pentru fiecare dintre ele, conectați logica de luare a deciziilor pe baza celei de-a doua coloane și nodurile copil pe baza celor de-a treia și a patra coloane. Trebuie să programați încă condițiile și acțiunile, dar acum structura jocului va fi mai complexă. Aici adăugați decizii și acțiuni suplimentare și, apoi, ajustați întregul AI, modificând pur și simplu un fișier text cu definiția arborelui. Apoi, transferați fișierul designerului de jocuri, care poate schimba comportamentul fără a recompila jocul și a modifica codul.
Arborii decizionali sunt foarte utili atunci când sunt construiți automat pe baza unui set mare de exemple (de exemplu, folosind algoritmul ID3). Acest lucru le face un instrument eficient și performant pentru clasificarea situațiilor pe baza datelor obținute. Cu toate acestea, depășim o simplă sistem pentru selectarea acțiunilor de către agenți.
Scenarii
Am analizat sistemul arborelui decizional care utiliza condiții și acțiuni create anterior. Persoana care proiectează AI-ul poate organiza arborele așa cum dorește, dar încă trebuie să se bazeze pe programatorul care a scris tot codul. Ce ar fi dacă am putea oferi designerului instrumente pentru a crea propriile condiții sau acțiuni?
Pentru a evita ca programatorul să scrie cod pentru condițiile Is Ball Left Of Paddle și Is Ball Right Of Paddle, el poate construi un sistem în care designerul să înregistreze condițiile pentru a verifica aceste valori. Atunci datele arborelui decizional vor arăta astfel:
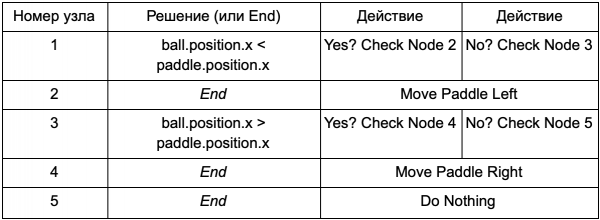
În esență, aceasta este la fel ca în prima tabelă, însă soluțiile au propriul cod, ceva asemănător cu partea condițională a operatorului if. Din punct de vedere al codului, acest lucru ar fi citit în a doua coloană pentru nodurile de decizie, dar în loc să caute o condiție specifică de executat (Este mingea la stânga paletei), evaluează expresia condițională și returnează true sau false în consecință. Aceasta se face cu ajutorul limbajului de scripting Lua sau Angelscript. Prin acestea, dezvoltatorul poate manipula obiectele din jocul său (mingea și paleta) și poate crea variabile utilizabile în scenariul (ball.position). În plus, limbajul de scripting este mai simplu decât C++. Nu necesită o etapă completă de compilare, fiind astfel ideal pentru ajustarea rapidă a logicii de joc și permițând „non-programatorilor” să creeze ei înșiși funcțiile dorite.
În exemplul oferit, limbajul de scripting este folosit doar pentru a evalua expresia condițională, însă poate fi utilizat și pentru acțiuni. De exemplu, datele Move Paddle Right pot deveni un operator de scripting (ball.position.x += 10). Astfel, acțiunea este definită și în script, fără a necesita programarea Move Paddle Right.
Se poate merge și mai departe și se poate scrie complet un arbore de decizie în limbajul de scripting. Acesta va fi cod sub formă de operatori condiționali hardcoded, dar vor fi în fișiere externe de script, ceea ce înseamnă că pot fi modificate fără a re-compila întreaga programă. Adesea, fișierul scriptului poate fi modificat chiar în timpul jocului, pentru a testa rapid diferite reacții ale AI-ului.
Reacționarea la evenimente
Exemplele de mai sus se aplică perfect în Pong. Acestea rulează continuu un ciclu Sens/Reflectare/Acțiune și acționează pe baza ultimei stări a lumii. Însă în jocuri mai complexe, este necesar să se reacționeze la evenimente individuale, nu să se evalueze totul deodată. În acest caz, Pong nu mai este un exemplu adecvat. Să alegem altceva.
Imaginați-vă un shooter, unde inamicii sunt nemișcați până când descoperă jucătorul, după care acționează în funcție de „specializarea” lor: unii vor alerga „rush”, alții vor ataca de la distanță. Aceasta este în continuare o sistem de reacție de bază – „dacă jucătorul este văzut, atunci fă ceva” – dar poate fi logic împărțit în evenimentul Jucător Văzut (player seen) și reacția (alege un răspuns și execută-l).
Aceasta ne întoarce la ciclul Sense/Think/Act. Putem programa partea de Sense care va verifica în fiecare cadru dacă AI-ul vede jucătorul. Dacă nu, nu se întâmplă nimic, dar dacă vede, se creează un eveniment Player Seen. Codul va avea o secțiune separată care spune: „când are loc evenimentul Player Seen, fă ”, unde reprezintă răspunsul de care ai nevoie pentru a te referi la părțile Think și Act. Astfel, vei configura reacțiile la evenimentul Player Seen: pentru personajul „gălăgios” – ChargeAndAttack, iar pentru lunetist – HideAndSnipe. Aceste legături pot fi create în fișierul de date pentru a fi editate rapid fără a fi nevoie să recompili toate. Și aici se poate folosi un limbaj de script.
Acceptarea deciziilor complexe
Deși sistemele simple de reacție sunt foarte eficiente, există multe situații în care acestea sunt insuficiente. Uneori, este necesar să ia decizii diferite, bazate pe ceea ce agentul face în acel moment, dar a prezenta acest lucru ca o condiție este dificil. Uneori există prea multe condiții pentru a le reprezenta eficient într-un arbore de decizie sau script. Uneori, este necesar să evaluăm din timp cum se va schimba situația înainte de a lua o decizie cu privire la următorul pas. Pentru a rezolva aceste probleme, sunt necesare abordări mai complexe.
Mașina de stare finită
Mașina de stare finită sau FSM (finite state machine) este un mod de a spune că agentul nostru se află în prezent într-o stare din mai multe posibile, și că poate trece dintr-o stare în alta. Există un număr prestabilit de astfel de stări – de aici și numele. Cel mai bun exemplu din viață este semaforul. În diferite locuri sunt diferite secvențe de lumini, dar principiul este același – fiecare stare reprezintă ceva (stai, mergi etc.). Semaforul se află într-o singură stare în orice moment dat, și trece de la una la alta pe baza unor reguli simple.
Cu NPC-urile din jocuri, povestea este similară. Ca exemplu, să luăm un gardian cu următoarele stări:
- Patrulând (Patrolling).
- Atacând (Attacking).
- Fugind (Fleeing).
Iar condițiile pentru schimbarea stării sale sunt:
- Dacă gardianul vede un inamic, atacă.
- Dacă gardianul atacă, dar nu mai vede inamicul, se întoarce la patrulare.
- Dacă gardianul atacă, dar este rănit grav, fuge.
De asemenea, putem scrie if-operatori cu variabila de stare a gardianului și diverse verificări: există un dușman în apropiere, care este nivelul de sănătate al NPC-ului etc. Să adăugăm câteva stări suplimentare:
- Inactivitate (Idling) — între patrulări.
- Căutare (Searching) — când dușmanul observat s-a ascuns.
- A cere ajutor (Finding Help) — când un dușman este observat, dar este prea puternic pentru a lupta cu el singur.
Alegerile fiecăruia sunt limitate — de exemplu, gardianul nu va merge să caute dușmanul ascuns dacă are sănătate scăzută.
În cele din urmă, o listă uriașă de «dacă <x и y, но не z>, atunci <p>», poate deveni prea voluminoasă, așa că ar trebui să formalizăm o metodă care să ne permită să reținem stările și tranzițiile între stări. Pentru a face acest lucru, vom lua în considerare toate stările și, sub fiecare stare, vom nota o listă cu toate tranzițiile către alte stări, împreună cu condițiile necesare pentru acestea.
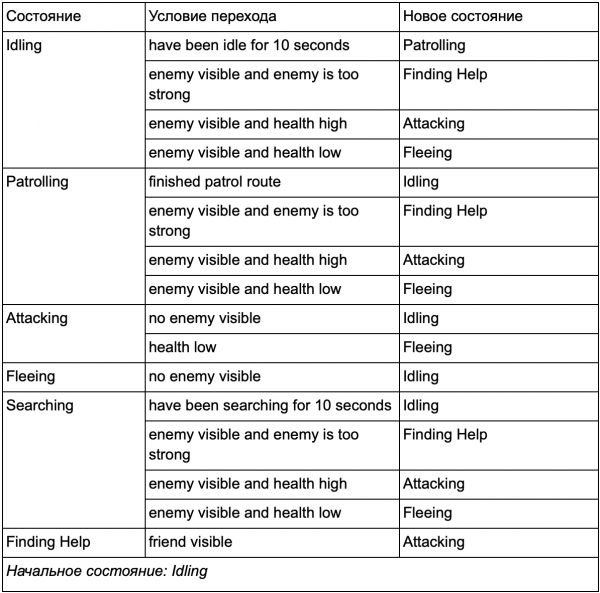
Aceasta este o tabelă a tranzițiilor de stare — o modalitate complexă de a reprezenta FSM. Să desenăm o diagramă și să obținem o imagine de ansamblu completă a modului în care se schimbă comportamentul NPC-ului.
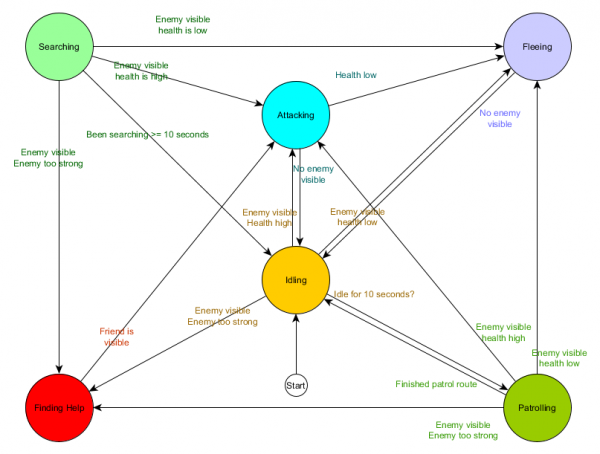
Diagrama reflectă esența luării deciziilor pentru acest agent pe baza situației curente. Fiecare săgeată arată o tranziție între stări, dacă condiția alăturată este adevărată.
La fiecare actualizare, verificăm starea curentă a agentului, examinăm lista de tranziții și, dacă condițiile pentru tranziție sunt îndeplinite, acesta își schimbă starea. De exemplu, la fiecare cadru, se verifică dacă timerul de 10 secunde a expirat, iar dacă da, atunci din starea Idling, gardianul trece în Patrolling. În același mod, starea Attacking verifică sănătatea agentului — dacă este scăzută, trece în starea Fleeing.
Aceasta este procesarea tranzițiilor între stări, dar ce zici de comportamentul legat de stările în sine? În ceea ce privește implementarea comportamentului efectiv pentru o stare specifică, de obicei există două tipuri de „hook-uri”, unde atribuim acțiuni la FSM:
- Acțiuni pe care le executăm periodic pentru starea curentă.
- Acțiuni pe care le întreprindem când trecem dintr-o stare în alta.
Exemple pentru primul tip. Starea Patrolling va muta agentul pe traseul de patrulare la fiecare cadru. Starea Attacking va încerca, la fiecare cadru, să înceapă un atac sau să treacă într-o stare când acest lucru este posibil.
Pentru al doilea tip, să examinăm tranziția „dacă inamicul este vizibil și inamicul este prea puternic, atunci treceți într-o stare de Găsire Ajutor. Agentul trebuie să aleagă unde să meargă pentru ajutor și să păstreze această informație, astfel încât starea Găsire Ajutor să știe către cine să se adreseze. Odată ce ajutorul este găsit, agentul revine la starea Atacare. În acel moment, el va dori să informeze un aliat despre amenințare, motiv pentru care poate apărea acțiunea NotificarePrietenDespreAmenințare.
Și din nou, putem privi acest sistem prin prisma ciclului Simte/Gândește/Acționează. Simte se întruchipează în datele utilizate în logica tranziției. Gândește — în tranzițiile disponibile în fiecare stare. Iar Acționează se realizează prin acțiunile desfășurate periodic în cadrul stării sau la tranzițiile dintre stări.
Uneori, sondajul continuu al condițiilor de tranziție poate fi costisitor. De exemplu, dacă fiecare agent ar efectua calcule complexe în fiecare cadru pentru a determina dacă vede inamicii și pentru a înțelege dacă poate trece de la starea Patrulare la Atacare — acest lucru va consuma mult timp de procesor.
Schimbările importante în starea lumii pot fi considerate evenimente care vor fi procesate pe măsură ce apar. În loc ca FSM să verifice în fiecare cadru condiția de tranziție „poate agentul meu să-l vadă pe jucător?”, se poate configura un sistem separat pentru a efectua verificările mai rar (de exemplu, de 5 ori pe secundă). Iar rezultatul va fi emiterea Player Seen, atunci când verificarea trece.
Aceasta se transmite în FSM, care acum trebuie să treacă la condiția 'Eveniment Player Seen primit' și să reacționeze corespunzător. Comportamentul final este același, cu excepția unei întârzieri aproape imperceptibile înainte de răspuns. Dar performanța a îmbunătățit în urma separării părții Sense într-o parte separată a programului.
Mașină de stări finite ierarhică
Cu toate acestea, lucrul cu FSM mari nu este întotdeauna convenabil. Dacă dorim să extindem starea de atac, înlocuind-o cu atacuri Mâini (MeleeAttacking) și atacuri la distanță (RangedAttacking), va trebui să modificăm tranzițiile din toate celelalte stări care duc la starea Atacare (cele actuale și viitoare).
Cu siguranță ați observat că în exemplul nostru există multe tranziții duplicate. Cele mai multe tranziții în starea Idling sunt identice cu cele din starea Patrolling. Ar fi bine să evităm redundanța, mai ales dacă adăugăm mai multe stări asemănătoare. Are sens să grupăm Idling și Patrolling sub o etichetă comună „non-combate”, unde există un singur set comun de tranziții către stările de luptă. Dacă ne imaginăm această etichetă ca o stare, Idling și Patrolling devin sub-stări. Exemplu de utilizare a unei tabele separate de tranziții pentru noua sub-stare non-combat:
Stările principale:
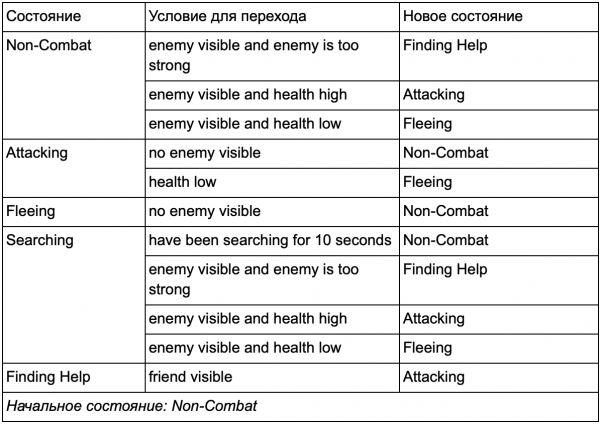
Starea în afara luptei:
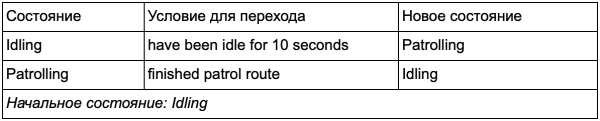
Și sub formă de diagramă:
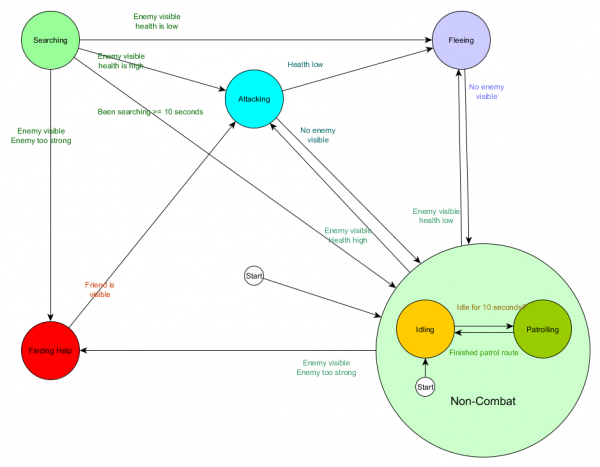
Aceasta este aceeași sistemă, dar cu o nouă stare non-combat, care include Idling și Patrolling. Fiecare stare conține un FSM cu sub-stări (iar aceste sub-stări, la rândul lor, conțin propriile FSM – și așa mai departe cât de mult este necesar), obținem așa-numitul Hierarchical Finite State Machine sau HFSM (mașină de stări finite ierarhică). Grupând starea non-combat, am eliminat multe tranziții redundante. Același lucru îl putem face pentru orice noi stări cu tranziții comune. De exemplu, dacă în viitor extindem starea Attacking la stările MeleeAttacking și MissileAttacking, acestea vor fi sub-stări care se vor tranzita între ele pe baza distanței față de inamic și a disponibilității munițiilor. În final, modele complexe de comportament și submodele de comportament pot fi reprezentate cu un minim de tranziții duplicate.
Arborele comportamentelor
Cu HFSM se creează combinații complexe de comportamente într-un mod simplu. Cu toate acestea, există o mică dificultate, deoarece luarea deciziilor sub formă de reguli de tranziție este strâns legată de starea curentă. Și în multe jocuri, acest lucru este exact ceea ce este necesar. O utilizare atentă a ierarhiei de stări poate reduce numărul de redundanțe în tranziții. Dar uneori sunt necesare reguli care să funcționeze indiferent de starea în care vă aflați sau care se aplică aproape în orice stări. De exemplu, dacă sănătatea agentului scade sub 25%, v-ar plăcea să fugă indiferent dacă se află în luptă, se află în repaus sau discută – va trebui să adăugați această condiție în fiecare stare. Și dacă designerul dumneavoastră va dori mai târziu să schimbe pragul de sănătate scăzut de la 25% la 10%, va trebui să se ocupe din nou de acest lucru.
Ideal pentru această situație este un sistem în care deciziile „în ce stare să ne aflăm” se află în afara stărilor în sine, astfel încât modificările să fie realizate într-un singur loc, fără a afecta condițiile de tranziție. Aici apar arborii comportamentali.
Există mai multe modalități de a le implementa, dar esența pentru toate este aproximativ aceeași și seamănă cu un arbore de decizie: algoritmul începe cu un nod „rădăcină”, iar în arbore se află noduri care reprezintă fie decizii, fie acțiuni. Totuși, există câteva diferențe cheie:
- Acum nodurile returnează unul dintre cele trei valori: Succeeded (dacă operațiunea a fost finalizată), Failed (dacă nu se poate porni) sau Running (dacă este încă în desfășurare și nu există un rezultat final).
- Nu mai există noduri de decizie pentru a alege între două alternative. În locul lor există noduri Decorator, care au un singur nod copil. Dacă acestea reușesc, atunci execută nodul lor unic copil.
- Nodurile care efectuează acțiuni returnează valoarea Running pentru a reprezenta acțiunile în desfășurare.
Această mică serie de noduri poate fi combinată pentru a crea un număr mare de modele complexe de comportament. Să ne imaginăm HFSM-ul unui garda din exemplul anterior sub forma unui arbore comportamental:
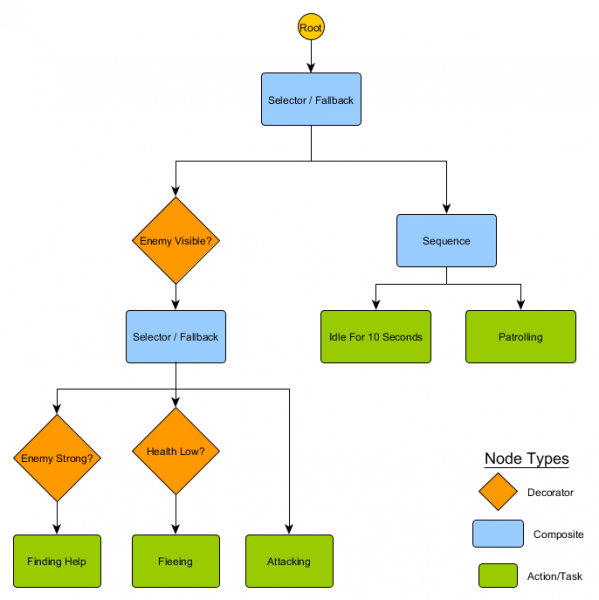
Cu această structură, nu ar trebui să existe o tranziție explicită de la stările Idling/Patrolling la starea Attacking sau la alte stări. Dacă inamicul este vizibil și sănătatea personajului este scăzută, execuția se va opri la nodul Fleeing, indiferent de nodul pe care l-a executat anterior — Patrolling, Idling, Attacking sau oricare altul.
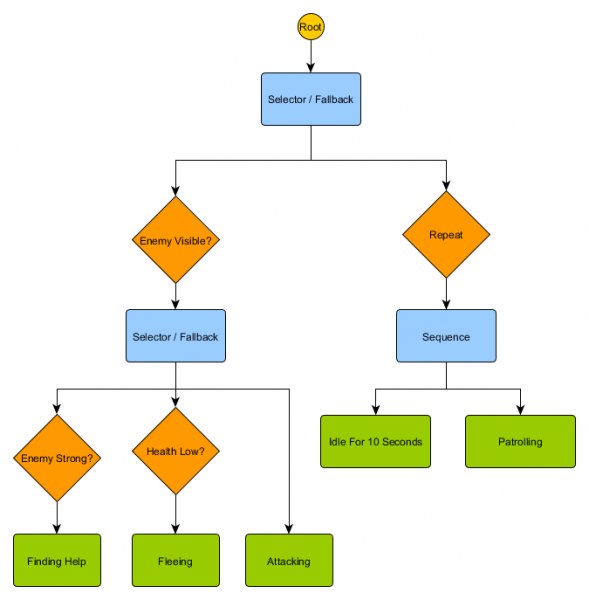
Arborii comportamentali sunt complecși — există multe modalități de a-i construi, iar găsirea combinației corecte de decoratori și noduri compuse poate fi problematică. Există, de asemenea, întrebări despre cât de des să verificăm arborele — vrem să trecem prin fiecare parte a acestuia sau doar atunci când una dintre condiții s-a schimbat? Cum să păstrăm starea asociată nodurilor — cum să știm când am fost în starea Idling timp de 10 secunde sau cum să știm ce noduri au fost executate ultima dată, pentru a gestiona corect secvența?
Exact din acest motiv există numeroase implementări. De exemplu, în unele sisteme, nodurile decorator au fost înlocuite cu decoratori încorporați. Aceștia reevaluează arborele atunci când condițiile decoratorului se schimbă, ajută la conectarea nodurilor și oferă actualizări periodice.
Sistem bazat pe utilitate
Unele jocuri au multe mecanici diferite. Este de dorit ca acestea să beneficieze de toate avantajele regulilor simple și generale de tranziție, dar nu este obligatoriu să fie sub forma unui arbore comportamental complet. În loc să existe un set clar de alegeri sau un arbore de acțiuni posibile, este mai simplu să studiem toate acțiunile și să alegem pe cea mai potrivită în acel moment.
Un sistem bazat pe utilitate va ajuta exact în acest sens. Este un sistem în care agentul are o multitudine de acțiuni și alege singur pe care să o execute, bazându-se pe utilitatea relativă a fiecărei acțiuni. Aici, utilitatea este o măsură arbitrară a cât de importantă sau dorită este executarea acestei acțiuni pentru agent.
Calculând utilitatea acțiunii pe baza stării curente și a mediuului, agentul poate verifica și alege cel mai potrivit alt stat în orice moment. Acest lucru este similar cu un FSM, cu excepția faptului că tranzițiile sunt determinate de evaluarea pentru fiecare stare potențială, inclusiv starea curentă. Rețineți că alegem cea mai utilă acțiune pentru tranziție (sau rămânem, dacă deja am realizat-o). Pentru o diversitate mai mare, aceasta poate fi o alegere ponderată, dar aleatorie, dintr-o mică listă.
Sistemul atribuie un interval aleator de valori de utilitate — de exemplu, de la 0 (complet nedorit) la 100 (complet dorit). Fiecare acțiune are o serie de parametri care influențează calcularea acestei valori. Revenind la exemplul nostru cu gardianul:
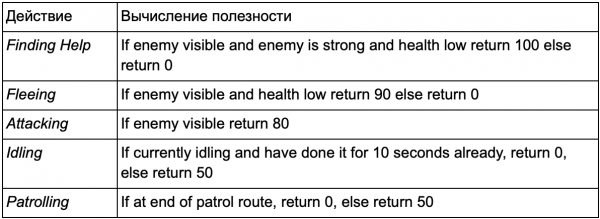
Tranzițiile între acțiuni sunt ambigue — orice stare poate urma după oricare alta. Prioritățile acțiunilor sunt în valorile de utilitate returnate. Dacă inamicul este vizibil, iar acest inamic este puternic, iar sănătatea personajului este scăzută, atunci atât Fleeing, cât și FindingHelp vor returna valori mari, nenule. În acest caz, FindingHelp va fi întotdeauna mai mare. În mod similar, acțiunile non-combat nu returnează niciodată mai mult de 50, așa că vor fi întotdeauna sub cele de combate. Acest lucru trebuie luat în considerare atunci când se creează acțiuni și se calculează utilitatea lor.
În exemplul nostru, acțiunile returnează fie o valoare constantă fixă, fie una din două valori fixe. O sistem mai realist presupune returnarea unei evaluări dintr-un interval continuu de valori. De exemplu, acțiunea Fugă returnează valori de utilitate mai mari dacă sănătatea agentului este scăzută, iar acțiunea Atac returnează valori mai mici dacă inamicul este prea puternic. Din această cauză, acțiunea Fugă are prioritate față de Atac în orice situație în care agentul simte că nu are destulă sănătate pentru a învinge adversarul. Aceasta permite modificarea priorităților acțiunilor pe baza unui număr variat de criterii, făcând astfel abordarea mai flexibilă și variabilă decât un arbore de comportament sau un FSM.
Fiecare acțiune are multe condiții pentru calcularea programului. Acestea pot fi scrise într-un limbaj de scriptare sau sub forma unei serii de formule matematice. În The Sims, care simulează rutina zilnică a unui personaj, se adaugă un nivel suplimentar de calcule — agentul primește o serie de „motivații” care influențează evaluările de utilitate. Dacă personajul îi este foame, atunci în timp el va deveni și mai înfometat, iar rezultatul de utilitate al acțiunii Mâncare va crește până când personajul o va efectua, scăzând astfel nivelul foamei și restabilind valoarea Mâncă la zero.
Ideea de a alege acțiuni pe baza unui sistem de evaluări este destul de simplă, prin urmare sistemul bazat pe utilitate poate fi utilizat ca parte a proceselor de luare a deciziilor AI, nu ca o înlocuire completă a acestora. Un arbore de decizii poate solicita o evaluare de utilitate a două noduri fiu și poate alege pe cel cu o valoare mai mare. În mod similar, un arbore de comportament poate avea un nod compus de Utilitate pentru a evalua utilitatea acțiunilor, pentru a decide care element fiu să fie executat.
Mișcare și navigare
În exemplele anterioare, am avut o platformă pe care o mutam la stânga sau la dreapta și un gardian care patrula sau ataca. Dar cum anume procesăm mișcarea agentului pe o anumită perioadă de timp? Cum stabilim viteza, cum evităm obstacolele și cum planificăm ruta dacă a ajunge la destinație este mai complicat decât a merge în linie dreaptă? Să examinăm acest aspect.
Gestionare
În stadiul inițial, să presupunem că fiecare agent are o valoare a vitezei, care include cât de repede se mișcă și în ce direcție. Aceasta poate fi măsurată în metri pe secundă, kilometri pe oră, pixeli pe secundă etc. Amintindu-ne de ciclul Sense/Think/Act, ne putem imagina că partea de Think selectează viteza, iar partea de Act aplică această viteză agentului. De obicei, în jocuri există un sistem fizic care îndeplinește această sarcină pentru tine, evaluând valoarea vitezei fiecărui obiect și ajustând-o. Prin urmare, putem lăsa AI-ul cu o singură sarcină - să decidă ce viteză ar trebui să aibă agentul. Dacă se știe unde ar trebui să fie agentul, atunci trebuie să-l deplasăm în direcția corectă cu viteza stabilită. O ecuație foarte simplă:
desired_travel = destination_position – agent_position
Imaginează-ți o lume 2D. Agentul este în punctul (-2,-2), destinația undeva în nord-est în punctul (30, 20), iar calea necesară pentru agent pentru a ajunge acolo este (32, 22). Să presupunem că aceste poziții sunt măsurate în metri - dacă luăm viteza agentului ca fiind de 5 metri pe secundă, atunci vom scala vectorul nostru de deplasare și vom obține o viteză de aproximativ (4.12, 2.83). Cu aceste parametrii, agentul ar ajunge la destinație aproape după 8 secunde.
Valorile pot fi recalibrate în orice moment. Dacă agentul a fost la jumătatea drumului spre obiectiv, deplasarea ar fi fost jumătate din lungime, dar deoarece viteza maximă a agentului este de 5 m/s (am decis asta mai sus), viteza va fi aceeași. Acest lucru funcționează de asemenea pentru ținte în mișcare, permițând agentului să efectueze mici ajustări pe măsură ce acestea se deplasează.
Dar ne dorim mai multă variabilitate - de exemplu, să creștem încet viteza pentru a simula un personaj care se mișcă dintr-o stare de repaus către alergare. La fel se poate face și la final înainte de a se opri. Aceste caracteristici sunt cunoscute sub numele de comportamente de direcționare, fiecare având nume specifice: Seek (căutare), Flee (fugă), Arrival (sosire) etc. Ideea este că forțele de accelerație pot fi aplicate vitezei agentului, pe baza comparației între poziția agentului și viteza curentă cu punctul de destinație, pentru a utiliza diferite modalități de a se deplasa către obiectiv.
Fiecare comportament are un scop ușor diferit. Seek și Arrival sunt modalități de a muta agentul către destinație. Obstacle Avoidance (evitarea obstacolelor) și Separation (separarea) corectează mișcarea agentului pentru a ocoli obstacolele întâlnite pe calea către țintă. Alignment (alinirea) și Cohesion (coeziunea) mențin agenții împreună în timpul deplasării. Orice număr de comportamente de steering diferite poate fi sumat pentru a obține un singur vector de direcție având în vedere toți factorii. Un agent folosește comportamentele Arrival, Separation și Obstacle Avoidance pentru a se menține departe de pereți și alți agenți. Această abordare funcționează bine în locații deschise fără detalii suplimentare.
În condiții mai dificile, combinarea diferitelor comportamente funcționează mai prost — de exemplu, agentul poate rămâne blocat în perete din cauza conflictului dintre Arrival și Obstacle Avoidance. De aceea, trebuie să luăm în considerare opțiuni care sunt mai complexe decât simpla adunare a tuturor valorilor. O astfel de metodă este: în loc să adăugăm rezultatele fiecărui comportament, putem analiza mișcarea în diferite direcții și alege cea mai bună opțiune.
Cu toate acestea, în medii complexe cu impasuri și alegeri de direcție, avem nevoie de ceva și mai avansat.
Găsirea căii
Comportamentele de steering sunt excelente pentru mișcarea simplă pe teren deschis (teren de fotbal sau arenă), unde a ajunge de la A la B este un drum direct cu mici abateri în jurul obstacolelor. Pentru rute complexe, avem nevoie de pathfinding (găsirea căii), care este o modalitate de a explora lumea și de a lua decizii cu privire la traseul prin ea.
Cea mai simplă metodă este să suprapui o grilă pe fiecare pătrat adiacent agentului și să evaluezi în care dintre ele este permisă mișcarea. Dacă unul dintre ele este destinația, atunci urmează din acel pătrat pe traseul de la fiecare pătrat la cel anterior, până ajungi la început. Acesta este traseul. În caz contrar, repetă procesul cu cele mai apropiate pătrate, până când găsești destinația sau se termină pătratul (ceea ce înseamnă că nu există niciun traseu posibil). Acesta este ceea ce se cunoaște formal ca Search in Wider Area (Breadth-First Search sau BFS). La fiecare pas, acesta se uită în toate direcțiile (de aceea se numește „larg”). Spațiul de căutare seamănă cu un front de undă care se deplasează, până când ajunge la locul dorit - zona de căutare se extinde la fiecare pas până când ajunge la punctul final, după care se poate urmări traseul înapoi la început.
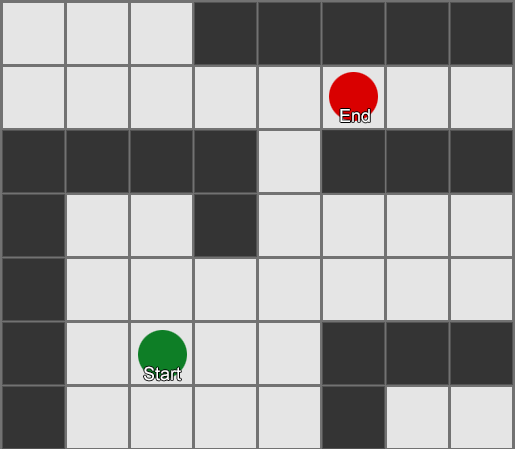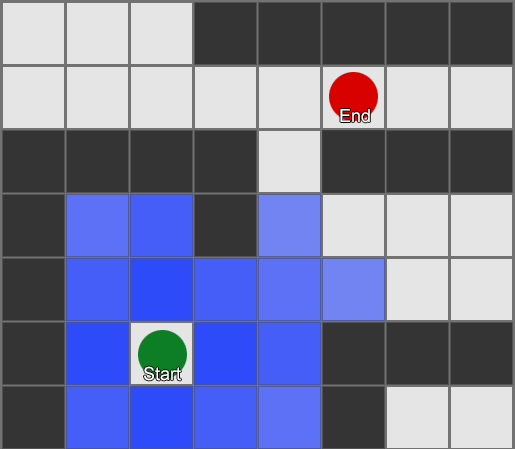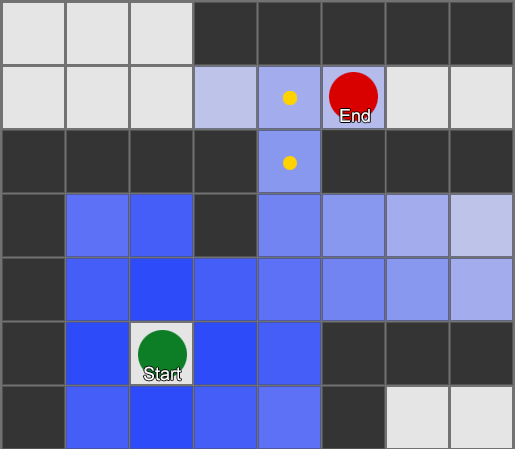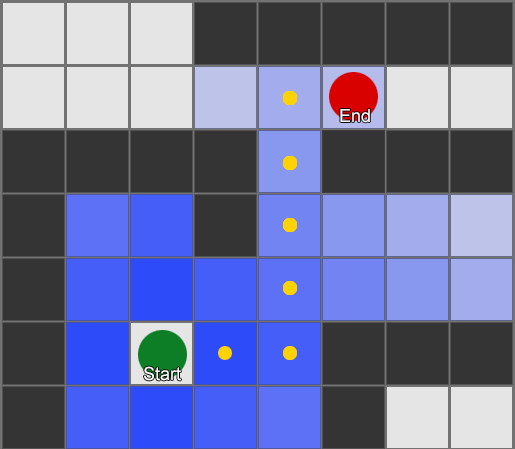
Ca rezultat, vei obține o listă de pătrate, care formează traseul dorit. Acesta este drumul (de aici, pathfinding) - o listă de locuri pe care agentul le va vizita, urmând către destinație.
Având în vedere că știm poziția fiecărui pătrat din lume, putem folosi comportamentele de direcționare pentru a ne deplasa pe traseu - de la nodul 1 la nodul 2, apoi de la nodul 2 la nodul 3 și așa mai departe. Cea mai simplă variantă este să te îndrepți către centrul pătratului următor, dar și mai bine este să te oprești la mijlocul marginii între pătratul curent și următorul. Astfel, agentul va putea să taie colțurile la viraje abrupte.
Algoritmul BFS are și dezavantaje - acesta explorează la fel de multe pătrate în direcția „greșită” ca și în direcția „corectă”. Aici intervine un algoritm mai complex numit A* (A star). Acesta funcționează similar, dar în loc să exploreze fără direcție pătratele vecine (apoi vecinii vecinilor, apoi vecinii vecinilor vecinilor și așa mai departe), acesta colectează nodurile într-o listă și le sortează astfel încât următorul nod explorat să fie întotdeauna cel care va conduce la cel mai scurt traseu. Nodurile sunt sortate pe baza unei heuristicii care ia în considerare două aspecte - „costul” traseului ipotetic către pătratul dorit (inclusiv orice costuri de deplasare) și o estimare a cât de departe este acest pătrat de destinație (îndreptând căutarea în direcția corectă).
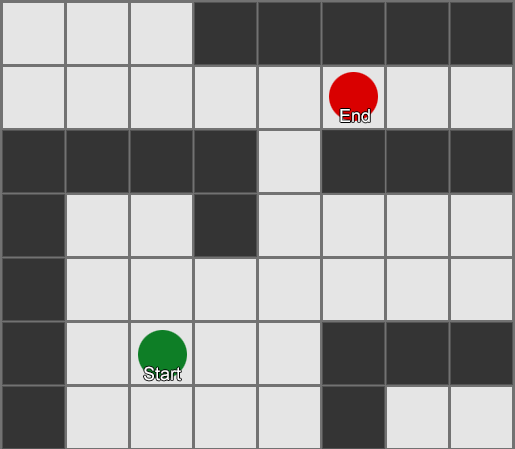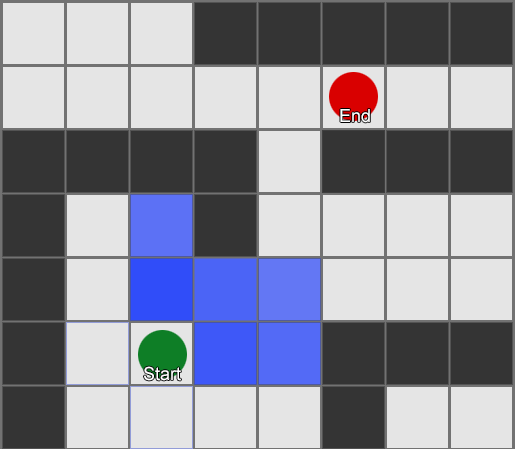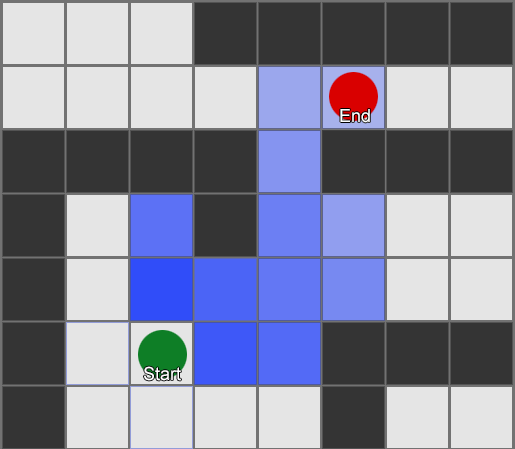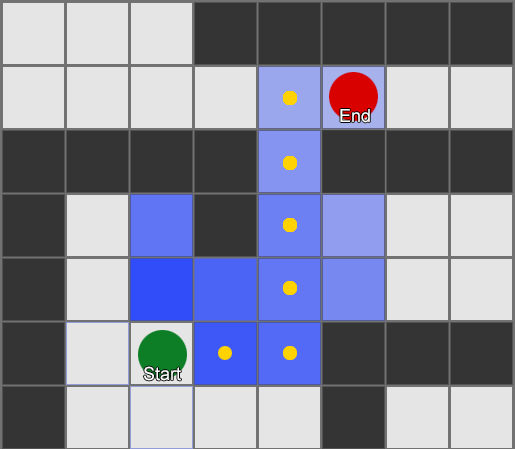
Acest exemplu arată că agentul explorează câte un pătrat pe rând, alegând de fiecare dată vecinul cel mai promițător. Calea obținută este aceeași ca în cazul BFS, dar în proces au fost examinati mai puțini pătrați — ceea ce contează foarte mult pentru performanța jocului.
Mișcare fără plasă
Dar majoritatea jocurilor nu sunt structurate pe o plasă și, adesea, nu este posibil să o realizăm fără a afecta realismul. Sunt necesare compromisuri. Ce dimensiuni ar trebui să aibă pătratele? Prea mari — și nu vor putea reda corect coridoarele sau virajele mici, prea mici — vor fi prea multe pătrate de căutat, ceea ce va dura o veșnicie.
Primul lucru de înțeles este că plasă ne oferă un graf de noduri interconectate. Algoritmii A* și BFS funcționează de fapt pe grafuri și nu le pasă deloc de plasa noastră. Am putea plasa nodurile în orice loc din lumea jocului: atâta timp cât există o legătură între orice două noduri conectate, precum și între punctul de start și cel de sosire și cel puțin unul dintre noduri — algoritmul va funcționa la fel de bine ca înainte. Adesea, acest lucru este numit sistem de puncte de navigare (waypoint), deoarece fiecare nod reprezintă o poziție semnificativă în lume, care poate face parte din orice număr de trasee ipotetice.
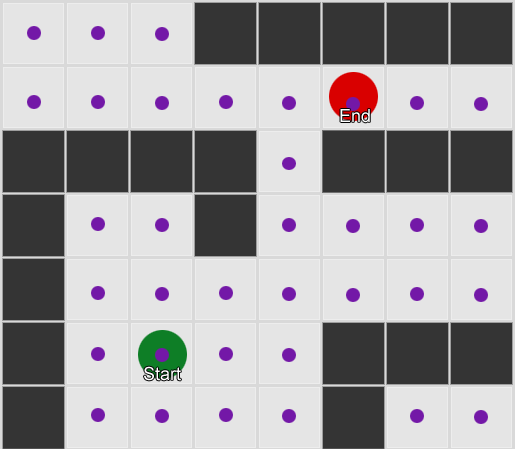
Exemplul 1: un nod în fiecare pătrat. Căutarea începe din nodul în care se află agentul și se termină în nodul pătratului dorit.
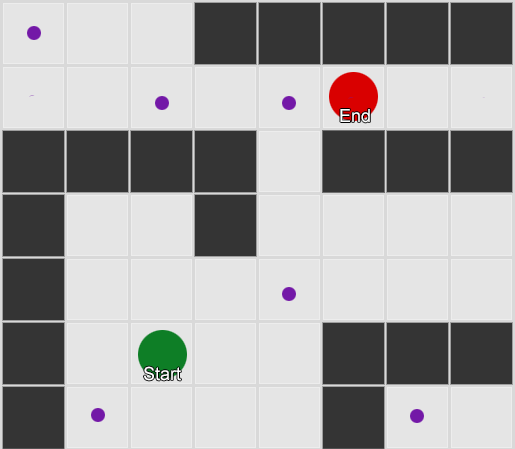
Exemplul 2: un set mai mic de noduri (puncte de navigare). Căutarea începe în pătratul cu agentul, trece printr-un număr necesar de noduri și apoi continuă până la destinație.
Aceasta este o sistemă destul de flexibilă și puternică. Dar este necesară o oarecare prudență în deciziile privind unde și cum să plasăm waypoint-urile, altfel agenții s-ar putea să nu vadă pur și simplu cea mai apropiată punct și să nu poată începe drumul. Ar fi mai ușor dacă am putea plasa automat punctele de navigare pe baza geometriei lumii.
Aici apare mesh-ul de navigare sau navmesh (plasa de navigare). Aceasta este, de obicei, o plasă 2D de triunghiuri, care se suprapune peste geometria lumii — peste tot unde agentului îi este permis să se miște. Fiecare dintre triunghiurile din plasă devine un nod în graf și are până la trei triunghiuri adiacente, care devin noduri vecine în graf.
Această imagine este un exemplu din motorul Unity — acesta a analizat geometria din lume și a creat navmesh (în captura de ecran, de culoare albastru deschis). Fiecare poligon din navmesh reprezintă o zonă pe care agentul poate sta sau se poate muta de la un poligon la altul. În acest exemplu, poligoanele sunt mai mici decât etajele pe care sunt situate — acest lucru este realizat pentru a ține cont de dimensiunile agentului, care vor depăși poziția sa nominală.
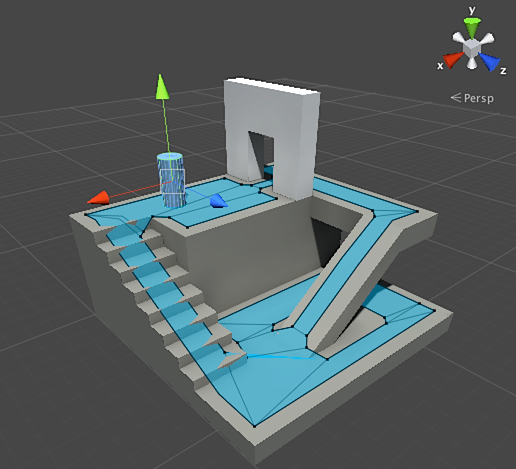
Putem căuta un traseu prin această rețea, utilizând din nou algoritmul A*. Acesta ne va oferi o rută aproape perfectă în lume, care ia în considerare toată geometria și în același timp nu necesită noduri suplimentare și crearea punctelor de referință.
Pathfinding-ul este o temă prea vastă, despre care nu poate fi acoperită într-o singură secțiune a articolului. Dacă doriți să o explorați mai detaliat, acest lucru vă va ajuta .
Planificare
Ne-am dat seama cu pathfinding că uneori nu este suficient să alegem o direcție și să mergem — trebuie să alegem o rută și să facem câteva întorsături pentru a ajunge la destinația dorită. Putem generaliza această idee: atingerea unui obiectiv nu este doar o simplă pas, ci este un întreg șir, unde uneori este necesar să privim înainte câțiva pași pentru a ști cum ar trebui să fie primul. Aceasta se numește planificare. Pathfinding poate fi considerat ca una dintre numeroasele completări ale planificării. Din perspectiva ciclului nostru Sense/Think/Act, aceasta este partea unde Thinking-ul planifică mai multe aspecte ale Act-ului pentru viitor.
Să luăm ca exemplu jocul de masă Magic: The Gathering. Noi jucăm primii cu următorul set de cărți în mână:
- Swamp — oferă 1 mană neagră (carte de pământ).
- Forest — oferă 1 mană verde (carte de pământ).
- Fugitive Wizard — necesită 1 mană albastră pentru a fi invocat.
- Elvish Mystic — necesită 1 mană verde pentru a fi invocat.
Ignorăm celelalte trei cărți pentru a simplifica. Conform regulilor, unui jucător îi este permis să joace 1 carte de pământ pe tură, el poate „tap” această carte pentru a extrage din ea mană, și apoi să folosească vrăji (inclusiv invocarea unei creaturi) în funcție de cantitatea de mană. În această situație, jucătorul uman știe că trebuie să joace Forest, să „tapeze” 1 mană verde și apoi să invoce Elvish Mystic. Dar cum poate ghici acest lucru inteligența artificială de joc?
Planificare simplă
Abordarea trivială este de a încerca fiecare acțiune pe rând, până când nu mai rămân opțiuni potrivite. Privind cărțile, IA vede că poate juca Swamp. Și îl joacă. Mai sunt alte acțiuni posibil de efectuat în această rundă? Nu poate chema nici Elvish Mystic, nici Fugitive Wizard, deoarece invocarea lor necesită, respectiv, mană verde și albastră, iar Swamp oferă doar mană neagră. Și nu va mai putea juca Forest, deoarece a jucat deja Swamp. Astfel, IA a acționat conform regulilor, dar a făcut-o prost. Există loc de îmbunătățire.
Planificarea poate găsi o listă de acțiuni care duc jocul în starea dorită. La fel cum fiecare pătrățel de pe calea de căutare are vecini, fiecare acțiune din plan are și ea vecini sau succesorii. Putem căuta aceste acțiuni și acțiunile ulterioare, până ajungem în starea dorită.
În exemplul nostru, rezultatul dorit este „a chema o ființă, dacă este posibil”. La începutul rundei, vedem doar două acțiuni posibile, permise de regulile jocului:
1. A juca Swamp (rezultatul: Swamp în joc)
2. A juca Forest (rezultatul: Forest în joc)
Fiecare acțiune acceptată poate duce la acțiuni suplimentare și poate închide altele, din nou în funcție de regulile jocului. Imaginați-vă că am jucat Swamp — acest lucru va elimina Swamp ca următor pas (l-am jucat deja), de asemenea va elimina și Forest (deoarece conform regulilor, putem juca o singură carte de teren pe tur). După aceasta, IA adaugă ca următor pas — obținerea a 1 mană neagră, pentru că nu există alte opțiuni. Dacă merge mai departe și alege să „tapeze” Swamp, va obține 1 unitate de mană neagră și nu va putea face nimic cu aceasta.
1. A juca Swamp (rezultatul: Swamp în joc)
1.1 „Tapare” Swamp (rezultatul: Swamp „tapată”, +1 unitate de mană neagră)
Nu există acțiuni disponibile – SFÂRȘIT
2. A juca Forest (rezultatul: Forest în joc)
Lista acțiunilor s-a scurtat, am ajuns într-un impas. Repetăm procesul pentru următoarea acțiune. Jucăm Forest, deschidem acțiunea „a obține 1 mană verde”, care la rândul ei va deschide a treia acțiune — invocarea Elvish Mystic.
1. A juca Swamp (rezultatul: Swamp în joc)
1.1 „Tapare” Swamp (rezultatul: Swamp „tapată”, +1 unitate de mană neagră)
Nu există acțiuni disponibile – SFÂRȘIT
2. A juca Forest (rezultatul: Forest în joc)
2.1 „Tapare” Forest (rezultatul: Forest „tapată”, +1 unitate de mană verde)
2.1.1 Invocare Elvish Mystic (rezultatul: Elvish Mystic în joc, -1 unitate de mană verde)
Nu există acțiuni disponibile – SFÂRȘIT
În cele din urmă, am studiat toate acțiunile posibile și am găsit un plan pentru a invoca o ființă.
Acesta este un exemplu foarte simplificat. Este recomandat să alegeți cel mai bun plan posibil, nu oricare care se încadrează în anumite criterii. De obicei, planurile pot fi evaluate pe baza rezultatului final sau a beneficiului total obținut din implementarea lor. Puteți obține 1 punct pentru a juca o carte de teren și 3 puncte pentru a chema o creatură. A juca Swamp ar fi un plan care oferă 1 punct. Iar a juca Forest → Tap the Forest → cheama Elvish Mystic — ar aduce imediat 4 puncte.
Așa funcționează planificarea în Magic: The Gathering, dar aceeași logică se aplică și în alte situații. De exemplu, mutând un pion pentru a face loc pentru o mișcare a unui nebun în șah. Sau ascunzându-te în spatele unui zid pentru a trage în siguranță în XCOM. În general, ați înțeles ideea.
Planificare îmbunătățită
Uneori există prea multe acțiuni potențiale pentru a lua în considerare fiecare variantă posibilă. Revenind la exemplul din Magic: The Gathering: să presupunem că în joc aveți mai multe cărți de teren și creaturi în mână — numărul combinațiilor posibile de mutări poate ajunge la zeci. Există mai multe soluții pentru această problemă.
Primul mod este chaining invers (backwards chaining). În loc să verificăm toate combinațiile, este mai bine să începem de la rezultatul final și să încercăm să găsim un drum direct. În loc de a merge de la rădăcina copacului la o frunză specifică, ne îndreptăm în direcția opusă — de la frunză la rădăcină. Această metodă este mai simplă și mai rapidă.
Dacă adversarul are 1 punct de sănătate, puteți găsi un plan „a provoca 1 sau mai multă daune”. Pentru a realiza acest lucru, trebuie să îndepliniți o serie de condiții:
1. Daunele pot fi provocate de un vrăjitor — acesta trebuie să fie în mână.
2. Pentru a juca vrăjitoria — este nevoie de mană.
3. Pentru a obține mană — trebuie să jucați o carte de teren.
4. Pentru a juca o carte de teren — trebuie să o aveți în mână.
O altă metodă este best-first search (căutarea celui mai bun întâi). În loc să verificăm toate căile, alegem cea mai potrivită. De cele mai multe ori, această metodă oferă un plan optim fără costuri inutile de căutare. A* este o formă de căutare a celui mai bun întâi — explorând cele mai promițătoare rute încă de la început, poate găsi deja cel mai bun drum fără a verifica celelalte variante.
O variant interesant și din ce în ce mai popular al căutării de tip best-first este Monte Carlo Tree Search. În loc să ghicească care planuri sunt cele mai bune la alegerea fiecărei acțiuni ulterioare, algoritmul alege succesorii aleatorii la fiecare pas, până ajunge la final (când planul conduce la victorie sau înfrângere). Rezultatul final este apoi folosit pentru a crește sau a scădea evaluarea „greutății” opțiunilor anterioare. Repetând acest proces de mai multe ori, algoritmul oferă o bună evaluare a următorului pas, chiar dacă situația se schimbă (dacă adversarul ia măsuri pentru a împiedica jucătorul).
În povestea despre planificarea în jocuri nu poate lipsi Goal-Oriented Action Planning sau GOAP (planificarea acțiunilor orientată spre obiective). Acesta este un metodă folosită și discutată pe larg, dar, în afară de câteva detalii distinctive, este, în esență, o metodă de backwards chaining, despre care am vorbit anterior. Dacă sarcina este „a distruge jucătorul”, iar jucătorul se află în spatele unei acoperiri, planul ar putea fi: distruge cu o grenadă → ia-o → arunc-o.
De obicei, există mai multe obiective, fiecare cu prioritatea sa. Dacă obiectivul cu cea mai mare prioritate nu poate fi îndeplinit (nici o combinație de acțiuni nu creează planul „a distruge jucătorul”, deoarece jucătorul nu este vizibil), AI-ul se va întoarce la obiectivele cu o prioritate mai mică.
Învățare și adaptare
Am mai spus că AI-ul din jocuri nu folosește de obicei învățarea automată, deoarece nu se potrivește pentru controlul agenților în timp real. Dar aceasta nu înseamnă că nu se poate lua ceva din acest domeniu. Vrem un adversar în shooter care poate învăța ceva. De exemplu, să învețe cele mai bune poziții de pe hartă. Sau un adversar în fighting care ar bloca combo-urile frecvent utilizate de jucător, motivându-l să utilizeze altele. Astfel, învățarea automată în aceste situații poate fi foarte utilă.
Statistici și probabilități
Înainte de a trece la exemple mai complexe, să ne dăm seama cât de departe putem ajunge, luând câteva măsurători simple și folosindu-le pentru a lua decizii. De exemplu, strategia în timp real – cum putem determina dacă un jucător poate începe un atac în primele minute ale jocului și ce apărare să pregătim împotriva acestuia? Putem analiza experiența anterioară a jucătorului pentru a înțelege care ar putea fi reacția sa viitoare. Începem cu faptul că nu avem astfel de date inițiale, dar le putem aduna — de fiecare dată când AI joacă împotriva unei persoane, poate înregistra timpul primului atac. După câteva sesiuni, vom obține o medie a timpului în care jucătorul va ataca în viitor.
Există o problemă cu valorile medii: dacă jucătorul a „atacat” de 20 de ori și a jucat încet de 20 de ori, valorile de care avem nevoie vor fi undeva la mijloc și nu ne vor oferi nimic util. O soluție ar fi să limităm datele de intrare – putem lua în considerare ultimele 20 de puncte.
O abordare similară este folosită pentru a evalua probabilitatea unor acțiuni specifice, presupunând că preferințele anterioare ale jucătorului vor fi aceleași în viitor. Dacă jucătorul ne atacă de cinci ori cu foc, de două ori cu fulgerul și o dată corp cu corp, este evident că preferă atacurile cu foc. Extrapolăm și vedem probabilitatea utilizării diferitelor tipuri de arme: foc=62,5%, fulger=25% și corp cu corp=12,5%. AI-ul nostru de joc trebuie să se pregătească pentru apărarea împotriva focului.
O altă metodă interesantă este utilizarea Naive Bayes Classifier (clasificator bayesian naiv) pentru a analiza cantități mari de date de intrare și a clasifica situația, astfel încât AI-ul să reacționeze corespunzător. Clasificatoarele bayesiene sunt celebre pentru utilizarea lor în filtrele de spam pentru e-mail. Acolo analizează cuvintele, le compară cu locurile unde aceste cuvinte au apărut anterior (în spam sau nu) și trag concluzii despre mesajele primite. Putem face același lucru chiar și cu mai puține date de intrare. Pe baza tuturor informațiilor utile pe care le vede AI-ul (de exemplu, ce unități inamice au fost create, sau ce vrăji folosesc, sau ce tehnologii au cercetat) și a rezultatului final (război sau pace, „atac” sau apărare etc.) — vom alege comportamentul potrivit pentru AI.
Toate aceste metode de învățare sunt suficiente, dar ideal ar fi să le utilizăm pe baza datelor din testare. Iar IA va învăța să se adapteze la diferitele strategii folosite de testerii dvs. IA care se adaptează la jucător după lansare poate deveni prea previzibil sau, dimpotrivă, prea greu de învins.
Adaptarea pe baza valorilor
Având în vedere conținutul lumii noastre de joc și regulile, putem schimba setul de valori care influențează luarea deciziilor, și nu doar să folosim datele de intrare. Procedăm astfel:
- Să lăsăm IA să adune date despre starea lumii și evenimentele cheie din timpul jocului (așa cum s-a menționat mai sus).
- Vom schimba câteva valori importante (value) pe baza acestor date.
- Vom implementa deciziile noastre bazate pe procesarea sau evaluarea acestor valori.
De exemplu, agentul are mai multe camere de ales pe harta unui shooter din perspectiva întâi. Fiecare cameră are valoarea sa, care determină cât de dorită este pentru a fi vizitată. IA alege aleatoriu în ce cameră să meargă, bazându-se pe valoarea respectivă. Apoi, agentul își amintește în ce cameră a fost ucis și scade valoarea acesteia (probabilitatea că se va întoarce acolo). Similar în situația inversă — dacă agentul distruge mulți inamici, atunci valoarea camerei crește.
Modelul Markov
Ce s-ar întâmpla dacă am folosi datele adunate pentru prognoză? Dacă ne amintim fiecare cameră în care vedem jucătorul pe o perioadă determinată, vom putea prezice în ce cameră ar putea merge jucătorul. Urmărind și înregistrând mișcările jucătorului prin camere (values), putem face prognoze.
Să luăm trei camere: roșie, verde și albastră. Şi de asemenea observațiile pe care le-am înregistrat în timpul vizionării unei sesiuni de joc:
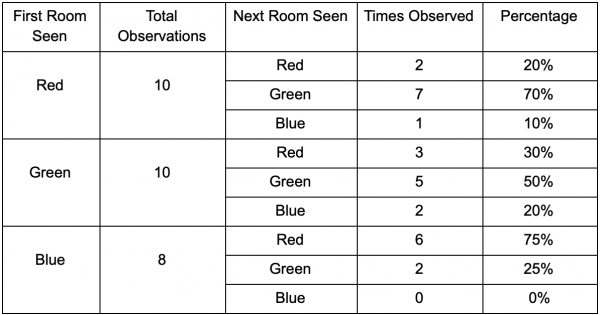
Numărul observațiilor pentru fiecare cameră este aproape egal — unde să facem un loc bun pentru o ambuscadă nu știm încă. Colectarea statisticilor este, de asemenea, complicată de respawnul jucătorilor, care apar uniform pe întreaga hartă. Dar datele despre următoarea cameră în care intră după apariția pe hartă sunt deja utile.
Este clar că camera verde îi satisface pe jucători — majoritatea oamenilor din camera roșie trec în ea, dintre care 50% rămân acolo în continuare. Camera albastră, dimpotrivă, nu este populară, în ea aproape că nu se intră, iar dacă se intră, nu se rămâne mult timp.
Dar datele ne spun ceva mai important — atunci când jucătorul se află în camera albastră, următoarea cameră în care îl vom vedea cel mai probabil va fi camera roșie, și nu cea verde. Deși camera verde este mai populară decât cea roșie, situația se schimbă atunci când jucătorul se află în camera albastră. Starea următoare (adică camera în care jucătorul va trece) depinde de starea anterioară (adică camera în care se află jucătorul în prezent). Datorită cercetării dependențelor, vom face prognoze mai precise decât dacă am număra pur și simplu observațiile independent unele de altele.
Previzionarea stării viitoare pe baza datelor din starea anterioară se numește model Markov (Markov model), iar exemplele de acest tip (cu camere) se numesc lanțuri Markov. Deoarece modelele reprezintă probabilitatea schimbărilor între stările consecutive, ele sunt reprezentate vizual sub forma unui FSM cu probabilități în jurul fiecărui tranziție. Anterior, am folosit FSM pentru a reprezenta starea comportamentală în care se afla agentul, dar această conceptie se extinde la orice stare, indiferent dacă este sau nu legată de agent. În acest caz, stările reprezintă camera ocupată de agent:
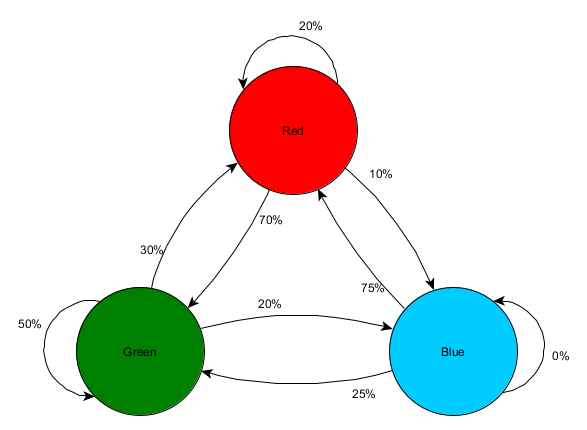
Aceasta este o variantă simplă de reprezentare a probabilității relative a schimbărilor de stări, oferind inteligenței artificiale o anumită capacitate de a prezice următoarea stare. Se pot anticipa mai multe pași înainte.
Dacă jucătorul se află în camera verde, există o șansă de 50% că va rămâne acolo la următoarea observație. Dar care este probabilitatea ca el să fie încă acolo și după aceea? Există nu doar șansa ca jucătorul să fi rămas în camera verde după două observații, ci și șansa că a plecat și s-a întors. Iată un nou tabel care ia în considerare noile date:
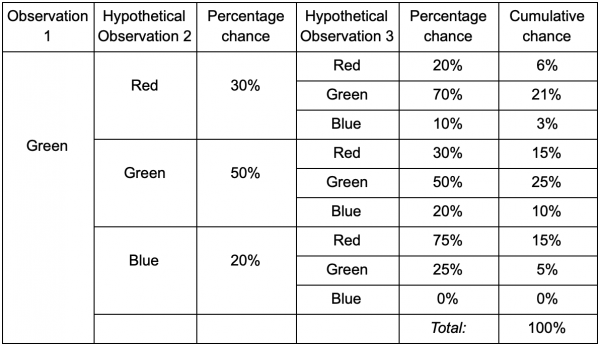
Din el reiese că șansa de a-l vedea pe jucător în camera verde după două observații va fi de 51% — 21%, că va veni din camera roșie, 5% dintre aceștia, că jucătorul va vizita camera albastră între ele, și 25%, că jucătorul nu va pleca deloc din camera verde.
Tabelul este doar un instrument vizual — procedura necesită doar multiplicarea probabilităților la fiecare pas. Aceasta înseamnă că poți privi departe în viitor cu o singură ajustare: presupunem că șansa de a intra într-o cameră depinde în totalitate de camera curentă. Acest lucru se numește proprietatea Markov (Markov Property) — starea viitoare depinde doar de prezent. Dar nu este 100% exact. Jucătorii pot schimba deciziile în funcție de alți factori: nivelul de sănătate sau numărul de muniție. Deoarece nu înregistrăm aceste valori, prognozele noastre vor fi mai puțin precise.
N-Grams
Dar ce zici de exemplul cu lupta și prezicerea combinațiilor de mișcări ale jucătorului? La fel! Dar în loc de o singură stare sau eveniment, vom explora întregi secvențe din care constă un combo.
Una dintre modalitățile de a face acest lucru este de a păstra fiecare intrare (de exemplu, Kick, Punch sau Block) într-un buffer și de a înregistra întregul buffer ca un eveniment. Așadar, jucătorul apasă repetat Kick, Kick, Punch pentru a folosi atacul SuperDeathFist, sistemul AI stochează toate intrările în buffer și reține ultimele trei utilizate la fiecare pas.
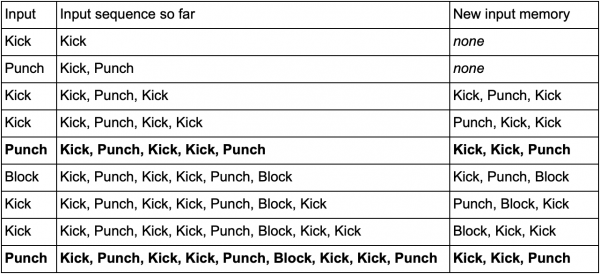
(Textul cu litere îngroșate arată momentele când jucătorul lansează atacul SuperDeathFist.)
AI-ul va vedea toate opțiunile când jucătorul a ales Kick, urmat de alt Kick, și apoi va observa că următoarea intrare este întotdeauna Punch. Acest lucru va permite agentului să prevadă combo-ul SuperDeathFist și să-l blocheze, dacă este posibil.
Aceste secvențe de evenimente se numesc N-gram-uri (N-grams), unde N este numărul de elemente stocate. În exemplul anterior, a fost un 3-gram (trigram), ceea ce înseamnă: primele două înregistrări sunt utilizate pentru a prezice a treia. Prin urmare, într-un 5-gram, primele patru înregistrări prezic a cincea și așa mai departe.
Dezvoltatorul trebuie să aleagă cu atenție dimensiunea N-gram-urilor. Un număr mai mic de N necesită mai puțină memorie, dar stochează și o istorie mai mică. De exemplu, un 2-gram (bigram) va înregistra Kick, Kick sau Kick, Punch, dar nu va putea stoca Kick, Kick, Punch, așa că AI-ul nu va reacționa la combo-ul SuperDeathFist.
Pe de altă parte, numerele mari necesită mai multă memorie și AI-ul va avea mai multe dificultăți în a învăța, deoarece vor apărea mult mai multe opțiuni posibile. Dacă ai avut trei intrări posibile Kick, Punch sau Block, iar noi am folosit un 10-gram, atunci ar ieși aproximativ 60 de mii de variante diferite.
Modelul bigramului este un lanț Markov simplu — fiecare pereche „stare anterioară/stare curentă” este un bigram, iar tu poți prezice a doua stare pe baza primei. Trigramul și n-gramurile mai mari pot fi, de asemenea, considerate lanțuri Markov, unde toate elementele (cu excepția ultimului din n-gram) formează împreună prima stare, iar ultimul element — a doua. Un exemplu din lupta arată șansa de tranziție de la starea Kick și Kick la starea Kick și Punch. Considerând mai multe înregistrări ale istoricului de intrare ca o unitate, practic transformăm secvența de intrare într-o parte a unei stări întregi. Aceasta ne oferă proprietatea Markov, permițând utilizarea lanțurilor Markov pentru a prezice următoarea intrare și a ghici ce mișcare de combinație va fi următoarea.
Concluzie
Am discutat despre cele mai comune instrumente și abordări în dezvoltarea inteligenței artificiale. De asemenea, am analizat situațiile în care acestea trebuie aplicate și unde sunt deosebit de utile.
Asta ar trebui să fie suficient pentru a înțelege lucrurile de bază în IA de joc. Dar, desigur, aceasta nu sunt toate metodele. Printre cele mai puțin populare, dar la fel de eficiente se numără:
- algoritmi de optimizare, inclusiv urcarea pe dealuri, coborârea prin gradient și algoritmi genetici
- algoritmi competiționali de căutare/planificare (minimax și tăierea alpha-beta)
- metode de clasificare (perceptroni, rețele neuronale și mașini cu vectori de suport)
- sisteme pentru procesarea percepției și memoriei agenților
- abordări arhitecturale pentru IA (sisteme hibride, submulțimi de arhitecturi și alte metode de suprapunere a sistemelor IA)
- instrumente de animație (planificarea și coordonarea mișcărilor)
- factori de performanță (nivelul de detaliu, algoritmii anytime și timeslicing)
Resursele online despre acest subiect:
1. Pe GameDev.net există , dar și pentru .
2. conține numeroase prezentări și articole pe o gamă largă de subiecte legate de dezvoltarea IA în jocuri.
3. include topicuri de la summitul GDC AI, multe dintre acestea fiind disponibile gratuit.
4. Materiale utile pot fi găsite de asemenea pe site-ul .
5. Tommy Thompson, cercetător în IA și dezvoltator de jocuri, face videoclipuri pe canalul său de YouTube cu explicații și studii despre IA în jocuri comerciale.
Cărți despre acest subiect:
1. Seria de cărți Game AI Pro este o colecție de articole scurte care explică cum să implementați funcții specifice sau cum să rezolvați probleme concrete.
2. Seria AI Game Programming Wisdom este predecesoarea seriei Game AI Pro. Aceasta conține metode mai vechi, dar aproape toate sunt relevante și astăzi.
3. — este unul dintre textele de bază pentru toți cei care doresc să înțeleagă domeniul general al inteligenței artificiale. Aceasta nu este o carte despre dezvoltarea de jocuri — ci învață conceptele de bază ale IA.
Sursa: habr.com
