

Bună, Habr! Eu sunt Artiom Karamișev, liderul echipei de administrare a sistemelor . În ultimul an, am avut multe lansări de produse noi. Am dorit să ne asigurăm că serviciile API sunt ușor scalabile, tolerante la erori și pregătite pentru creșterea rapidă a încărcăturii utilizatorilor. Platforma noastră este realizată pe OpenStack și vreau să vă povestesc despre problemele de toleranță la erori ale componentelor pe care a trebuit să le rezolvăm pentru a obține un sistem tolerante la erori. Cred că va fi interesant pentru cei care dezvoltă și produse pe OpenStack.
Toleranța generală la erori a platformei este formată din rezistența componentelor sale. Așa că vom parcurge treptat toate nivelurile la care am identificat riscuri și le-am rezolvat.
Versiunea video a acestei povești, care a avut ca sursă o prezentare de la conferința Uptime day 4, organizată de , poate fi vizionată .
Toleranța la erori a arhitecturii fizice
Partea publică a cloud-ului MCS se bazează acum pe două centre de date de nivel Tier III, între care există fibră optică proprie, rezervată la nivel fizic pe diferite trasee, cu o lățime de bandă de 200 Gbit/s. Nivelul Tier III asigură nivelul necesar de toleranță la erori pentru infrastructura fizică.
Fibră optică este rezervată atât la nivel fizic, cât și la nivel logic. Procesul de rezervare a canalelor a fost iterativ, au apărut probleme, iar noi îmbunătățim constant conexiunea între centrele de date.
De exemplu, nu cu mult timp în urmă, în timpul lucrărilor într-o fosa din apropierea unuia dintre centrele de date, o excavatoare a perforat un tub, iar în interiorul acestui tub se afla atât cablul optic principal, cât și cel de rezervă. Canalul nostru de comunicație tolerant la erori cu centrul de date a fost vulnerabil într-un singur punct, în fosa. Prin urmare, am pierdut o parte din infrastructură. Am învățat din aceasta, am luat o serie de măsuri, inclusiv am tras o fibră optică suplimentară prin fosa vecină.
Centrele de date au puncte de prezență ale furnizorilor de servicii, cărora le transmitem prefixelor noastre prin BGP. Pentru fiecare direcție de rețea se alege cea mai bună metrică, ceea ce permite asigurarea unei calități superioare a conexiunii pentru diferiți clienți. Dacă conexiunea printr-un furnizor se întrerupe, ne reconfigurăm rutarea prin furnizorii disponibili.
În caz de defecțiune a furnizorului, trecem automat la următorul. În cazul unei defecțiuni a unuia dintre centrele de date, avem o copie mirror a serviciilor noastre în cel de-al doilea centru de date, care preia întreaga sarcină.
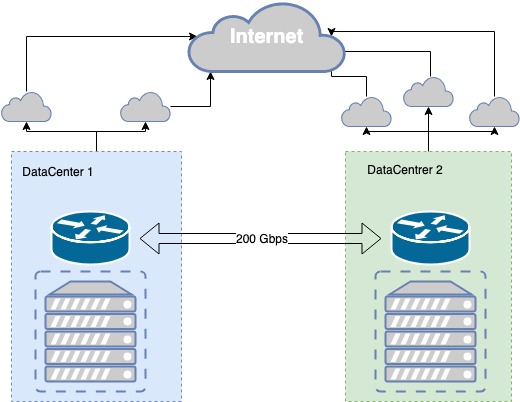
Rezistența la defecțiuni a infrastructurii fizice
Ce utilizăm pentru rezistența la defecțiuni la nivel de aplicații
Serviciul nostru este construit pe baza unui număr de componente open-source.
ExaBGP — un serviciu care implementează o serie de funcții folosind protocolul de rutare dinamic bazat pe BGP. Îl folosim activ pentru a anunța adresele noastre IP albe, prin care utilizatorii accesează API-ul.
HAProxy — un echilibrist de sarcină de mare capacitate, care permite configurarea unor reguli foarte flexibile de echilibrare a traficului la diferite niveluri ale modelului OSI. Îl folosim pentru echilibrarea în fața tuturor serviciilor: baze de date, brokeri de mesaje, servicii API, servicii web, proiecte interne — totul se află în spatele HAProxy.
Aplicația API — o aplicație web scrisă în Python, prin care utilizatorul își gestionează infrastructura și serviciul.
Aplicația Worker (denumită în continuare simplu worker) — în serviciile OpenStack, aceasta este un daemon de infrastructură care permite transmiterea comenzilor API către infrastructură. De exemplu, crearea unui disc are loc exact în worker, iar cererea de creare — în aplicația API.
Arhitectura standard a aplicației OpenStack
Cele mai multe servicii dezvoltate pentru OpenStack încearcă să urmeze o paradigmă unitară. Un serviciu constă de obicei din 2 părți: API și workeri (executoare de backend). În general, API-ul este o aplicație WSGI scrisă în Python, care este rulată fie ca un proces independent (daemon), fie cu ajutorul unui server web existent, cum ar fi Nginx sau Apache. API-ul procesează cererea utilizatorului și transmite instrucțiunile suplimentare aplicației worker. Transmiterea se face prin intermediul unui broker de mesaje, de cele mai multe ori RabbitMQ, celelalte fiind mai puțin suportate. Când mesajele ajung în broker, acestea sunt procesate de workerii care, dacă este necesar, returnează un răspuns.
Această paradigmă implică puncte de defecțiune izolate: RabbitMQ și baza de date. Totuși, RabbitMQ este izolat în cadrul unui singur serviciu și, în teorie, poate fi individual pentru fiecare serviciu. Așa că, în MCS, separăm la maxim aceste servicii; pentru fiecare proiect separat creăm o bază de date distinctă, un RabbitMQ separat. Această abordare este eficientă deoarece, în cazul unei avarii în câteva puncte vulnerabile, nu se defectează întregul serviciu, ci doar partea sa.
Numărul de aplicații worker nu este limitat, așa că API-ul poate fi ușor scalat orizontal prin intermediul echilibratorilor de sarcină pentru a crește performanța și rezistența la defecțiuni.
În unele servicii, este necesară coordonarea în cadrul serviciului — atunci când se desfășoară operațiuni secvențiale complexe între API și workeri. În acest caz, se folosește un singur centru de coordonare, un sistem de cluster gen Redis, Memcache, etcd, care permite unui worker să comunice altuia că această sarcină îi este alocată («tu, te rog, nu o lua»). Noi folosim etcd. De obicei, workerii comunică activ cu baza de date, scriind și citind informații din aceasta. Ca bază de date, folosim MariaDB, care se află într-un cluster mulți-maestru.
Un astfel de serviciu clasic unic este organizat într-un mod standard acceptat pentru OpenStack. Poate fi considerat un sistem închis, pentru care metodele de scalare și rezistență la defecțiuni sunt destul de evidente. De exemplu, pentru rezistența la defecțiuni a API-ului, este suficient să se plaseze un equilibrator de sarcină în fața acestora. Scalarea workerilor se realizează prin creșterea numărului acestora.
Punctul slab din întreaga schemă este RabbitMQ și MariaDB. Arhitectura lor merită un articol separat. În acest articol vreau să mă concentrez pe reziliența API-ului.
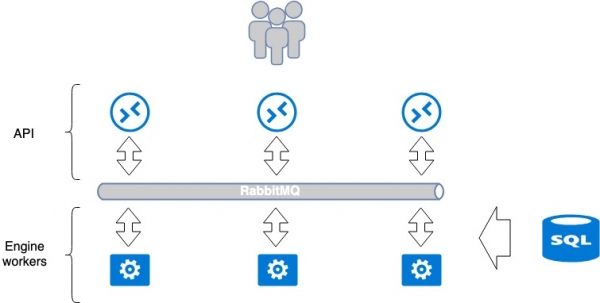
Arhitectura Openstack Application. Echilibrarea și reziliența platformei de cloud.
Facem echilibratorul HAProxy rezilient cu ajutorul ExaBGP.
Pentru ca API-urile noastre să fie scalabile, rapide și reziliente, le-am pus un echilibrator în față. Am ales HAProxy. Din punctul meu de vedere, acesta are toate caracteristicile necesare pentru sarcina noastră: echilibrare pe mai multe niveluri OSI, interfață de management, flexibilitate și scalabilitate, un număr mare de metode de echilibrare, suport pentru tabelele de sesiune.
Prima problemă pe care a trebuit să o rezolvăm a fost reziliența echilibratorului în sine. Simplă instalare a echilibratorului creează de asemenea un punct de eșec: dacă echilibratorul pică, serviciul se întrerupe. Pentru a evita acest lucru, am folosit HAProxy împreună cu ExaBGP.
ExaBGP permite implementarea unui mecanism de verificare a stării serviciului. Am folosit acest mecanism pentru a verifica funcționarea HAProxy și, în caz de probleme, a dezactiva serviciul HAProxy din BGP.
Schema ExaBGP+HAProxy.
- Instalăm pe trei servere software-ul necesar, ExaBGP și HAProxy.
- Pe fiecare dintre servere, creăm o interfață loopback.
- Pe toate cele trei servere, configurăm aceleași adrese IP publice pentru această interfață.
- Adresa IP publică este anunțată în internet prin ExaBGP.
Reziliența se obține prin anunțarea aceleași adrese IP de pe toate cele trei servere. Din punct de vedere al rețelei, aceeași adresă este disponibilă din trei next hop-uri diferite. Routerul vede trei rute identice, alege cea mai prioritară în funcție de metricile proprii (de obicei aceeași opțiune) și traficul merge doar pe unul dintre servere.
În caz de probleme cu funcționarea HAProxy sau căderea unui server, ExaBGP încetează să anunțe ruta, iar traficul se comută lin pe alt server.
Astfel, am obținut reziliența echilibratorului.
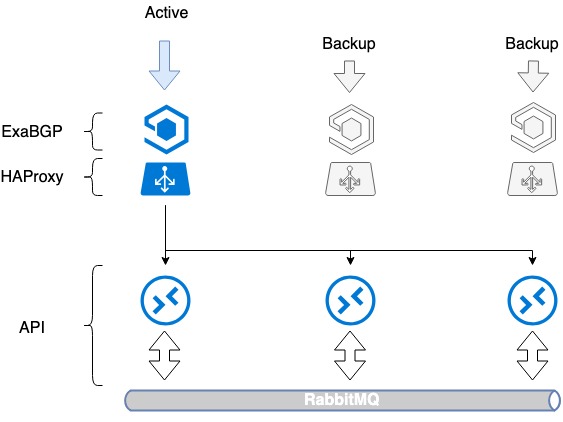
Reziliența echilibratoarelor HAProxy.
Schema rezultată nu este ideală: am învățat să rezervăm HAProxy, dar nu am învățat să distribuim sarcina în interiorul serviciilor. De aceea, am extins puțin schema: am trecut la echilibrarea între mai multe adrese IP publice.
Echilibrarea bazată pe DNS plus BGP
Întrebarea echilibrării sarcinii înaintea HAProxy-urilor noastre a rămas nerezolvată. Cu toate acestea, poate fi rezolvată destul de simplu, așa cum am procedat și noi.
Pentru echilibrarea a trei servere sunt necesare 3 adrese IP publice și vechiul DNS. Fiecare dintre aceste adrese este definită pe interfața loopback a fiecărui HAProxy și este anunțată pe Internet.
În OpenStack, pentru gestionarea resurselor se folosește un catalog de servicii, în care este definit endpoint-ul API pentru fiecare serviciu. În acest catalog, specificăm numele de domeniu — public.infra.mail.ru, care este rezolvat prin DNS prin trei adrese IP diferite. Ca urmare, obținem distribuția sarcinii între cele trei adrese prin intermediul DNS.
Dar, deoarece nu gestionăm prioritățile de selectare a serverelor în timpul anunțării adreselor IP publice, nu este încă o echilibrare. De obicei, va fi selectat un singur server în funcție de senioritatea adresei IP, iar celelalte două vor sta în așteptare, deoarece nu sunt specificate metriki în BGP.
Am început să anunțăm rutele prin ExaBGP cu metrici diferite. Fiecare echilibror anunță toate cele trei adrese IP publice, dar unul dintre ele, principal pentru acest echilibror, este anunțat cu cea mai mică metrică. Așadar, cât timp toate cele trei echilibratoare sunt funcționale, cererile către prima adresă IP ajung la primul echilibror, cererile către a doua la al doilea, iar cele către a treia la al treilea.
Ce se întâmplă în momentul în care unul dintre echilibratoare se oprește? În cazul în care oricare dintre echilibratoare eșuează, adresa sa principală este încă anunțată de celelalte două, iar traficul între ele se redistribuie. Astfel, oferim utilizatorului prin DNS imediat câteva adrese IP. Prin echilibrarea pe DNS și metrici diferite obținem o distribuție uniformă a sarcinii pe toate cele trei echilibratoare. Și, în același timp, nu pierdem rezistența la defecțiuni.
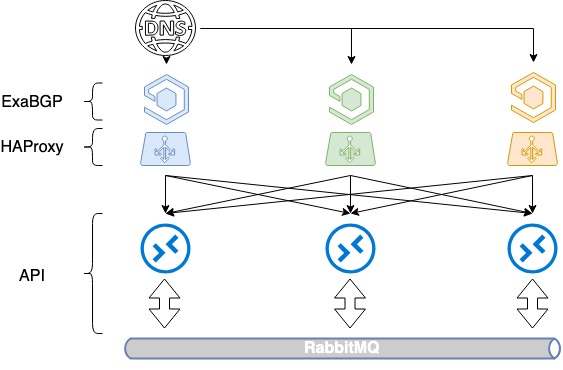
Echilibrarea HAProxy pe baza DNS + BGP
Interacțiunea între ExaBGP și HAProxy
Așadar, am implementat rezistența la defecțiuni în cazul în care un server pleacă, pe baza încetării anunțării rutelor. Dar HAProxy se poate opri și din alte motive decât defecțiunea serverului: erori de administrare, defecțiuni interne ale serviciului. Vrem să eliminăm echilibrorul defect de sub sarcină și în aceste cazuri, și este necesar un alt mecanism.
Prin urmare, extinzând schema precedentă, am implementat un heartbeat între ExaBGP și HAProxy. Aceasta este o implementare software a interacțiunii între ExaBGP și HAProxy, în care ExaBGP folosește scripturi personalizate pentru a verifica starea aplicațiilor.
Pentru aceasta, în configurația ExaBGP trebuie să configurăm un health checker care să poată verifica starea HAProxy. În cazul nostru, am configurat un health backend în HAProxy, iar din partea ExaBGP verificăm printr-un simplu GET request. Dacă anunțul încetează să mai aibă loc, atunci HAProxy, cel mai probabil, nu funcționează și nu trebuie să-l anunțăm.
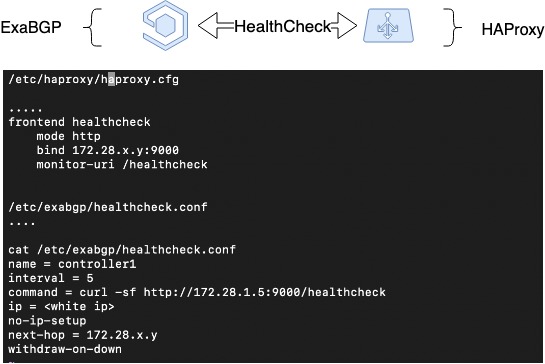
Verificare a sănătății HAProxy
Perechi HAProxy: sincronizarea sesiunilor
Următorul lucru pe care trebuia să-l facem era să sincronizăm sesiunile. Atunci când lucrăm prin balansoare distribuite, este greu să organizăm păstrarea informațiilor despre sesiunile clienților. Însă HAProxy este unul dintre puținele balansoare care pot face acest lucru datorită funcționalității Peers – capacitatea de a transfera între diferitele procese HAProxy tabelele de sesiuni.
Există diferite metode de balansare: simple, cum ar fi , și avansate, în care sesiunea clientului este păstrată, iar acesta ajunge de fiecare dată pe același server pe care l-a folosit anterior. Noi am dorit să implementăm a doua variantă.
În HAProxy, pentru păstrarea sesiunilor clientului, acest mecanism folosește stick-tables. Acestea păstrează adresa IP inițială a clientului, adresa țintă aleasă (backend) și unele informații de serviciu. De obicei, stick-tables sunt utilizate pentru a păstra perechea source-IP + destination-IP, ceea ce este deosebit de util pentru aplicațiile care nu pot transmite contextul sesiunii utilizatorului atunci când trec pe un alt balansoar, de exemplu – în modul de balansare RoundRobin.
Dacă stick-table este învățată să se miște între diferitele procese HAProxy (între care se efectuează balansarea), balansoarele noastre vor putea lucra cu un singur pool de stick-tables. Aceasta va permite comutarea fără probleme a rețelei clientului în cazul în care unul dintre balansoare cedează, iar lucrul cu sesiunile clienților va continua pe aceleași backends care au fost alese anterior.
Pentru a funcționa corect, trebuie rezolvată problema adresei IP sursă a balansoarului de la care a fost stabilită sesiunea. În cazul nostru, aceasta este o adresă dinamică pe interfața loopback.
Funcționarea corectă a peers se realizează doar în anumite condiții. Asta înseamnă că timeout-urile TCP trebuie să fie suficient de mari sau comutarea trebuie să fie suficient de rapidă pentru a preveni întreruperea sesiunii TCP. Cu toate acestea, acest lucru permite comutarea fără întreruperi.
Avem în IaaS un serviciu construit pe aceeași tehnologie. Acesta , numit Octavia. Este bazat pe două procese HAProxy, având suport inițial pentru peers. În acest serviciu, acestea s-au demonstrat a fi foarte eficiente.
În imagine este reprezentată schematic mișcarea tabelelor peers între cele trei instanțe HAProxy, fiind propus un configurare pentru cum poate fi realizată această setare:
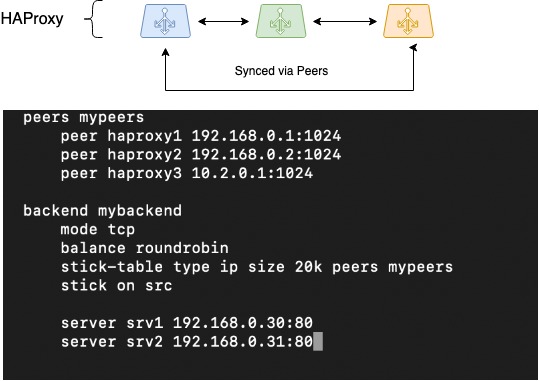
HAProxy Peers (sincronizarea sesiunilor)
Dacă intenționați să implementați o asemenea schemă, este necesar să testați cu atenție funcționarea acesteia. Nu este garantat că va funcționa în aceleași condiții în 100% din cazuri. Dar, cel puțin, nu veți pierde stick-tabelele atunci când trebuie să rețineți IP-ul sursă al clientului.
Limitarea numărului de cereri simultane de la același client
Orice servicii aflate în acces deschis, inclusiv API-urile noastre, pot fi supuse avalanșelor de cereri. Motivele pot varia de la erori ale utilizatorilor până la atacuri deliberate. Noi suntem periodic DDoS-ați pe adresele IP. Clienții greșesc frecvent în scripturile lor, provocând mini-DDoS-uri.
Indiferent de caz, este necesar să prevedem o protecție suplimentară. O soluție evidentă devine limitarea numărului de cereri către API și evitarea pierderii timpului CPU pe procesarea cererilor malițioase.
Pentru implementarea unor astfel de limitări, aplicăm rate limits, organizate pe baza HAProxy, cu ajutorul acelorași stick-tabele. Limitele pot fi setate destul de simplu și permit restricționarea utilizatorului în funcție de numărul de cereri către API. Algoritmul își reține IP-ul sursă de unde sunt efectuate cererile și limitează numărul de cereri simultane de la un singur utilizator. Firește, am calculat profilul mediu de încărcare pe API pentru fiecare serviciu și am stabilit o limită de aproximativ 10 ori mai mare decât această valoare. Continuăm să monitorizăm cu atenție situația, având mâna pe puls.
Cum arată în practică? Avem clienți care folosesc constant API-urile noastre pentru scalarea automată. Aceștia creează aproximativ două sute-trei sute de mașini virtuale dimineața și le șterg seara. Pentru OpenStack, a crea o mașină virtuală, împreună cu servicii PaaS, înseamnă cel puțin 1000 de cereri API, deoarece interacțiunea între servicii se face și prin API.
Astfel de transferuri de sarcini generează o sarcină considerabilă. Am evaluat această sarcină, am colectat vârfurile zilnice, le-am înmulțit cu zece și aceasta a devenit limita noastră de rată. Suntem mereu atenți la schimbări. Vedem adesea roboți și scannere care încearcă să ne verifice, căutând dacă avem vreo script CGA pe care să o poată rula, pe care le tăiem activ.
Cum să actualizăm baza de cod fără ca utilizatorii să observe
Implementăm redundanța și la nivelul proceselor de desfășurare a codului. În timpul desfășurărilor apar erori, dar impactul acestora asupra disponibilității serviciilor poate fi minimizat.
Actualizăm constant serviciile noastre și trebuie să asigurăm un proces de actualizare a bazei de cod fără efecte pentru utilizatori. Am reușit să abordăm această problemă, folosind capabilitățile de gestionare HAProxy și implementarea Graceful Shutdown în serviciile noastre.
Pentru a rezolva această problemă, a fost necesar să asigurăm gestionarea balansorului de sarcină și oprirea «corectă» a serviciilor:
- În cazul HAProxy, gestionarea se face prin intermediul fișierului stats, care este practic un socket și este definit în configurația HAProxy. Comenzile pot fi transmise prin stdio. Dar principalul nostru instrument de control al configurațiilor este ansible, care are un modul integrat pentru gestionarea HAProxy. Pe care îl folosim activ.
- Majoritatea serviciilor noastre API și Engine suportă tehnologiile graceful shutdown: la oprire, așteaptă finalizarea completă a sarcinii curente, fie că este vorba de o cerere http sau de o sarcină administrativă. Același lucru se întâmplă și cu worker-ul. Acesta cunoaște toate sarcinile pe care le execută și se finalizează când toate au fost completate cu succes.
Datorită acestor două aspecte, algoritmul nostru de desfășurare în siguranță arată astfel.
- Dezvoltatorul adună un nou pachet de cod (pentru noi, acesta este RPM), îl testează în mediul dev, îl testează în stage și îl lasă în depozitul stage.
- Dezvoltatorul stabilește sarcina de desfășurare cu o descriere cât mai detaliată a „artefactelor”: versiunea noului pachet, descrierea noilor funcționalități și alte detalii despre desfășurare, dacă este necesar.
- Administratorul de sistem pornește actualizarea. Lansează playbook-ul Ansible, care la rândul său face următoarele:
- Ia pachetul din repo-ul de stage și actualizează versiunea pachetului în repo-ul de producție.
- Compune o listă a backend-urilor serviciului care urmează să fie actualizat.
- Oprește primul serviciu actualizat în HAProxy și așteaptă finalizarea proceselor acestuia. Datorită închiderii elegante, suntem siguri că toate cererile curente ale clienților se vor finaliza cu succes.
- După oprirea completă a API-ului, worker-ilor și închiderii HAProxy, are loc actualizarea codului.
- Ansible pornește serviciile.
- Pentru fiecare serviciu, trage anumite „mânere” care efectuează testare unitate bazată pe un set de teste predefinite. Se realizează o verificare de bază a noului cod.
- Dacă nu au fost descoperite erori în pasul anterior, backend-ul este activat.
- Trecem la următorul backend.
- După actualizarea tuturor backend-urilor, sunt lansate teste funcționale. Dacă sunt insuficiente, dezvoltatorul verifică orice nouă funcționalitate pe care a realizat-o.
Aceasta înseamnă că desfășurarea s-a finalizat.
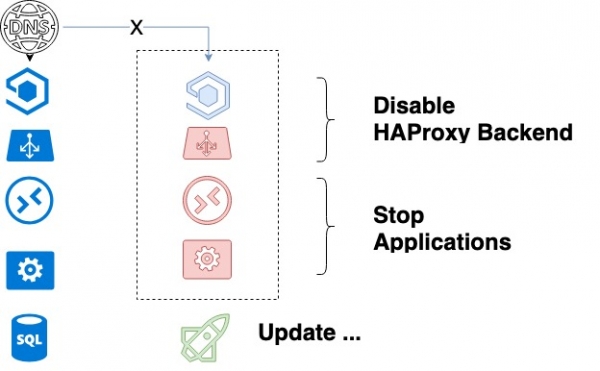
Ciclul de actualizare a serviciului
Această schemă nu ar fi funcțională dacă nu am avea o regulă. Menținem în producție simultan versiunea veche și pe cea nouă. În prealabil, în etapa de dezvoltare a software-ului, se presupune că, chiar dacă vor apărea modificări în baza de date a serviciului, acestea nu vor afecta codul anterior. Ca urmare, se realizează o actualizare treptată a bazei de cod.
Concluzie
Împărtășind propriile gânduri despre arhitectura WEB rezistentă la erori, vreau să subliniez din nou punctele sale cheie:
- rezistența fizică la erori;
- rezistența la erori a rețelei (încărcătoare, BGP);
- rezistența la erori a software-ului utilizat și dezvoltat.
Toată lumea să aibă uptime stabil!
Sursa: habr.com
