

TL; DR: JSONB poate simplifica semnificativ dezvoltarea schemei de bază de date fără a compromite performanța interogărilor.
Introducere
Să luăm un exemplu clasic, probabil unul dintre cele mai vechi moduri de utilizare în lumea bazelor de date relaționale: avem o entitate și trebuie să salvăm anumite proprietăți (atribute) ale acestei entități. Dar nu toate instanțele pot avea același set de proprietăți, iar în plus, posibilitatea de a adăuga încă proprietăți în viitor.
Cea mai simplă soluție pentru această problemă este crearea unei coloane în tabela de bază de date pentru fiecare valoare de proprietate și pur și simplu completarea celor necesare pentru o anumită instanță a entității. Excelent! Problema a fost rezolvată… până în momentul în care tabela ta nu conține milioane de înregistrări și ai nevoie să adaugi o nouă înregistrare.
Să luăm în considerare modelul EAV (), care este destul de frecvent întâlnit. O tabelă conține entități (înregistrări), o altă tabelă conține numele proprietăților (atributelor), iar a treia tabelă leagă entitățile de atributele lor și conține valorile acestor atribute pentru entitatea curentă. Aceasta îți oferă posibilitatea de a avea seturi diferite de proprietăți pentru diferite obiecte, precum și de a adăuga proprietăți „din mers”, fără a modifica structura bazei de date.
Cu toate acestea, nu aș fi scris această notă dacă nu ar fi fost dezavantajele abordării EAV. De exemplu, pentru a obține una sau mai multe entități care au 1 atribut, sunt necesare 2 join-uri (uniri) în interogare: primul – unirea cu tabela atributelor, al doilea – unirea cu tabela valorilor. Dacă entitatea are 2 atribute, sunt necesare deja 4 join-uri! În plus, toate atributele sunt de obicei stocate sub formă de șiruri de caractere, ceea ce duce la conversii de tipuri, atât pentru rezultat, cât și pentru condiția WHERE. Dacă scrii multe interogări, aceasta este destul de costisitoare, din punct de vedere al utilizării resurselor.
În ciuda acestor dezavantaje evidente, EAV este folosit de mult timp pentru a soluționa acest tip de probleme. Acestea au fost dezavantaje inevitabile, iar o alternativă mai bună pur și simplu nu a existat.
Dar apoi în PostgreSQL a apărut o nouă „tehnologie”...
Începând cu PostgreSQL 9.4, a fost adăugat tipul de date JSONB pentru stocarea datelor JSON binare. Deși stocarea JSON în acest format ocupă de obicei puțin mai mult spațiu și timp decât JSON-ul simplu, executarea operațiunilor cu el se face mult mai rapid. De asemenea, JSONB suportă indexarea, ceea ce face ca interogările să fie și mai rapide.
Tipul de date JSONB ne permite să înlocuim modelul EAV voluminos prin adăugarea unei singure coloane JSONB în tabela noastră de entități, ceea ce simplifică semnificativ proiectarea bazei de date. Dar mulți susțin că acest lucru ar trebui să vină cu o scădere a performanței… De aceea a apărut acest articol.
Configurarea bazei de date de testare
Pentru această comparație, am creat o bază de date pe o instalare nouă PostgreSQL 9.5 pe o configurație de 80 de dolari Ubuntu 14.04. După configurarea unor setări în postgresql.conf, am rulat scriptul folosind psql. Pentru a reprezenta datele într-un format EAV, au fost create următoarele tabele:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Mai jos este tabelul unde vor fi stocate aceleași date, dar cu atribute în coloana de tip JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Arată mult mai simplu, nu-i așa? Apoi au fost adăugate în tabelele entităților (entity & entity_jsonb) 10 milioane de înregistrări și, în consecință, au fost completate cu date identice tabelele în care se folosește modelul EAV și abordarea cu coloana JSONB – entity_jsonb.properties. Astfel, am obținut mai multe tipuri diferite de date în întregul set de proprietăți. Exemplu de date:
{
  id:          1
  name:        "Entity1"
  description: "Entitate de test nr. 1"
  properties:  {
    color:        "roșu"
    length:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgia"
  }
}
Deci, acum avem date identice pentru cele două variante. Să începem să comparăm implementările în practică!
Simplificarea designului
A fost menționat anterior că designul bazei de date a fost semnificativ simplificat: o singură tabelă, datorită utilizării coloanei JSONB pentru proprietăți, în loc de utilizarea a trei tabele pentru EAV. Dar cum se reflectă acest lucru în interogări? Actualizarea unei proprietăți a entității arată astfel:
-- EAV
UPDATE entity_attribute_value
SET value = 'blue'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blue"')
WHERE id = 120;
După cum vedem, ultima interogare nu arată mai simplă. Pentru a actualiza valoarea unei proprietăți în obiectul JSONB, trebuie să folosim funcția , și trebuie să transmitem noua noastră valoare ca obiect JSONB. Totuși, nu trebuie să știm niciun identificator dinainte. Privind exemplul cu EAV, trebuie să știm atât entity_id, cât și entity_attribute_id pentru a efectua actualizarea. Dacă dorești să actualizezi o proprietate în coloana JSONB pe baza numelui obiectului, acest lucru se face totul cu un singur rând simplu.
Acum să selectăm entitatea pe care am actualizat-o, pe baza noului său color:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blue';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blue';
Cred că putem conveni că a doua este mai scurtă (fără join!), și astfel mai ușor de citit. Aici câștigă JSONB! Folosim operatorul JSON ->>, pentru a obține culoarea ca valoare text din obiectul JSONB. Există, de asemenea, o a doua metodă de a obține același rezultat în modelul JSONB folosind operatorul @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blue"}';
Este puțin mai complicat: verificăm dacă obiectul JSON din coloana proprietăți conține obiectul care se află în dreapta operatorului @>. Mai puțin citibil, dar mai performant (vezi mai departe).
Să simplificăm utilizarea JSONB și mai mult, atunci când trebuie să selectăm mai multe proprietăți simultan. Aici se potrivește cu adevărat abordarea JSONB: pur și simplu selectăm proprietățile ca coloane suplimentare în setul nostru de rezultate fără necesitatea de a face unire:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
Cu EAV, vei avea nevoie de 2 uniuni pentru fiecare proprietate pe care vrei să o interoghezi. Din punctul meu de vedere, interogările de mai sus arată o mare simplificare în designul bazei de date. Poți viziona mai multe exemple despre cum să scrii interogări pentru JSONB, posibile și în post.
Acum a venit timpul să vorbim despre performanță.
Performanță
Pentru a compara performanța, am folosit în interogări, pentru calcularea timpului de execuție. Fiecare interogare a fost efectuată de cel puțin trei ori, deoarece prima dată planificatorului de interogări îi trebuie mai mult timp. La început, am efectuat interogările fără indecși. Evident, acest lucru a fost un avantaj pentru JSONB, deoarece join-urile necesare pentru EAV nu puteau folosi indecși (câmpurile cheie străine nu erau indexate). După aceea, am creat un indice pentru cele două coloane ale cheilor externe din tabela valorilor EAV, precum și un indice pentru coloana JSONB.
Actualizările de date au arătat următoarele rezultate în timp (în ms). Rețineți că scala este logaritmică:
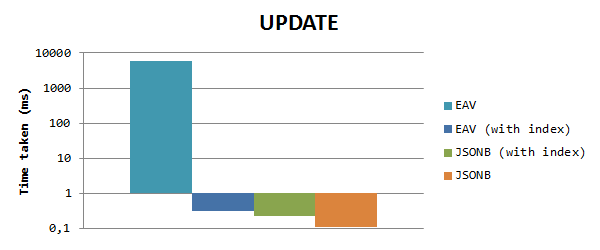
Se observă că JSONB este cu mult (> 50000-x) mai rapid decât EAV, dacă nu folosim indecși, din cauza menționată mai sus. Când indexăm coloanele cu chei primare, diferența aproape dispare, dar JSONB rămâne totuși de 1,3 ori mai rapid decât EAV. Rețineți că indicele din coloana JSONB nu are nicio influență aici, deoarece nu folosim coloana proprietăților în criteriile de evaluare.
Pentru selectarea datelor pe baza valorii proprietății, obținem următoarele rezultate (scala normală):
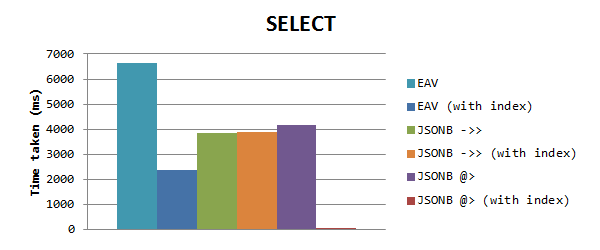
Se poate observa că JSONB lucrează din nou mai repede decât EAV fără indecși, dar când EAV are indecși și totuși funcționează mai rapid decât JSONB. Dar apoi am observat că timpul pentru interogările JSONB a fost același, ceea ce m-a determinat să cred că indicele GIN nu funcționează. Se pare că, atunci când folosești un indice GIN pentru o coloană cu proprietăți completate, acesta acționează doar atunci când se folosește operatorul de includere @>. Am folosit asta într-un nou test, ceea ce a avut un impact uriaș asupra timpului: doar 0,153 ms! Este cu 15000 de ori mai rapid decât EAV și cu 25000 de ori mai rapid decât operatorul ->>.
Cred că a fost destul de rapid!
Dimensiunea tabelelor DB
Să comparăm dimensiunile tabelelor în ambele abordări. În psql putem arăta dimensiunea tuturor tabelelor și indecșilor folosind comanda dti+
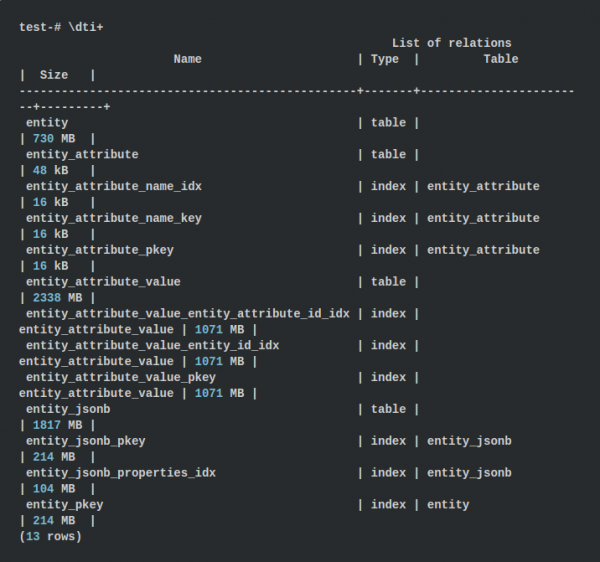
Pentru abordarea EAV, dimensiunile tabelelor sunt de aproximativ 3068 MB, iar indecșii sunt până la 3427 MB, ceea ce totalizează 6,43 GB. Folosind abordarea cu JSONB, se folosesc 1817 MB pentru tabel și 318 MB pentru indecși, ceea ce reprezintă 2,08 GB. Este de trei ori mai puțin! Acest fapt m-a surprins puțin, deoarece stocăm numele proprietăților în fiecare obiect JSONB.
Dar totuși, cifrele vorbesc de la sine: în EAV stocăm 2 chei externe întregi pentru valoarea atributului, obținând astfel 8 byte de date suplimentare. În plus, în EAV toate valorile proprietăților sunt stocate sub formă de text, în timp ce JSONB va folosi valori numerice și logice acolo unde este posibil, rezultând un volum mai mic.
Concluzii
În general, cred că păstrarea proprietăților entităților în format JSONB poate simplifica semnificativ proiectarea și întreținerea bazei dumneavoastră de date. Dacă efectuați multe interogări, tot ce este stocat într-o singură tabelă cu entitatea va funcționa cu adevărat mai eficient. Și faptul că simplifică interacțiunea între date deja reprezintă un avantaj, dar și baza de date rezultantă este de 3 ori mai mică ca volum.
De asemenea, din testele efectuate, se poate concluziona că pierderile de performanță sunt foarte neglijabile. În unele cazuri, JSONB funcționează chiar mai repede decât EAV, ceea ce îl face și mai bun. Cu toate acestea, acest test de referință nu acoperă toate aspectele (de exemplu, entități cu un număr foarte mare de proprietăți, o creștere semnificativă a numărului de proprietăți ale datelor existente,…), așa că, dacă aveți sugestii despre cum să le îmbunătățiți, nu ezitați să le lăsați în comentarii!
Sursa: habr.com
