

În acest articol, vom discuta despre dependențele funcționale în bazele de date — ce sunt, unde se aplică și ce algoritmi există pentru a le identifica.
Vom analiza dependențele funcționale în contextul bazelor de date relaționale. Dacă ne referim în termeni foarte simpli, informațiile din aceste baze de date sunt stocate sub formă de tabele. În continuare, vom folosi noțiuni aproximative care nu sunt interschimbabile în teoria relațională strictă: tabelul propriu-zis îl vom numi relație, coloanele — atribute (multe dintre acestea constituie schema relației), iar setul de valori al unei linii pe un subset de atribute — tuplă.
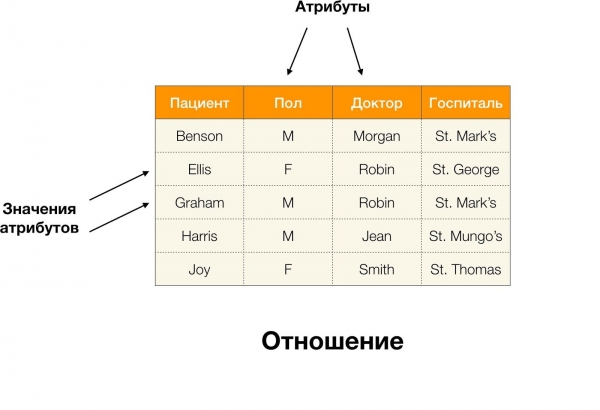
De exemplu, în tabelul de mai sus, (Benson, M, M organ) este o tuplă în funcție de atributele (Pacient, Sex, Doctor).
Mai formal, acest lucru se scrie în următoarea formă:  [Pacient, Sex, Doctor] = (Benson, M, M organ).
Acum putem introduce conceptul de dependență funcțională (DF):
Definiția 1. Relația R satisface DF X → Y (unde X, Y ⊆ R) dacă și numai dacă pentru orice tuple  ,
 ∈ R se îndeplinește: dacă
 [X] =
 [X], atunci
 [Y] =
 [Y]. În acest caz, se spune că X (determinantul, sau mulțimea de atribute definitorie) determină funcțional Y (mulțimea dependentă).
Cu alte cuvinte, existența DF X → Y înseamnă că, dacă avem două tuple în R și ele coincid pe atributele X, atunci ele vor coincide și pe atributele Y.
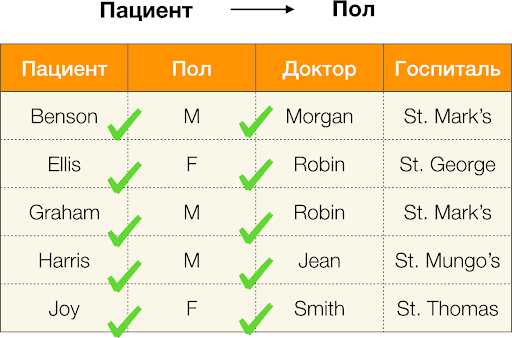
Acum, să luăm fiecare caz pe rând. Să analizăm atributele Pacient și Genul pentru care dorim să aflăm dacă există dependențe între ele sau nu. Pentru un astfel de set de atribute, pot exista următoarele dependențe:
- Pacient → Sex
- Sex → Pacient
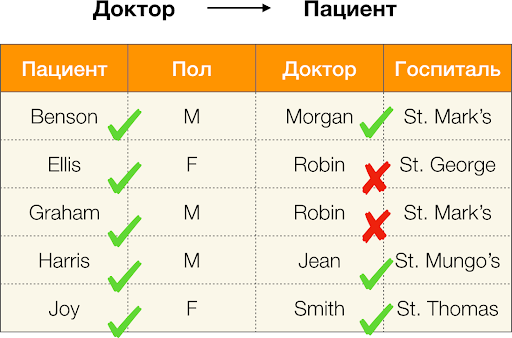
Conform definiției de mai sus, pentru ca prima dependență să se mențină, fiecărui valorii unice din coloana Pacient trebuie să îi corespundă doar o singură valoare din coloana Genul. Și pentru tabelul-exemplu, acesta este într-adevăr cazul. Totuși, în sens invers, aceasta nu funcționează, adică a doua dependență nu se îndeplinește, iar atributul Genul nu este un determinant pentru Pacient.În mod similar, dacă luăm dependența Doctor → Pacient, putem observa că aceasta este încălcată, deoarece valoarea Robin pentru acest atribut are mai multe valori diferite — Ellis și Graham..
Astfel, dependențele funcționale permit identificarea relațiilor existente între mulțimile de atribute ale unei tabele. Drept urmare, de acum înainte, ne vom concentra asupra celor mai interesante relații, și anume acelea X → Y, care sunt:
- netriviale, adică partea dreaptă a dependenței nu este un subset al părții stângi (Y ̸⊆ X);
- minimales, adică nu există o astfel de dependență Z → Y, ceea ce Z ⊂ X.
Dependențele analizate până în acest moment au fost stricte, adică nu preconizau nicio încălcare în tabel, dar pe lângă acestea există și altele care permit o anumită neconcordanță între valorile tuplilor. Aceste dependențe sunt plasate într-o clasă separată, numite aproximative și li se permite să fie încălcate într-un anumit număr de tupli. Această cantitate este reglementată de indicatorul de eroare maximă emax. De exemplu, o rată de eroare  = 0.01 poate însemna că dependența poate fi încălcată la 1% din tuplii existenți în mulțimea de atribute analizată. Cu alte cuvinte, pentru 1000 de înregistrări, maximum 10 tupli pot încălca dependența FZ. Totuși, noi ne vom concentra asupra unei metrici ușor diferite, bazate pe valori distincte comparate ale tuplilor. Pentru dependența X → Y pe relația r este considerată astfel:

Să calculăm eroarea pentru Doctor → Pacient din exemplul de mai sus. Avem două tupluri, valorile cărora diferă pe atributul Pacient, dar coincid pe Doctor:  [Doctor, Pacient] = (Robin, Ellis) și
 [Doctor, Pacient] = (Robin, Graham). Urmând definiția erorii, trebuie să luăm în considerare toate perechile conflictuale, ceea ce înseamnă că vor fi două: (
 ,
 ) și inversul său (
 ,
 ). Să înlocuim în formulă și să obținem:

Acum să încercăm să răspundem la întrebarea: „De ce este totul acesta?”. De fapt, există diferite tipuri de FZ. Primul tip sunt acele dependențe care sunt definite de administrator în etapa de proiectare a bazei de date. De obicei, acestea sunt puține, sunt stricte, iar utilizarea principală este normalizarea datelor și proiectarea schemei relației.
Al doilea tip sunt dependențele care reprezintă datele «ascunse» și relațiile anterior necunoscute între atribute. Cu alte cuvinte, aceste dependențe nu au fost luate în considerare în momentul proiectării, iar ele sunt descoperite ulterior pentru un set de date existent, pentru a face concluzii despre informațiile stocate pe baza multor reguli funcționale descoperite. Exact cu astfel de dependențe lucrăm. Ele sunt studiate de un întreg domeniu al minării datelor, cu diverse tehnici de căutare și algoritmi construiți pe baza acestora. Să analizăm cum ne pot fi utile dependențele funcționale găsite (exacate sau aproximative) în anumite date.
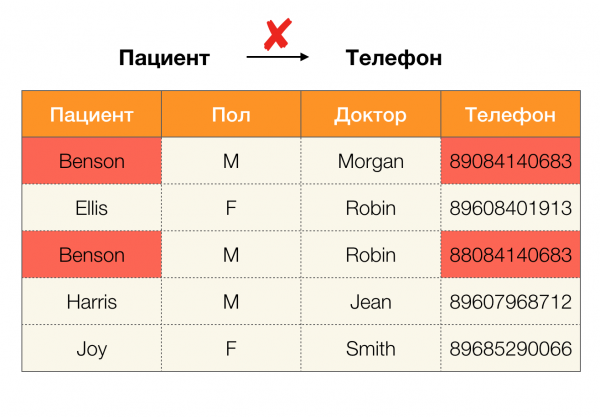
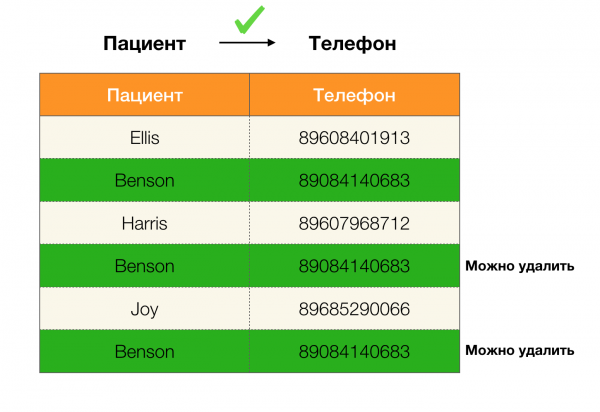
Astăzi, printre principalele domenii de aplicare a dependențelor se numără curățarea datelor. Aceasta implică dezvoltarea proceselor de identificare a „datelor murdare” cu corectarea ulterioară a acestora. Reprezentanți evidenți ai „datelor murdare” sunt duplicatele, erorile în date sau greșelile de tipar, valorile lipsă, datele învechite, spațiile inutile și altele asemenea.
Exemplu de eroare în date:
Exemplu de duplicate în date:
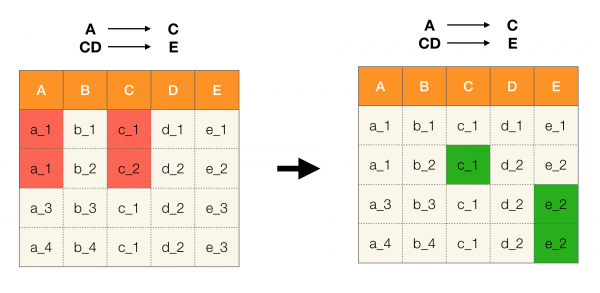
De exemplu, avem un tabel și un set de reguli funcționale care trebuie respectate. Curățarea datelor, în acest caz, presupune modificarea datelor astfel încât regulile funcționale să devină corecte. În același timp, numărul de modificări trebuie să fie minim (pentru această procedură există algoritmi specifici, la care nu ne vom concentra în acest articol). Mai jos este un exemplu de astfel de transformare a datelor. În stânga, relația inițială, în care, evident, regulile necesare nu sunt respectate (cu roșu este evidențiat un exemplu de încălcare a uneia dintre reguli). În dreapta este prezentată relația actualizată, în care celulele verzi arată valorile modificate. După ce s-a efectuat această procedură, dependențele necesare au început să fie menținute.
O altă aplicare populară este designul bazei de date. Aici merită să amintim despre formele normale și normalizare. Normalizarea este un proces de aducere a relației în conformitate cu un set de cerințe, fiecare dintre ele fiind definită printr-o formă normală în mod unic. Nu vom detalia cerințele diferitelor forme normale (aceasta se face în orice carte de curs pentru începători despre baze de date), ci vom menționa doar că fiecare dintre acestea folosește conceptul de dependențe funcționale într-un mod specific. Întrucât dependențele funcționale sunt, prin natura lor, constrângeri de integritate care sunt luate în considerare în procesul de proiectare a unei baze de date (în contextul acestei sarcini, dependențele funcționale sunt uneori numite super-chei).
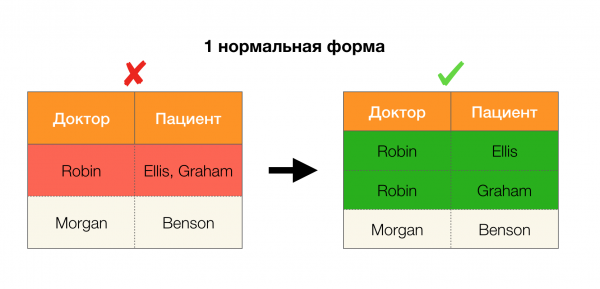
Să luăm în considerare aplicarea lor pentru cele patru forme normale din imaginea de mai jos. Să reamintim că forma normală Boyce-Codd este mai strictă decât a treia formă, dar mai puțin strictă decât a patra. Pe aceasta din urmă nu o luăm în considerare deocamdată, deoarece pentru formularea ei este necesară o înțelegere a dependențelor multivalente, care nu sunt de interes în acest articol.
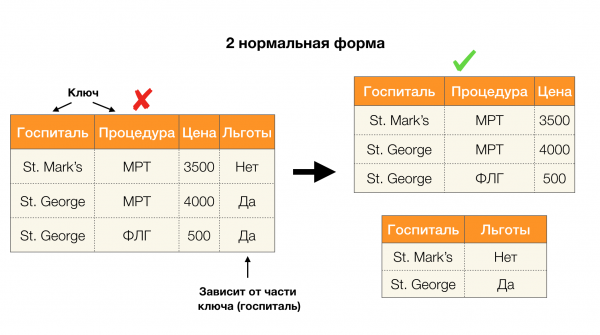
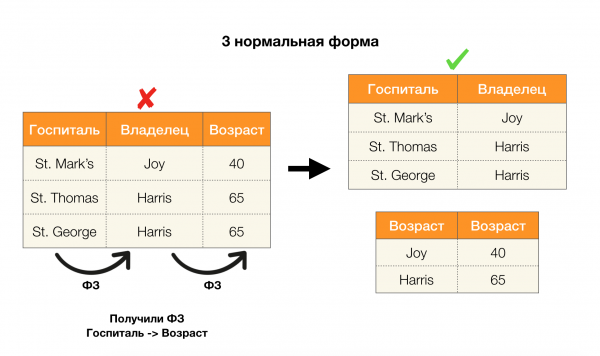
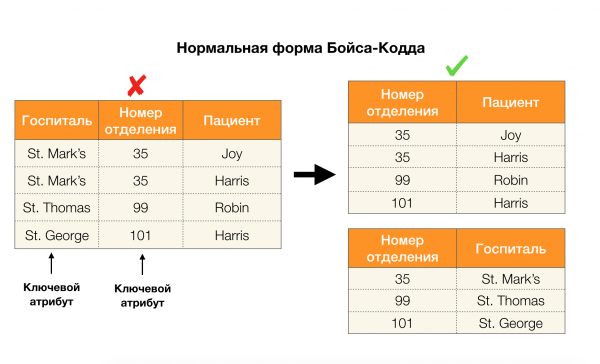
O altă arie în care dependențele și-au găsit aplicarea este reducerea dimensiunii spațiului caracteristic în astfel de sarcini precum construirea unui clasificator Naive Bayes, extragerea caracteristicilor semnificative și reparametrizarea modelului de regresie. În articolele originale, această sarcină este numită definirea caracteristicilor redundante (feature redundancy) și relevante (feature relevancy) [5, 6], iar ea este rezolvată cu o utilizare activă a conceptelor din bazele de date. Odată cu apariția acestor lucrări, putem spune că în prezent există o solicitare pentru soluții care să permită integrarea bazei de date, analizei și implementării problemelor de optimizare menționate mai sus într-un singur instrument [7, 8, 9].
Pentru a găsi dependențele funcționale într-un set de date, există numeroase algoritmi (atât moderni, cât și mai vechi). Acești algoritmi pot fi împărțiți în trei grupuri:
- Algoritmi care utilizează parcurgerea rețelelor algebraice (Lattice traversal algorithms)
- Algoritmi bazati pe căutarea valorilor concordante (Difference- and agree-set algorithms)
- Algoritmi bazati pe comparații pereche (Dependency induction algorithms)
O descriere sumară a fiecărui tip de algoritm este prezentată în tabelul de mai jos:
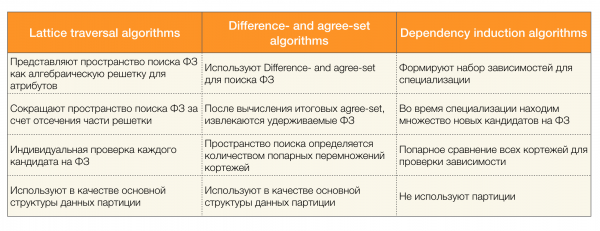
Detalii despre această clasificare pot fi găsite în [4]. Mai jos sunt prezentate exemple de algoritmi pentru fiecare dintre tipuri:
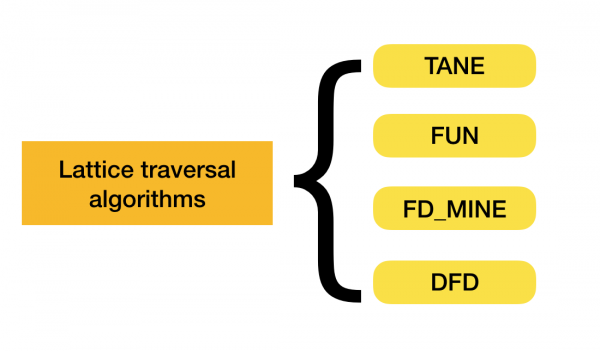
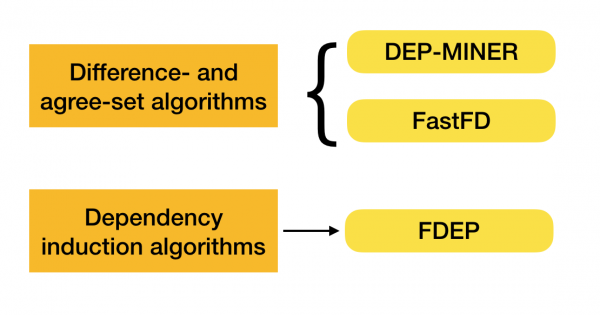
În prezent, apar noi algoritmi care combină mai multe abordări pentru a căuta dependențe funcționale. Exemple de astfel de algoritmi sunt Pyro [2] și HyFD [3]. Analiza modului în care funcționează aceștia va fi efectuată în articolele următoare ale acestei serii. În acest articol, vom discuta doar conceptele de bază și teorema necesară pentru înțelegerea tehnicilor de identificare a dependențelor.
Să începem cu un exemplu simplu – difference-set și agree-set, utilizate în al doilea tip de algoritmi. Difference-set reprezintă mulțimea de tuple care nu coincid în valori, în timp ce agree-set conține tuple care coincid în valori. Este important de menționat că în acest caz analizăm doar partea stângă a dependenței.
Un alt concept important menționat anterior este plasarea algebrică. Deoarece multe dintre algoritmii moderni operează cu acest concept, trebuie să avem o înțelegere a ceea ce reprezintă acesta.
Pentru a introduce conceptul de plasare, este necesară definiția unei mulțimi parțial ordonate (sau partially ordered set, prescurtat – poset).
Definiția 2. Se spune că o mulțime S este parțial ordonată printr-o relație binară ⩽, dacă pentru orice a, b, c ∈ S se îndeplinesc proprietățile:
- Reflexivitate, adică a ⩽ a
- Antisimetricitate, adică, dacă a ⩽ b și b ⩽ a, atunci a = b
- Transitivitate, adică pentru a ⩽ b și b ⩽ c, se deduce că a ⩽ c
Această relație se numește relație (ne strictă) de ordine parțială, iar mulțimea însăși se numește mulțime parțial ordonată. Notație formală: ⟨S, ⩽⟩.
Ca un exemplu simplu de mulțime parțial ordonată, putem lua mulțimea tuturor numerelor naturale N cu relația obișnuită de ordine ⩽. Nu este greu de verificat că toate axiomele necesare sunt satisfăcute.
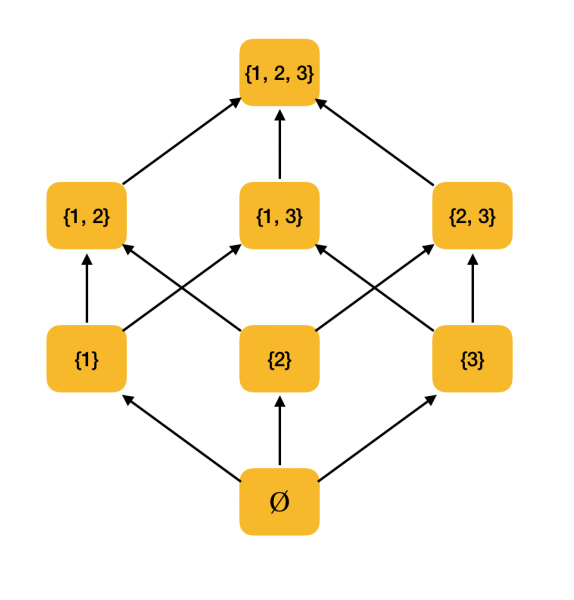
Un exemplu mai substanțial. Să considerăm mulțimea tuturor submulțimilor {1, 2, 3}, ordonată prin relația de incluziune ⊆. Într-adevăr, această relație îndeplinește toate condițiile unei ordini parțiale, prin urmare ⟨P({1, 2, 3}), ⊆⟩ este o mulțime parțial ordonată. În figură este reprezentată structura acestei mulțimi: dacă dintr-un element se poate ajunge prin săgeți la alt element, atunci acestea sunt în relație de ordine.
Ne vor fi necesare încă două definiții simple din domeniul matematicii — supremum (supremum) și infimum (infimum).
Definiția 3. Fie ⟨S, ⩽⟩ — un set parțial ordonat, A ⊆ S. Limita superioară a lui A este un element u ∈ S, astfel încât ∀x ∈ S: x ⩽ u. Fie U — mulțimea tuturor limitelor superioare ale lui S. Dacă în U există un element minim, atunci acesta se numește supremum și se notează ca sup A.
În mod similar se definește noțiunea de limită inferioară exactă.
Definiția 4. Fie ⟨S, ⩽⟩ — un set parțial ordonat, A ⊆ S. Limita inferioară a lui A este un element l ∈ S, astfel încât ∀x ∈ S: l ⩽ x. Fie L — mulțimea tuturor limitelor inferioare ale lui S. Dacă în L există un element maxim, atunci acesta se numește infimum și se notează ca inf A.
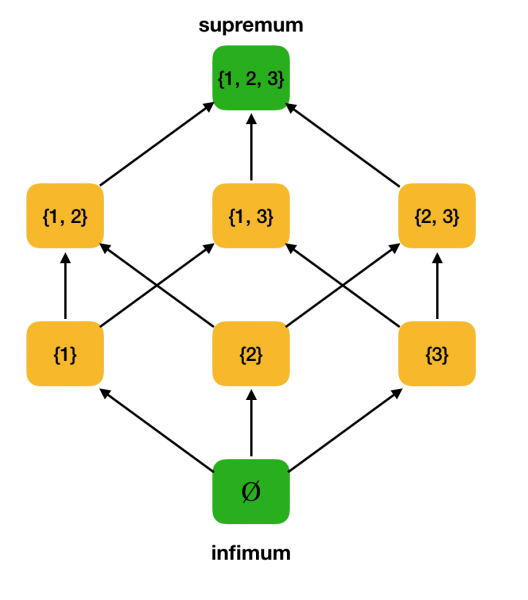
Să considerăm ca exemplu mulțimea parțial ordonată ⟨P ({1, 2, 3}), ⊆⟩ și să găsim în ea supremum și infimum:
Acum putem formula definiția unei lattice algebrice.
Definiția 5. Fie ⟨P, ⩽⟩ — un set parțial ordonat, astfel încât orice submulțime de două elemente are limite superioare și inferioare exacte. Atunci P se numește lattice algebrică. În acest context, sup{x, y} se notează ca x ∨ y, iar inf {x, y} — ca x ∧ y.
Să verificăm că exemplul nostru de lucru ⟨P ({1, 2, 3}), ⊆⟩ este o lattice. Așadar, pentru orice a, b ∈ P ({1, 2, 3}), a∨b = a∪b, iar a∧b = a∩b. De exemplu, să considerăm mulțile {1, 2} și {1, 3} și să găsim infimumul și supremumul lor. Dacă le intersectăm, obținem mulțimea {1}, care va fi infimumul. Supremum însă îl obținem prin uniunea lor — {1, 2, 3}.
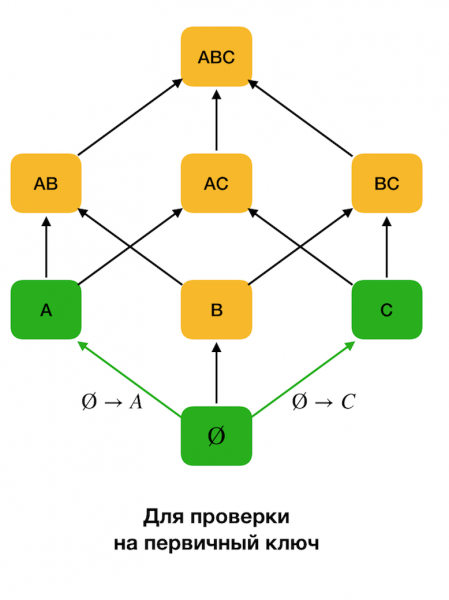
În algoritmii de detectare a FZ, spațiul de căutare este adesea reprezentat sub forma unei lattice, unde mulțimile dintr-un singur element (citește primul nivel al lattice-ului de căutare, unde partea stângă a dependențelor constă într-un singur atribut) reprezintă fiecare atribut al relației inițiale.
La început, sunt considerate dependențele de tipul ∅ → Un atribut unic. Această etapă permite identificarea atributelor care sunt chei primare (pentru astfel de atribute nu există determinanți, iar partea stângă este goală). Ulterior, astfel de algoritmi avansează în sus pe lattice. Este important de menționat că lattice-ul nu trebuie parcurs întreg, adică dacă se transmite o dimensiune maximă dorită a părții stângi, atunci algoritmul nu va avansa dincolo de nivelul cu această dimensiune.
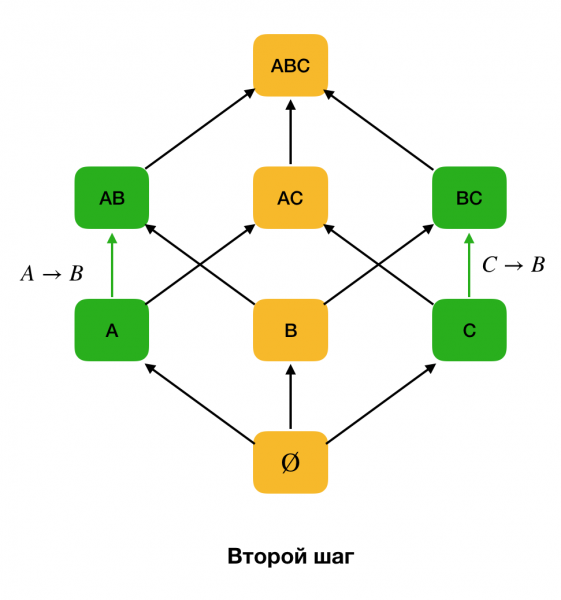
În figura de mai jos este arătat cum se poate utiliza rețeaua algebrică în problema căutării FD. Aici, fiecare muchie (X, XY) reprezintă o dependență X → Y. De exemplu, am trecut primul nivel și știm că dependența este păstrată A → B (să o reprezentăm printr-o legătură verde între vârfuri A și B). Asta înseamnă că, pe măsură ce avansăm pe rețea în sus, nu mai putem verifica dependența A, C → B, deoarece aceasta nu va mai fi minimă. În mod similar, nu am verifica-o dacă s-ar păstra dependența C → B.
În plus, în general, toate algoritmii moderni pentru căutarea FD folosesc o astfel de structură de date ca partitiile (în sursă - stripped partition [1]). Definiția oficială a unei partition este următoarea:
Definiția 6. Fie X ⊆ R - un set de atribute pentru relația r. Un cluster reprezintă un set de indici de tuple din r care au aceeași valoare pentru X, adică c(t) = {i|ti[X] = t[X]}. O partition reprezintă un set de clustere, excluzând clusterele de lungime unică:

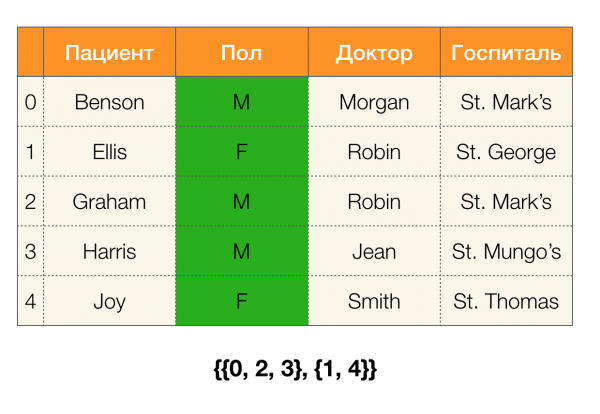
Cu alte cuvinte, partition pentru atributul X reprezintă un set de liste, unde fiecare listă conține numere de rând cu valori identice pentru X. În literatura modernă, structura care reprezintă partitiile se numește position list index (PLI). Clusterele de lungime unică sunt excluse în scopul comprimării PLI, deoarece acestea sunt clustere care conțin doar numărul de înregistrare cu o valoare unică, care va fi întotdeauna ușor de stabilit.
Să luăm un exemplu. Să ne întoarcem la aceeași tabelă cu pacienți și să construim partitiile pentru coloanele Pacient și Genul (a apărut o nouă coloană în stânga, în care sunt notate numerele de rând ale tabelei):
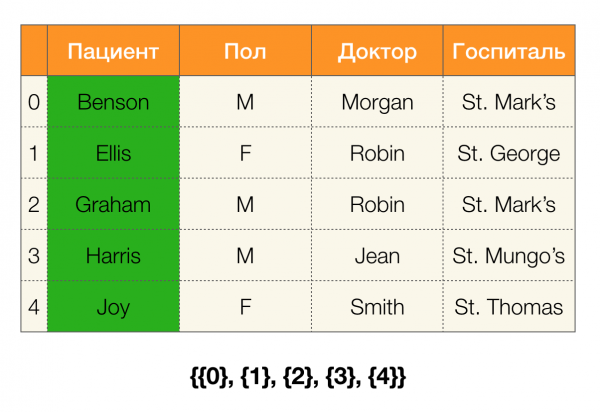
Astfel, conform definiției, partition pentru coloana Pacient va fi de fapt goală, deoarece clusterele unice sunt excluse din partitie.
Partițiile pot fi obținute pe baza mai multor atribute. Și pentru aceasta există două metode: parcurgând tabela, construind o partitie imediat pe toate atributele necesare, sau construind-o prin operația de intersecție a partitiilor pe un subset de atribute. Algoritmii pentru căutarea FD utilizează a doua variantă.
Cu alte cuvinte, pentru a obține, de exemplu, partitia pe coloanele ABC, se pot lua partitiile pentru AC și B (sau orice alt set de submulțimi disjuncte) și a le intersecta între ele. Operația de intersecție a două partitii evidențiază clusterele de lungime maximă comune ambelor partitii.
Să luăm un exemplu:
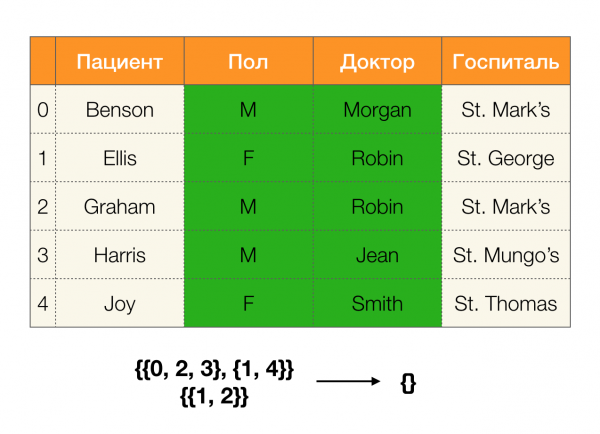
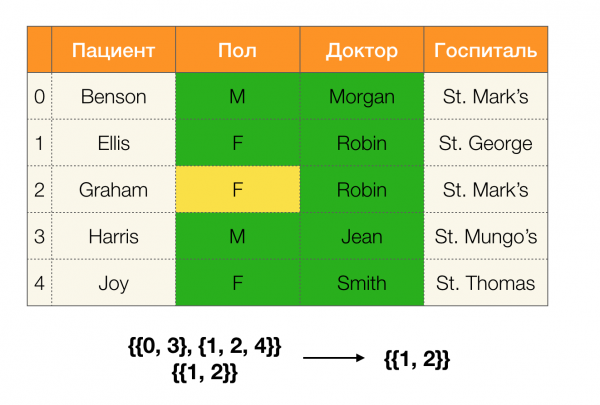
În primul caz, am obținut o partiție goală. Dacă ne uităm mai atent la tabel, vom observa că nu există valori identice pe cele două atribute. Dacă modificăm puțin tabelul (cazul din dreapta), vom obține o intersecție non-golă. În acest caz, rândurile 1 și 2 conțin într-adevăr valori identice pe atribute. Genul și Doctor.
Apoi, avem nevoie de un concept care se numește dimensiunea partitiei. Formal:

Pe scurt, dimensiunea partitiei reprezintă numărul clusterelor care intră în partiție (să ne amintim că clusterele unitare nu sunt incluse în partiție!):
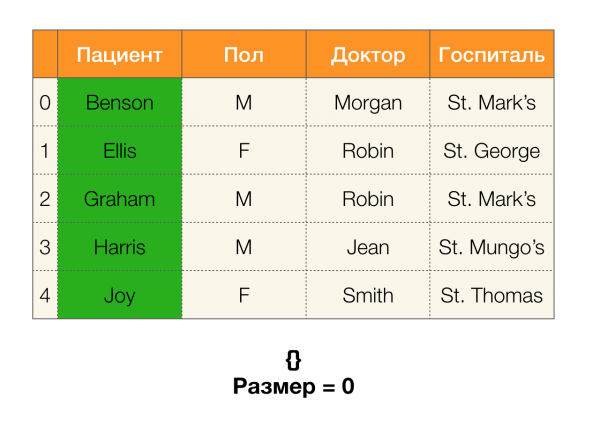
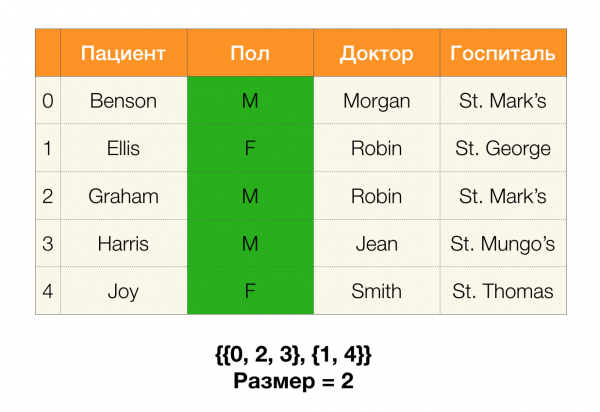
Acum putem defini una dintre lemele cheie care pentru partitii date permite să stabilim dacă dependența este menținută sau nu:
Lemma 1. Dependența A, B → C este menținută dacă și numai dacă

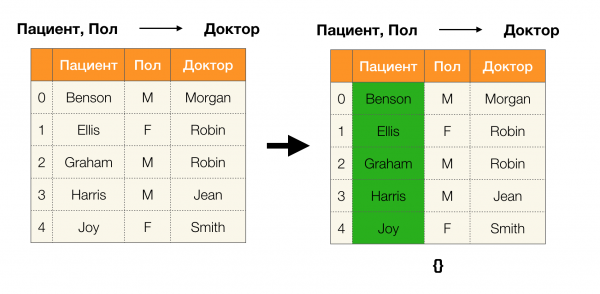
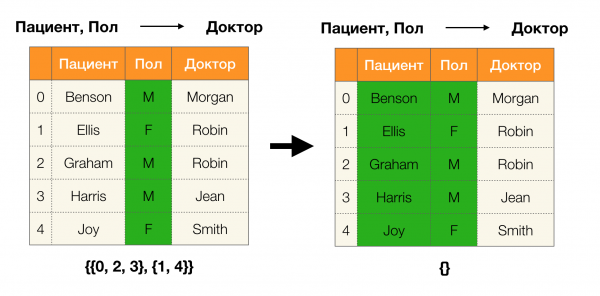
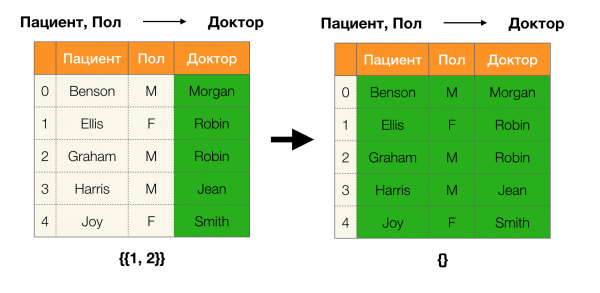
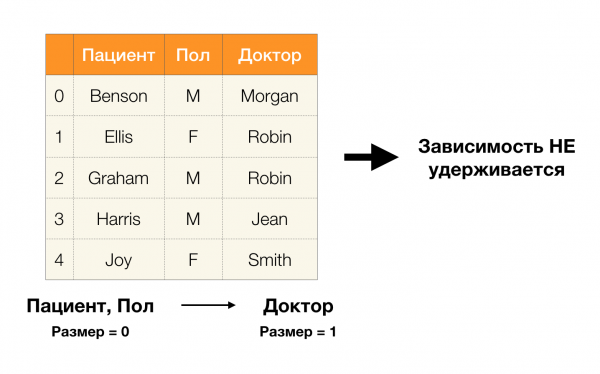
Conform lemei, pentru a determina dacă dependența este menținută, trebuie să urmăm patru pași:
- Calculați partiția pentru partea stângă a dependenței
- Calculați partiția pentru partea dreaptă a dependenței
- Calculați produsul primului și celui de-al doilea pas
- Comparați dimensiunile partițiilor obținute în primul și al treilea pas
Mai jos este un exemplu de verificare a menținerii dependenței conform acestei leme:
În acest articol, am discutat despre concepte precum dependența funcțională, dependența funcțională aproximativă, locurile unde acestea sunt aplicate, precum și despre algoritmii existenți pentru identificarea dependențelor funcționale. Am analizat de asemenea conceptele de bază, dar esențiale, utilizate în algoritmii moderni pentru depistarea dependențelor funcționale.
Referințe bibliografice:
- Huhtala Y. et al. TANE: Un algoritm eficient pentru descoperirea dependențelor funcționale și aproximative // The computer journal. – 1999. – Vol. 42. – Nr. 2. – P. 100-111.
- Kruse S., Naumann F. Descoperirea eficientă a dependențelor aproximative // Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – Nr. 7. – P. 759-772.
- Papenbrock T., Naumann F. O abordare hibridă pentru descoperirea dependențelor funcționale // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – P. 821-833.
- Papenbrock T. et al. Descoperirea dependențelor funcționale: O evaluare experimentală a șapte algoritmi // Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – Nr. 10. – P. 1082-1093.
- Kumar A. et al. Să ne alăturăm sau nu?: Gândind de două ori înainte de a face selecția caracteristicilor // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – P. 19-34.
- Abo Khamis M. et al. Învățare în bazele de date cu tensori rarefiți // Lucrările celui de-al 37-lea Simpozion ACM SIGMOD-SIGACT-SIGAI pe Principiile Sistemelor de Baze de Date. – ACM, 2018. – P. 325-340.
- Hellerstein J. M. et al. Biblioteca de analize MADlib: sau abilități MAD, SQL // Lucrările Fundației VLDB. – 2012. – Vol. 5. – Nr. 12. – P. 1700-1711.
- Qin C., Rusu F. Aproximări speculative pentru optimizarea distribuită a gradientului la scară terascale // Lucrările celui de-al Patrulea Atelier pe Analiza Datelor în Cloud. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib: Învățare automată în Apache Spark // Jurnalul de Cercetare în Învățarea Automată. – 2016. – Vol. 17. – Nr. 1. – P. 1235-1241.
Autorii articolului: , cercetător în , și , cercetător în
Sursa: habr.com
