

Salut, Habr! La echipa Dodo Pizza Engineering, ne plac foarte mult datele (cine nu le iubește acum?). Acum va fi o poveste despre cum să acumulăm toate datele din lumea Dodo Pizza și să oferim oricărui angajat al companiei acces convenabil la acest imens set de date. Sarcina cu stea: să păstrăm nervii echipei de inginerie a datelor.
Ca adevărați Pliușkin, adunăm diverse informații despre activitatea pizzăriilor noastre:
- ne amintim toate comenzile utilizatorilor;
- știm cât timp a durat prepararea primei pizza din Syktyvkar;
- vedem cât timp pizza se răcește pe raftul de încălzire din Voronezh chiar acum;
- stocăm date despre desfacerile de produse;
- și multe altele.
Pentru gestionarea datelor, Dodo Pizza are în prezent mai multe echipe, una dintre ele fiind echipa de inginerie a datelor. Acum, în fața noastră (adică a noastră) se află sarcina: să oferim oricărui angajat al companiei acces convenabil la acest imens set de date.
Când am început să ne gândim la cum să facem acest lucru și am început să discutăm despre sarcină, am găsit o abordare foarte interesantă pentru gestionarea datelor - (la link găsiți un articol gastronomic uriaș). Ideile sale s-au potrivit foarte bine cu viziunea noastră despre cum vrem să construim sistemul nostru. În continuare, în articolul nostru va fi revizuită abordarea și cum vedem implementarea ei în Dodo Pizza Engineering.
Ce înțelegem prin „date”
Pentru început, să ne clarificăm ce înțelegem prin date la Dodo Pizza Engineering:
- Evenimentele pe care le trimit serviciile (avem un bus comun construit cu RabbitMQ);
- Înregistrările din baza de date (pentru noi aceasta este MySQL și CosmosDB);
- Clickstream de pe aplicația mobilă și site.
Pentru ca afacerea Dodo Pizza să poată utiliza aceste date și să se bazeze pe ele, este important să îndeplinească următoarele condiții:
- Acestea trebuie să fie integrale. Trebuie să fim siguri că nu modificăm datele în timpul procesării, stocării și afișării lor. Dacă afacerea nu poate avea încredere în datele noastre, atunci acestea nu vor avea nicio valoare.
- Acestea trebuie să aibă marcaj temporal și să nu fie suprascrise. Aceasta înseamnă că dorim să avem posibilitatea de a reveni în orice moment și de a examina datele din acel interval de timp. De exemplu, să știm câte pizza au fost vândute pe 8 iulie 2018.
- Acestea trebuie să fie fiabile. În procesul de colectare și stocare a datelor, trebuie să păstrăm nu doar integritatea, ci și fiabilitatea. Nu putem pierde date, feronestim, pentru că odată cu acestea pierdem încrederea clienților noștri (atât externi, cât și interni).
- Acestea trebuie să aibă un schelet stabil – scriem interogări pentru aceste date. Nu ne-ar plăcea să se schimbe atât de mult, încât interogările noastre să nu mai funcționeze, odată cu modificările codului aplicației și cu refactorizarea. Cine scrie interogările nu va ști niciodată că ați făcut refactorizare până când totul nu se va strica complet. Nu ne dorim să aflăm asta de la clienți.
Având în vedere toate aceste cerințe, am ajuns la concluzia că datele în Dodo reprezintă un produs. La fel ca API-ul public al serviciului. Astfel, echipa care deține datele ar trebui să fie aceeași echipă care deține serviciul. De asemenea, schimbările în schema datelor ar trebui să fie întotdeauna compatibile cu versiunile anterioare.
Abordarea tradițională – Data Lake
Pentru a rezolva sarcinile de stocare și procesare sigură a Big Data, există o abordare tradițională, acceptată în multe companii care lucrează cu un astfel de volum de informații – Data Lake. În cadrul acestei abordări, inginerii de date colectează informațiile din toate componentele sistemului și le stochează într-un singur depozit mare (aceasta poate fi, de exemplu, Hadoop, Azure Kusto, Apache Cassandra sau chiar un replica MySQL, dacă datele încap în ea).
Apoi, acești ingineri scriu interogări pentru acest depozit. Implementarea acestei abordări în Dodo Pizza Engineering presupune că echipa de Data Engineering va deține schema de date în depozitul analitic.
În acest caz, echipa devine foarte tristă și iată de ce:
- Ea trebuie să urmărească schimbările în TOATE serviciile din cadrul companiei. Și acestea sunt multe, iar schimbările sunt foarte multe (în medie, noi fuzionăm ~100 pull requests pe săptămână, iar multe servicii nu efectuează deloc pull requests).
- Când schema de date se schimbă, Product Owner-ul și echipa care modifică schema de date trebuie să aștepte până Data Engineering finalizează codul necesar pentru a susține modificările. În același timp, avem de mult timp proiecte în derulare, iar situația în care o echipă așteaptă o altă echipă este foarte rară. Și nu dorim ca aceasta să devină o parte „normală” a procesului de dezvoltare.
- Ea trebuie să fie implicată în ÎNTREG afacerea companiei. Rețeaua de pizzerii pare o afacere simplă, dar doar așa pare. Este foarte dificil să aduni în aceeași echipă suficiente competențe pentru a construi un model de date adecvat pentru întreaga companie.
- Este un singur punct de eșec. De fiecare dată când trebuie să schimbi datele pe care le returnează serviciul sau să scrii o interogare, toate aceste sarcini ajung la echipa de Data Engineering. În final, echipa se confruntă cu un backlog supraîncărcat.
Astfel, echipa se află la intersecția unei cantități enorme de nevoi și probabil nu va putea să le satisfacă. În plus, se va afla într-o stare constantă de criză și stres. Nu ne dorim așa ceva. Prin urmare, trebuie să ne gândim la cum să rezolvăm aceste probleme și să obținem, totodată, capacitatea de a analiza datele.
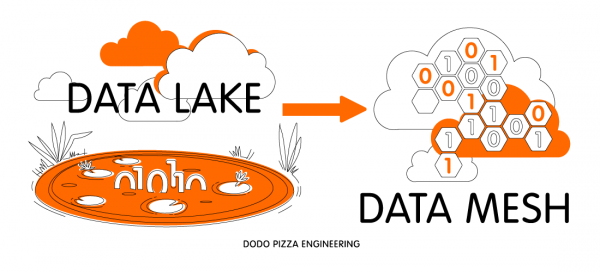
Trecând de la Data Lake la Data Mesh
Din fericire, această întrebare nu ne-a fost adresată doar nouă. De fapt, o astfel de problemă a fost deja rezolvată în industrie (aleluia!). Doar că într-un alt domeniu: desfășurarea aplicațiilor. Da, mă refer la abordarea DevOps, unde echipa stabilește cum trebuie să fie desfășurat produsul pe care îl creează.
O abordare similară pentru rezolvarea problemelor Data Lake a fost propusă de Zhamak Dehghani, consultant ThoughtWorks. Observând cum abordări similare sunt folosite de Netflix și Spotify, ea a scris un articol uimitor (linkul către acest articol a fost la începutul articolului). Principalele idei pe care le-am extras din acesta sunt:
- Împărțirea unui Data Lake mare în domenii de date care se aseamănă foarte mult cu domeniile din design-ul bazat pe domenii. Fiecare domeniu este un mic bounded context.
- Echipele de funcționalitate (Feature Team) care sunt responsabile pentru domeniile DDD sunt, de asemenea, responsabile pentru domeniile corespunzătoare de date. Ele păstrează schema, fac modificări și încarcă datele în ea. În plus, știu totul: cum să schimbe încărcarea datelor fără a provoca defecte atunci când aplicația se modifică. Cunoștințele nu dispar nicăieri. Pentru a accesa datele, nu trebuie să meargă nicăieri. Echipa în sine gestionează întregul ciclu de dezvoltare, de la modificarea datelor operaționale la furnizarea datelor analitice către terți. O singură echipă deține tot ce ține de domeniu (atât domeniul de afaceri, cât și domeniul de date).
- Data Engineer – un rol în cadrul echipei de funcționalitate. Nu trebuie neapărat să fie o persoană separată, dar este esențial ca echipa să aibă această competență.
Între timp, echipa de Data Engineering…
Dacă ne imaginăm că totul se realizează cu un simplu click, rămâne să răspundem la două întrebări:
Ce va face acum echipa de Data Engineering? În Dodo Pizza Engineering există deja o echipă de platformă/SRE. Sarcina acesteia este de a oferi dezvoltatorilor instrumente pentru desfășurarea simplă a serviciilor. Echipa de Data Engineering va îndeplini aceeași rol, dar pentru date.
Transformarea datelor operaționale în date analitice este un proces complex. A face datele analitice accesibile pentru întreaga companie este și mai complicat. Echipa de Data Engineering se va ocupa exact de aceste probleme.
Ne propunem să oferim echipei Feature Team un set convenabil de instrumente și practici, care să le permită să publice date din serviciul lor pentru restul companiei. De asemenea, vom fi responsabili pentru părțile infrastructurale generale ale pipeline-ului de date (cozi, stocare sigură, clustere pentru efectuarea transformărilor asupra datelor).
Cum vor apărea abilitățile Data Engineer în interiorul echipei Feature Team? Cu echipa Feature Team este mai complicat. Desigur, am putea încerca să angajăm câte un Data Engineer în fiecare dintre echipele noastre. Dar este foarte complicat. Să găsești o persoană cu un background solid în procesarea datelor și să o convingi să lucreze în cadrul echipei de produs este dificil.
Un mare avantaj pentru Dodo este că ne place formarea internă. Așa că planul nostru acum este: echipa de Data Engineering începe să publice date din anumite servicii, plânge, se înțeapă, dar continuă să mănânce cactus. Odată ce vom înțelege că avem un proces gata pentru publicare, vom începe să vorbim despre el în echipa Feature Team.
Avem câteva modalități de a face acest lucru:
- , pe care vom explica cum arată procesul pe care l-am creat, ce instrumente există și cum pot fi folosite cel mai eficient.
- Prezentarea la DevForum ne va ajuta să adunăm feedback de la dezvoltatorii de produs. După aceasta, putem să ne alăturăm echipelor de produs și să le ajutăm să rezolve problemele legate de publicarea datelor, organizând antrenamente pentru echipe.
Consumarea datelor
Acum am vorbit mult despre publicarea datelor. Dar există și consumul. Ce este de spus în această privință?
Avem o echipă BI minunată care elaborează rapoarte foarte complexe pentru compania de management. În interiorul Dodo IS există multe rapoarte pentru partenerii noștri, care îi ajută să gestioneze pizzeriile. În noul nostru model, ne gândim la ei ca la consumatori de date care au propriile domenii de date. Iar acești consumatori vor fi responsabili pentru propriile lor domenii. Uneori, domeniul consumatorului poate fi descris printr-o singură interogare în depozitul analitic – și este bine. Dar înțelegem că acest lucru nu va funcționa întotdeauna. De aceea, ne dorim ca platforma pe care o vom crea pentru echipele de produse să poată fi folosită și de consumatorii de date (în cazul rapoartelor din interiorul Dodo IS, vor fi aceleași echipe).
Așa vedem noi lucrul cu datele în Dodo Pizza Engineering. Așteptăm cu interes părerile voastre despre acest subiect în comentarii.
Sursa: habr.com
